
Qualité et coûts
- Leçon 9
- 55 min
- Module 3 : Instrumenter une télémétrie utile
Où nous en sommes
Dans la leçon précédente, nous avons donné à chaque billet une trace, avec des journaux et des métriques qui partagent ses identifiants. Mais un seul coût et un seul nombre d'échecs pour tout le service ne disent pas quelle requête coûte plus cher, ni pourquoi les billets échouent. Dans cette leçon, nous ventilons les résultats, les jetons et les coûts par version de requête, et nous trouvons l'étape lente et coûteuse dans une trace. Nous commençons par une boulangerie qui essaie une nouvelle recette.
Leçon 9 sur 19 · MLOps et LLMOps : exploiter l'IA en productionQualité et coûts
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
Un seul coût et un seul nombre d’échecs pour tout le service ne suffisent pas. Ils ne disent pas quelle requête coûte plus cher, ni pourquoi les billets échouent. Comptez les résultats, les types d’échec, les jetons et les coûts pour chaque version de requête. Repérez aussi l’étape lente et coûteuse dans une seule trace.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Journaux, métriques et traces : l’événement
ticket.triaged, les attributs GenAI etops waterfall. - Les réponses coupées à la limite de jetons (
finish_reason: length), dans Traiter les résultats incomplets, et les jetons de raisonnement cachés, dans Raisonnement et multimodalité. - La comparaison des requêtes v2 et v3 dans le cours sur l’évaluation, dans Compromis et régressions.
Ce qu’il vous faut sur votre ordinateur
- Votre projet à l’instantané
end-of-m03, avec la télémétrie enregistrée dansdata/telemetry/. Pas de Docker : chaque commande de cette leçon lit des fichiers.
Une boulangerie essaie une nouvelle recette
Section intitulée « Une boulangerie essaie une nouvelle recette »Une boulangerie prépare son pain avec sa recette habituelle. Un matin, elle utilise une nouvelle recette pour la moitié des plaques. Cette recette demande moins de farine. Le soir, le propriétaire lit un seul rapport : 8 % des pains ont fini à la poubelle. La farine a aussi coûté plus cher que d’habitude.
Que dit ce rapport sur la nouvelle recette? Rien. Il mélange les deux recettes. Le propriétaire ne voit donc pas que l’ancienne n’a presque rien gaspillé. « À la poubelle » mélange aussi les raisons : pain brûlé, pas levé, tombé par terre. Chaque raison a une cause différente, et une personne différente peut la corriger.
Un bon rapport sépare les comptes par recette et par raison. Il place aussi le coût à côté de chaque pain, même ceux à la poubelle : la boulangerie a payé leur farine aussi.
Le problème : un seul nombre pour deux requêtes
Section intitulée « Le problème : un seul nombre pour deux requêtes »Omar veut la requête la moins chère. La requête v3 est plus courte que v2, donc chaque appel envoie moins de jetons. « Elle doit coûter moins cher », dit-il.
Voici ce que pouvait indiquer le tableau de bord de la semaine dernière, dans Objectifs de service :
Cost: US$0.440 per 1,000 tickets (budget US$0.40, OVER)Le coût dépasse le budget, mais ce nombre mélange 602 billets de la requête v2 et 1 798 de v3. Il ne permet pas à Omar de savoir quelle requête coûte plus cher. L’ébauche du SLI indiquait que 197 billets n’avaient reçu aucune réponse. Elle ne disait pas quelle requête avait échoué, ni comment. Un billet peut échouer parce que le modèle n’a rien écrit, ou parce que le fournisseur n’a jamais répondu. Ce sont des problèmes différents, avec des responsables différents.
L’idée : compter par version et par résultat, avec le coût à côté
Section intitulée « L’idée : compter par version et par résultat, avec le coût à côté »Trois changements rendent le rapport de la boulangerie utile. Ils fonctionnent de la même façon pour l’assistant.
Étiquetez chaque compte avec la version. Chaque événement ticket.triaged et chaque métrique portent prompt.version et release.id. On peut alors séparer n’importe quel nombre par version. Dans Grafana, une étiquette donne une ligne par version; dans ops, une colonne par version.
Nommez le résultat de chaque billet. Un résultat de tâche indique si l’étape de triage a rempli son rôle pour ce billet. La valeur ok (réussite) signifie que la réponse contient une équipe, une décision et un brouillon valides. Toute autre valeur est une catégorie d’échec : un type d’échec nommé, avec sa propre cause :
| Résultat | Ce qui s’est passé | Qui examine d’abord |
|---|---|---|
no_answer |
Le modèle a utilisé tous ses jetons et n’a écrit aucun texte (finish_reason: length) |
Priya (la requête) |
bad_answer |
Le texte n’est pas une décision valide | Priya |
rejected |
Le fournisseur a refusé l’appel | Kwame (le fournisseur) |
dead_letter |
Le fournisseur a échoué à chaque tentative : délais dépassés, erreurs | Amira, puis Kwame |
failed |
Tout autre problème, par exemple un billet manquant | Amira |
Attribuez le coût. L’attribution des coûts consiste à associer chaque coût à ce qui l’a causé. D’abord à l’appel d’IA, puis à son billet, puis à la version. Le span (segment de trace) de chaque appel contient ses jetons et app.cost_usd. L’événement du billet additionne ses appels. Un billet qui échoue conserve son coût, car le fournisseur facture les jetons, pas les bonnes réponses.
Un petit exemple : quatre billets à la main
Section intitulée « Un petit exemple : quatre billets à la main »Voici quatre billets de la relecture de la semaine dernière, deux pour chaque requête. Les jetons proviennent des segments de trace de leurs appels de triage. Le cours suppose des prix de 0,10 $ US par million de jetons d’entrée et de 0,50 $ US par million de jetons de sortie. Chaque appel coûte donc : jetons d’entrée × 0,10 + jetons de sortie × 0,50, en millionièmes de dollar.
| Billet | Requête | Résultat | Jetons d’entrée | Jetons de sortie (raisonnement) | Coût |
|---|---|---|---|---|---|
| T-502401 | v2 | ok | 1 903 | 235 (143) | 190,3 + 117,5 = 0,000308 $ US |
| T-502746 | v2 | no_answer | 1 922 | 1 000 (1 000) | 192,2 + 500,0 = 0,000692 $ US |
| T-503003 | v3 | ok | 1 467 | 621 (477) | 146,7 + 310,5 = 0,000457 $ US |
| T-503354 | v3 | no_answer | 1 495 | 1 000 (1 000) | 149,5 + 500,0 = 0,000650 $ US |
Lisez le tableau colonne par colonne. La requête v3 envoie environ 430 jetons d’entrée de moins : Omar a raison sur ce point. Mais sa bonne réponse contient 621 jetons de sortie, contre 235 pour v2. Ici, les jetons de sortie coûtent cinq fois plus cher que les jetons d’entrée. La bonne réponse de v3 coûte donc 48 % plus cher que celle de v2.
Regardez maintenant les deux lignes no_answer (aucune réponse). Ce sont les billets les plus chers des quatre. Chaque appel a consacré ses 1 000 jetons de sortie aux jetons de raisonnement : le travail caché du modèle avant d’écrire sa réponse. Le fournisseur les compte et les facture, mais ne renvoie pas leur texte. La limite a arrêté l’appel avant que le modèle écrive quoi que ce soit. Ces billets ont donc coûté le plus cher sans rien donner.
Enfin, le résultat. Avec deux billets par requête, chaque requête compte un échec. Cela donne un taux d’échec de 50 % pour les deux, et ne nous apprend rien. Il faut beaucoup de billets, séparés par version, pour voir une différence.
Larkfield : la semaine dernière, par requête
Section intitulée « Larkfield : la semaine dernière, par requête »La commande ops quality produit le même tableau pour chaque billet d’un fichier :
python -m ops quality data/telemetry/release-full.jsonl.gzprompt assistant-v2 assistant-v3------------------------------ ----------------- -----------------tickets 602 1,798 ok 601 (99.8%) 1,602 (89.1%) no_answer 1 (0.2%) 186 (10.3%) dead_letter 0 (0.0%) 10 (0.6%)sent to a person 162 (27.0% of ok) 475 (29.7% of ok)tokens in (median) 1,902 1,477tokens out (median) 260 627triage call p50 / p95 (s) 2.89 / 5.17 5.56 / 8.34time to a draft p95 (s) 5.2 7.9cost per 1,000 tickets (US$) 0.338 0.474agrees with the agent's review 288/307 (93.8%) 623/744 (83.7%)Omar a maintenant sa réponse. Pour 1 000 billets, v3 coûte 0,474 $ US et v2 coûte 0,338 $ US : 40 % de plus. L’appel médian de v3 envoie 425 jetons d’entrée de moins, ce qui économise 0,0000425 $ US. Il écrit aussi 367 jetons de sortie de plus, qui coûtent 0,0001835 $ US. La sortie supplémentaire coûte quatre fois ce que la requête plus courte économise.
Les échecs ont aussi des noms. Un billet sur dix avec v3 n’a reçu aucune réponse, contre un sur 602 avec v2 (l’enregistrement « spark plug »). Dix billets v3 sont devenus des messages non livrables : des erreurs du fournisseur, pas des réponses sans texte. L’appel de triage est presque deux fois plus lent à la médiane (5,56 s contre 2,89 s). Il est aussi 61 % plus lent au p95. Et quand les agents ont ensuite vérifié les décisions, ils étaient moins souvent d’accord avec v3.
La même commande permet d’autres découpages. --by release donne les mêmes deux colonnes sous les identifiants de version 1.5.0-4fafd1 et 1.5.0-767b56, dans Lignée des artefacts. --from 5 conserve les billets reçus à partir de la minute 5, après le changement. --by evidence sépare les réponses rejouées des 10 messages non livrables, qui n’ont aucune réponse.
Les mêmes nombres dans Grafana
Section intitulée « Les mêmes nombres dans Grafana »Le tableau de bord de qualité de l’IA place quatre signaux en haut. Voici la semaine normale, puis la semaine dernière :
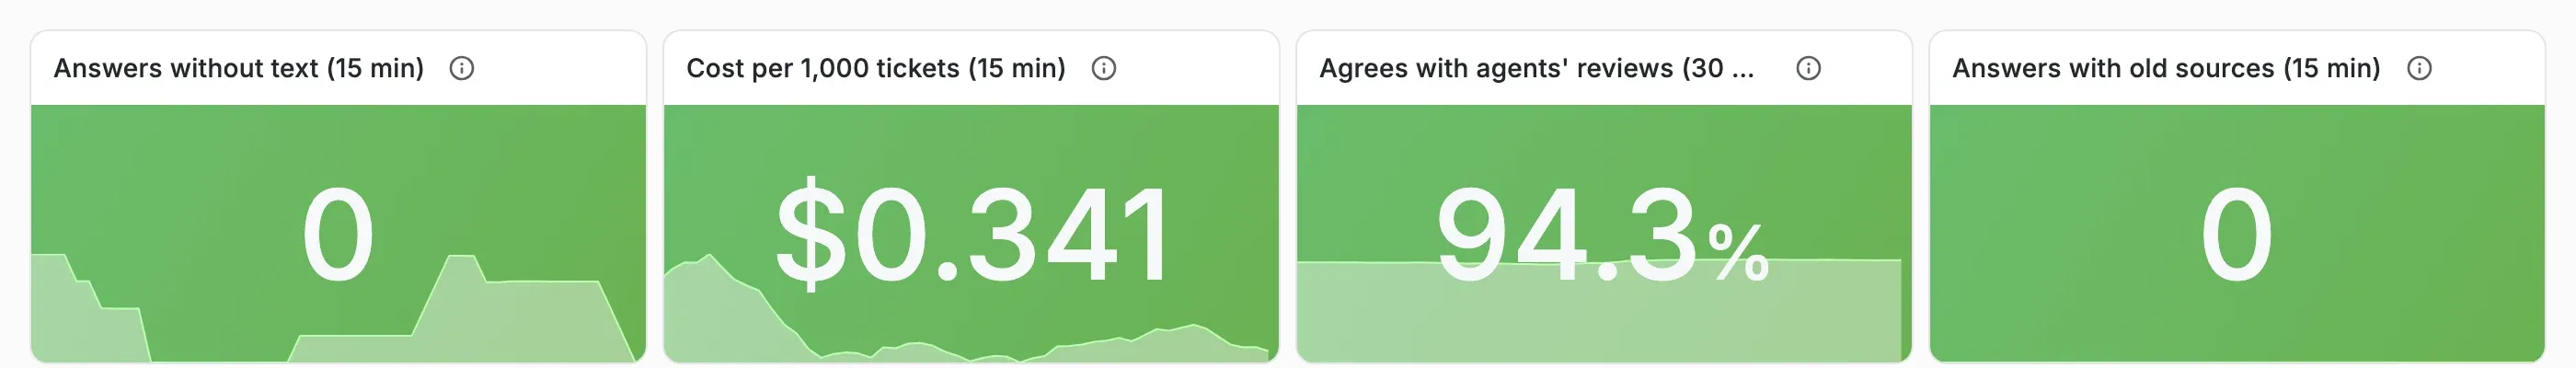
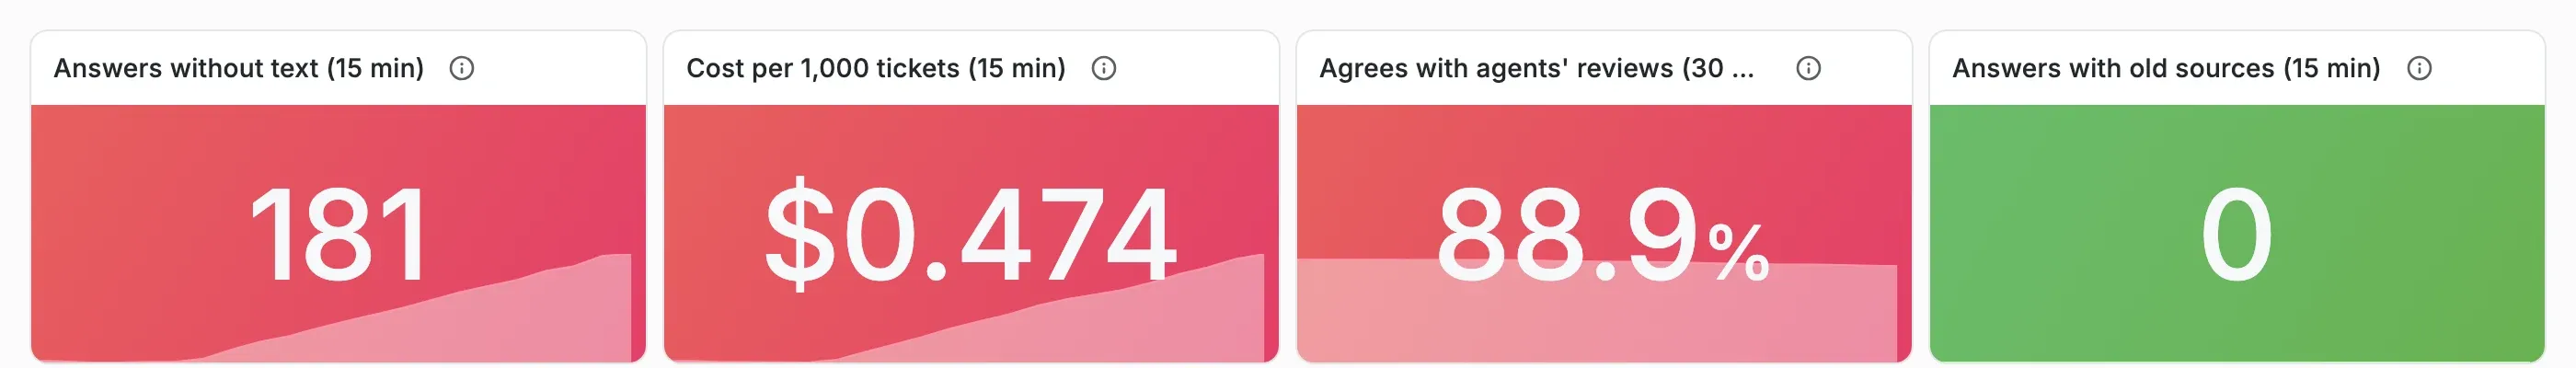
Ces panneaux comptent une fenêtre de billets récents, toutes requêtes confondues. Utilisez-les pour voir qu’un problème existe maintenant. Utilisez ensuite les panneaux avec une ligne par version pour repérer la version en cause :
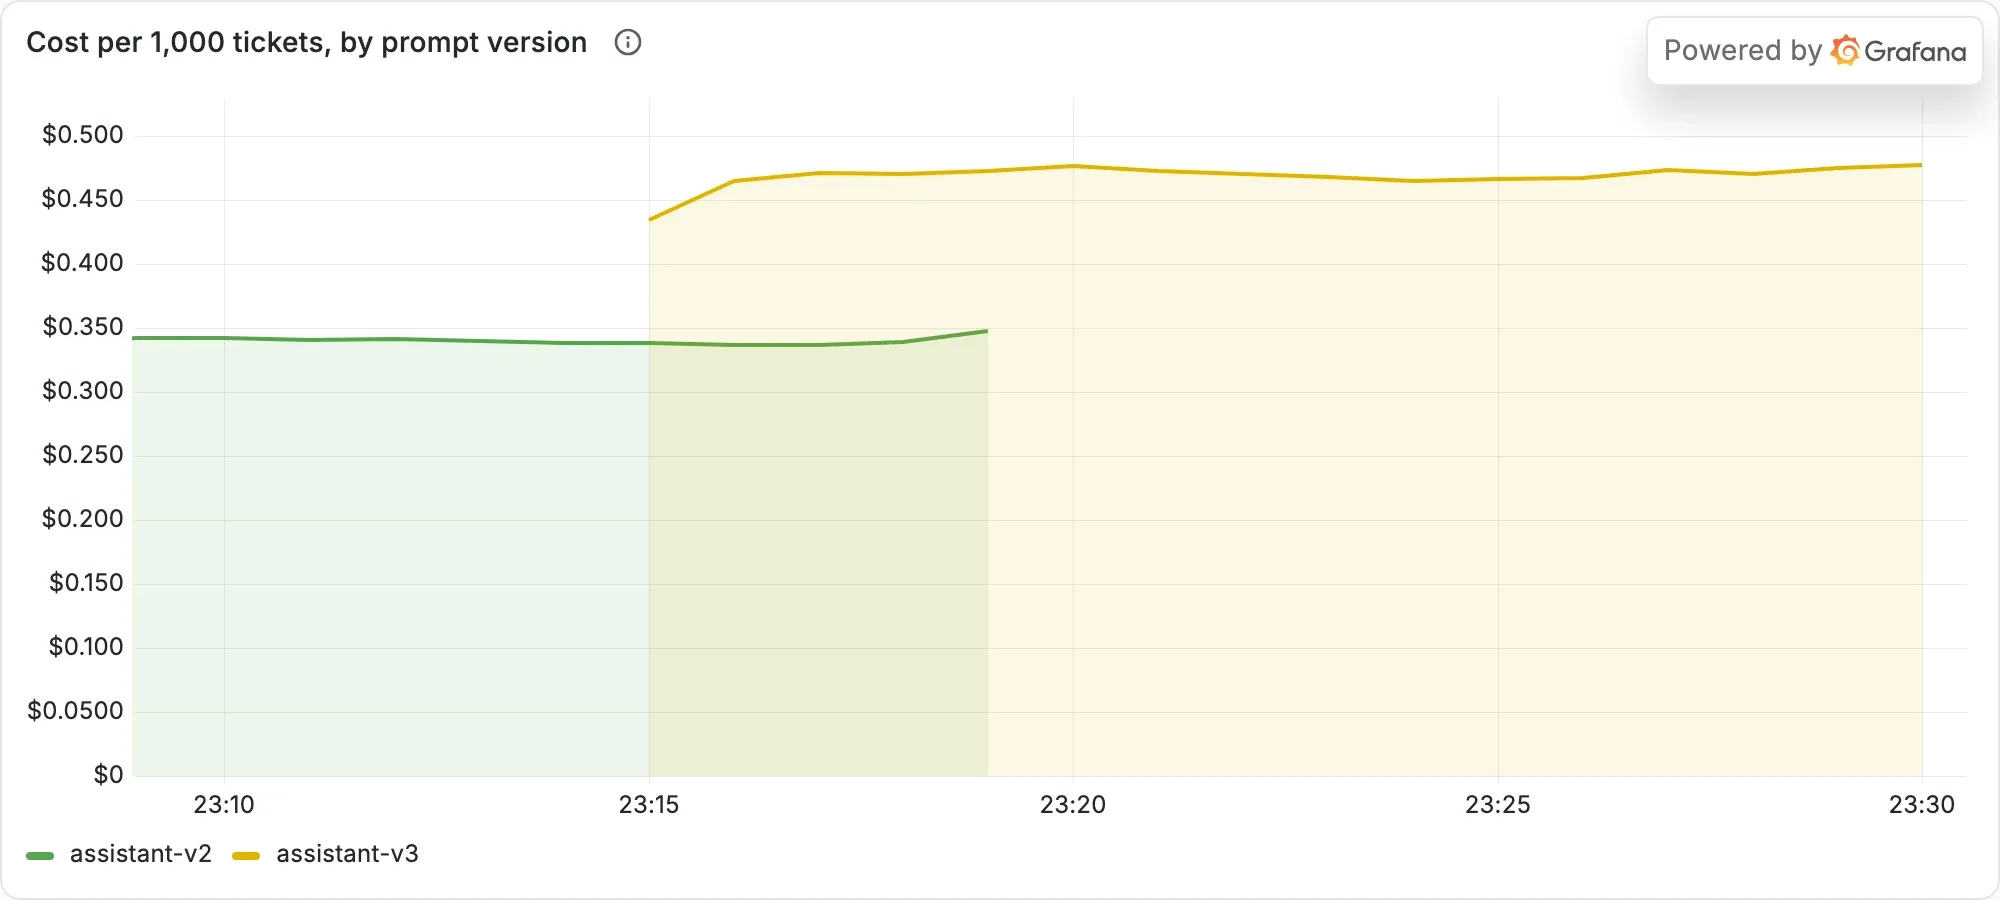
Les deux lignes ne se croisent jamais : v3 coûte plus cher dès sa première minute. Sans l’étiquette prompt.version, ce panneau montrerait une seule ligne qui monte lentement, et personne ne saurait pourquoi.
Une alerte qui ne peut pas se déclencher
Section intitulée « Une alerte qui ne peut pas se déclencher »Les étiquettes cachent un piège, et l’équipe du cours y est tombée. Prometheus, le système de stockage des métriques de Grafana, mesure l’augmentation d’un compteur sur une fenêtre. Une nouvelle combinaison d’étiquettes démarre une nouvelle série. Quand le premier no_answer d’une nouvelle requête est arrivé, sa série a commencé à 1. Prometheus n’avait aucune valeur antérieure à comparer, donc l’augmentation était de 0. Pendant le premier déploiement canari d’exercice, une réponse n’avait aucun texte, et l’alerte no-answer ne s’est jamais déclenchée.
La correction se trouve dans ticket_api/telemetry.py. Quand le processus voit une nouvelle requête et une nouvelle version, il ajoute d’abord 0 à chaque série de résultats (zero_series). Le premier véritable échec devient alors une augmentation de 0 à 1. Écrivez chaque alerte, puis testez-la avec un échec volontaire, comme le font les modules suivants.
Repérer l’étape lente et coûteuse dans une trace
Section intitulée « Repérer l’étape lente et coûteuse dans une trace »Le tableau indique que v3 est lente et coûteuse en moyenne. Une trace montre où un billet dépense son temps et son argent. Placez un bon billet v2 et un billet v3 en échec sur la même échelle de temps :
python -m ops waterfall data/telemetry/release-full.jsonl.gz --ticket T-503354Trace 62bdee6f5950708a65de0362c9584db4, ticket T-503354: 14 spans, 9,203 ms from first to lastspan start ms ms cost US$POST /v1/tickets 0 17.4 # (waiting in the queue) 17 165.0 # process ticket job ERROR 182 9,020.4 ################################### triage ERROR 185 9,013.2 ################################### chat chat-small 185 9,008.4 ################################### 0.000650 POST 185 9,006.9 ###################################(9 database queries hidden; --all shows them)Longest step: triage, 9,013 ms (98% of the trace)Costliest step: chat chat-small, US$0.000650 of US$0.000650: 1495 tokens in, 1000 out (1000 of them reasoning), finish length
Description textuelle du diagramme
Les deux traces commencent de la même façon : un court segment d’API et une courte attente dans la file. Ensuite, l’appel de triage remplit presque toute chaque trace. Dans la trace v2, l’appel prend 2,7 secondes, coûte 0,000308 $ US et se termine avec stop (arrêt); le plongement suit. Dans la trace v3, l’appel prend 9,0 secondes, soit trois fois plus longtemps, et coûte 0,000650 $ US, soit deux fois plus. Il se termine avec length (limite de longueur) : les 1 000 jetons de sortie étaient tous du raisonnement. La tâche et l’étape de triage portent la mention ERROR (erreur). Il n’y a aucun plongement, car la tâche s’est arrêtée à la réponse vide.
Expliquez maintenant le goulot d’étranglement à partir de la trace seulement. L’API et la file ont pris 0,2 seconde, donc elles ne sont pas le problème. L’appel de triage a pris 98 % du temps et 100 % du coût. Ses attributs expliquent sa durée et son coût : le modèle a produit 1 000 jetons de sortie, tous de raisonnement. Le fournisseur l’a arrêté à la limite, donc il n’a écrit aucune réponse.
Vous n’avez jamais besoin de lire le raisonnement caché pour le savoir. Sa taille et sa durée figurent dans le segment de trace : 1 000 jetons et 9 secondes. Cela indique la cause : la requête v3 fait réfléchir le modèle plus longtemps que la limite de jetons le permet. Le serveur n’a pas besoin de changement. La correction concerne la requête ou la limite, ce qui relève de Priya.
Quand le fournisseur ne répond pas
Section intitulée « Quand le fournisseur ne répond pas »Les 10 messages non livrables sont différents. La trace du billet T-503258 contient cinq segments process ticket job (traitement de la tâche du billet), un par tentative. Dans chacun, chat chat-small ERROR dure 10,0xx ms, et ops affiche Costliest step: … US$0.000000 … None tokens in (étape la plus coûteuse, aucun compte de jetons d’entrée) :
process ticket job 281 10,030.4 ###### triage ERROR 285 10,019.0 ###### chat chat-small ERROR 285 10,018.4 ######Le service attend le fournisseur pendant 10 secondes (PROVIDER_TIMEOUT), et la réponse enregistrée pour ce billet prend 12,1 secondes. Chaque tentative dépasse donc le délai, et la tâche devient un message non livrable après cinq tentatives. Les 10 messages non livrables correspondent tous à ce seul message d’exercice, tiré 10 fois par le scénario. Son événement ticket.triaged indique outcome: dead_letter (résultat : message non livrable) et error.type: ProviderTimeout (délai du fournisseur dépassé). C’est une erreur du fournisseur, et sa correction est différente : le délai d’attente, un réglage d’Amira. Ce problème reste ouvert jusqu’à Tirer des leçons après un incident.
Quand utiliser les métriques par version, et ce qu’elles coûtent
Section intitulée « Quand utiliser les métriques par version, et ce qu’elles coûtent »Comptez par version dès que deux versions peuvent fonctionner dans la même fenêtre : déploiement canari, retour arrière, changement de réglages. Limitez le nombre d’étiquettes. Chaque valeur d’étiquette multiplie le nombre de séries que Prometheus stocke. Une version de requête, une version du service et un résultat donnent quelques dizaines de séries. Un identifiant de billet comme étiquette créerait une nouvelle série pour chaque billet, et le stockage augmenterait sans fin. Placez les valeurs propres aux billets dans les journaux, jamais dans les étiquettes des métriques.
Le coût dans la télémétrie est une estimation : les jetons multipliés par les prix dans ticket_api/prices.py. Elle convient pour comparer les versions, car les deux utilisent les mêmes prix. Ce n’est pas la facture. Chaque mois, Kwame compare la facture du fournisseur à l’estimation, et il met les prix à jour quand ils changent.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Deux valeurs p95 pour les mêmes appels : 8,34 s dans ops, environ 10 s dans Grafana
Symptôme : ops quality indique un p95 de 8,34 s pour l’appel de triage de v3. Le panneau Grafana affiche environ 10 s pour la même relecture :
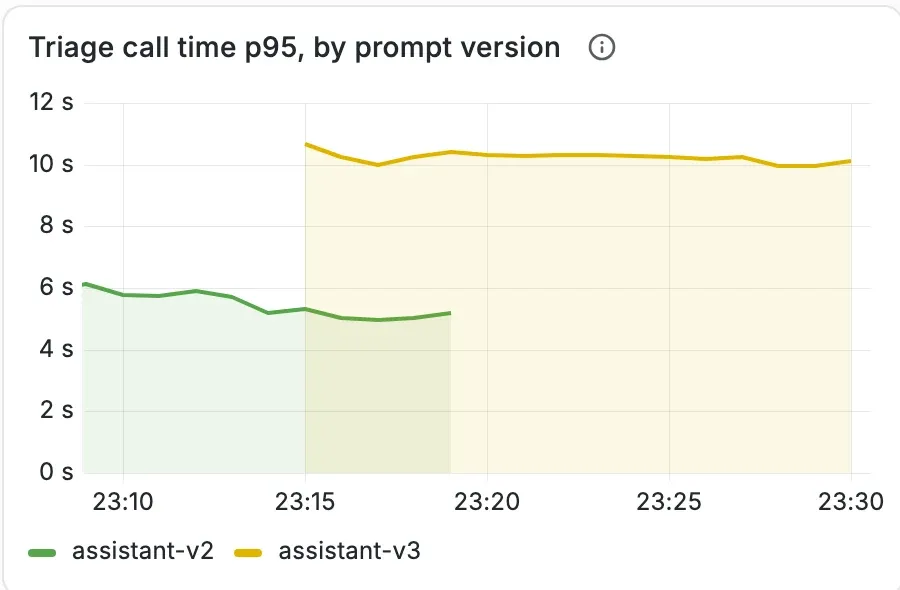
Cause : ops trie les durées réelles et prend le 95e centile. Grafana n’a pas les durées, seulement un histogramme : des comptes d’appels par classes, ici 5–8 s et 8–12 s. Sa fonction histogram_quantile sait que le p95 se trouve dans la classe 8–12 s. Elle estime une valeur à l’intérieur de cette classe. Une classe large donne une estimation approximative.
Correction : comparez les deux nombres avec prudence. Pour décider, utilisez la valeur exacte des journaux (ops). Si une limite tombe à l’intérieur d’une classe, ajoutez une borne de classe à cette limite. Par exemple, 8 s pour l’alerte triage-slow. Les classes du projet ont déjà une borne à 8 s.
Erreur courante
Les messages non livrables semblent gratuits
Symptôme : ops quality --by evidence affiche une colonne None (aucune valeur) avec 10 messages non livrables et un coût de 0.000.
Cause : le service consigne un coût seulement lorsqu’une réponse arrive avec ses comptes de jetons. Un appel dont le délai est dépassé ne renvoie aucun compte. Le fournisseur peut quand même avoir travaillé sur l’appel, et certains fournisseurs facturent ce travail.
Correction : ne lisez jamais un coût de 0 comme « gratuit ». Comptez les appels en échec (error.type). Demandez au fournisseur comment il facture un appel dont le client a cessé d’attendre la réponse. Kwame est responsable de cette question.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Omar dit : « La requête v3 envoie moins de jetons, donc elle coûte moins cher. » Répondez-lui avec le tableau de qualité opérationnelle de la semaine dernière.
Afficher la réponse
v3 envoie moins de jetons d’entrée (médiane de 1 477 contre 1 902), mais produit plus de jetons de sortie (627 contre 260). Aux tarifs supposés, les jetons de sortie coûtent cinq fois plus cher. Par appel médian, 425 jetons d’entrée en moins économisent 0,0000425 $ US. Les 367 jetons de sortie supplémentaires coûtent 0,0001835 $ US. Pour 1 000 billets, v3 coûte 0,474 $ US contre 0,338 $ US, soit 40 % de plus. Ses billets en échec ajoutent à ce coût : une réponse sans texte coûte les 1 000 jetons de sortie.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Deux billets ont échoué la semaine dernière : T-503354 (no_answer) et T-503258 (dead_letter). Pourquoi la catégorie de résultat détermine-t-elle qui intervient?
Afficher la réponse
no_answer (aucune réponse) signifie que le modèle a utilisé tous ses jetons pour le raisonnement. La cause est la requête ou la limite de jetons, donc Priya examine le problème en premier. dead_letter (lettre morte) signifie que le fournisseur n’a pas répondu avant le délai d’expiration, à chaque tentative. La cause est le réglage du délai ou le fournisseur, donc Amira examine le problème en premier, puis Kwame. Un seul décompte des « billets en échec » enverrait les deux problèmes à la même personne.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : avec ops waterfall, trouvez l'étape la plus lente et celle qui coûte le plus pour le billet T-503354. Expliquez sa lenteur sans lire le raisonnement du modèle.
Afficher la réponse
python -m ops waterfall data/telemetry/release-full.jsonl.gz --ticket T-503354 affiche Longest step: triage, 9,013 ms (98% of the trace) (étape la plus longue : triage, 9 013 ms, soit 98 % de la trace) et Costliest step: chat chat-small, US$0.000650 … 1000 out (1000 of them reasoning), finish length (étape la plus coûteuse : chat chat-small, 0,000650 $ US, 1 000 jetons de sortie, tous pour le raisonnement, arrêt à la limite). L’API et la file d’attente ont pris environ 0,2 seconde. L’appel était lent parce que le modèle a consacré ses 1 000 jetons de sortie au raisonnement caché. La limite l’a arrêté. Le segment de trace montre la taille et la durée du raisonnement, pas son texte. Cela suffit pour orienter l’enquête vers la requête et la limite.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Associez chaque résultat, nombre de jetons et coût à la version de la requête et à la mise en production. Vous pourrez ainsi ventiler chaque chiffre par version.
- Un résultat de tâche indique ce qui est arrivé à chaque billet. Les catégories d’échec (
no_answer,dead_letter, …) pointent vers des causes et des responsables différents. - L’attribution des coûts associe le coût estimé de chaque appel à son segment de trace, son billet et sa version. Les billets en échec coûtent aussi de l’argent.
- La semaine dernière, v3 a coûté 40 % de plus et échoué sur un billet sur dix. Une trace a montré pourquoi : un appel de 9 secondes qui a consacré tous ses jetons au raisonnement.
Ensuite, vous examinez ce que la télémétrie contient d’autre : pourrait-elle divulguer le message d’un client? Vous mesurez ce que coûte chaque réglage de confidentialité.
Leçon suivante : Une observabilité qui respecte la vie privée