
Objectifs de service
- Leçon 3
- 55 min
- Module 1 : Définir la responsabilité opérationnelle
Où nous en sommes
Dans la leçon précédente, nous avons listé les 14 parties du service et le premier signe de panne de chacune. Mais nous ne sommes pas encore d'accord sur ce que « fonctionner » veut dire : la semaine dernière, le service était disponible 99,9 % du temps, et des clients attendaient quand même sans que personne s'occupe d'eux. Dans cette leçon, nous transformons chaque besoin des utilisateurs en un nombre avec une cible, comme une compagnie d'autobus qui fait une promesse qu'elle peut vérifier.
Leçon 3 sur 19 · MLOps et LLMOps : exploiter l'IA en productionObjectifs de service
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
« Disponible 99,9 % du temps » était vrai la semaine dernière. Pourtant, des clients attendaient sans que personne s’occupe d’eux. Transformez chaque besoin des clients et du service de soutien en un nombre avec une cible. Ainsi, « fonctionner » veut dire la même chose pour tout le monde. Calculez ensuite combien d’échecs chaque cible permet.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Faire tourner le service en production et Ce qui est exploité : l’étape de triage, la télémétrie enregistrée et
python -m ops. - Les centiles (p95), dans Latence et capacité.
- Facultatif : Attributs de qualité, dans le cours de conception de systèmes, définit aussi des SLO pour un système pas encore construit.
Ce qu’il vous faut sur votre ordinateur
- Votre projet à l’instantané
end-of-m01, avec la télémétrie enregistrée dansdata/telemetry/. Pas de Docker.
La promesse de la compagnie d’autobus
Section intitulée « La promesse de la compagnie d’autobus »Une compagnie d’autobus urbains ne peut pas promettre que chaque autobus sera à l’heure. La circulation, la neige et une porte brisée retardent certains autobus. La compagnie fait donc une promesse qu’elle peut tenir et vérifier : « 95 autobus sur 100 partent au plus 3 minutes après l’heure prévue, selon un décompte mensuel. »
Regardez ce que fait cette promesse. Elle nomme ce qui importe aux passagers : partir à l’heure, pas « les autobus circulent ». Elle dit comment compter un bon départ : au plus 3 minutes de retard. Elle donne une cible inférieure à 100 % et une période. Elle donne aussi un budget à la compagnie : sur 10 000 autobus par mois, 500 peuvent être en retard. Supposons que 400 soient en retard au 20 du mois. Le gestionnaire sait que le budget est presque épuisé. Il arrête les travaux routiers qui retardent les autobus.
Le service de soutien a besoin du même genre de promesse.
Le problème : le mauvais nombre était vert
Section intitulée « Le problème : le mauvais nombre était vert »Voici les mêmes cinq panneaux que dans Faire tourner le service en production, cette fois pendant la semaine normale :
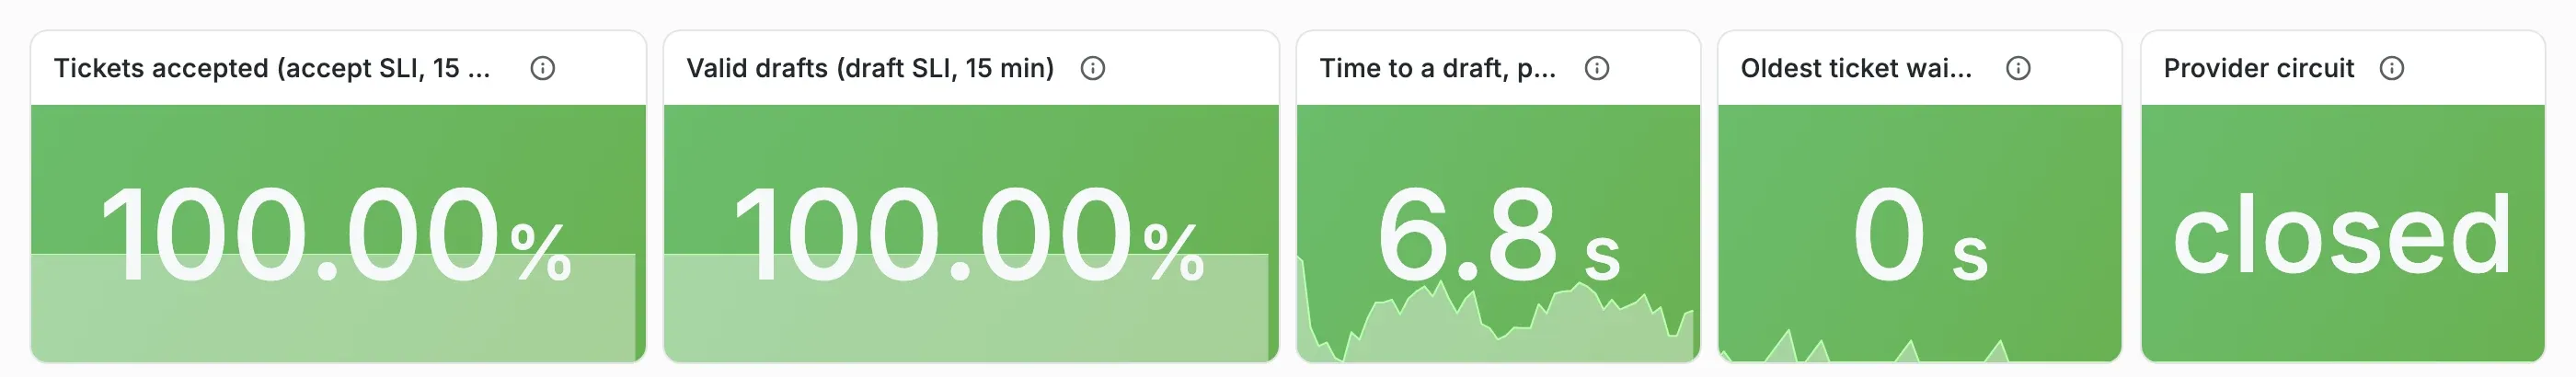
Pendant la semaine normale, le premier panneau indiquait 100,00 %. La semaine dernière, pendant le passage à la requête (prompt) v3, il indiquait aussi 100,00 %. Le nombre que tout le monde surveillait ne permettait pas de distinguer une bonne semaine d’une mauvaise. Il mesurait si l’API acceptait un billet de soutien. Les clients ne veulent pas simplement qu’un billet soit accepté. Ils veulent une réponse, et un billet lié à la sécurité doit parvenir à une personne.
Le deuxième panneau, celui des brouillons valides, a changé : 100,00 % pendant la semaine normale, 89,09 % la semaine dernière. Quelqu’un avait créé ce panneau. Mais personne n’avait dit quel nombre il devrait afficher. Personne ne savait donc que 89,09 % était mauvais.
L’idée : parcours, indicateurs et objectifs
Section intitulée « L’idée : parcours, indicateurs et objectifs »Partez des personnes, pas du service. Un parcours utilisateur est une chose qu’un utilisateur essaie de faire, du début à la fin. Exemples : « un client envoie un billet », « le service de soutien reçoit une décision et un brouillon ». Puis, pour chaque parcours, deux termes :
- Un indicateur de niveau de service, ou SLI, mesure la proportion de bons événements : bons événements ÷ tous les événements. Pour le parcours de rédaction : billets ayant reçu un triage valide en moins de 10 minutes ÷ tous les billets acceptés. Il indique le niveau du service que les utilisateurs reçoivent.
- Un objectif de niveau de service, ou SLO, est une cible pour un SLI, sur une fenêtre. Pour le parcours de rédaction : 99 % des billets, comptés sur une semaine de billets. C’est l’objectif pour ce niveau. Comme les 95 % de la compagnie d’autobus, c’est une décision, pas une mesure.
Le SLI est le compteur d’autobus à l’arrêt. Le SLO est la promesse sur le site Web de la compagnie.
Un petit exemple : dix billets
Section intitulée « Un petit exemple : dix billets »Dix clients envoient un billet. Voici ce qui arrive à chacun :
| Billet | Accepté (202)? | Triage valide? | Délai de rédaction | Bon pour « acceptation »? | Bon pour « rédaction »? |
|---|---|---|---|---|---|
| 1–8 | oui | oui | 3 à 6 s | oui | oui |
| 9 | oui | non : réponse sans texte | – | oui | non |
| 10 | oui | oui | 4 s | oui | oui |
Le SLI d’acceptation est de 10 bons événements ÷ 10 = 100 %. Le SLI de rédaction est de 9 bons événements ÷ 10 = 90 %. Les mêmes dix billets donnent deux nombres différents, car les deux parcours posent des questions différentes. Le billet 9 est une réussite pour l’API et un échec pour le client.
Avec un SLO de rédaction de 99 %, la cible permet 1 % de 10 = 0,1 mauvais billet. Un mauvais billet représente dix fois ce que la cible permet. Ce rapport porte un nom, le taux de consommation, que vous verrez plus bas.
Les objectifs de Larkfield
Section intitulée « Les objectifs de Larkfield »Amira, Priya et Grace ont écrit un SLO pour chaque parcours dans operations/slos.toml. Voici le bloc du parcours de rédaction :
[[slo]]id = "draft"journey = "The help desk gets a decision and a draft reply"sli = "accepted tickets with a valid triage (team, needs a person, draft) within 10 minutes"threshold_seconds = 600target = 0.99owner = "Amira"Les six parcours et la raison de chaque cible :
| SLO | Parcours | Bon événement | Cible | Pourquoi cette cible |
|---|---|---|---|---|
accept |
Un client envoie un billet | l’API l’accepte (202); les erreurs 4xx dues à l’appelant ne comptent pas | 99,9 % | Perdre un billet est grave, et l’accepter est simple. |
draft |
Le service de soutien reçoit une décision et un brouillon | un triage valide en moins de 10 minutes | 99 % | Même la bonne requête v2 donne une réponse sans texte sur 679. |
quality |
La décision est correcte | l’équipe et le besoin d’une personne concordent avec la révision de l’agent de soutien | 90 % | La requête v2 en bon état concorde avec les agents environ 94 % du temps; 90 % laisse une marge. |
safety |
Un billet qui nécessite une personne parvient à une personne | l’assistant l’a envoyé à une personne | 100 % | Aucun budget. Un seul manquement est un incident SEV-1. |
answer_time |
Un client pose une question | réponse en moins de 3 s | 95 % | Le site Web attend cette réponse. |
answer_sources |
Une réponse cite des documents à jour | chaque source est la version actuelle | 99 % | Une ancienne règle dans une réponse induit le client en erreur. |
Deux d’entre eux, quality et safety, dépendent des révisions des agents, qui arrivent plus tard. Ils sont tardifs : vous connaissez le résultat seulement après qu’une personne a vérifié le billet. Étiquettes tardives traite ce sujet.
Il y a aussi un budget : au plus 0,40 $ US par 1 000 billets pour les appels d’IA. Ce n’est pas un SLO. Les clients ne le ressentent pas, mais Kwame, oui.
La fenêtre se compte en billets. Une semaine chez Larkfield représente 822 billets par jour × 7 = 5 754 billets. Les scénarios d’exercice envoient une semaine de billets en 48 minutes. Comme la fenêtre se compte en billets, les mêmes nombres valent dans un exercice et dans la réalité.
Le budget d’erreur
Section intitulée « Le budget d’erreur »Les 95 % de la compagnie d’autobus laissaient un budget de 500 autobus en retard par mois. Un SLO fait la même chose. Le budget d’erreur est le nombre de mauvais événements que la cible permet dans la fenêtre :
budget d’erreur = (1 − cible) × tous les événements de la fenêtre
Pour le SLO de rédaction sur une semaine : (1 − 0,99) × 5 754 = 57,5 billets. Amira peut dépenser ce budget : pour une mise en production risquée, une journée lente chez un fournisseur ou la réponse « bougie d’allumage ». Une fois le budget épuisé, les utilisateurs ont subi plus d’échecs que la promesse le permet. Les mises en production cessent jusqu’à ce que le service respecte de nouveau son SLO.
La vitesse de consommation compte aussi. Le taux de consommation compare la proportion de mauvais événements à celle que la cible permet :
taux de consommation = (mauvais ÷ tous) ÷ (1 − cible)
Un taux de consommation de 1 utilise le budget exactement à la vitesse prévue : il s’épuise à la fin de la fenêtre. Un taux de 10 l’utilise dix fois plus vite : le budget d’une semaine s’épuise en moins d’une journée.
Laissons maintenant l’outil ops faire le décompte pour la semaine normale :
python -m ops slo data/telemetry/normal-week.jsonl.gz5,754 tickets, +0.0 min to +48.0 min; objectives from operations/slos.tomlSLO SLI (good/all) target budget bad used burn owner-------------- --------------------- ------ ------ --- ---- ---- -----accept 100.00% (5,754/5,754) 99.9% 5.8 0 0% 0.00 Amiradraft 99.93% (5,750/5,754) 99.0% 57.5 4 7% 0.07 Amiraquality * 94.32% (1,478/1,567) 90.0% 156.7 89 57% 0.57 Priyasafety * 100.00% (320/320) 100.0% 0.0 0 n/a n/a Graceanswer_time 100.00% (470/470) 95.0% 23.5 0 0% 0.00 Amiraanswer_sources 100.00% (470/470) 99.0% 4.7 0 0% 0.00 Tomás* from agents' reviews, which arrive later (delayed labels)Cost: US$0.341 per 1,000 tickets (budget US$0.40)Lisez la ligne draft de gauche à droite. Le SLI compte 5 750 bons événements sur 5 754 : 99,93 %. La cible est de 99 %, donc le budget est de 57,5 billets. Quatre étaient mauvais : la réponse « bougie d’allumage », tirée quatre fois. Ils ont utilisé 7 % du budget, à un taux de consommation de 0,07. Le budget de qualité se calcule seulement sur les billets révisés : 10 % des 1 567 révisions donnent 156,7, car sa cible est de 90 %. Chaque SLO est respecté, et le coût reste sous son budget. C’est une bonne semaine.
Avant de regarder la semaine dernière, essayez les cibles vous-même.
Explorer
Combien d'échecs chaque cible permet-elle?
Prédisez d’abord : Une cible de 99,9 % laisse-t-elle plus ou moins de place aux échecs que 99 %? Combien des 4 mauvais billets de la semaine normale chaque budget peut-il contenir?
- Budget pour une semaine (5 754 tickets)
- 57,5
- Semaine normale : mauvais tickets
- 4 sur 57,5
- « La semaine dernière » : budget épuisé au
- ticket 1 098
1 % de 5 754 tickets peuvent échouer : un budget de 57,5 tickets par semaine. La semaine normale a eu 4 mauvais tickets : 7 % d’un budget de 57,5. « La semaine dernière » a épuisé tout le budget au ticket 1 098, 497 tickets après la mise en service du prompt v3. Après 2 400 tickets, elle comptait 197 mauvais tickets : 3,4 fois le budget.
- Semaine normale (enregistrée)
- « La semaine dernière » (rejeu)
Description textuelle de l’explorateur
L’explorateur a une seule commande, la cible du SLO de rédaction : 99 %, 99,5 %, 99,9 % ou 99,99 %. L’affichage donne le budget pour une semaine et les mauvais billets de la semaine normale. Il indique aussi le billet auquel la reprise de la semaine dernière a épuisé tout le budget. L’axe des x du graphique représente les billets depuis le début de la semaine, de 0 à 5 754. L’axe des y représente le budget restant, en billets. La courbe de la semaine normale commence au budget et descend quatre fois. La courbe de la semaine dernière commence à la même hauteur et descend une fois au billet 346 (la réponse « bougie d’allumage »). Elle chute après le billet 601, où la requête v3 est entrée en production.
À 99 %, le budget est de 57,5 billets. La semaine normale en utilise 4 (7 %). La semaine dernière a épuisé le budget au billet 1 098, soit 497 billets après le changement. Elle s’est terminée avec 197 mauvais billets, soit 3,4 fois le budget. À 99,5 %, le budget est de 28,8, et la semaine dernière l’a épuisé au billet 848. À 99,9 %, le budget est de 5,8 billets. La semaine normale en utilise 70 %, et la semaine dernière l’a épuisé 36 billets après le changement. À 99,99 %, le budget est de 0,6 billet : un seul mauvais billet le dépasse. Même la semaine normale le dépasse, au billet 2 433. La semaine dernière l’a dépassé au billet 346, avant la mise en production de la requête v3.
Une cible plus élevée laisse moins de place aux échecs, pas plus. 99,9 % semble à peine mieux que 99 %, mais son budget est dix fois plus petit. Et à 99,99 %, la bonne requête v2 enfreint le SLO à elle seule, avec une réponse enregistrée. Une cible que le service en bon état ne peut pas atteindre n’est pas une promesse. C’est une alarme qui ne s’arrête jamais, et les gens apprennent à l’ignorer.
La semaine dernière, mesurée par rapport aux objectifs
Section intitulée « La semaine dernière, mesurée par rapport aux objectifs »python -m ops slo data/telemetry/release-full.jsonl.gz2,400 tickets, +0.0 min to +20.1 min; objectives from operations/slos.tomlSLO SLI (good/all) target budget bad used burn owner-------------- --------------------- ------ ------ --- --------- ---- -----accept 100.00% (2,400/2,400) 99.9% 2.4 0 0% 0.00 Amiradraft 91.79% (2,203/2,400) 99.0% 24.0 197 821% 8.21 Amiraquality * 86.68% (911/1,051) 90.0% 105.1 140 133% 1.33 Priyasafety * 98.08% (204/208) 100.0% 0.0 4 no budget n/a Graceanswer_time n/a (0/0) 95.0% 0.0 0 n/a n/a Amiraanswer_sources n/a (0/0) 99.0% 0.0 0 n/a n/a Tomás* from agents' reviews, which arrive later (delayed labels)Cost: US$0.440 per 1,000 tickets (budget US$0.40, OVER)Le tableau raconte maintenant ce que le nombre de disponibilité cachait :
- accept reste à 100 %. L’API n’a jamais échoué.
- draft est à 91,79 % : 197 mauvais billets contre un budget de 24 pour ces 2 400 billets. Le budget est consommé 8 fois, à un taux de consommation de 8,21.
- quality est sous sa cible : les décisions vérifiées par les agents concordent moins souvent.
- safety compte 4 manquements sur 208 billets révisés qui nécessitaient une personne. Avec une cible de 100 %, il n’y a aucun budget : chaque manquement est un incident. (Dix de ces billets ne sont parvenus à personne; seulement 4 avaient été révisés à la fin du fichier.)
- cost dépasse son budget : 0,440 $ US par 1 000 billets.
answer_timeetanswer_sourcesaffichentn/a (0/0)(sans objet, aucun événement) : personne n’a posé de question dans ce scénario. L’absence de données n’équivaut pas à de bonnes données.
Le graphique montre la même chose dans le temps, avec un point par 100 billets :
- SLI d'acceptation
- SLI de rédaction
- SLO de rédaction (99 %)
Description textuelle du graphique
L’axe des x compte les 2 400 billets de la semaine dernière, et chaque point représente un bloc de 100 billets. Le SLI d’acceptation est une ligne plate à 100 %, du début à la fin. Le SLI de rédaction est entre 99 % et 100 % pour les 600 premiers billets, avec la requête v2. Après le billet 601, où la requête v3 est entrée en production, il tombe entre 85 % et 93 % dans chaque bloc. C’est bien en dessous de la ligne pointillée de son SLO de 99 %.
Niveaux de gravité : à quel point est-ce grave?
Section intitulée « Niveaux de gravité : à quel point est-ce grave? »Un SLO vous dit que quelque chose ne va pas. Il ne vous dit pas s’il faut réveiller quelqu’un la nuit. Pour cela, Larkfield écrit des niveaux de gravité dans le même fichier. Un niveau de gravité est une catégorie d’incident, avec la réponse à lui donner :
| Niveau | Signification | Réponse |
|---|---|---|
| SEV-1 | Des clients peuvent subir un préjudice, ou beaucoup ne peuvent pas être servis : un billet de sécurité non envoyé à une personne, des billets perdus, les données d’un autre client affichées, ou aucun billet accepté. | Alertez immédiatement la personne de garde, à toute heure. Grace informe les clients touchés dans un délai de 1 heure. |
| SEV-2 | Un SLO consomme vite son budget : il serait épuisé en une journée de billets (822); ou une mise en production dégrade les réponses pour beaucoup de clients. | Alertez le responsable pendant la journée, dans un délai de 30 minutes. Arrêtez les mises en production jusqu’à la correction. |
| SEV-3 | Un SLO consomme lentement son budget, ou le coût dépasse son budget. | Un billet pour le responsable, le prochain jour ouvrable. |
| SEV-4 | Un seul échec; aucun SLO n’est menacé. | Notez-le pour la révision hebdomadaire. |
« Épuisé en une journée de billets » correspond à un taux de consommation que vous pouvez calculer. Le budget est prévu pour 5 754 billets. S’il s’épuise en 822 billets, le taux de consommation est de 5 754 ÷ 822 = 7. Tout taux de consommation de 7 ou plus est donc SEV-2.
Appliquez cela à la semaine dernière. Le SLO de rédaction avait un taux de consommation de 8,21; cela suffit pour un SEV-2. Mais le SLO de sécurité avait des manquements : des billets nécessitant une personne ne sont parvenus à personne. C’est SEV-1. L’incident a été SEV-1 pendant deux jours, et le tableau de bord était vert.
Quand utiliser les SLO et ce qu’ils coûtent
Section intitulée « Quand utiliser les SLO et ce qu’ils coûtent »Omar demande : « Pourquoi pas 100 % pour tout? On veut le meilleur service. »
Grace répond : « Alors chaque échec devient une urgence, et on ne livre jamais rien de nouveau. Une cible sous 100 % dit combien d’échecs on accepte, pour pouvoir dépenser ce budget sur des changements. La sécurité est le seul domaine où on n’en accepte aucun. »
Utilisez les SLO pour les parcours dont les utilisateurs se plaindraient, et limitez leur nombre : Larkfield en a six. Chacun demande du travail. Quelqu’un doit le mesurer, le surveiller et agir quand le budget se consomme. Un parcours sans responsable est un panneau de tableau de bord, pas un SLO. Choisissez les cibles selon ce que le service fait réellement, comme les 99 % pour les brouillons. Les réponses sans texte de v2 doivent tenir dans le budget. Ne changez une cible que volontairement, avec les personnes qui en dépendent.
À vous de jouer
Section intitulée « À vous de jouer »Grace se demande si la cible de rédaction devrait être de 99,5 %. Utilisez les nombres de la semaine dernière dans ops slo : 197 mauvais billets sur 2 400. Calculez le budget pour ces 2 400 billets, la proportion du budget utilisée et le taux de consommation. Quel est le niveau de gravité? Vérifiez ensuite vos nombres en modifiant target dans operations/slos.toml et en exécutant de nouveau ops slo. Remettez ensuite la cible à 0,99.
Une solution détaillée
Le budget est de (1 − 0,995) × 2 400 = 12 billets. La proportion utilisée est de 197 ÷ 12 = 16,4, soit 1 642 %. Le taux de consommation est de (197 ÷ 2 400) ÷ 0,005 = 0,0821 ÷ 0,005 = 16,42. C’est plus que 7; le SLO de rédaction suffit donc à donner SEV-2. Les manquements de sécurité font toujours de l’incident un SEV-1. Avec target = 0.995, ops slo affiche 12.0 dans la colonne du budget, puis 1642% et 16.42 sur la ligne draft. Une cible plus stricte ne change pas ce qui s’est passé. Elle change la force avec laquelle les nombres le signalent.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Deux nombres pour le même SLI : 89,09 % dans Grafana, 91,79 % dans ops
Symptôme : le panneau Grafana de la semaine dernière affiche un SLI de rédaction de 89,09 %. ops slo, avec la même télémétrie, indique 91,79 %. L’un des deux semble faux.
Cause : ils comptent des fenêtres différentes. Le panneau compte les 15 dernières minutes de l’exécution, où la requête v3 était active pour chaque billet. ops slo compte tout le fichier, y compris les 600 billets avec la requête v2 au début.
Diagnostic : lisez toujours la fenêtre à côté du nombre. Le titre du panneau indique « 15 min ». ops slo affiche sa fenêtre sur la première ligne : 2,400 tickets, +0.0 min to +20.1 min (2 400 billets, de +0,0 à +20,1 minutes).
Correction : comparez les nombres sur la même fenêtre. python -m ops slo FILE --last 822 compte seulement les 822 derniers billets, soit une journée de billets chez Larkfield. Pour la semaine dernière, il donne un SLI de rédaction de 89,54 % et un taux de consommation de 10,46.
Erreur courante
n/a interprété comme un bon résultat
Symptôme : dans le tableau de la semaine dernière, answer_time et answer_sources affichent n/a (0/0). Un résumé disant « 4 SLO sur 6 ont échoué » les compte comme respectés.
Cause : aucun événement signifie aucune mesure. Personne n’a posé de question dans ce scénario, donc il n’y a rien à évaluer.
Correction : indiquez « aucune donnée » comme un état distinct. Si un parcours qui devrait avoir du trafic affiche 0/0 en production, c’est aussi un problème : une fonctionnalité ou une télémétrie défectueuse.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Expliquez comment un service peut être disponible sans répondre aux besoins des utilisateurs. Utilisez les deux SLI de la semaine dernière.
Afficher la réponse
La disponibilité mesurait un parcours : un client envoie un billet. Le SLI d’acceptation était de 100,00 % (2 400 sur 2 400) : tous les billets ont été enregistrés. Mais le parcours du service de soutien a échoué. Le SLI des brouillons était de 91,79 % (2 203 sur 2 400). La requête v3 a produit 186 réponses sans texte, et 10 billets sont devenus des messages non livrables. L’API avait déjà répondu 202, donc elle ne pouvait pas voir l’échec. Dix billets qui nécessitaient une intervention humaine n’ont atteint personne : un incident SEV-1. Un service « fonctionne » seulement pour les parcours que vous mesurez.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : la cible du SLO des brouillons passe de 99 % à 99,9 %. Que devient le budget d'erreur hebdomadaire? La semaine normale respecte-t-elle encore le SLO?
Afficher la réponse
Le budget devient dix fois plus petit : (1 − 0,999) × 5 754 = 5,8 billets au lieu de 57,5. Les 4 billets problématiques de la semaine normale restent dans le budget (70 % du budget). La semaine respecte donc encore le SLO, mais il reste peu de marge. À 99,99 %, le budget est de 0,6 billet. La requête v2, pourtant saine, le dépasse avec une seule réponse sans texte enregistrée.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : exécutez ops slo sur la semaine dernière avec --last 822. Quels sont le SLI des brouillons et son taux de consommation? Quel niveau de gravité ce taux seul indique-t-il?
Afficher la réponse
python -m ops slo data/telemetry/release-full.jsonl.gz --last 822 affiche 822 tickets, +13.2 min to +20.1 min (822 billets, de +13,2 à +20,1 minutes). La ligne draft (brouillon) affiche 89.54% (736/822), un budget de 8.2, 86 billets problématiques et un taux de consommation de 10.46. Un taux de consommation de 7 ou plus épuise le budget hebdomadaire en une seule journée de billets : c’est SEV-2. La ligne de sécurité, 95.83% (46/48), indique des échecs, donc l’incident est SEV-1.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un parcours utilisateur est une chose qu’un utilisateur essaie de faire. Un SLI est la proportion d’événements réussis dans ce parcours. Un SLO est la cible de cette proportion sur une période. Larkfield a six SLO et un budget de coûts, dans
operations/slos.toml. - Le budget d’erreur est (1 − cible) × événements : 57,5 billets par semaine pour les brouillons à 99 %. Le taux de consommation indique à quelle vitesse ce budget s’épuise; 7 ou plus correspond à SEV-2.
- Semaine dernière : acceptation à 100,00 %, brouillons à 91,79 % (consommation de 8,21), échecs de sécurité : un SEV-1 derrière une « disponibilité » au vert.
- Une cible plus élevée laisse moins de marge. Une cible que le service sain ne peut pas atteindre crée du bruit.
Ensuite, vous attribuez un responsable à chaque partie et à chaque SLO, et vous indiquez qui appeler en premier.
Leçon suivante : Responsabilité et soutien