
Tirer des leçons après un incident
- Leçon 19
- 50 min
- Module 6 : Gérer les incidents et la passation
Où nous en sommes
Dans les deux leçons précédentes, nous avons écrit des guides d'exploitation et traversé une panne du fournisseur. Mais un incident terminé n'est pas encore un incident dont nous avons tiré des leçons. Dans cette leçon, nous revenons à l'incident de la requête v3 de la semaine dernière et nous écrivons une analyse sans blâme : ce qui s'est passé, pourquoi le système l'a permis et ce qui change. Nous commençons par un petit incendie dans une cuisine.
Leçon 19 sur 19 · MLOps et LLMOps : exploiter l'IA en productionTirer des leçons après un incident
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
Tirez des leçons d’un incident pour éviter qu’il se reproduise. Notez ce qui s’est passé et pourquoi le système l’a permis. Indiquez les changements, chacun avec un responsable, sans blâmer une personne.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- « La semaine dernière », l’incident de la requête v3, dans Faire tourner le service en production et Objectifs de service.
- Les guides d’exploitation et
python -m ops alerts, dans Guides d’exploitation.python -m ops incidentet le recours à une personne, dans Pannes des fournisseurs et des dépendances. - La barrière et le déploiement canari, dans Barrières d’évaluation et Déploiements contrôlés.
Ce qu’il vous faut sur votre ordinateur
- Votre projet après la dernière leçon, avec le simulateur, l’API et le processus en marche.
- La télémétrie enregistrée dans
data/telemetry/.
La poêle sur la cuisinière
Section intitulée « La poêle sur la cuisinière »Une famille subit un petit incendie dans sa cuisine. Quelqu’un a laissé une poêle d’huile sur la cuisinière, et le détecteur de fumée n’a pas sonné. Personne n’a été blessé.
La famille peut demander « qui a laissé la poêle sur le feu? » C’est l’adolescent, qui est allé répondre à la porte. Tout le monde convient qu’il faut faire plus attention. Le mois suivant, quelqu’un d’autre répond à la porte en laissant une poêle sur la cuisinière.
Ou la famille peut demander « comment une poêle a-t-elle pu brûler sans que personne le remarque? » Elle découvre alors d’autres choses. La pile du détecteur était à plat, la couverture anti-feu était dans le garage, et la cuisinière n’a pas de minuterie. La famille peut changer chacun de ces éléments. Chaque changement la protège, peu importe qui cuisine.
Le problème : une analyse qui blâme ne règle rien
Section intitulée « Le problème : une analyse qui blâme ne règle rien »La semaine dernière, chez Larkfield, la requête est passée de v2 à v3 pour tous les billets de soutien. Une analyse qui blâme s’écrit vite : « Omar a changé la requête après que l’évaluation a indiqué DO NOT SHIP (ne pas livrer). Omar doit suivre le processus. »
Voyez ce que cette analyse omet. Dans la simulation de l’incident, avec de vraies réponses enregistrées :
- Le changement était un changement de paramètre. Rien dans le système ne l’a bloqué, n’a exigé une barrière ou ne l’a limité à un déploiement canari.
- 186 des 1 798 billets traités avec la requête v3 ont reçu une réponse sans texte, et les tâches ont échoué silencieusement. Rien n’a envoyé ces billets à une personne.
- Le tableau de bord affichait le SLI d’acceptation, 100,00 %, comme « disponibilité ». Rien ne mesurait les brouillons.
- La seule alerte qui aurait pu aider,
no-answer(sans réponse), s’était déjà déclenchée pour un billet avec la requête fonctionnelle. Elle ressemblait donc à du bruit.
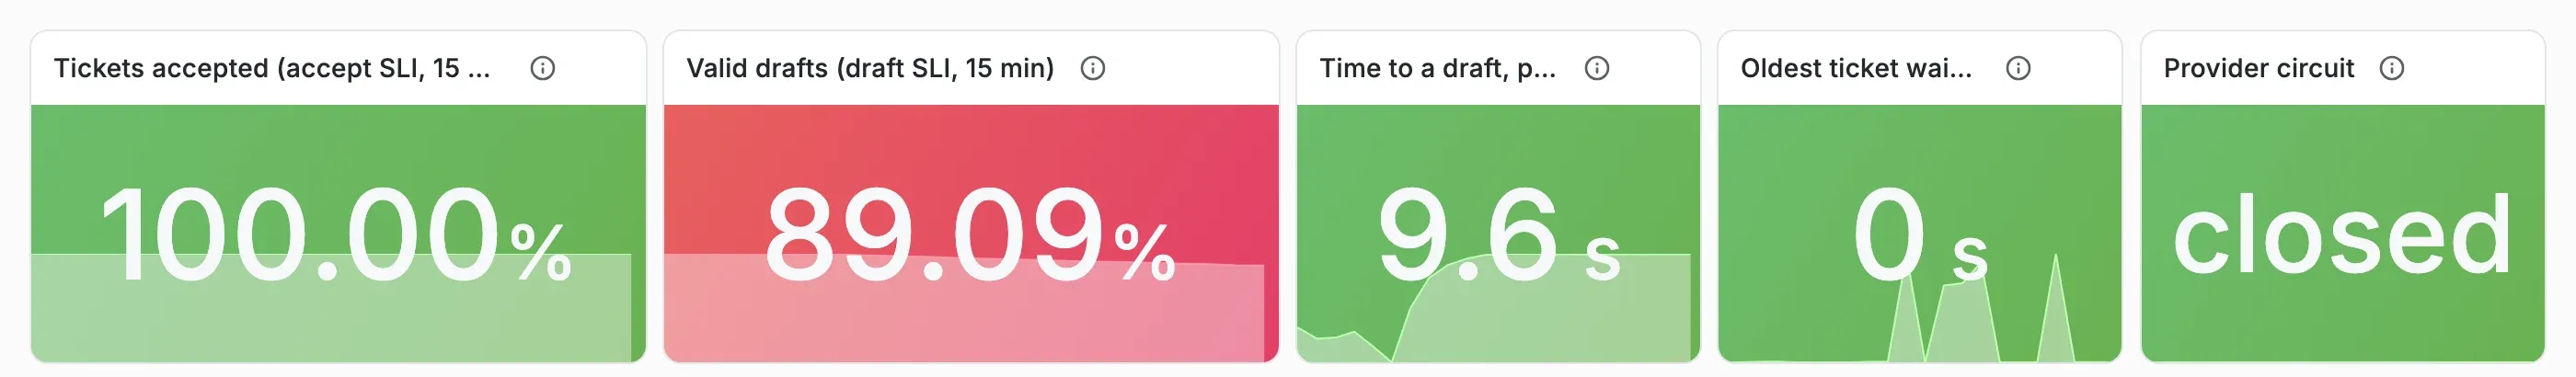
« Omar doit suivre le processus » ne change rien à tout cela. La prochaine personne qui subit une pression pour économiser fera la même chose, et le système la laissera faire.
L’idée : l’analyse demande comment le système a permis l’incident
Section intitulée « L’idée : l’analyse demande comment le système a permis l’incident »Une analyse post-incident est un compte rendu écrit d’un incident : ce qui s’est passé, pourquoi, et ce qui change. On l’appelle souvent un postmortem. Elle est sans blâme : elle suppose que les gens ont agi raisonnablement avec ce qu’ils savaient et voyaient alors. Elle cherche les conditions qui ont rendu l’erreur possible et difficile à remarquer.
Elle distingue deux types de raisons :
- La cause : le changement qui a déclenché les dommages. Ici : avec la requête v3, le modèle raisonne jusqu’à sa limite de jetons sur certains billets, sans rien écrire.
- Les conditions contributives : les faiblesses qui ont laissé la cause atteindre les clients et passer inaperçue. Chacune est un trou qu’un meilleur système boucherait.
Une image aide. Pensez à des tranches de fromage suisse, l’une derrière l’autre. Chaque tranche est une défense : une barrière, un recours de secours, un tableau de bord, une alerte. Chacune a des trous. Les dommages passent seulement quand les trous s’alignent. Une analyse trouve tous les trous, pas seulement le premier.

Description textuelle du diagramme
La cause est la requête v3, qui ne produit aucun texte pour environ 10 % des billets. Pour atteindre les clients, elle a traversé quatre trous. C’était un changement de paramètre sans barrière ni déploiement canari. Aucun recours de secours n’existait pour un billet sans réponse. Le tableau de bord affichait seulement la disponibilité, et l’alerte sans réponse était déjà bruyante. Résultat : 10 billets qui nécessitaient une personne n’ont atteint personne. Chaque trou a une action. Une mise en production reçoit une barrière et un déploiement canari (Priya, Omar). Un billet sans réponse va à une personne (Amira). Le tableau de bord principal reçoit des SLO de brouillon et de sécurité (Amira, Grace). Priya examine le cas connu de v2.
Un petit exemple : la cuisine, sous forme d’analyse
Section intitulée « Un petit exemple : la cuisine, sous forme d’analyse »Présentez l’incendie de cuisine sous forme d’analyse, en montrant chaque partie :
| Partie | La cuisine |
|---|---|
| Impact | Fumée dans la cuisine; une poêle brûlée; personne de blessé |
| Chronologie | 18 h 02 huile sur le feu; 18 h 05 sonnette; 18 h 12 fumée; 18 h 13 quelqu’un la voit; 18 h 14 couvercle sur la poêle |
| Cause | Quelqu’un a laissé une poêle d’huile sur un feu vif |
| Conditions contributives | la pile du détecteur était à plat; la couverture anti-feu était dans le garage; la cuisinière n’a pas de minuterie |
| Actions, avec responsables | nouvelle pile et test mensuel (papa); couverture anti-feu près de la cuisinière (maman); minuterie pour la friture (l’adolescent) |
| Comment vérifier la correction | appuyer sur le bouton de test du détecteur le 1er de chaque mois; la couverture est sur son crochet |
Regardez les actions. Chacune change une chose, pas l’attitude d’une personne. Chacune a un responsable et une vérification. « Faire plus attention » manque volontairement : cette action n’a ni responsable ni vérification.
La chronologie montre aussi le délai qui est au cœur de l’analyse. Il s’est écoulé 7 minutes entre la première fumée et la première personne qui l’a vue. En logiciel, ce délai est celui de la détection.
L’analyse de Larkfield : PIR-001
Section intitulée « L’analyse de Larkfield : PIR-001 »L’analyse de la semaine dernière se trouve dans operations/reviews/PIR-001-prompt-v3.md. Ouvrez ce fichier. Son en-tête :
| Gravité | SEV-1 (des billets qui nécessitaient une personne n’ont atteint personne) |
| Responsable de cette analyse | Priya |
| Personnes | Amira (service), Priya (requête), Grace (clients), Omar (changement), Kwame (coût) |
| État | actions ouvertes |
Omar participe à la réunion, puisqu’il a fait le changement. Il sait mieux que quiconque pourquoi la requête moins coûteuse semblait sûre, et l’analyse a besoin de ce savoir. Il est aussi responsable de l’action sur le déploiement canari.
Construire la chronologie à partir de la télémétrie
Section intitulée « Construire la chronologie à partir de la télémétrie »Une chronologie faite de mémoire contient des détails erronés. Construisez-la à partir de la simulation enregistrée de l’incident :
python -m ops incident data/telemetry/release-full.jsonl.gzTimeline (what happened, in order):when kind event--------- -------- ----------------------------------------------------------------------------+0.0 min practice scenario start+0.0 min practice simulator mode: normal+0.0 min practice ops rollout start 1.5.0-4fafd1 --reason practice scenario release-full+0.0 min grafana alert firing: no-answer+0.0 min release release: active 1.5.0-4fafd1+0.3 min grafana alert resolved: no-answer+3.2 min alert no-answer fired+3.3 min grafana alert firing: no-answer+5.0 min practice ops rollout start 1.5.0-767b56 --reason the cheaper prompt, for every ticket+5.0 min release release: active 1.5.0-767b56+9.7 min alert triage-slow fired+10.0 min grafana alert firing: triage-slow+10.6 min grafana alert firing: draft-fast-burn+10.7 min alert draft-fast-burn fired+10.8 min alert reviews-disagree fired+11.2 min alert cost-over-budget fired+13.8 min grafana alert firing: cost-over-budget+18.2 min alert draft-fast-burn resolved+18.3 min grafana alert resolved: draft-fast-burn+20.0 min practice scenario endLa sortie continue avec les billets par période. La vérification du rétablissement de la dernière période est [ ] drafts are valid: 31 without a valid draft (first period 0) (brouillons valides : 31 sans brouillon valide, contre 0 à la première période). La case est vide : rien n’a été rétabli, car personne n’a agi.
La chronologie de l’analyse garde les lignes importantes, en mots simples. Elle ajoute ce que la télémétrie ne peut pas savoir (tiré du tableau de l’analyse) :
| Quand | Quoi |
|---|---|
| +0.0 | Requête v2 active (version 1.5.0-4fafd1). |
| +3.2 | L’alerte no-answer se déclenche : la requête v2 a une réponse enregistrée sans texte (billet de simulation T-65450). Personne n’agit : cela ressemble à du bruit. |
| +5.0 | La requête v3 devient active pour tous les billets (version 1.5.0-767b56). Aucun déploiement canari, aucune barrière. |
| +7.9 | Premier billet de sécurité sans réponse (T-65663). |
| +9.7 | triage-slow (triage lent) se déclenche (règles sur la télémétrie enregistrée; Grafana : +9.95). |
| +10.7 | draft-fast-burn (épuisement rapide du budget de brouillons) se déclenche : SEV-2 (Grafana : +10.6). |
| +10.8 | reviews-disagree (désaccord entre les révisions) se déclenche. |
| +11.2 | cost-over-budget (coût supérieur au budget) se déclenche (Grafana : +13.8). |
| +20.1 | Fin de la simulation. Personne n’est revenu à la version précédente : lors de l’incident réel, ces alertes n’existaient pas encore. |
La simulation tourne environ 210 fois plus vite que le trafic réel de Larkfield. Les 15 minutes de v3 dans la simulation, soit 1 798 billets, représentent donc environ deux jours de billets réels. Ce sont les « deux jours » pendant lesquels les clients ont attendu.
Description textuelle du graphique
L’axe des x montre les 20 minutes de simulation; environ 120 billets se terminent chaque minute. Pendant les 5 premières minutes, avec la requête v2, la ligne est à 0. La seule exception est 1 billet à la minute 4, le cas connu de v2. Dès la minute 6, après le passage à la requête v3, elle monte entre 7 et 19 billets par minute. C’est environ 11 % en moyenne, et elle reste à ce niveau jusqu’à la fin. L’alerte draft-fast-burn se déclenche à la minute 10,7.
Le graphique montre le délai de détection en une seule image. Les billets problématiques apparaissent dès la première minute après le changement. Les alertes suivent de 4,7 à 6,2 minutes plus tard. À vitesse réelle, environ 210 fois plus lente, cela représente des heures. Voilà pourquoi l’analyse ne propose pas « une alerte plus rapide », mais un déploiement canari. Celui-ci limite les dommages en attendant les alertes.
Causes et conditions contributives
Section intitulée « Causes et conditions contributives »PIR-001 énumère une cause et quatre conditions contributives. Ce sont les trous du schéma ci-dessus :
- La cause : la requête v3 demande une réponse complète et précise. Le modèle raisonne alors jusqu’à la limite de jetons sur certains billets (25 sur 271 dans l’évaluation; 10,3 % ici).
- Le changement de requête a été fait comme un changement de paramètre, pas une mise en production : aucun manifeste, aucune barrière, aucun déploiement canari.
- Une tâche sans réponse valide échouait silencieusement. Le billet restait dans l’équipe par défaut, sans prévenir personne (aucun recours de secours).
- Le tableau de bord affichait seulement le parcours d’acceptation (« disponibilité »); rien ne mesurait le parcours de brouillon.
- L’alerte
no-answers’était déclenchée avant le changement pour un billet de la requête v2. Une nouvelle alerte ressemblait donc au même bruit.
Lisez la formulation. Aucun élément ne nomme une personne. L’élément 2 concerne le changement d’Omar, mais décrit ce que le système permettait : atteindre tous les clients avec un seul paramètre.
Actions avec responsables
Section intitulée « Actions avec responsables »| Action | Responsable | Réalisée dans |
|---|---|---|
Un billet sans réponse valide va à une personne (TRIAGE_FALLBACK=person) |
Amira | Module 6 |
Chaque changement de requête est une mise en production avec un manifeste, et passe la barrière (ops gate) |
Priya | Modules 2 et 5 |
Chaque mise en production commence par un déploiement canari à 10 %, avec des règles de retour arrière (operations/rollout.toml) |
Omar | Module 5 |
| Les SLO des parcours de brouillon et de sécurité, et leurs alertes, figurent sur le tableau de bord principal | Amira, Grace | Modules 1 et 3 |
L’alerte no-answer contient un lien vers le billet. Le cas connu de v2 (T-65450) est examiné pour rendre l’alerte fiable |
Priya | Module 6 |
| Le délai d’expiration du fournisseur couvre la réponse enregistrée la plus lente, ou une réponse longue n’est pas retentée 5 fois | Kwame | ouverte |
Une bonne action a quatre propriétés. Elle change le système, pas un sentiment. Elle nomme un responsable. Elle indique quand elle est terminée. Et elle peut être vérifiée. Regardez la dernière ligne. Un enregistrement de v3 a pris 12,1 secondes, plus que le délai d’expiration de 10 secondes. Son billet a donc expiré à chaque tentative et fini parmi les messages non traités, 10 fois dans la simulation. L’action est ouverte, et l’analyse le dit. Un état « ouvert » honnête vaut mieux qu’un vague « terminé ».
Vérifier qu’une action fonctionne
Section intitulée « Vérifier qu’une action fonctionne »L’état « terminé » dans le tableau des actions exige aussi des preuves. Vous pouvez vérifier la première action, le recours de secours, sur votre propre service. Vous faites volontairement répondre la requête v3 à certains billets. Vous vérifiez qu’aucun billet sans réponse n’est laissé seul.
-
Arrêtez l’API et le processus avec Ctrl+C. Déplacez vos fichiers de télémétrie vers un autre dossier, par exemple
telemetry/before/. Ainsi, le prochain compte ne contiendra que ces billets. Redémarrez l’API et le processus. Activez ensuite la version de la requête v3, comme changement de simulation. Utilisez votre propre identifiant v3 de Barrières d’évaluation :Fenêtre de terminal python -m ops rollout start 1.5.0-422985 --by Amira --reason "practice: check the fallback with prompt v3"start: active 1.5.0-422985. The worker takes it within 5 seconds.Utilisez l’état de mise en production, pas le paramètre
ASSISTANT_PROMPT. Depuis le module 5, le processus suit l’état de mise en production dans la base de données.RELEASE_IDprend aussi priorité surASSISTANT_PROMPT. Un processus démarré avecASSISTANT_PROMPT=assistant-v3répondrait quand même avec la requête v2. -
Envoyez 40 billets de simulation :
Fenêtre de terminal python -m scripts.practice --tickets 40 --rate 2 --seed 11Sent 40 practice tickets in 19.5 s: 202: 40 -
Attendez que la file soit vide. Regardez le journal du processus. Chaque billet sans réponse valide a deux lignes comme celles-ci, après l’heure :
WARNING ticket_api.worker [a6bfef76f157]: ticket T-500186: no valid answer, sent to a personINFO ticket_api.worker [a6bfef76f157]: job 186: succeeded (attempt 1)Consultez cette tâche :
curl http://127.0.0.1:8000/v1/jobs/186, avec votre propre numéro de tâche. La fin de sa réponse :"state":"succeeded", … "result":{"team":"other","priority":1,"needs_human":true,"draft_reply":null,"embedding_version":"embed-small-384-v1"}Le billet n’a ni décision d’équipe ni brouillon, mais
needs_human(nécessite une personne) est vrai et la priorité est 1. Il est en tête de la file des agents de soutien. -
Comptez les résultats dans votre télémétrie :
Fenêtre de terminal python -m ops summary telemetry/ticket-api.jsonl telemetry/ticket-worker.jsonlRecords: 81 logs, 780 spans, 96 metric records, from +0.0 min to +1.1 minTicket requests: 40 (202: 40)Tickets triaged: 40 (ok: 37, sent_to_person: 3)Prompt versions: assistant-v3 40Where the answers come from: replayed 40 (100.00%)Sent to a person (needs_human): 17 (42.50%)Agents' reviews (delayed labels): 0; answers to questions: 03 billets sur 40 n’ont reçu aucune réponse valide de la requête v3, soit environ les 10,3 % de la semaine dernière. Chacun est
sent_to_person(envoyé à une personne); aucun n’est une tâche échouée. Vos comptes peuvent différer. -
Réactivez la version de la requête v2, avec votre propre identifiant v2 :
Fenêtre de terminal python -m ops rollout start 1.5.0-5a4f87 --by Amira --reason "practice done: back to prompt v2"
L’action fonctionne : un billet sans réponse attend maintenant une personne, au lieu de n’attendre personne. Il reste deux choses à voir. D’abord, python -m ops alerts sur les mêmes fichiers affiche encore no-answer comme still firing (toujours active). C’est normal : le recours de secours protège le client, mais la requête reste mauvaise, et quelqu’un doit le savoir. Ensuite, les tests vérifient l’ancien comportement. Avec TRIAGE_FALLBACK=none, tests/test_jobs.py attend que la tâche échoue, comme la semaine dernière.
Quand rédiger une analyse, et ce qu’elle coûte
Section intitulée « Quand rédiger une analyse, et ce qu’elle coûte »Sam demande : « On en écrit une pour chaque alerte? »
Grace répond : « Non. Pour chaque SEV-1 et SEV-2, dans les 5 jours ouvrables. Un SEV-3 reçoit une ligne dans les notes hebdomadaires. »
Rédigez une analyse pour les incidents qui ont nui aux clients ou rapidement épuisé le budget d’un SLO. Faites-le aussi pour les incidents évités de justesse qui auraient pu le faire. Le déploiement canari qui a détecté v3 mérite une demi-page. N’en rédigez pas pour trouver qui avait tort. Si les gens s’attendent à être blâmés, ils cessent de signaler les incidents évités de justesse, et les analyses disparaissent.
Ce qu’elle coûte : une réunion d’environ une heure avec les personnes concernées, et quelques heures de rédaction. Les actions elles-mêmes sont la partie coûteuse. Une analyse dont les actions ne se terminent jamais est un document, pas un apprentissage.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
L'action est « faire plus attention »
Symptôme : le tableau des actions dit « Omar vérifiera l’évaluation avant de changer les requêtes », ou « Tout le monde : faire plus attention aux mises en production ».
Cause : l’analyse s’est arrêtée à la personne. Une action sur l’attention n’a aucune vérification, et elle échoue la prochaine fois que quelqu’un est occupé.
Correction : demandez « qu’est-ce qui bloquerait cela, peu importe qui fait le changement? » Ici : une barrière qui refuse la mise en production, et un déploiement canari qui la limite. Chacun a un responsable et un test.
Exercice du module : une simulation sur table
Section intitulée « Exercice du module : une simulation sur table »L’exercice de ce module : faites une simulation sur table d’une panne de fournisseur ou d’une mise en production défectueuse. Une simulation sur table est un incident d’entraînement sur papier. Un animateur lit les événements, minute par minute. L’équipe explique ce qu’elle fait, le guide d’exploitation ouvert. Rien ne tombe réellement en panne. Vous testez les personnes et les guides d’exploitation, pas le code. D’abord, voici un exemple détaillé où chaque étape est visible. Ensuite, vous faites votre propre simulation.
Exemple détaillé : une mise en production défectueuse, avec la relecture de la semaine dernière
Section intitulée « Exemple détaillé : une mise en production défectueuse, avec la relecture de la semaine dernière »Priya anime. Amira est de garde, Grace représente les clients. La relecture enregistrée fournit les faits. Chaque « événement » est une ligne que l’animatrice lit, tirée de python -m ops alerts et ops incident sur release-full.jsonl.gz :
| Événement (minute de simulation) | L’animatrice dit | L’équipe répond, avec le guide d’exploitation bad-release.md |
Constat |
|---|---|---|---|
| +3,2 | « no-answer (aucune réponse) se déclenche, SEV-2. » |
Amira suit l’étape 1 du triage : une absence de réponse, version 1.5.0-4fafd1, billet de soutien fictif T-65450, le cas connu. Elle le note et ne réveille pas Priya pendant la nuit. | Le guide d’exploitation n’a aucune ligne sur le cas connu. Action : l’ajouter, avec l’identifiant du billet. |
| +5,0 | « Quelqu’un remplace la version active par 1.5.0-767b56 pour tous les billets. » | Personne ne le voit : aucune alerte ne se déclenche lors d’un changement de version. | Action : envoyer l’événement de changement de version dans le clavardage de l’équipe. |
| +10,7 | « draft-fast-burn se déclenche, SEV-2. » |
Étape 1 du triage : la version 1.5.0-767b56 a 10,3 % de réponses absentes, v2 en a une. Étape 2 : elle a changé à +5,0. Atténuation : ops rollout rollback. |
Cela fonctionne, mais 5,7 minutes après le changement. |
| +10,9 | « Grace demande : un billet lié à la sécurité est-il resté sans réponse? » | Le guide dit de trouver les billets avec le résultat no_answer (aucune réponse) depuis la mise en production, en commençant par la sécurité. Amira ne sait pas comment les lister. |
Action : ajouter la commande au guide d’exploitation. |
| après le retour arrière | « Comment savez-vous que c’est terminé? » | Vérifications du rétablissement : la ligne du déploiement canari de ops canary et la dernière période de ops incident ne doivent montrer aucune nouvelle absence de réponse au-delà du cas connu de v2. |
Les vérifications fonctionnent. |
Résultat : trois actions pour le guide d’exploitation, chacune avec un responsable. Priya s’occupe du cas connu et de la liste de sécurité, Amira de l’événement de changement de version. L’exercice a pris 30 minutes et n’a rien brisé.
À vous : une panne de fournisseur de 30 minutes
Section intitulée « À vous : une panne de fournisseur de 30 minutes »Faites une simulation sur table du guide d’exploitation pour les pannes de fournisseur (operations/runbooks/provider-outage.md). Utilisez les faits de l’exécution de panne enregistrée. Mais dites à l’équipe que la panne dure 30 minutes au rythme réel de Larkfield, pas 5 minutes de simulation.
- Écrivez cinq événements, chacun avec une minute de simulation et une phrase. Tirez les trois premiers de
python -m ops incident data/telemetry/outage.jsonl.gz. Inventez les deux derniers et indiquez « construit » : un concernant un client, et un concernant un billet lié à la sécurité. - Pour chaque événement, écrivez ce que le guide demande à la personne de garde de faire, et qui agit.
- Notez chaque lacune du guide sous forme d’action avec un responsable.
- Écrivez les vérifications du rétablissement qui permettraient de clore l’incident, chacune avec la commande qui fournit sa valeur.
Solution détaillée
Événements et réponses (les trois premiers viennent de l’exécution enregistrée; les temps correspondent au début d’une vraie panne) :
| Événement | Réponse du guide d’exploitation | Qui |
|---|---|---|
+0,6 : provider-circuit-open se déclenche, SEV-2 |
Triage : est-ce le fournisseur? curl http://127.0.0.1:8300/admin/stats pendant l’exercice, la page d’état du fournisseur en situation réelle. Perd-on des billets? Non : GET /v1/queue augmente, l’indicateur de niveau de service d’acceptation est à 100 %. Atténuation : ne rien faire aux processus. |
Amira |
+3,1 : drafts-late se déclenche, SEV-2; GET /v1/status indique « delayed » (retardé) |
Le site Web affiche automatiquement le message de retard. L’équipe de Grace lit la file d’attente pour repérer les mots liés à la sécurité. | Amira, Grace |
| +5,0 : toujours en panne | Attendre : le disjoncteur teste la connexion toutes les 30 secondes. Ne pas augmenter les nouvelles tentatives ni le délai d’expiration. | Amira |
| +15, construit : « Un client appelle : j’ai envoyé mon billet deux fois, vais-je recevoir deux réponses? » | Le message d’état disait de ne pas le renvoyer. Deux billets existent; les agents les fusionnent. Lacune : le guide ne dit rien sur les billets en double. | Grace |
| +20, construit : « Un billet indique : de la fumée sort du chargeur. » | Il attend dans la file comme les autres. Le guide dit que les agents lisent la file manuellement, mais pas comment. Lacune : aucune commande ne liste les billets en attente contenant des mots liés à la sécurité. | L’équipe de Grace |
| +30 | L’objectif de niveau de service des brouillons n’est plus respecté pour les premiers billets à partir d’environ +9 minutes, selon le calcul de la dernière leçon. SEV-2 reste; escalade après 15 minutes : Kwame demande au fournisseur une estimation du délai de rétablissement; après 30 minutes, Grace met à jour la page d’aide. | Kwame, Grace |
Actions : une ligne du guide sur les billets en double (Grace); une commande ou un panneau de tableau de bord qui liste les billets en attente contenant des mots liés à la sécurité, utilisé par les agents (Amira); les coordonnées du soutien du fournisseur et le numéro de contrat dans le guide (Kwame); un registre de décision sur l’intérêt d’un deuxième fournisseur, compte tenu du coût de son évaluation après une panne de 30 minutes (Kwame, en suspens).
Vérifications du rétablissement, chacune avec sa valeur :
- disjoncteur fermé : le journal du processus, ou la chronologie de
python -m ops incident; - file d’attente vidée :
GET /v1/queue,oldest_queued_secondssous 120; - aucun message non traité :
GET /v1/queue,dead_letterà 0, ou une nouvelle tentative pour chacun; - brouillons valides et à temps : la dernière période complète de
ops incident; - clients informés de la fin de l’incident :
GET /v1/statusindique ok, et Grace a retiré la note de la page d’aide.
Vérification finale : restaurez un état fiable connu et prouvez-le
Section intitulée « Vérification finale : restaurez un état fiable connu et prouvez-le »Restaurez le service de Larkfield à sa version fiable connue et listez les preuves qui confirment le rétablissement. Utilisez votre propre service pour la restauration, et l’exécution canari enregistrée pour les preuves d’un retour arrière complet.
- Activez la version
1.5.0-4fafd1(requête v2) avecpython -m ops rollout, en donnant une raison. - Montrez que cette version correspond à ce que vous pensez : son manifeste correspond aux fichiers.
- Montrez l’historique des versions, avec la personne qui a fait le changement et sa raison.
- Dans l’exécution canari enregistrée, listez les valeurs qui confirment que les clients ont retrouvé la bonne version après le retour arrière.
Solution détaillée
python -m ops rollout start 1.5.0-4fafd1 --reason "known-good release after the tabletop" --by Amirastart: active 1.5.0-4fafd1. The worker takes it within 5 seconds.python -m ops release verify 1.5.0-4fafd1Release 1.5.0-4fafd1 matches the files here (code, prompt, migrations).python -m ops rollout historywhen action state after by reason-------- ------ ------------------- ----- -------------------------------------------+0.0 min start active 1.5.0-5a4f87 Amira prompt v2 on the Module 5 code+1.4 min start active 1.5.0-422985 Amira practice: check the fallback with prompt v3+2.6 min start active 1.5.0-5a4f87 Amira practice done: back to prompt v2+2.8 min start active 1.5.0-4fafd1 Amira known-good release after the tabletopVotre historique contient aussi les changements de Déploiements contrôlés. Il est donc plus long, et vos temps diffèrent. La dernière ligne est la restauration.
La restauration seule ne prouve rien sur les clients. Les preuves se trouvent dans les billets après le changement. Dans l’exécution canari du module 5, la dernière ligne de python -m ops canary data/telemetry/canary.jsonl.gz est :
After the last release change (+7.3 min: active 1.5.0-4fafd1, canary None): 1,533 tickets, 2 without text, US$0.341 per 1,000, triage p95 5.17 s, canary tickets 0La liste des preuves :
- 0 billet canari après le retour arrière : aucun client n’a reçu la requête v3 après cela.
- 2 sans texte sur 1 533 : le taux du cas connu de la requête v2, pas les 10 % de v3.
- 0,341 $ US par 1 000 et un p95 du triage de 5,17 s : les valeurs de v2 (0,340 $ US et 5,18 s dans la même exécution), pas celles de v3 (0,479 et 7,86).
- Le manifeste correspond aux fichiers (
ops release verify) : la version qui répond est celle qui a franchi la barrière. - L’historique consigne qui a changé la version, quand et pourquoi : le début de la chronologie de la prochaine analyse.
Une bonne réponse indique que chaque valeur est comparée à une valeur d’avant l’incident. « L’alerte s’est arrêtée » ne figure pas dans la liste.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Quelle est la différence entre la cause et un facteur contributif? Donnez un exemple de chacun tiré de la semaine dernière.
Afficher la réponse
La cause est le changement qui a déclenché les dommages : la requête v3. Elle fait raisonner le modèle jusqu’à sa limite de jetons et ne rien écrire pour environ 10 % des billets. Un facteur contributif est une faiblesse qui a permis à la cause de toucher les clients ou de rester invisible. Par exemple, une requête pouvait être modifiée en production comme un simple paramètre, sans barrière ni déploiement canari. Éliminer la cause règle cet incident. Éliminer les facteurs protège aussi contre la prochaine cause.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Réécrivez cette phrase d'une ébauche d'analyse sans blâmer personne, et expliquez pourquoi c'est important : « Omar a ignoré l'évaluation et mis le service de soutien en panne. »
Afficher la réponse
Par exemple : « La requête a été remplacée pour tous les billets comme un simple changement de paramètre. La décision DO NOT SHIP (ne pas mettre en production) de l’évaluation figurait dans un registre des expériences. Mais rien dans le processus de mise en production ne la vérifiait. » Les faits restent les mêmes. La nouvelle phrase montre ce que le système permettait. L’action devient donc une barrière qui lit la décision, pas un avertissement à Omar. Et Omar peut expliquer pourquoi le changement semblait sûr, une information nécessaire à l’analyse.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : Larkfield avait utilisé la requête v3 dans un déploiement canari à 10 %, avec un recours à une personne. Que dirait la ligne sur les répercussions dans l'analyse?
Afficher la réponse
Environ 1 billet sur 10 utiliserait v3, et le déploiement canari reviendrait en arrière en quelques minutes. Dans l’exécution canari, 22 billets canaris ont précédé le retour arrière : 3 sans texte, aucun lié à la sécurité. Avec le recours à une personne, ces 3 billets seraient confiés à quelqu’un plutôt qu’à personne. Les répercussions seraient donc quelques billets plus lents, aucun billet laissé sans aide et aucun SEV-1. Un incident évité de justesse, qui mérite une demi-page d’analyse.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
Ce module a préparé le service au jour où quelque chose tombe en panne. Vous pouvez maintenant :
- Écrire un guide d’exploitation pour chaque alerte : détection, triage, atténuation, escalade et vérifications du rétablissement, avec une commande ou un panneau à chaque étape. Tester les règles d’alerte sur des exécutions enregistrées avec
python -m ops alerts, et repérer les fausses alertes. - Planifier une panne de fournisseur : du travail en file d’attente qui conserve chaque billet, et un disjoncteur qui ne gaspille aucune tentative. Ajouter un recours à une personne et un état honnête destiné aux clients provenant de
GET /v1/status. Estimer combien de temps une panne peut durer avant que l’objectif de niveau de service des brouillons ne soit plus respecté. - Vérifier un rétablissement avec une liste de valeurs provenant de
python -m ops incidentet de l’API, pas avec l’état d’une alerte. - Écrire une analyse post-incident sans blâme : une chronologie tirée de la télémétrie, la cause, les facteurs contributifs, et des actions avec responsables et vérifications. Faire une simulation sur table pour tester les guides d’exploitation.
Réinitialisation. Si votre projet ne fonctionne plus, copiez l’instantané end-of-m06, conservez votre .env et exécutez python -m scripts.load --reset, comme le montre le README des instantanés.
Ensuite, les études de cas appliquent le cours à des données publiques et à un incident public. Puis, le travail final vous demande de créer votre propre dossier d’exploitation.
Leçon suivante : Surveiller un modèle sur des données publiques qui changent