
Journaux, métriques et traces
- Leçon 8
- 60 min
- Module 3 : Instrumenter une télémétrie utile
Où nous en sommes
Dans le module 2, nous avons rendu chaque réponse traçable jusqu'aux versions qui l'ont produite. Mais nous ne voyons pas encore ce que fait le service pendant qu'il fonctionne : la semaine dernière, il écrivait des lignes de journal que personne ne pouvait relier. Dans cette leçon, nous ajoutons des journaux, des métriques et une trace par billet, tous avec les mêmes identifiants, comme le numéro de suivi d'un colis.
Leçon 8 sur 19 · MLOps et LLMOps : exploiter l'IA en productionJournaux, métriques et traces
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
La semaine dernière, le service écrivait des lignes de journal que personne ne pouvait relier. Faites décrire chaque billet de soutien par l’API, le processus et le client du fournisseur pour le suivre de bout en bout. Donnez-lui une trace, ainsi que des journaux et des métriques qui partagent ses identifiants.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Faire tourner le service en production : l’étape de triage, les billets d’exercice et
python -m ops. - Lignée des artefacts : l’identifiant de version que chaque réponse porte.
- La file de tâches de Cycle de vie d’une tâche, et le chronomètre dans l’en-tête
Server-Timingde Trouver le goulot d’étranglement.
Ce qu’il vous faut sur votre ordinateur
- Votre projet à l’instantané
end-of-m02, avec Docker Desktop pour PostgreSQL, Azurite et Valkey. - Facultatif : environ 900 Mo d’espace disque et 1,3 Go de mémoire libre pour le conteneur Grafana.
Sans Docker, vous ne pouvez pas exécuter le service. Passez à Lire une trace enregistrée. Cette section nécessite seulement Python et la télémétrie enregistrée dans data/telemetry/.
Un colis et son numéro de suivi
Section intitulée « Un colis et son numéro de suivi »Pensez à un colis que vous envoyez à l’autre bout du pays. L’entreprise de livraison conserve trois types de données à son sujet.
Chaque dépôt scanne le colis à son arrivée et à son départ. En ligne, vous voyez ces scans dans l’ordre, chacun avec une heure. Vous pouvez ainsi voir où le colis a attendu deux jours. Les chauffeurs écrivent de courtes notes : « Personne à la maison, carte laissée. » Et l’entreprise compte des éléments pour l’ensemble des colis : colis par jour, colis en retard, colis perdus.
Un numéro relie ces trois types de données : le numéro de suivi. Avec lui, vous pouvez passer de « plus de colis sont en retard » à un colis précis en retard. De ce colis, vous passez à la note qui explique le retard.
Le service de billets a besoin des mêmes trois types de données et du même genre de numéro.
Le problème : deux lignes de journal qui ne se rejoignent jamais
Section intitulée « Le problème : deux lignes de journal qui ne se rejoignent jamais »Après la semaine dernière, Grace a posé une question simple à Amira : « Le billet sur la poêle, T-65663. Qu’est-ce qui lui est arrivé? » Amira a ouvert les journaux (logs) de la console. À l’instantané end-of-m02, l’API écrit une ligne par requête et le processus écrit une ligne par tâche. Voici les deux formats, avec les valeurs de l’exécution réalisée pour le cours :
INFO ticket_api: POST /v1/tickets 202 7ms queries=5 id=c0274d01c5232026-10-11 04:16:32,552 INFO ticket_api.worker: job 3: succeeded (attempt 1)Ces deux lignes concernent le même billet, mais rien ne l’indique. La ligne de l’API contient un identifiant de requête, mais aucun billet. Celle du processus contient un numéro de tâche, mais aucun identifiant de requête ni billet. Elle ne contient pas non plus de version de requête (prompt) ni de raison d’échec. Amira ne pouvait donc pas les relier. Elle ne pouvait pas répondre à Grace, ni compter les billets qui avaient échoué avec la requête v3.
Chaque processus racontait sa propre histoire, et les histoires ne se rejoignaient jamais. La file complique les choses : entre l’API et le processus, le billet attend dans une table de base de données. Aucun processus ne le détient alors.
L’idée : trois signaux avec des identifiants communs
Section intitulée « L’idée : trois signaux avec des identifiants communs »Le service doit écrire trois types de données, comme l’entreprise de livraison. Ensemble, ils forment la télémétrie du service, et chaque type est un signal :
- Un journal contient l’enregistrement d’un événement, avec son heure et ses détails. Ici, les journaux contiennent des événements aux noms fixes :
ticket.received(billet reçu) quand l’API accepte un billet,ticket.triaged(billet trié) quand le processus le termine. Les noms fixes permettent à un programme de les compter, comme on compte les scans des dépôts. - Une métrique est un nombre que le service cumule au fil du temps, pour chaque billet. Exemples : billets triés par résultat et version de requête, jetons (tokens) par appel, coût. Les métriques sont petites et peu coûteuses, donc elles n’omettent jamais un billet.
- Une trace est le parcours d’une requête dans le système. Elle se compose de segments de trace (spans) : un par étape, avec un début, une fin et des attributs. Ces attributs sont des valeurs nommées, comme la version de requête. Un segment de trace peut avoir des segments enfants : une trace forme donc un arbre d’étapes.
Le numéro de suivi correspond à deux identifiants. L’identifiant de trace désigne la trace d’un billet. Chaque événement de journal qui se produit dans un segment de trace le porte. L’identifiant de requête est celui que l’API attribue à la requête. Les lignes de console du processus le portent maintenant aussi.
Le service crée ces données avec OpenTelemetry, une norme ouverte et un ensemble de bibliothèques de télémétrie. Le code indique quoi enregistrer; un exportateur indique où l’envoyer. Ce projet a deux exportateurs. L’un écrit un fichier de lignes JSON que python -m ops lit. L’autre, si vous le voulez, envoie les données à un OpenTelemetry Collector. Ce programme reçoit la télémétrie et la transmet, ici à Grafana.

Description textuelle du diagramme
Lisez le diagramme en partant du billet vers l’extérieur. Chaque signal répond à sa propre question. Un événement de journal indique ce qui est arrivé à ce billet. La trace indique où son temps et son coût ont été dépensés. Une métrique indique à quelle fréquence quelque chose se produit pour l’ensemble des billets. Les identifiants communs vous permettent de passer de l’un à l’autre. Vous partez d’une métrique qui augmente, passez aux événements des billets en échec, puis à la trace de l’un d’eux. Tout est enregistré dans des fichiers; Grafana est facultatif.
Un petit exemple : un billet, toutes ses données
Section intitulée « Un petit exemple : un billet, toutes ses données »Voici un billet de l’exécution de cette leçon par l’auteur : T-500001, un billet d’exercice sur un foyer extérieur endommagé. Ses données sont copiées des fichiers de télémétrie et abrégées pour gagner de la place.
L’API a écrit un événement quand elle a accepté le billet :
{"signal": "log", "service": "ticket-api", "event": "ticket.received", "trace_id": "d2bdff5b10aa9b2c70503f7581b2054b", "attributes": {"request.id": "7e9a07239ab6", "ticket.id": "T-500001", "job.id": 1, "http.status_code": 202, "ticket.channel": "web_form", "ticket.message_chars": 216, "ticket.language_guess": "en", "ticket.message_sha256": "1fcdc0c6d3790e4e", "customer.ref": "09a4de5cda"}}Le processus a écrit un événement quand il a terminé la tâche, 2,8 secondes plus tard :
{"signal": "log", "service": "ticket-worker", "event": "ticket.triaged", "trace_id": "d2bdff5b10aa9b2c70503f7581b2054b", "attributes": {"request.id": "7e9a07239ab6", "ticket.id": "T-500001", "job.attempt": 1, "release.id": "none", "prompt.version": "assistant-v2", "outcome": "ok", "time_to_draft_s": 2.842, "cost_usd": 0.0002933, "triage_ms": 2450.8, "gen_ai.response.model": "gpt-6-luna-2026-09-22", "gen_ai.response.finish_reasons": "stop", "gen_ai.usage.input_tokens": 1903, "gen_ai.usage.output_tokens": 203, "gen_ai.usage.reasoning_output_tokens": 101, "evidence": "replayed", "team": "delivery", "needs_human": false, "language": "en"}}Observez trois choses. D’abord, les deux événements proviennent de deux processus et ont les mêmes identifiants de trace et de requête. Ensuite, le texte du billet n’y est pas : seulement sa longueur, une estimation de sa langue et un court hachage. Un hachage est une empreinte du texte : le même texte donne le même hachage, mais vous ne pouvez pas retrouver le texte. Une observabilité qui respecte la vie privée explique pourquoi. Enfin, release.id vaut none (aucune) : l’exécution de l’auteur n’avait aucun manifeste de version. Quand vous définissez RELEASE_ID, comme dans Lignée des artefacts, votre identifiant de version apparaît ici, par exemple 1.5.0-3ad293.
Le processus a aussi envoyé une métrique. Toutes les 15 secondes, il écrit le compteur des billets terminés, avec une valeur par combinaison d’étiquettes (version abrégée) :
{"signal": "metric", "name": "app.tickets.triaged", "points": [ {"attributes": {"outcome": "ok", "prompt.version": "assistant-v2", "needs_human": "true"}, "value": 3}, {"attributes": {"outcome": "ok", "prompt.version": "assistant-v2", "needs_human": "false"}, "value": 2}, {"attributes": {"outcome": "no_answer", "prompt.version": "assistant-v2", "needs_human": "none"}, "value": 0}]}Cinq billets : 3 transmis à une personne, 2 non transmis, 0 sans réponse. La métrique ne précise pas quels billets; les journaux le font. La trace de T-500001 contient 22 segments de trace. Vous la lirez plus loin dans cette leçon.
Une trace qui traverse la file
Section intitulée « Une trace qui traverse la file »Une trace est facile à gérer dans un seul processus. La bibliothèque garde le segment de trace courant en mémoire, et chaque nouveau segment devient son enfant. Mais le billet quitte l’API et attend dans la table jobs. Plus tard, un autre processus le prend.
L’API écrit donc le contexte de la trace dans la tâche. Un format standard, le traceparent du W3C, contient l’identifiant de trace et celui du segment courant dans un court texte. La migration 017_job_trace_context.sql ajoute deux colonnes à jobs : trace_context et request_id. Dans ticket_api/intake.py, l’API enregistre les deux avec la nouvelle tâche :
job = jobs.enqueue( conn, ticket["ticket_id"], actor, # … the scaling course's arguments … request_id=telemetry.REQUEST_ID.get(), trace_context=telemetry.traceparent(),)Dans ticket_api/worker.py, le processus démarre le segment de trace de la tâche avec ce contexte comme parent :
with telemetry.tracer.start_as_current_span( "process ticket job", context=telemetry.context_from(job.get("trace_context")), kind=SpanKind.CONSUMER, attributes=attributes,) as span:
Description textuelle du diagramme
Le segment de trace de l’API commence à l’arrivée de la requête. Avant de répondre 202, l’API enregistre le contexte de trace et l’identifiant de requête dans la ligne de la tâche. Pendant 157 millisecondes, aucun processus ne détient le billet : seule la ligne contient les identifiants. Le processus prend la tâche, lit le contexte et démarre son segment comme enfant de celui de l’API. L’appel d’IA et l’événement final appartiennent donc à la même trace que la requête.
L’interrogation périodique de la file par le processus ne fait pas partie du travail sur un billet. Le code désactive donc le traçage autour de cette opération (telemetry.quiet()). Avant ce changement, l’équipe du cours a compté 208 segments UPDATE (mise à jour) pour 20 billets. Les interrogations périodiques masquaient les segments utiles.
Un segment de trace pour chaque appel d’IA
Section intitulée « Un segment de trace pour chaque appel d’IA »Le client du fournisseur, ticket_api/provider.py, entoure chaque appel d’un segment nommé selon l’opération et le modèle : chat chat-small ou embeddings embed-small. Ses attributs suivent les conventions sémantiques GenAI d’OpenTelemetry, des noms convenus pour les appels d’IA : gen_ai.request.model, gen_ai.response.model, gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, gen_ai.response.finish_reasons. Ces conventions ont encore le statut « development » (en développement). Un nom peut donc changer dans une version ultérieure. Le service les garde dans un seul fichier, pour qu’un changement touche un seul endroit.
Le segment contient aussi app.cost_usd, l’estimation du service. Prenons l’appel de triage de T-500001. Il comptait 1 903 jetons en entrée à 0,10 $ US par million, et 203 en sortie à 0,50 $ US par million : 0,0002918 $ US. Ce sont les prix supposés pour le cours dans ticket_api/prices.py. Les prix changent : vérifiez la page actuelle du fournisseur avant de les utiliser pour un vrai budget.
Ajouter la télémétrie à votre projet
Section intitulée « Ajouter la télémétrie à votre projet »L’instantané end-of-m03 contient le code ci-dessus et les fichiers des deux prochaines leçons de ce module. Vous le copiez une seule fois.
-
Arrêtez l’API, le processus et le simulateur s’ils tournent. Copiez l’instantané dans votre projet. Il ne contient ni
.envnisecrets/, donc les vôtres restent.Fenêtre de terminal cp -R ../nextia-learning-labs/C25/snapshots/end-of-m03/. .Fenêtre de terminal Copy-Item -Recurse -Force ..\nextia-learning-labs\C25\snapshots\end-of-m03\* . -
Installez les nouveaux paquets : l’API d’OpenTelemetry, son SDK, l’exportateur et les instrumentations pour FastAPI, psycopg et httpx.
Fenêtre de terminal python -m pip install -r requirements.txtpython -m pip listaffiche ensuiteopentelemetry-sdk 1.45.1etopentelemetry-instrumentation-fastapi 0.66b1. Leb1signifie que les instrumentations sont encore en version bêta. -
Si votre
.envcontient une ligneRELEASE_IDavec un identifiant, mettez d’abord la version à jour. Votre manifeste de Lignée des artefacts se termine à la migration 016, et ce module ajoute la migration 017. Le service, les tests etscripts.loadle refuseraient donc. Créez un nouveau manifeste pour la requête v2 :Fenêtre de terminal python -m ops release build --prompt assistant-v2 --evidence baseline-v2-chat-small-r1-b6a2b9 --writeLa dernière ligne :
Saved operations/releases/1.5.0-3ad293.toml. Run the service with RELEASE_ID=1.5.0-3ad293Dans
.env, donnez àRELEASE_IDl’identifiant affiché par votre commande. Le code a changé, donc son empreinte et l’identifiant ont changé aussi. SiRELEASE_ID=est vide, sautez cette partie. -
Appliquez la nouvelle migration et rechargez les données :
Fenêtre de terminal python -m scripts.load --resetapplied 017_job_trace_contextDatabase is up to date (17 migrations).Loaded the small data in 0.6 s: -
Exécutez les tests :
python -m pytest. Attendez-vous à200 passed, 1 deselected(200 réussis, 1 non sélectionné), soit 7 de plus qu’avant. Les nouveaux tests vérifient la trace unique par billet, le masquage et l’échantillonnage. -
Ouvrez
.env.example. Copiez le bloc qui commence par# Telemetry (Module 3)(télémétrie, module 3) à la fin de votre.env. Son premier paramètre est celui qui compte maintenant :TELEMETRY_FILE=telemetry/{service}.jsonl{service}devientticket-apiouticket-worker, donc chaque processus écrit son propre fichier.
Exécuter le service et lire votre propre trace
Section intitulée « Exécuter le service et lire votre propre trace »-
Démarrez le simulateur, l’API et le processus dans trois terminaux, comme dans Faire tourner le service en production :
python -m simulator,fastapi dev,python -m ticket_api.worker. -
Dans un quatrième terminal, envoyez cinq billets d’exercice :
Fenêtre de terminal python -m scripts.practice --tickets 5 --rate 2Sent 5 practice tickets in 2.0 s: 202: 5 -
Attendez que le processus ait inscrit cinq tâches dans les journaux. Ses lignes de console portent maintenant l’identifiant de requête entre crochets :
2026-10-11 04:16:31,538 INFO httpx [7e9a07239ab6]: HTTP Request: POST http://127.0.0.1:8300/v1/chat/completions "HTTP/1.1 200 OK"2026-10-11 04:16:31,760 INFO ticket_api.worker [7e9a07239ab6]: job 1: succeeded (attempt 1)La ligne de console de l’API pour ce billet a le même identifiant :
INFO ticket_api [7e9a07239ab6]: POST /v1/tickets 202 …. Vos identifiants et vos temps seront différents. -
Arrêtez le processus avec Ctrl+C. Le service écrit la télémétrie par lots. À son arrêt, le processus écrit ce qui attend encore.
-
Lisez le résumé de vos deux fichiers :
Fenêtre de terminal python -m ops summary telemetry/ticket-api.jsonl telemetry/ticket-worker.jsonlRecords: 10 logs, 110 spans, 42 metric records, from +0.0 min to +0.1 minTicket requests: 5 (202: 5)Tickets triaged: 5 (ok: 5)Prompt versions: assistant-v2 5Where the answers come from: replayed 5 (100.00%)Sent to a person (needs_human): 3 (60.00%)Agents' reviews (delayed labels): 0; answers to questions: 0Dix entrées de journal : deux événements par billet. 110 segments de trace : 22 par billet. Si Valkey contient encore les vecteurs de ces billets d’une leçon précédente, vous voyez 19 segments par billet. L’étape suivante explique pourquoi.
-
Affichez la trace de votre premier billet en cascade, avec une ligne par segment de trace :
Fenêtre de terminal python -m ops waterfall telemetry/ticket-api.jsonl telemetry/ticket-worker.jsonl --ticket T-500001Trace d2bdff5b10aa9b2c70503f7581b2054b, ticket T-500001: 22 spans, 2,846 ms from first to lastspan start ms ms cost US$POST /v1/tickets 0 14.9 #(waiting in the queue) 15 156.5 #process ticket job 171 2,674.9 #################################triage 175 2,458.8 ###############################chat chat-small 175 2,450.9 ############################## 0.000292POST 176 2,447.0 ##############################embed 2,633 209.3 ##cache get 2,634 6.0 #embeddings embed-small 2,640 194.1 ## 0.000002POST 2,640 191.4 ##cache set 2,834 1.5 #(12 database queries hidden; --all shows them)Longest step: triage, 2,459 ms (86% of the trace)Costliest step: chat chat-small, US$0.000292 of US$0.000293: 1903 tokens in, 203 out (101 of them reasoning), finish stop
Lire une trace enregistrée
Section intitulée « Lire une trace enregistrée »Chaque ligne d’une cascade est un segment de trace. start ms (début en ms) indique quand il a commencé, depuis le début de la trace. ms indique sa durée; la barre # représente les deux sur une même échelle de temps. Les lignes en retrait sont des segments enfants. La ligne (waiting in the queue) (attente dans la file) n’est pas un segment de trace. ops la calcule à partir de l’écart entre le segment de l’API et celui de la tâche. Dans cette trace, le cache était vide. Le plongement (embedding) a donc appelé le fournisseur (embeddings embed-small) et enregistré le vecteur (cache set, écriture dans le cache). Si votre cache contenait déjà le vecteur, embed contient seulement cache get (lecture du cache), sans coût.
Sans Docker, lisez un billet de la télémétrie enregistrée. T-502401 est le premier billet de la réexécution de la semaine dernière, traité avec la requête v2 :
python -m ops waterfall data/telemetry/release-full.jsonl.gz --ticket T-502401
Description textuelle du diagramme
Le segment de l’API est une mince barre au début : 35 millisecondes. La barre pointillée est la file : 192 millisecondes. Ensuite, le segment de la tâche s’ouvre et occupe le reste. À l’intérieur, triage et son appel chat chat-small occupent 2,7 des 3,0 secondes. L’appel porte le seul coût réel, 0,000308 $ US. Le plongement est une petite barre à la fin : son vecteur venait du cache, donc il n’a rien coûté.
Vous avez déjà vu cette forme dans le cours Mettre à l’échelle les API et les charges de travail d’IA : les appels du fournisseur occupent presque tout le temps d’un billet. L’en-tête Server-Timing le montrait pour une requête. La trace le montre à travers deux processus et la file, et elle ajoute les jetons et le coût.
Facultatif : la même télémétrie dans Grafana
Section intitulée « Facultatif : la même télémétrie dans Grafana »Les fichiers suffisent pour ce cours. Une équipe veut généralement un service qui stocke la télémétrie et l’affiche. Ainsi, tout le monde consulte la même vue en direct. Le cours utilise Grafana dans un seul conteneur, grafana/otel-lgtm:0.36.0. Il contient un OpenTelemetry Collector, Prometheus pour les métriques, Tempo pour les traces, Loki pour les journaux et Grafana pour les afficher.
-
Démarrez le conteneur. Il se trouve dans
compose.yaml, sous le profilobservability. Les autres commandes ne le démarrent donc pas :Fenêtre de terminal docker compose --profile observability up -d observability -
Dans
.env, définissezOTEL_EXPORTER_OTLP_ENDPOINT=http://127.0.0.1:4318. Redémarrez l’API et le processus. Ils envoient maintenant la télémétrie aux fichiers et au collecteur. -
Ouvrez
http://127.0.0.1:3000. Les tableaux de bord se trouvent dans le dossier Ticket service (service de billets). Les fichiers dansobservability/les définissent, ainsi que les règles d’alerte. -
Arrêtez le conteneur quand vous avez terminé :
docker compose --profile observability stop.
Sur l’ordinateur de l’équipe du cours, le téléchargement de l’image représentait 855 Mo. Le conteneur était prêt 5 secondes après son démarrage et utilisait alors 1,2 Go de mémoire. Il est passé à 2,45 Go après environ trois heures de télémétrie stockée. Les captures d’écran de ce module proviennent des exécutions de l’équipe du cours.
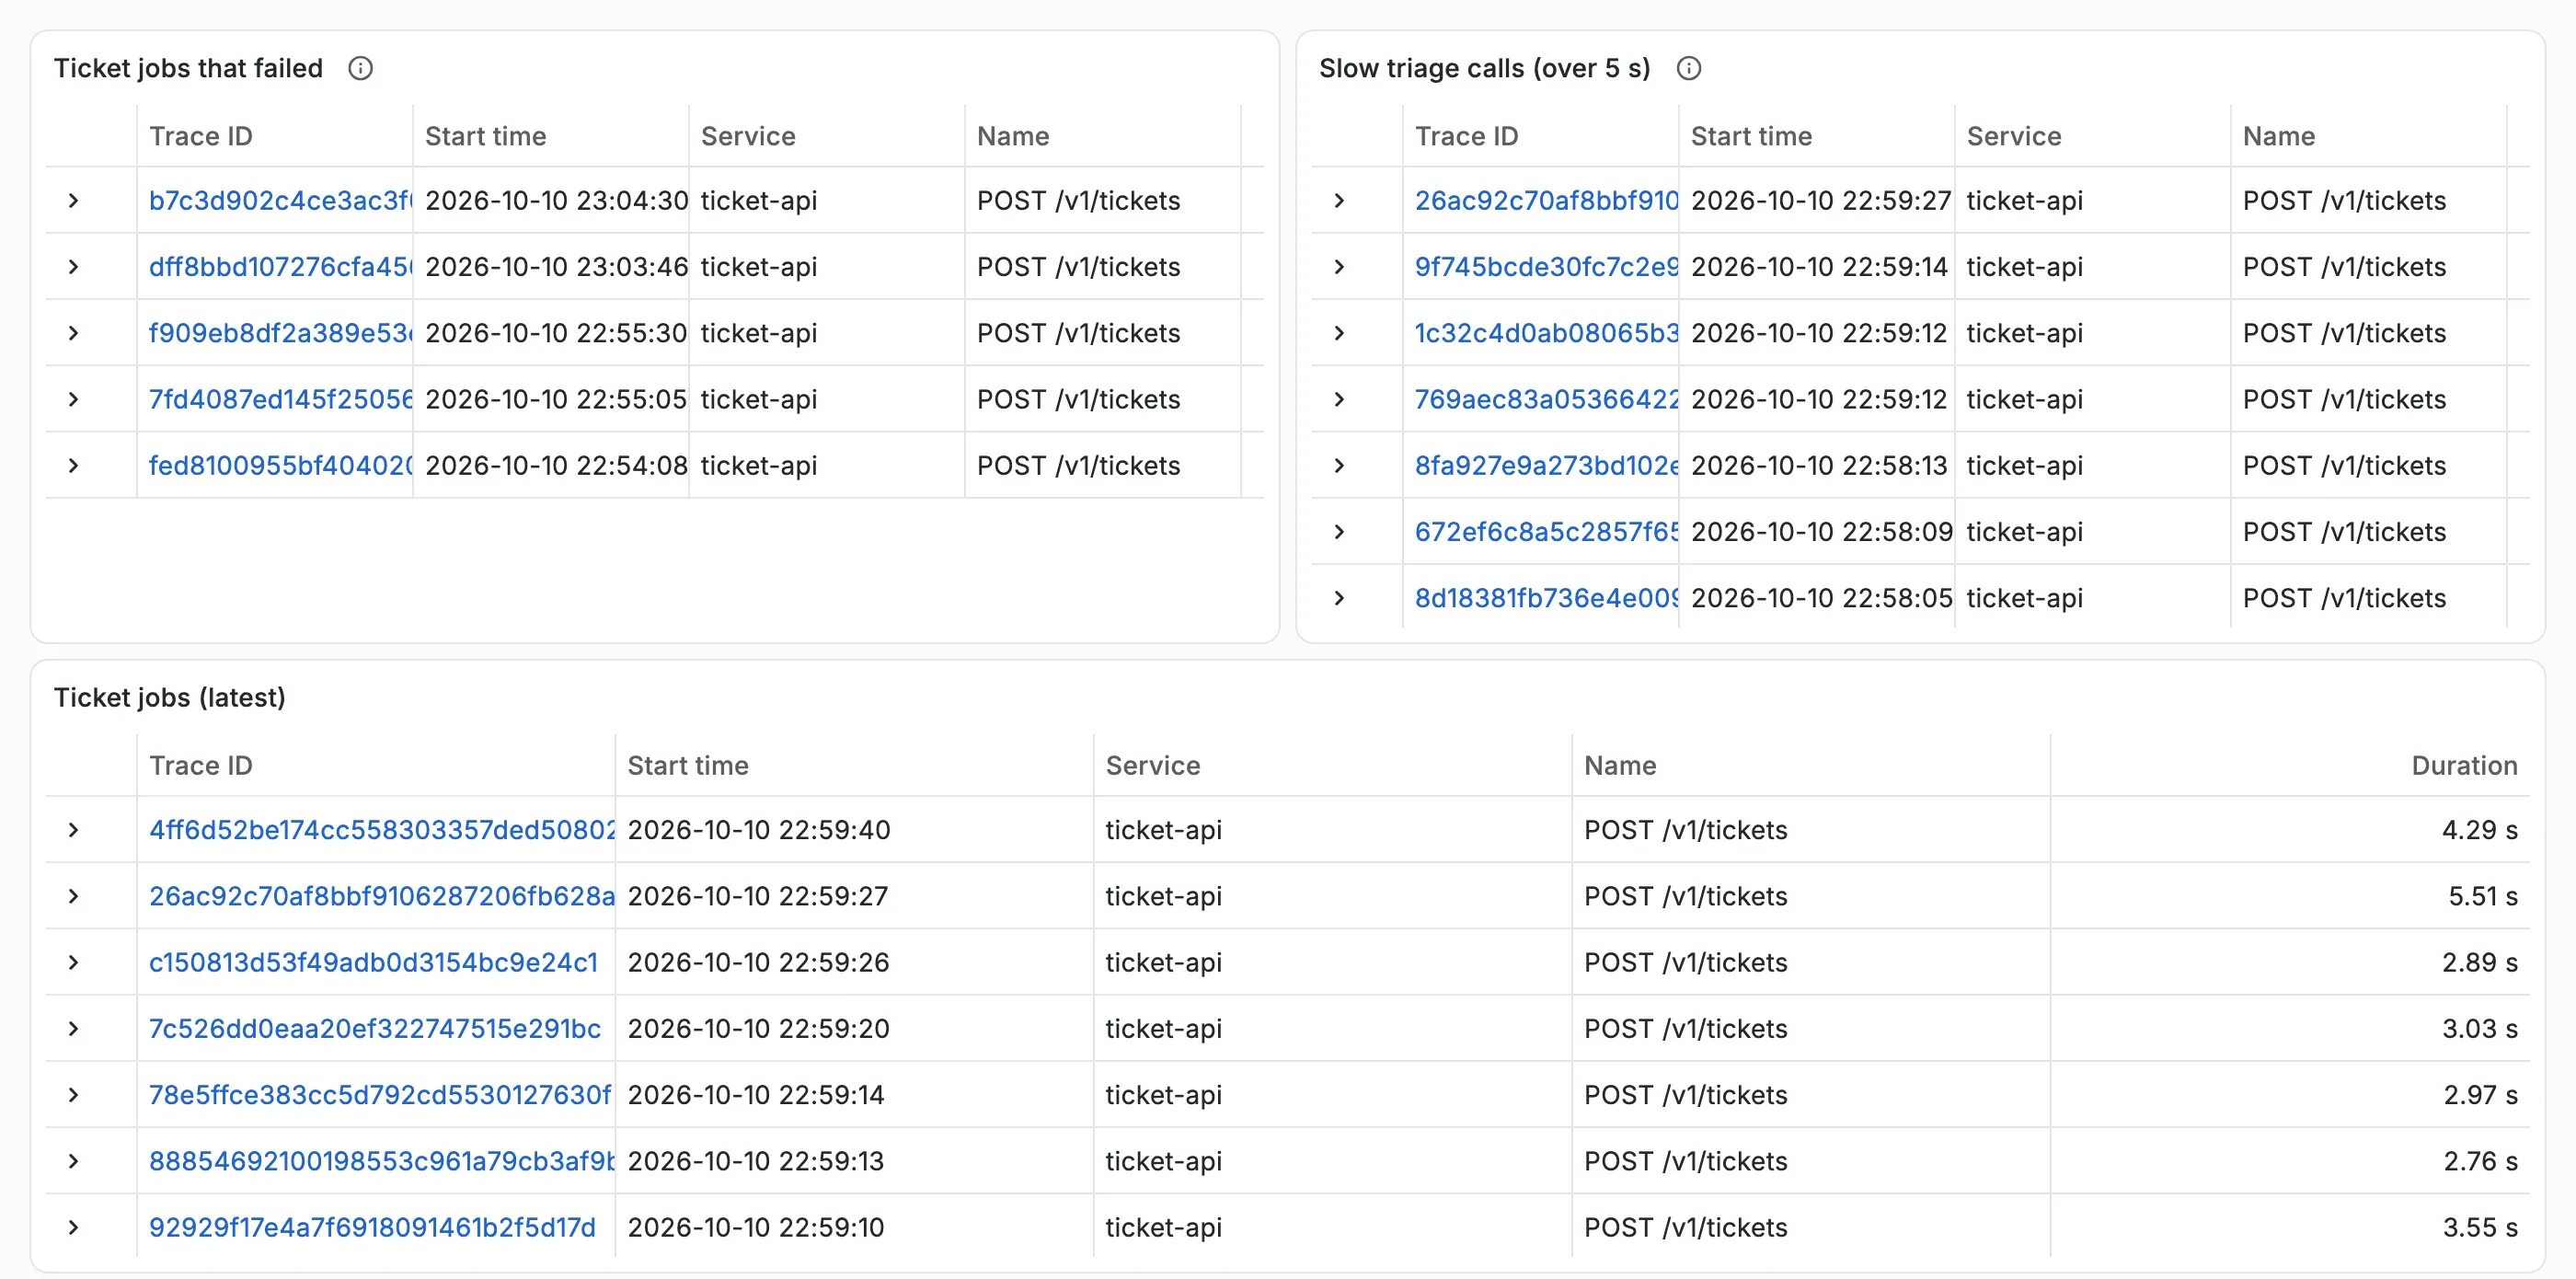
Chaque ligne est une trace, nommée d’après son premier segment de trace (span), POST /v1/tickets. La trace commence à l’API, même quand la partie lente se trouve dans le processus. Le dernier panneau liste les événements ticket.triaged de gravité ERROR (erreur) : les journaux des billets sans réponse valide.
Quand ajouter de la télémétrie, et ce qu’elle coûte
Section intitulée « Quand ajouter de la télémétrie, et ce qu’elle coûte »Sam demande : « Pourquoi ne pas garder toutes les lignes que le code écrit dans les journaux, puis les chercher plus tard? »
Amira répond : « On a essayé ça au début. Les lignes des journaux Python n’ont pas de noms fixes. Un tableau de bord ne peut donc pas les compter. Et la première version exportait aussi le chemin complet de chaque fichier source sur l’ordinateur du développeur. Les événements avec des noms fixes disent ce qu’il nous faut, et rien d’autre. »
Ajoutez de la télémétrie dès qu’un service a des utilisateurs et plus d’un processus. Choisissez d’abord les noms des événements et les étiquettes des métriques. Ils forment un contrat : les tableaux de bord, les alertes et ops les lisent, et docs/telemetry.md les liste. Sans cette liste, chaque changement de nom brise un graphique sans avertissement.
La télémétrie prend du temps à chaque requête. L’équipe du cours a mesuré POST /v1/tickets. La médiane était de 2,39 ms sans télémétrie, et de 3,66 ms en conservant toutes les traces. Un processus terminait 238 tâches par seconde sans télémétrie, et 201 avec toutes les traces : 16 % de moins. Ces mesures utilisaient un simulateur qui répond immédiatement. Avec de vrais appels d’IA de 3 secondes, une milliseconde se perd dans le bruit, mais le coût existe toujours. La télémétrie exige aussi du stockage et de l’attention. Quelqu’un doit garder les noms stables et exclure les textes privés. La dernière leçon de ce module mesure ces coûts et les réduit.
N’ajoutez pas de télémétrie que personne ne lira. Pour un script exécuté une seule fois, une instruction d’affichage suffit.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
ops : aucun fichier telemetry/ticket-api.jsonl
Symptôme : après l’envoi de billets, ops summary affiche :
ops summary: no file telemetry/ticket-api.jsonlCause : votre .env provient d’une ancienne version de .env.example et ne contient donc pas TELEMETRY_FILE. Sans fichier ni point de terminaison, le service ne démarre aucune télémétrie et fonctionne comme avant.
Diagnostic : le dossier telemetry n’existe pas, mais les lignes de console du processus contiennent l’identifiant de requête entre crochets. Cet identifiant vient du code, pas du réglage de télémétrie.
Solution : copiez le bloc de télémétrie de .env.example dans votre .env, comme à l’étape 6 de la configuration. Redémarrez l’API et le processus, puis envoyez les billets de nouveau.
Erreur courante
Les derniers billets manquent dans le fichier
Symptôme : vous exécutez ops summary pendant que le processus fonctionne encore. La commande compte moins de billets triés que vous en avez envoyé.
Cause : le service écrit la télémétrie par lots pour qu’une écriture lente dans un fichier ne retarde jamais un billet. Dans ce projet, les segments de trace et les journaux sont exportés environ toutes les 2 secondes. Les métriques le sont toutes les 15 secondes (TELEMETRY_METRIC_INTERVAL_MS).
Solution : attendez quelques secondes, ou arrêtez le processus avec Ctrl+C. Il écrit tout ce qui attend avant de s’arrêter. Si le processus est interrompu brutalement, le dernier lot est perdu. C’est aussi vrai en production; arrêtez donc les processus proprement.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Grace pose trois questions : combien de billets n'ont reçu aucune réponse avec la requête v3 cette semaine? Pourquoi le billet T-65663 a-t-il attendu? Où sont passées les 9 secondes d'un billet lent? Quel signal répond à chaque question?
Afficher la réponse
Le nombre vient d’une métrique : app.tickets.triaged, avec les étiquettes outcome et prompt.version, compte chaque billet, sans échantillonnage. Les journaux expliquent pourquoi un billet a attendu. Ses événements ticket.received et ticket.triaged indiquent le résultat, la raison de fin et le type d’erreur. Sa trace montre où les 9 secondes sont passées. La vue en cascade montre le début, la durée et le coût de chaque segment de trace. L’identifiant de trace et l’identifiant de requête relient la deuxième réponse à la troisième.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : la tâche du billet attend dans la base de données entre l'API et le processus. Sans la colonne trace_context, à quoi ressemblerait la trace d'un billet?
Afficher la réponse
Le billet aurait deux traces. La trace de l’API contiendrait seulement POST /v1/tickets et ses requêtes SQL, soit environ 15 ms. Le processus démarrerait une nouvelle trace pour process ticket job (traiter la tâche du billet), avec l’appel de triage et le plongement. Rien ne montrerait l’attente dans la file. La requête de l’API ne serait jamais reliée à son appel d’IA. Le traceparent enregistré avec la tâche permet d’en faire une seule trace.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : envoyez cinq billets d'exercice avec TELEMETRY_FILE défini. Qu'affichent ops summary et ops waterfall pour votre premier billet?
Afficher la réponse
python -m ops summary telemetry/ticket-api.jsonl telemetry/ticket-worker.jsonl affiche Ticket requests: 5 (202: 5) (5 requêtes de billets, toutes avec le code 202) et Tickets triaged: 5 (ok: 5) (5 billets triés, tous réussis). python -m ops waterfall … --ticket T-500001 affiche une trace avec des segments de trace des deux services : POST /v1/tickets, l’attente dans la file, process ticket job, triage (triage) avec chat chat-small et son coût, et embed (plongement). L’étape la plus longue est triage, soit plus de 80 % de la trace. Vos durées seront différentes. Sans Docker, --ticket T-502401 sur data/telemetry/release-full.jsonl.gz donne la même structure : 3 006 ms, et l’appel de triage coûte 0,000308 $ US.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- La télémétrie comprend trois signaux. Les journaux sont des événements aux noms fixes, les métriques comptent chaque billet, et une trace est l’arbre des segments de trace d’un billet.
- L’identifiant de trace et l’identifiant de requête les relient. La tâche enregistre le traceparent de la requête. Ainsi, une trace traverse la file, de l’API au processus.
- Chaque appel d’IA est un segment de trace avec les attributs GenAI (modèle, jetons, raison de fin). Ils ont encore le statut « development » (en développement) dans OpenTelemetry. Le segment contient aussi l’estimation du coût faite par le service.
TELEMETRY_FILEenregistre tout en lignes JSON pourpython -m ops. Grafana est facultatif, et les fichiers montrent les mêmes nombres.
Ensuite, vous comparez les requêtes v2 et v3 avec ces signaux : résultats, jetons, durée et coût pour chaque version. Vous trouvez aussi l’étape lente et coûteuse dans une trace.
Leçon suivante : Qualité et coûts