
Dérive des données et dérive conceptuelle
- Leçon 11
- 55 min
- Module 4 : Surveiller les changements de comportement
Où nous en sommes
Dans le module 3, nous avons fait en sorte que le service nous dise ce qu'il fait, par version et sans texte privé. Mais les billets eux-mêmes changent : plus de billets arrivent en français, et les documents de la boutique changent. Dans cette leçon, nous mesurons à quel point les entrées ont changé, et nous séparons cela de la vraie question : l'assistant se trompe-t-il maintenant? Nous commençons par une personne qui trie les lettres dans un bureau de poste.
Leçon 11 sur 19 · MLOps et LLMOps : exploiter l'IA en productionDérive des données et dérive conceptuelle
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
Déterminez quand les billets de soutien qui arrivent à l’assistant changent. Mesurez ensuite ce changement avec une méthode déclarée. Puis distinguez « les entrées ont changé » de « l’assistant se trompe maintenant ». Seul le deuxième cas nuit aux clients, et la dérive seule ne permet pas de le montrer.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- La télémétrie du service et
python -m ops summary, dans Journaux, métriques et traces, et la qualité par version de requête, dans Qualité et coûts. - Le SLO de qualité (90 % des billets révisés sont en accord avec l’agent), dans Objectifs de service.
- Les billets d’exercice et les étiquettes de Grace, dans Faire tourner le service en production. La dérive comme signal de production, dans Rétroaction de la production.
Ce qu’il vous faut sur votre ordinateur
- Votre projet
ticket-apià la fin du module 3, ou une copie de l’instantanéend-of-m03.python -m pytestaffiche200 passed(200 tests réussis). - Docker exécutant PostgreSQL et Valkey (
docker compose up -d db cache), pour la migration et les tests. - La télémétrie enregistrée dans
data/telemetry/, copiée du dépôt d’exercices dans Lignée des artefacts.
Aucun compte, aucune clé et aucuns frais. Les étapes qui lisent les fichiers enregistrés n’ont pas besoin de Docker.
Le tri du courrier au bureau de poste
Section intitulée « Le tri du courrier au bureau de poste »Imaginez une personne qui trie les lettres dans un bureau de poste. Elle lit le code postal sur chaque enveloppe et place la lettre dans le sac du quartier correspondant. Elle fait ce travail depuis des années et le fait bien.
Trois choses différentes peuvent changer pendant sa semaine :
- Plus de lettres arrivent de l’étranger. Les enveloppes sont différentes, et l’écriture est nouvelle. La règle reste la même : le code postal 4 va dans le sac 4. La personne peut encore trier chaque lettre correctement.
- La ville déplace une rue dans un autre quartier. Les enveloppes sont exactement comme avant. Mais ce code postal correspond maintenant à un autre sac, et l’ancienne règle de tri est incorrecte.
- Des lettres arrivent dans le mauvais quartier. Personne ne le voit à la table de tri. La personne l’apprend plusieurs jours plus tard, quand les quartiers renvoient les lettres qu’ils n’auraient pas dû recevoir.
Seul le troisième cas est une erreur mesurée, et le bureau de poste l’apprend tard. L’assistant du service de soutien connaît les mêmes trois types de changements.
Le problème : une alarme qui indique la mauvaise direction
Section intitulée « Le problème : une alarme qui indique la mauvaise direction »Dans cette leçon, vous examinez une simulation que nous avons créée exprès : le scénario de dérive. Le service a reçu 3 000 billets d’exercice en trois blocs de 1 000. Les agents ont révisé la moitié des billets, 120 secondes après l’arrivée de chacun. Les réponses sont de vrais enregistrements du cours sur l’évaluation; la répartition des billets est construite :
- Normal : les billets habituels.
- Français : une nouvelle région commence à écrire, et les billets en français deviennent six fois plus probables.
- Politique muette : une nouvelle option de paiement apparaît. Les questions sans réponse dans la politique du magasin deviennent six fois plus probables.
Priya surveillait un seul nombre : la part des messages en français. Dans le deuxième bloc, elle est passée de 5 % à 25 %, et sa vérification indiquait changement IMPORTANT. Tomás a dit tout de suite : « L’alerte de dérive s’est déclenchée : réentraînons automatiquement. »
Puis les révisions des agents sont arrivées. Dans le bloc français, l’assistant était en accord avec les agents sur 95,8 % des billets révisés : aussi bien qu’avant. Dans le troisième bloc, la vérification de langue de Priya indiquait aucun changement réel. Mais l’accord est tombé à 85,3 %, sous le SLO de qualité de 90 %.
Sa seule alarme s’est déclenchée pour le changement sans danger et est restée silencieuse pour le changement nuisible.
L’idée : quatre choses qui peuvent changer
Section intitulée « L’idée : quatre choses qui peuvent changer »Utilisez quatre noms et distinguez-les :
- Dérive des données, aussi appelée dérive des entrées : les entrées changent. Plus de billets en français, des messages plus longs, un nouveau produit. Ce sont les lettres de l’étranger dans l’exemple du tri.
- Dérive des prédictions : les décisions de l’assistant changent. Il envoie plus de billets à
returns(retours), ou moins à une personne. Vous le voyez immédiatement, car les décisions sont dans la télémétrie. - Dérive conceptuelle : la bonne réponse pour la même entrée change. Le magasin crée une nouvelle règle, par exemple « chaque billet concernant une batterie nécessite maintenant une personne ». Les billets semblent identiques, mais les anciennes décisions sont maintenant incorrectes. C’est la rue déplacée dans un autre quartier.
- Baisse de performance : la qualité mesurée diminue. Les décisions et les révisions des agents sont moins souvent en accord. C’est le seul des quatre cas qui dit « l’assistant se trompe maintenant ». Il nécessite les vraies réponses, les étiquettes.
La « dérive » désigne un écart lent ou soudain par rapport à une référence. La référence est une période fiable, par exemple les 1 000 premiers billets, quand les révisions confirmaient le bon fonctionnement de l’assistant.

Description textuelle du diagramme
Le billet arrive à l’assistant, et l’assistant donne une décision. Des heures ou des jours plus tard, la révision d’un agent indique quelle était la bonne décision. La dérive des données est un changement dans les billets. La dérive des prédictions est un changement dans les décisions. La dérive conceptuelle change la bonne réponse; vous ne la voyez donc qu’à travers les révisions. La baisse de performance est le résultat mesuré : les décisions et les révisions sont moins souvent en accord.
La dérive des données et celle des prédictions sont rapides : la télémétrie les contient quelques secondes après chaque billet. La dérive conceptuelle et la baisse de performance nécessitent des étiquettes; elles sont donc lentes.
Un petit exemple : quelle ampleur et quelle certitude
Section intitulée « Un petit exemple : quelle ampleur et quelle certitude »Pour parler de « dérive », vous devez noter une méthode et un seuil. Deux questions nécessitent deux nombres :
- Quelle est l’ampleur du changement? Le projet utilise l’indice de stabilité de la population (PSI). Pour chaque catégorie, il prend le changement de proportion. Il le pondère selon le facteur d’augmentation ou de diminution de cette proportion. Puis il additionne les parties. Ainsi, une proportion qui passe de 5 % à 25 % compte beaucoup plus qu’une qui passe de 75 % à 95 %.
- À quel point sommes-nous certains du changement? Un test du khi carré pose la question suivante : si rien n’avait changé, à quelle fréquence deux échantillons différeraient-ils autant par hasard? Cette probabilité est la valeur p. Le projet considère p < 0,01 comme « différent ».
Prenez 100 billets de référence, 95 en anglais et 5 en français, et 100 billets actuels, 75 en anglais et 25 en français. Pour chaque langue, la partie du PSI est (proportion actuelle − proportion de référence) × ln(proportion actuelle ÷ proportion de référence) :
- Anglais : (0,75 − 0,95) × ln(0,75 ÷ 0,95) = (−0,20) × (−0,236) = 0,047
- Français : (0,25 − 0,05) × ln(0,25 ÷ 0,05) = 0,20 × 1,609 = 0,322
Le PSI est 0,047 + 0,322 = 0,369. Exécutez le calcul, puis changez les nombres de billets :
Exécutez du Python dans votre navigateur
PSI et test du khi carré sur 100 billets
L’encadré affiche chaque partie, le PSI 0.369 et le test du khi carré : statistique 15.7, valeur p 7.5e-05. Multipliez chaque nombre de billets par 10 et exécutez de nouveau le calcul. Puis essayez un petit changement, de 7 % → 14 % en français, avec 100 puis 1 000 billets.
Tab ajoute quatre espaces. Appuyez sur Esc, puis sur Tab, pour quitter la zone. Ctrl+Enter exécute le code.
Les quatre exécutions, côte à côte :
| Référence → actuel | Billets dans chaque groupe | PSI | Valeur p |
|---|---|---|---|
| 5 % → 25 % en français | 100 | 0,369 | 7,5e-05 |
| 5 % → 25 % en français | 1 000 | 0,369 | 5,5e-36 |
| 7 % → 14 % en français | 100 | 0,054 | 0,11 |
| 7 % → 14 % en français | 1 000 | 0,054 | 3,3e-07 |
Lisez le tableau lentement. Le PSI dépend seulement des proportions; dix fois plus de billets donnent donc le même PSI. La valeur p dépend du nombre de billets. Avec 1 000 billets, le petit changement obtient une valeur p minuscule : il est réel, mais petit. Lisez donc les deux ensemble : le PSI pour l’ampleur, la valeur p pour la certitude.
Pour le PSI, on utilise une règle pratique : sous 0,1, aucun changement réel; de 0,1 à 0,2, un petit changement; au-dessus de 0,2, un changement important. C’est une convention issue de l’évaluation du crédit, pas une loi de la nature. Le projet l’inscrit dans ops/stats.py, pour que tout le monde utilise la même. Pour un nombre comme la longueur du message, le projet divise la référence en 10 classes de taille égale (déciles). Puis il compte les billets actuels dans ces mêmes classes.
Ajouter les fichiers du module à votre projet
Section intitulée « Ajouter les fichiers du module à votre projet »Ce module ajoute des fichiers pour ses trois leçons : les outils de dérive et d’étiquettes, les révisions des agents et un index de récupération des réponses. Copiez-les maintenant, une seule fois. Chaque leçon explique ses propres fichiers.
-
Dans un terminal, allez dans votre projet et activez l’environnement virtuel.
Fenêtre de terminal cd ~/projects/ticket-apisource .venv/bin/activateFenêtre de terminal cd ~\projects\ticket-api.venv\Scripts\Activate.ps1 -
Copiez les fichiers du module depuis l’instantané
end-of-m04. Onze fichiers sont nouveaux, et sept changent.Fenêtre de terminal S=../nextia-learning-labs/C25/snapshots/end-of-m04for f in migrations/018_ticket_reviews.sql migrations/019_answer_index.sql \ticket_api/reviews.py ticket_api/answers.py ticket_api/main.py ticket_api/repository.py \ticket_api/worker.py ops/stats.py ops/cmd_drift.py ops/cmd_labels.py ops/cmd_rag.py \scripts/reindex.py scripts/send_reviews.py scripts/update_document.py scripts/load.py \tests/test_monitoring.py contract/openapi.json README.md; docp "$S/$f" "$f"doneFenêtre de terminal $S = "..\nextia-learning-labs\C25\snapshots\end-of-m04"$files = 'migrations\018_ticket_reviews.sql', 'migrations\019_answer_index.sql','ticket_api\reviews.py', 'ticket_api\answers.py', 'ticket_api\main.py', 'ticket_api\repository.py','ticket_api\worker.py', 'ops\stats.py', 'ops\cmd_drift.py', 'ops\cmd_labels.py', 'ops\cmd_rag.py','scripts\reindex.py', 'scripts\send_reviews.py', 'scripts\update_document.py', 'scripts\load.py','tests\test_monitoring.py', 'contract\openapi.json', 'README.md'foreach ($f in $files) { Copy-Item "$S\$f" $f } -
Appliquez les deux nouvelles migrations. Elles ajoutent deux tables et conservent vos données.
Fenêtre de terminal python -m ticket_api.migrateapplied 018_ticket_reviewsapplied 019_answer_indexDatabase is up to date (19 migrations). -
Si votre
.envcontient une ligneRELEASE_IDavec un identifiant, mettez à jour la version. Son manifeste indique l’ancienne dernière migration; le service et les tests refuseraient donc de démarrer. Créez un nouveau manifeste pour la requête v2, comme dans Lignée des artefacts :Fenêtre de terminal python -m ops release build --prompt assistant-v2 --evidence baseline-v2-chat-small-r1-b6a2b9 --writeLa dernière ligne :
Saved operations/releases/1.5.0-c7b614.toml. Run the service with RELEASE_ID=1.5.0-c7b614Dans
.env, définissezRELEASE_IDavec l’identifiant affiché par votre commande. Votre identifiant diffère si votre projet est un dépôt Git ou si un fichier diffère. SiRELEASE_ID=est vide, sautez cette étape. -
Exécutez les tests. Vous devriez obtenir
207 passed(207 tests réussis), soit 7 de plus qu’avant :Fenêtre de terminal python -m pytest207 passed, 1 deselected in 24.87s
| Fichiers | Ce qu’ils ajoutent | Leçon |
|---|---|---|
ops/stats.py, ops/cmd_drift.py |
PSI, khi carré et Wilson avec la bibliothèque standard; python -m ops drift |
celle-ci |
migrations/018_ticket_reviews.sql, ticket_api/reviews.py, main.py, repository.py, scripts/send_reviews.py, ops/cmd_labels.py |
les révisions des agents, POST /v1/tickets/{id}/review, python -m ops labels |
Étiquettes tardives |
migrations/019_answer_index.sql, scripts/reindex.py, scripts/update_document.py, ticket_api/answers.py, scripts/load.py, ops/cmd_rag.py |
l’index de récupération des réponses et python -m ops rag |
Régressions des LLM et du RAG |
tests/test_monitoring.py, contract/openapi.json, README.md, ticket_api/worker.py |
les tests, le contrat de l’API, les commandes; seulement la mise en forme dans worker.py |
les trois |
Lire la simulation de dérive
Section intitulée « Lire la simulation de dérive »Le fichier enregistré data/telemetry/drift.jsonl.gz contient le scénario de dérive. Chaque événement ticket.received (billet reçu) contient une estimation de la langue, faite à partir de mots courants; le texte lui-même n’est jamais enregistré. L’événement contient aussi la longueur du message en caractères et le canal. Chaque événement ticket.triaged (billet trié) contient la décision.
Comparez chaque bloc de 1 000 billets au premier :
python -m ops drift data/telemetry/drift.jsonl.gz --windows 1000Each window of 1000 tickets against the first window:tickets French (guess) PSI language p PSI team--------- -------------- ------------ ----- --------1-1000 5.4% 0.000 1 0.0001001-2000 24.9% 0.343 5e-34 0.0162001-3000 3.4% 0.010 0.029 0.047La première ligne est la référence; elle donne donc 0.000 comparée à elle-même. Le bloc français a un PSI de langue de 0,343 : au-dessus de 0,2, c’est un changement important. Sa valeur p ≈ 5e-34 indique qu’il ne s’agit pas du hasard. Le bloc politique muette a un PSI de 0,010 et p = 0,029 : aucun changement réel, et pas de « certitude » selon la règle p < 0,01.
La dernière colonne est la dérive des prédictions. L’équipe choisie par l’assistant a très peu changé : 0,016 et 0,047, tous deux sous 0,1.
Le rapport complet du cours pour chaque bloc, produit par la même fonction, ajoute la longueur du message. Elle a un peu changé dans les deux blocs : PSI de 0,196 dans le bloc français (médiane de 225 → 178 caractères) et de 0,119 dans le bloc politique muette. Dans le bloc politique muette, rien ne dépasse 0,2.
Des fenêtres plus petites montrent quand le changement commence et finit :
python -m ops drift data/telemetry/drift.jsonl.gz --windows 500Each window of 500 tickets against the first window:tickets French (guess) PSI language p PSI team--------- -------------- ------------ ------- --------1-500 4.8% 0.000 1 0.000501-1000 6.0% 0.003 0.4 0.0131001-1500 24.4% 0.364 1.7e-18 0.0181501-2000 25.4% 0.393 9.3e-20 0.0182001-2500 2.8% 0.011 0.098 0.0192501-3000 4.0% 0.002 0.54 0.065La part du français passe d’environ 5 % à environ 25 %, puis revient à son niveau initial.
Une valeur p minuscule pour un petit changement
Section intitulée « Une valeur p minuscule pour un petit changement »--at divise plutôt la simulation à une minute donnée. Divisez-la au milieu du bloc français, à la minute 9,2 :
python -m ops drift data/telemetry/drift.jsonl.gz --at 9.2Reference: before minute 9.2 (1,105 tickets). Current: from minute 9.2 (1,895 tickets).kind feature PSI p-value verdict reference -> current------ -------------- ----- -------- -------------- ------------------------------------------------------------input language_guess 0.049 3.22e-08 no real change en 93% -> 86%, fr 7% -> 14%input message_chars 0.098 1.71e-10 no real change median 223 -> 187 charactersinput channel 0.000 1 no real change web_form 100% -> 100%output team 0.023 0.00299 no real change delivery 28% -> 25%, warranty 21% -> 20%, returns 17% -> 21%output needs_human 0.000 0.728 no real change False 75% -> 76%, True 25% -> 24%output outcome 0.001 0.435 no real change ok 100% -> 100%, no_answer 0% -> 0%PSI: < 0.1 no real change, 0.1-0.2 small, > 0.2 large (a rule of thumb). p-value: chi-square test; < 0.01 = the difference is unlikely to be chance.Drift is not an error rate: compare the agents' reviews (python -m ops labels).C’est encore le petit exemple, avec de vrais billets. La période actuelle mélange des billets français et des billets politique muette; le français passe donc seulement de 7 % à 14 %. Le PSI est de 0,049, sous 0,1, mais la valeur p est de 3,22e-08, car il y a presque 3 000 billets. Une alarme fondée seulement sur la valeur p se déclencherait pour ce petit changement. Et la dernière ligne le dit : la dérive n’est pas un taux d’erreur.
La dérive et l’exactitude indiquent des directions différentes
Section intitulée « La dérive et l’exactitude indiquent des directions différentes »Ajoutez maintenant les révisions des agents. La prochaine leçon explique ops labels; ici, lisez seulement la colonne « agrees » (en accord) :
python -m ops labels data/telemetry/drift.jsonl.gz --windows 10003,000 tickets, 1,445 reviewed (48%); review delay median 120 s, p95 121 swindow tickets reviewed agrees (95% interval) no answer to a person French----------- ------- -------- --------------------- --------- ----------- ------ 1-1000 1000 474 95.1% [92.8%, 96.7%] 0.1% 25.1% 5.4% 1001-2000 1000 495 95.8% [93.6%, 97.2%] 0.1% 24.0% 24.9% 2001-3000 1000 476 85.3% [81.8%, 88.2%] 0.3% 24.8% 3.4%Reviews arrive later: the last windows have fewer. For a margin of about 5 points on an agreement near 90%, a window needs 139 reviews.Placez les deux tableaux côte à côte :
| Bloc | PSI de langue | Accord avec les révisions |
|---|---|---|
| Normal | 0,000 (la référence) | 95,1 % |
| Français | 0,343, important | 95,8 %, inchangé |
| Politique muette | 0,010, aucun | 85,3 %, sous le SLO |
Le graphique place les deux signaux sur la même horloge. Chaque point est un bloc de 250 billets. La part du français est tracée à l’arrivée du dernier billet du bloc. L’accord est tracé à l’arrivée de la dernière révision du bloc, environ 2 minutes de simulation plus tard.
- Messages en français, connus immédiatement
- Accord avec les révisions, connu plus tard
- SLO de qualité (90 %)
Description textuelle du graphique
L’axe des x montre les 28 minutes de la simulation de dérive. La première courbe, la part des messages en français, reste entre environ 4 % et 7 % jusqu’à la minute 8. Elle monte entre 23 % et 28 % de la minute 10 à la minute 17, puis redescend entre 3 % et 5 %. La deuxième courbe, l’accord avec les révisions des agents, commence à la minute 4. Elle reste entre 94 % et 98 % pendant que le français monte et descend, au-dessus de la ligne pointillée à 90 %. À partir de la minute 20,7, elle tombe entre 81 % et 87 %, sous la ligne, et y reste jusqu’à la fin.
Pourquoi le bloc politique muette a-t-il échoué sans dérive? Ces billets posent des questions sans réponse dans la politique du magasin; la bonne équipe est donc difficile à choisir. Dans le jeu d’exercice, ils ont toujours été le sous-groupe où l’assistant était faible. Leur langue et leur longueur semblent normales, et la répartition des équipes change à peine. Aucune des caractéristiques surveillées par Priya ne pouvait donc les détecter.
Ce n’est pas une dérive conceptuelle. La bonne réponse pour chacun de ces billets n’a pas changé. La répartition s’est déplacée vers des billets où l’assistant était déjà faible, selon une caractéristique que personne ne mesurait. Vous pouvez surveiller plus de caractéristiques. Mais vous ne pouvez jamais énumérer toutes les différences possibles entre les billets; c’est pourquoi les étiquettes existent.
Les signaux rapides des décisions n’ont pas aidé non plus. La part envoyée à une personne est restée près de 25 % dans les trois blocs :
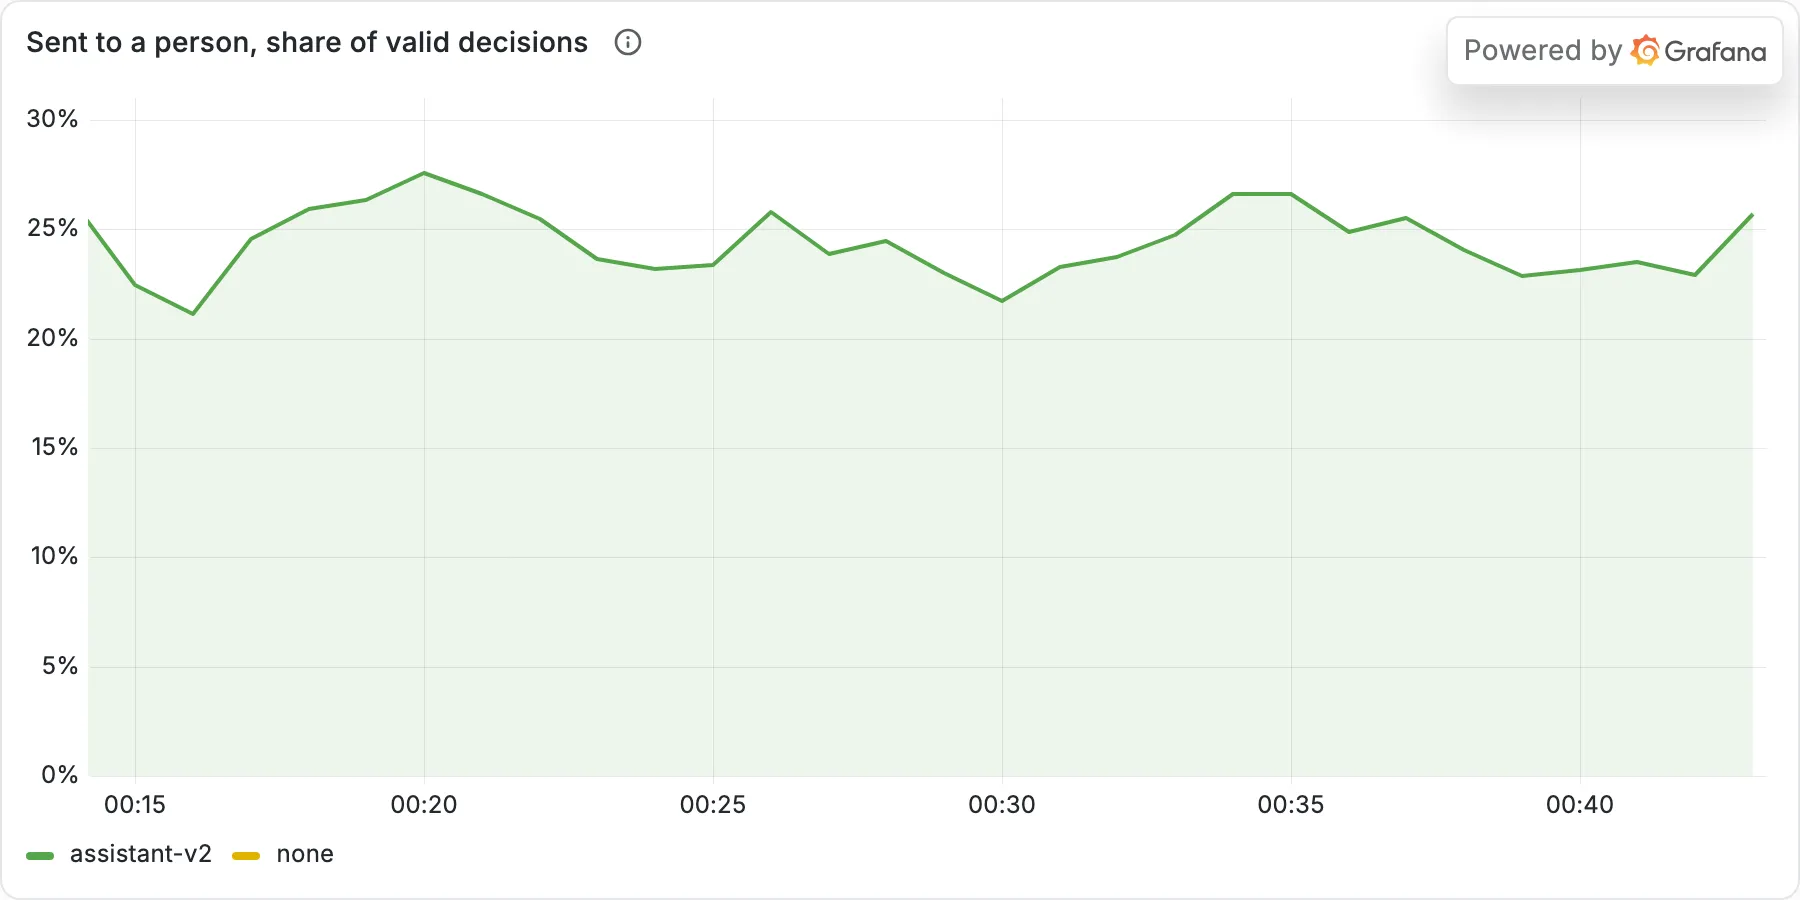
Cette ligne ne permet pas de savoir où commence l’un ou l’autre des blocs.
À quoi ressemblerait une dérive conceptuelle
Section intitulée « À quoi ressemblerait une dérive conceptuelle »La simulation de dérive n’a aucune dérive conceptuelle; voici donc un exemple construit. Supposons que Larkfield décide que chaque billet concernant une batterie nécessite maintenant une personne, à cause d’une nouvelle règle de sécurité. Les billets concernant les batteries semblent exactement comme avant : mêmes mots, longueur et langue. L’assistant indique encore « aucune personne nécessaire » pour la plupart.
Les vérifications de dérive des données et des prédictions ne montrent rien, car ni les entrées ni les décisions n’ont changé. Seules les révisions le montrent : les agents indiquent maintenant « nécessite une personne » pour ces billets, et l’accord diminue. La correction est une nouvelle politique et une nouvelle requête, choisies selon la cause, comme le montre Réentraîner ou réviser au module 5.
« Alerte de dérive déclenchée : réentraîner automatiquement »
Section intitulée « « Alerte de dérive déclenchée : réentraîner automatiquement » »L’idée de Tomás semble sûre. Elle ne l’est pas, pour trois raisons :
- Une dérive n’est pas une erreur. Le bloc en français le montre : un grand changement, sans perte.
- Il n’y a rien à réentraîner. L’assistant se compose d’une requête et d’un modèle hébergé. Une nouvelle requête est une mise en production. Elle doit franchir la barrière d’évaluation du module 5.
- La cause détermine la correction. Les billets non couverts par la politique exigent une réponse dans celle-ci; une nouvelle règle exige une nouvelle requête. Un réentraînement automatique ne choisit ni l’un ni l’autre.
Amira écrit la règle de l’équipe : une alerte de dérive ouvre une enquête, jamais un changement. Priya examine le sous-ensemble qui a changé et demande de réviser ces billets en premier. Elle décide ensuite à partir des révisions.
Quand surveiller la dérive, et à quel coût
Section intitulée « Quand surveiller la dérive, et à quel coût »Sam demande : « Si la dérive ne prouve rien, pourquoi la surveiller? »
Priya répond : « Parce que c’est rapide. Les révisions prennent des jours. La dérive m’indique le jour même quels billets vérifier en premier. »
Surveillez la dérive de quelques entrées que vous pouvez expliquer : langue, longueur, canal, produit. Surveillez aussi les décisions : équipe et besoin d’une personne. Notez la période de référence, la méthode et le seuil dans un fichier, pour que tous lisent le même nombre.
N’alertez pas une personne sur la seule base d’une dérive, et ne déclenchez pas de changement à partir de celle-ci. Ne testez pas de nombreuses caractéristiques avec p < 0,01 en traitant chaque résultat significatif comme une nouvelle. Avec de grands échantillons, presque tout est « différent ».
Le coût : quelques lignes de statistiques et un attribut de télémétrie pour chaque entrée surveillée. Le vrai coût est l’attention : une personne doit examiner chaque alerte de dérive. Gardez donc une liste courte.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
ops drift s'arrête : moins de deux fenêtres
Symptôme : python -m ops drift data/telemetry/drift.jsonl.gz --windows 5000 affiche une ligne et se termine avec le code 2 :
ops drift: fewer than two windows of 5000 ticketsCause : le fichier contient 3 000 billets. L’outil exige une fenêtre de référence et au moins une autre fenêtre complète.
Correction : utilisez une fenêtre contenant au plus la moitié des billets, par exemple --windows 1000. Une fenêtre doit aussi être assez grande pour mesurer ses proportions. Avec 50 billets, un billet en français fait varier la proportion de 2 points.
Erreur courante
ops drift avec un seul fichier et aucune division
Symptôme : python -m ops drift data/telemetry/drift.jsonl.gz se termine avec le code 2 :
ops drift: give two files, or one file with --at or --windowsCause : la dérive compare toujours « cette période à cette autre période ». Avec un seul fichier, l’outil ne sait pas quelle période sert de référence.
Correction : ajoutez --windows N ou --at MINUTE, ou fournissez deux fichiers : la référence d’abord, puis le fichier actuel.
Réinitialisation. Si votre projet ne fonctionne plus, copiez l’instantané end-of-m04, gardez votre .env, puis exécutez python -m scripts.load --reset. Refaites ensuite l’étape 4 de Ajouter les fichiers du module. Le README des instantanés explique la réinitialisation.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Nommez les quatre types de changement de cette leçon. Pour chacun, dites si la télémétrie du service peut le montrer le jour même, et pourquoi.
Afficher la réponse
Dérive des données (les billets changent) et dérive des prédictions (les décisions changent) : oui. Les deux apparaissent dans la télémétrie quelques secondes après chaque billet. Dérive conceptuelle (la bonne réponse pour le même billet change) et baisse de performance (les décisions concordent moins avec les révisions) : non. Les deux exigent les vraies réponses, soit les révisions des agents, qui arrivent plus tard. Une dérive conceptuelle peut survenir sans aucune dérive des données ni des prédictions.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : la proportion des billets de Larkfield concernant les retours passe de 20 % à 22 %. Avec 100 billets par période, puis 10 000, que deviennent le PSI et la valeur p?
Afficher la réponse
Le PSI reste identique dans les deux cas, car il dépend seulement des proportions. Il vaut (0,22 − 0,20) × ln(0,22 ÷ 0,20) + (0,78 − 0,80) × ln(0,78 ÷ 0,80) ≈ 0,0019 + 0,0005 ≈ 0,0024, bien en dessous de 0,1. La valeur p devient beaucoup plus petite avec 10 000 billets. Avec 100 billets, une différence de 2 points peut facilement venir du hasard. Avec 10 000, elle est réelle, mais minuscule. Rapportez « aucun changement réel », avec le PSI.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : avec l'exécution de dérive enregistrée, montrez un grand changement de langue sans baisse de qualité dans un bloc. Montrez aussi une baisse de qualité sans dérive des entrées dans un autre bloc. Quelles commandes et quelles lignes utilisez-vous?
Afficher la réponse
python -m ops drift data/telemetry/drift.jsonl.gz --windows 1000 : les billets 1 001–2 000 ont un PSI de langue de 0,343 (grand, p ≈ 5e-34); les billets 2 001–3 000 ont un PSI de 0,010. python -m ops labels data/telemetry/drift.jsonl.gz --windows 1000 : concordance de 95,8 % dans le bloc en français, et de 85,3 % [81,8 %, 88,2 %] dans le troisième bloc. Votre projet doit aussi afficher 207 passed (207 tests réussis).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- La dérive des données est un changement des entrées, et la dérive des prédictions, un changement des décisions. La dérive conceptuelle est un changement de la bonne réponse pour une même entrée. La baisse de performance est une diminution mesurée de la qualité. C’est la seule qui mesure les erreurs, et elle exige des étiquettes.
- Le PSI indique l’ampleur du changement d’une distribution (repères conventionnels : < 0,1 aucun, 0,1–0,2 petit, > 0,2 grand). La valeur p du khi carré indique votre degré de certitude. Avec beaucoup de billets, les changements minuscules donnent des valeurs p minuscules. Lisez donc les deux.
- Dans l’exécution de dérive, les billets en français ont produit un grand changement (PSI de 0,343), sans perte de qualité (95,8 %). Les billets non couverts par la politique n’ont produit aucun changement réel de langue (0,010). La qualité a chuté à 85,3 %.
- Une alerte de dérive ouvre une enquête. Elle ne déclenche jamais un réentraînement ni une mise en production.
- Votre projet contient les fichiers du module, et
python -m pytestaffiche207 passed.
Ensuite, vous examinez les étiquettes elles-mêmes : les révisions des agents. Elles arrivent tard. Que surveillez-vous entre-temps, et combien de billets les personnes doivent-elles vérifier?
Leçon suivante : Étiquettes tardives