
Faire tourner le service en production
- Leçon 1
- 45 min
- Module 1 : Définir la responsabilité opérationnelle
Où nous en sommes
Vous connaissez déjà le service de billets du cours Mettre à l'échelle les API et les charges de travail d'IA, et son assistant du cours Évaluer et tester les systèmes d'IA. Mais un test avant la mise en production ne montre pas ce qui se passe après : le service est maintenant en production, et de vrais billets arrivent sans arrêt. Dans cette leçon, nous faisons tourner le service et nous lisons une semaine de télémétrie sauvegardée, comme un nouveau responsable de nuit dans un hôtel qui ne ferme jamais.
Leçon 1 sur 19 · MLOps et LLMOps : exploiter l'IA en productionFaire tourner le service en production
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
Le service de billets de soutien de Larkfield est en production, et son assistant trie maintenant chaque billet. Faites tourner le service sur votre ordinateur, envoyez-lui des billets d’exercice et lisez une semaine de télémétrie sauvegardée avec l’outil ops du cours.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le service de billets
ticket-apidu cours Mettre à l’échelle les API et les charges de travail d’IA : le fournisseur d’IA simulé, la file de tâches et le processus de Cycle de vie d’une tâche, ainsi quepython -m scripts.queue_watchde Contre-pression. - L’assistant du centre de soutien du cours Évaluer et tester les systèmes d’IA : la requête (prompt) v2 (la référence de base), la requête v3 (la candidate) et la décision DO NOT SHIP (ne pas mettre en production) pour v3 dans Compromis et régressions.
- Les versions de mise en production du cours CI/CD, tests et mises en production sûres, et la base de données du cours Bases de données et stockage pour les applications d’IA.
Ce qu’il vous faut sur votre ordinateur
- Python 3.12 ou une version plus récente, Docker Desktop, VS Code et un terminal.
- Environ 200 Mo d’espace disque libre pour l’environnement virtuel, et environ 15 Mo pour la télémétrie sauvegardée. Aucun compte, aucune clé et aucun coût.
Vous partez de l’instantané start : le projet à la fin du cours sur la mise à l’échelle, sans modification. Si vous avez votre propre ticket-api de ce cours, conservez-le sous un autre nom.
Sans Docker, vous ne pouvez pas faire tourner le service. Vous pouvez quand même faire la dernière partie de cette leçon, Lire une semaine sauvegardée, et toutes les analyses suivantes du cours. Vous avez seulement besoin de Python.
Un nouvel emploi : le quart de nuit
Section intitulée « Un nouvel emploi : le quart de nuit »Imaginez que vous commencez un nouvel emploi comme responsable de nuit dans un petit hôtel. L’hôtel est ouvert, et personne ne le fermera pour vous laisser apprendre.
La première nuit, vous ne changez rien. Vous faites une fois le tour du bâtiment. Vous observez l’arrivée d’un client, de la porte jusqu’à sa chambre. Ensuite, vous lisez le registre de la semaine dernière.
C’est ce que vous faites dans cette leçon. Le service de billets est l’hôtel. Vous le faites tourner une fois sur votre ordinateur. Vous suivez un billet du site Web au centre de soutien. Ensuite, vous lisez le journal d’une semaine entière.
Le service de Larkfield est en production
Section intitulée « Le service de Larkfield est en production »Vous connaissez le centre de soutien de Larkfield grâce aux cours précédents. Dans Mettre à l’échelle les API et les charges de travail d’IA, Amira a préparé le service de billets pour le Vendredi fou. Dans Évaluer et tester les systèmes d’IA, Priya a testé l’assistant du centre de soutien. Maintenant, les deux se rejoignent : le service de billets est en production pour de vrais clients, et l’assistant trie chaque nouveau billet.
Les personnes sont les mêmes : Amira, la développeuse, vous guide; Priya est responsable de la qualité de l’assistant; Grace dirige le centre de soutien; Mei, Kwame, Omar, Tomás et Sam sont aussi là.
Le tableau de bord indique que le service fonctionne 99,9 % du temps. Mais la semaine dernière, des clients ont attendu deux jours des réponses à leurs billets liés à la sécurité, sans que personne le remarque. Voici le tableau de bord du service pendant cette semaine :
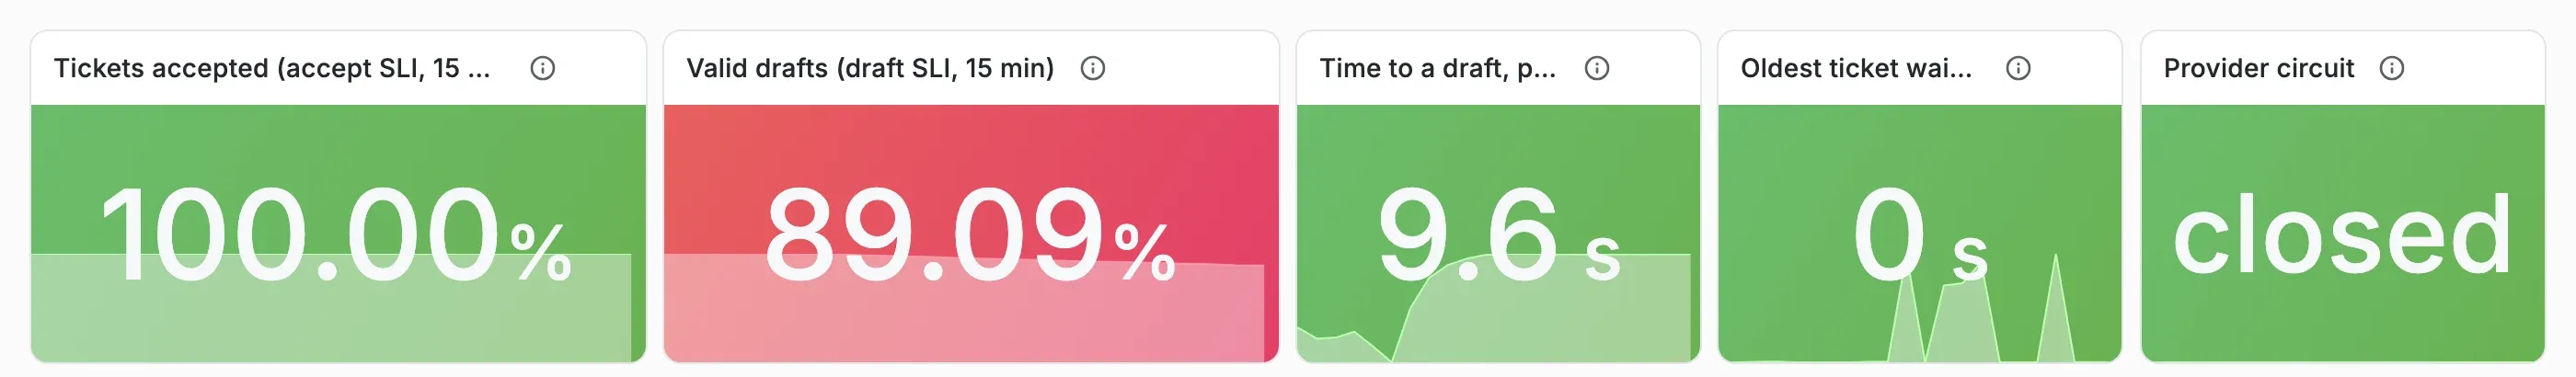
Le premier panneau montre la « disponibilité » que tout le monde surveillait : 100 % des billets acceptés. Le deuxième panneau raconte une autre histoire : seulement 89,09 % des billets ont reçu une réponse valide de l’assistant. Les autres ont été sauvegardés, puis sont restés en attente sans que personne s’en occupe. Un client a écrit que la poignée d’une poêle était fissurée et très chaude, et a demandé si c’était sécuritaire.
Que s’est-il passé? L’équipe d’Omar a fait passer l’assistant à la requête v3 avec un seul réglage, pour tous les billets. Le cours sur l’évaluation avait dit DO NOT SHIP pour v3. Personne n’a fait le lien entre le changement de réglage et les réponses vides.
Grace pose la question de ce cours : « Comment saurions-nous que l’assistant ne répond pas aux besoins de nos clients, avant qu’ils nous le disent? »
Faire fonctionner un modèle en production, et le garder fonctionnel, porte un nom : MLOps (exploitation de l’apprentissage automatique). LLMOps désigne le même travail pour les applications basées sur de grands modèles de langage, avec leurs propres éléments : requêtes, modèles des fournisseurs, index de récupération. Dans ce cours, vous faites les deux pour un seul service.
Il s’agit d’une relecture pour s’exercer. Le cours a provoqué l’incident volontairement, sur le vrai service, et les réponses de l’assistant sont de vraies réponses enregistrées. Vous lisez ses chiffres à la fin de cette leçon.
Ce qui a changé dans le service : l’étape de triage
Section intitulée « Ce qui a changé dans le service : l’étape de triage »Dans le cours sur la mise à l’échelle, le processus posait deux questions au fournisseur pour chaque billet : classer (équipe et priorité) et rédiger une réponse. Maintenant, une seule requête fait les deux tâches. C’est exactement la requête du cours sur l’évaluation : mêmes fichiers de requêtes, même politique, même schéma de sortie et même limite de jetons (tokens). Cette étape est le triage : le premier classement d’un billet, comme à l’urgence d’un hôpital.
L’assistant donne trois éléments pour chaque billet :
- L’équipe : livraison, retours, paiement, garantie ou compte. Ce sont les cinq équipes du cours sur l’évaluation. Les billets sauvegardés auparavant gardent leurs anciens noms d’équipe.
- Besoin d’une personne (
needs_human) : vrai quand les règles de Grace exigent qu’une personne traite le billet, par exemple un problème de sécurité. - Un brouillon de réponse, qu’un agent vérifie avant l’envoi.
L’assistant ne donne aucune priorité, alors le service la définit : priorité 1 quand une personne doit traiter le billet, priorité 2 sinon. L’assistant lit le corps du billet, le message du client lui-même. L’objet est un court titre que le site Web crée à partir de la première phrase.

Description textuelle du diagramme
Le client envoie un billet. L’API le sauvegarde avec une tâche dans PostgreSQL et répond 202 Accepted (accepté) immédiatement, comme dans la conception de file du cours sur la mise à l’échelle. Plus tard, le processus prend la tâche et envoie une requête de triage au fournisseur. Environ 3 secondes plus tard, la réponse revient avec l’équipe, la décision et le brouillon. Le processus demande aussi le plongement (embedding) du billet, puis sauvegarde le tout. La dernière note compte pour ce cours : quand la réponse n’a aucun texte, la tâche échoue, le billet reste sans équipe et personne n’est averti.
D’où viennent les réponses : relecture et simulation
Section intitulée « D’où viennent les réponses : relecture et simulation »Dans le cours sur la mise à l’échelle, les délais du fournisseur simulé étaient réels, mais ses réponses étaient une phrase fixe. Cela convenait aux tests de charge. Ce cours demande si les réponses sont bonnes, et une phrase fixe ne produit jamais d’erreurs intéressantes à étudier.
Le cours sur l’évaluation a envoyé les requêtes de l’assistant à un vrai modèle hébergé et conservé chaque réponse. Cela représente 1 358 appels enregistrés : 679 avec la requête v2 et 679 avec la requête v3. Certains billets ont été envoyés plusieurs fois, alors il y a 542 requêtes différentes. Le simulateur possède maintenant ces enregistrements. Quand il reçoit une requête enregistrée, il renvoie une des réponses enregistrées, après le délai enregistré. C’est une relecture : comme l’enregistrement d’un concert, la musique est réelle, mais on la rejoue à un autre moment.

Description textuelle du diagramme
Le simulateur crée une clé à partir des champs de la requête. Ce sont le modèle, les messages (requête, politique et texte du billet), le schéma de sortie et la limite de jetons. Si la clé correspond à l’une des 542 requêtes enregistrées, la réponse est rejouée : un vrai modèle l’a écrite. Si vous écrivez vous-même un billet, la clé est nouvelle, et le simulateur crée une réponse simulée à partir d’un gabarit. Son délai, son nombre de jetons et sa fréquence d’interruption proviennent quand même des enregistrements.
Pour obtenir des réponses rejouées, vous envoyez des billets d’exercice : les 271 billets inventés du cours sur l’évaluation, avec les étiquettes données par l’équipe de Grace. Trois d’entre eux n’ont qu’une pièce jointe et aucun texte, donc 268 peuvent être envoyés. Aucun vrai client n’en a écrit.
Ce que les enregistrements révèlent sur les deux requêtes :
| Requête | Appels enregistrés | Réponses sans texte | Délai médian | Le plus lent |
|---|---|---|---|---|
| v2 (en production) | 679 | 1 (billet T-65450, « bougie d’allumage ») | 2,95 s | 10,0 s |
| v3 (candidate) | 679 | 88 | 5,55 s | 12,1 s |
Une réponse sans texte est un appel qui a utilisé ses 1 000 jetons pour le raisonnement caché du modèle. Il s’est arrêté avant d’écrire la réponse JSON. Le fournisseur signale cela par finish_reason: length (raison d’arrêt : longueur). Le processus ne peut pas lire une équipe ou une décision dans une réponse vide. Gardez la ligne v2 en tête : même la bonne requête produit une telle réponse, et un module ultérieur explique pourquoi cela compte.
Préparer le projet
Section intitulée « Préparer le projet »Vous copiez l’instantané start, vérifiez qu’il fonctionne, puis copiez l’instantané end-of-m01 de ce module par-dessus.
-
Obtenez les fichiers du cours. Si vous avez Git, clonez le dépôt des exercices une fois, dans
~/projects. Si vous avez déjà le clone, exécutez plutôtgit -C nextia-learning-labs pull.Fenêtre de terminal cd ~/projectsgit clone https://github.com/Nextia-Intelligence/nextia-learning-labs.gitSans Git, téléchargez le fichier ZIP du dépôt, puis décompressez-le dans
~/projects. Son dossier est alorsnextia-learning-labs-main. Utilisez ce nom dans les étapes suivantes. -
Si un dossier
ticket-apiexiste, renommez-le d’abord. Ensuite, copiez l’instantanéstart, puis créez votre.envet le fichier de clé d’API :Fenêtre de terminal mv ticket-api ticket-api-scaling # only if the folder existscp -R nextia-learning-labs/C25/snapshots/start ticket-apicd ticket-apicp .env.example .envmkdir -p secrets && echo "local-practice-key" > secrets/api_key.txtFenêtre de terminal Rename-Item ticket-api ticket-api-scaling # only if the folder existsCopy-Item -Recurse nextia-learning-labs\C25\snapshots\start ticket-apicd ticket-apiCopy-Item .env.example .envNew-Item -ItemType Directory -Force secrets; Set-Content secrets\api_key.txt "local-practice-key" -
Ouvrez le dossier dans VS Code. Dans
.env, remplacezchange-me-local-onlypar votre propre mot de passe, aux trois endroits. -
Démarrez Docker Desktop. Ensuite, démarrez PostgreSQL, Azurite et Valkey :
Fenêtre de terminal docker compose up -d db azurite cache -
Créez l’environnement virtuel, installez les paquets, chargez les données et exécutez les tests :
Fenêtre de terminal python3 -m venv .venvsource .venv/bin/activatepython -m pip install -r requirements.txtpython -m scripts.loadpython -m pytestFenêtre de terminal python -m venv .venv.venv\Scripts\Activate.ps1python -m pip install -r requirements.txtpython -m scripts.loadpython -m pytestLes tests se terminent par
176 passed, 1 deselected(176 réussis, 1 désélectionné). C’est le projet du cours sur la mise à l’échelle, et il fonctionne. -
Copiez l’instantané
end-of-m01par-dessus votre projet. Il n’a ni.envnisecrets/, donc les vôtres restent.Fenêtre de terminal cp -R ../nextia-learning-labs/C25/snapshots/end-of-m01/. .Fenêtre de terminal Copy-Item -Recurse -Force ..\nextia-learning-labs\C25\snapshots\end-of-m01\* .L’instantané contient aussi les fichiers des trois prochaines leçons, alors vous ne faites qu’une copie dans ce module.
-
Appliquez la nouvelle migration et chargez les données à nouveau. Les tables contiennent déjà des données, alors ajoutez
--reset:Fenêtre de terminal python -m scripts.load --resetapplied 015_triageDatabase is up to date (15 migrations).Loaded the small data in 0.6 s:customers 40tickets 200messages 331attachments 43documents 36ai_runs 294ticket_embeddings 20043 files uploaded to the object storage.3 messages have no ticket: they are in orphaned_messages.Une migration est nouvelle :
015_triage. Le petit jeu de données est le même qu’avant. -
Exécutez les tests :
python -m pytest. Attendez-vous à185 passed, 1 deselected(185 réussis, 1 désélectionné), soit 9 de plus qu’avant. Les nouveaux tests vérifient l’étape de triage, la relecture et l’outilops.
Ce que font les nouveaux fichiers
Section intitulée « Ce que font les nouveaux fichiers »| Fichier | Ce qu’il fait |
|---|---|
ticket_api/assistant.py |
La requête de triage et le code qui lit sa réponse. |
ticket_api/prompts/ |
Les requêtes v2 et v3, la politique de Grace et le schéma de sortie. |
migrations/015_triage.sql |
La tâche triage, les cinq équipes, needs_human, finish_reason. |
simulator/replay.py, recorded_assistant.jsonl.gz |
Les réponses enregistrées, trouvées par clé de requête. |
scripts/practice.py, data/practice/ |
Envoie des billets d’exercice; sauvegarde leurs identifiants dans practice/sent.jsonl. |
ops/ |
L’outil ops du cours : lit les fichiers sauvegardés, avec la bibliothèque standard seulement. |
operations/ |
Les fichiers des trois prochaines leçons. |
Un réglage est nouveau dans .env.example : ASSISTANT_PROMPT=assistant-v2, la requête en production (celle par défaut, donc votre .env n’en a pas besoin). C’est le réglage que l’équipe d’Omar a changé la semaine dernière.
Faire tourner le service : trois terminaux et des billets d’exercice
Section intitulée « Faire tourner le service : trois terminaux et des billets d’exercice »Vous faites tourner trois services et envoyez des billets depuis un quatrième terminal. Activez l’environnement virtuel dans chaque terminal.
-
Terminal 1, le fournisseur simulé. Laissez-le tourner.
Fenêtre de terminal python -m simulatorSimulated AI provider on http://127.0.0.1:8300/v1 (mode normal). Its times and quota come from real recorded calls; its answers are simple. Stop it with Ctrl+C.La première ligne est encore celle du cours sur la mise à l’échelle. Pour les billets d’exercice, « ses réponses sont simples » n’est plus vrai : elles sont rejouées.
-
Terminal 2, l’API. Laissez-la tourner aussi.
Fenêtre de terminal fastapi dev -
Terminal 3, le processus. Il prend les billets dans la file et les trie.
Fenêtre de terminal python -m ticket_api.workerWorker your-computer-46114: up to 4 jobs at a time. Stop it with Ctrl+C.Le nom du processus combine le nom de votre ordinateur et le numéro du processus.
-
Terminal 4, les billets d’exercice. Envoyez 20 billets d’exercice, 2 par seconde :
Fenêtre de terminal python -m scripts.practice --tickets 20 --rate 2Sent 20 practice tickets in 9.5 s: 202: 20Saved the ticket IDs in practice/sent.jsonl. The worker does their AI work; watch it withpython -m scripts.queue_watch
Chaque billet a reçu 202 : l’API l’a accepté et a mis une tâche dans la file. Dans le terminal 3, le processus écrit une ligne de journal par tâche, par exemple job 1: succeeded (attempt 1) (tâche 1 : réussie, tentative 1). Vos délais seront différents.
Maintenant, regardez la file, comme dans le cours sur la mise à l’échelle. Appuyez sur Ctrl+C après quelques lignes :
python -m scripts.queue_watchL’exécution de l’auteur, démarrée juste après le script d’exercice :
time queued ready running oldest s done/min dead 0 8 8 4 3.7 8 0 1 6 6 4 3.7 10 0 2 6 6 4 4.7 10 0 3 6 6 4 5.7 10 0 4 3 3 4 5.2 13 0 5 3 3 4 6.2 13 0 6 2 2 4 6.7 14 0 7 2 2 4 7.7 14 0Le processus exécute 4 tâches à la fois. Deux billets arrivent chaque seconde et chacun prend environ 3 secondes, alors la file grossit un peu, puis se vide. Quelques secondes plus tard, done/min (tâches terminées par minute) atteint 20.
Lisez le résultat d’une tâche. Le premier billet après un nouveau chargement est T-500001, avec la tâche 1. Sur Windows, tapez curl.exe au lieu de curl.
curl http://127.0.0.1:8000/v1/jobs/1{"job_id":1,"ticket_id":"T-500001","state":"succeeded","attempts":1,"max_attempts":5,"created_at":"2026-10-11T07:52:30.687528Z","started_at":"2026-10-11T07:52:30.856745Z","finished_at":"2026-10-11T07:52:33.525167Z","last_error":null,"result":{"team":"delivery","priority":2,"needs_human":false,"draft_reply":"I'm sorry your fire pit arrived damaged. Please send us photos of the damage within 14 days of delivery. The team will send a replacement at no cost, or provide a full refund if a replacement is not in stock.","embedding_version":"embed-small-384-v1"}}Le résultat contient les trois sorties de l’assistant : l’équipe delivery (livraison), needs_human: false (pas besoin d’une personne, donc priorité 2), et un brouillon de réponse. Un vrai modèle a écrit cette réponse pour ce message précis.
Enfin, demandez au simulateur d’où viennent ses réponses :
curl http://127.0.0.1:8300/admin/stats{"mode":"normal","in_flight":0,"max_in_flight":4,"calls":{"embed":{"200":20},"triage":{"200":20}},"tokens":46593,"triage_answers":{"replayed":20},"model_version":"gpt-6-luna-2026-09-22","simulated":true}triage_answers (réponses de triage) compte les réponses selon leur provenance : les 20 ont été rejouées. model_version (version du modèle) est la version du modèle hébergé qui a produit les enregistrements. Maintenant, envoyez un billet que vous écrivez vous-même :
curl -X POST http://127.0.0.1:8000/v1/tickets -H "Content-Type: application/json" \ -d '{"customer_id": "C-0022", "subject": "Charged twice", "body": "Two payments for one order."}'Sur Windows, mettez-le sur une seule ligne sans le \, et tapez curl.exe. Quelques secondes plus tard, sa tâche (la tâche 21, après les 20 billets d’exercice) a une équipe et la réponse du gabarit Thank you for your message. We will reply with the next steps soon. (Merci pour votre message. Nous vous répondrons bientôt avec les prochaines étapes.), et les statistiques affichent "triage_answers":{"replayed":20,"simulated":1} (20 réponses rejouées, 1 simulée). Personne n’a enregistré ce message, alors sa réponse est simulée.
Arrêtez le processus, l’API et le simulateur avec Ctrl+C quand vous avez terminé. Vous pouvez aussi arrêter les conteneurs : docker compose stop.
Lire une semaine enregistrée avec l’outil ops
Section intitulée « Lire une semaine enregistrée avec l’outil ops »Vous avez traité 20 billets. Dans les données de ce cours, Larkfield reçoit environ 822 billets par jour. Pour examiner une semaine, il faut une semaine de billets et un relevé de ce qui est arrivé à chacun.
Ce relevé est la télémétrie : les données qu’un service écrit sur son propre travail pendant qu’il fonctionne. Dans Journaux, métriques et traces, vous l’ajoutez vous-même au service. Pour l’instant, vous lisez la télémétrie que l’équipe du cours a enregistrée. L’équipe a exécuté le même service, avec les mêmes réponses enregistrées, dans des scénarios d’exercice. Chaque scénario est un fichier de lignes JSON : un enregistrement par ligne, sur un événement d’un billet.
Les scénarios envoient 2 billets par seconde, soit environ 210 fois la moyenne réelle de Larkfield. Ainsi, une semaine de billets (5 754) a été traitée en 48 minutes. Le cours compte en billets, pas en jours. Les nombres restent donc valables à la vitesse réelle. Les temps de l’assistant sont les temps réellement enregistrés.
-
Copiez la télémétrie enregistrée et les fichiers de mise en production dans le dossier
data/de votre projet :Fenêtre de terminal cp -R ../nextia-learning-labs/C25/data/telemetry ../nextia-learning-labs/C25/data/releases data/Fenêtre de terminal Copy-Item -Recurse ..\nextia-learning-labs\C25\data\telemetry, ..\nextia-learning-labs\C25\data\releases data\Sans Docker, une copie de l’instantané
end-of-m01et Python 3.12 suffisent :opsn’a besoin d’aucun paquet. -
Lisez la semaine normale :
Fenêtre de terminal python -m ops summary data/telemetry/normal-week.jsonl.gzRecords: 13,558 logs, 11,614 spans, 9,240 metric records, from +0.0 min to +48.0 minTicket requests: 5,754 (202: 5,754)Tickets triaged: 5,754 (ok: 5,750, no_answer: 4)Prompt versions: assistant-v2 5,754Where the answers come from: replayed 5,754 (100.00%)Sent to a person (needs_human): 1,446 (25.13%)Agents' reviews (delayed labels): 1,567; answers to questions: 470
Lisez le résultat ligne par ligne :
- Enregistrements : journaux, segments de trace et métriques, expliqués dans Journaux, métriques et traces. Les temps sont en minutes depuis le début du fichier.
- Requêtes de billets : l’API a accepté les 5 754 billets.
- Billets triés : 4 réponses n’avaient aucun texte. Les quatre proviennent du même enregistrement « bougie d’allumage » de v2, sélectionné quatre fois.
- Versions de la requête, provenance : chaque billet a utilisé v2, et chaque réponse a été rejouée.
- Transmis à une personne : un billet sur quatre.
- Révisions des agents : les agents ont ensuite vérifié 1 567 billets. Une leçon ultérieure les utilise pour mesurer la qualité.
Lisez maintenant la semaine dernière, qui rejoue le passage à la requête v3 :
python -m ops summary data/telemetry/release-full.jsonl.gzRecords: 5,907 logs, 46,987 spans, 3,440 metric records, from +0.0 min to +20.1 minTicket requests: 2,400 (202: 2,400)Tickets triaged: 2,400 (ok: 2,203, no_answer: 187, dead_letter: 10)Prompt versions: assistant-v3 1,798, assistant-v2 602Where the answers come from: replayed 2,390 (99.58%), None 10 (0.42%)Sent to a person (needs_human): 637 (26.54%)Agents' reviews (delayed labels): 1,051; answers to questions: 0Encore une fois, tous les billets ont été acceptés. Mais 187 billets n’ont reçu aucune réponse : 186 avec v3, et la réponse « bougie d’allumage » de v2. Dix autres sont devenus des lettres mortes, les tâches qui ont échoué aux 5 tentatives, comme dans Livraison et nouvelles tentatives. Une réponse de v3 a pris 12,1 secondes, alors que le délai maximal du service est de 10 secondes. Chaque tentative a donc échoué. Une lettre morte n’a jamais reçu de réponse, donc sa « provenance » est None (aucune). Les 1 798 billets de v3 représentent environ 2,2 jours de billets chez Larkfield, ce qui correspond à « deux jours ».
L’équipe du cours a comparé les réponses vides aux étiquettes des billets d’exercice. Dix de ces billets nécessitaient une personne. Il s’agissait de la poêle (5 fois), d’un parasol tombé vers un enfant (3 fois), d’un colis livré à la mauvaise maison et d’un billet en espagnol sur une commande perdue. Chacun attendait, sans équipe assignée, et personne ne s’en occupait.
Quand utiliser une relecture
Section intitulée « Quand utiliser une relecture »Sam demande : « Donc, c’est le vrai assistant ou pas? »
Amira répond : « Les réponses sont réelles. Un vrai modèle a écrit chacune d’elles, pour cette requête précise. Le trafic, les moments d’arrivée et l’incident sont inventés. On peut donc se fier à la relecture pour voir comment l’assistant répond. Mais pas pour voir comment les clients se comportent. »
Utilisez une relecture pour observer le comportement réel d’un modèle sans les coûts, le compte et les changements d’un fournisseur actif. Ne l’utilisez pas pour évaluer de nouvelles requêtes ou de nouveaux billets : ils reçoivent des réponses simulées. Elle répète aussi des réponses rares : la réponse « bougie d’allumage » est un seul enregistrement, sélectionné plusieurs fois dans un long scénario. Elle demande aussi du travail : quelqu’un a enregistré les appels, et ces enregistrements vieillissent quand le fournisseur change son modèle. Chaque nombre du cours indique donc s’il est mesuré, rejoué, simulé ou fondé sur une hypothèse.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Le processus ne fonctionne pas : les billets attendent
Symptôme : scripts.practice affiche 202 pour chaque billet, mais queue_watch montre la colonne queued (en attente) à 20. La colonne oldest s (ancienneté maximale en secondes) augmente de un chaque seconde. GET /v1/jobs/1 affiche "state":"queued" (état : en attente) et aucun résultat.
Cause : rien ne prend les tâches. Le terminal 3 est fermé, ou le processus s’est arrêté à cause d’une erreur.
Diagnostic : l’API accepte les billets sans le processus, comme prévu. C’est la file d’attente du cours Mettre à l’échelle les API et les charges de travail d’IA. Une file pleine sans erreurs indique donc l’absence d’un processus.
Solution : lancez python -m ticket_api.worker dans le terminal 3. Il prend les 20 tâches, et la file se vide en quelques secondes. C’est aussi votre premier aperçu du problème de ce cours : tous les billets sont acceptés, mais aucun client ne reçoit de réponse.
Erreur courante
ops : aucun fichier
Symptôme :
ops summary: no file data/telemetry/normal-week.jsonlCause : le chemin est incorrect. Ici, il manque .gz. La commande échoue aussi ainsi si vous l’exécutez depuis un autre dossier ou si vous n’avez pas copié la télémétrie enregistrée.
Solution : exécutez ops depuis le dossier du projet et vérifiez le nom avec ls data/telemetry (Windows : dir data\telemetry). L’outil ops lit les fichiers .jsonl et .jsonl.gz.
Réinitialisation. python -m scripts.load --reset recharge les données, et les nouveaux billets recommencent à T-500001. practice/sent.jsonl grossit chaque fois que vous envoyez des billets; supprimez le dossier practice pour recommencer. Si votre projet ne fonctionne plus, copiez l’instantané end-of-m01 et conservez vos .env et secrets/, comme l’explique le README des instantanés.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Un billet d'exercice et un billet que vous écrivez vous-même reçoivent tous deux une réponse du fournisseur simulé. Quelle différence y a-t-il entre les deux réponses? Laquelle permet de juger la qualité de l'assistant?
Afficher la réponse
La requête du billet d’exercice fait partie des 542 requêtes enregistrées. Sa réponse est donc rejouée : un vrai modèle a écrit ce texte, avec ses vrais jetons, temps et motif d’arrêt. La requête de votre propre billet est nouvelle. Sa réponse est donc simulée : un texte type, avec des temps, des jetons et des coupures tirés des enregistrements. Seule la réponse rejouée renseigne sur la qualité de l’assistant. curl http://127.0.0.1:8300/admin/stats compte les deux types dans triage_answers (réponses de triage).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Dans le résumé de la semaine dernière, chacun des 2 400 billets a reçu un 202. Expliquez pourquoi ce nombre n'a pas révélé le problème.
Afficher la réponse
Le 202 signifie que l’API a enregistré le billet et placé sa tâche dans la file d’attente. Le travail de l’IA se fait plus tard, dans le processus. Avec la requête v3, 186 réponses n’avaient aucun texte et 10 billets sont devenus des lettres mortes. En comptant la réponse vide de v2, 197 billets n’ont reçu ni équipe, ni décision, ni brouillon. L’API n’a jamais vu cela : elle avait déjà répondu. Un nombre de requêtes acceptées mesure seulement la première étape du parcours du client.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : montrez que votre installation fonctionne. Qu'affichent les tests, le script d'exercice et les statistiques du simulateur?
Afficher la réponse
python -m pytest termine avec 185 passed, 1 deselected (185 tests réussis, 1 exclu). python -m scripts.practice --tickets 20 --rate 2 affiche Sent 20 practice tickets (20 billets d’exercice envoyés) avec 202: 20. Une fois que le processus les a pris, curl http://127.0.0.1:8300/admin/stats affiche "triage_answers":{"replayed":20} (20 réponses de triage rejouées) : chaque réponse était un véritable enregistrement. Sans Docker, python -m ops summary data/telemetry/normal-week.jsonl.gz affiche Ticket requests: 5,754 (202: 5,754) (5 754 requêtes de billets acceptées) et Tickets triaged: 5,754 (ok: 5,750, no_answer: 4) (5 754 billets triés, dont 5 750 réussis et 4 sans réponse).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Études de cas de ce cours
À la fin du cours, vous appliquez ce que vous avez appris à un projet réaliste, des données jusqu’à la recommandation. Terminez-en au moins une pour obtenir le certificat; les autres sont facultatives.
- Surveiller un modèle sur des données publiques qui changentEntraîner un modèle simple sur les premiers mois d'un jeu de données public et daté, puis construire mois par mois sa surveillance de la dérive et des étiquettes tardives, et dire ce que cette surveillance peut prouver et ce qu'elle ne peut pas prouver.
- Analyse post-incident d'une panne publiqueReconstruire la chronologie, la détection, l'atténuation et les actions préventives d'un rapport d'incident publié par un fournisseur, dans le format de procédure et d'analyse du cours.
Récapitulatif
- Le service de billets est en production. Une requête de triage par billet indique l’équipe, si une personne doit le traiter, et un brouillon. C’est l’assistant du cours Évaluer et tester les systèmes d’IA, avec la requête v2.
- Le fournisseur simulé rejoue des réponses réellement enregistrées pour les 268 billets d’exercice et simule des réponses pour tout autre texte. La requête v2 compte 1 réponse sans texte sur 679 enregistrements; la requête v3 en compte 88.
- La télémétrie est le relevé qu’un service écrit sur son propre travail.
python -m ops summarylit un fichier enregistré : la semaine normale comptait 5 754 billets, tous acceptés, dont 4 sans réponse. - La semaine dernière, dans une relecture d’exercice, tous les billets ont été acceptés, mais 197 n’ont reçu aucune réponse. Parmi eux, 10 nécessitaient une personne. Le travail des MLOps et des LLMOps consiste à repérer et à prévenir ces situations.
Ensuite, vous listez toutes les dépendances du service, la version de chaque élément et le premier signe de défaillance.
Leçon suivante : Ce qui est exploité