
Raisonnement et multimodalité
- Leçon 6
- 40 min
- Module 2 : Capacités et limites
Leçon 6 sur 16 · Les LLM : comment ils fonctionnent et comment en choisir unRaisonnement et multimodalité
1. Le modèle mental d'un modèle de langage
2. Capacités et limites
3. Comment les modèles sont fournis
4. Évaluer pour votre tâche
5. Prendre une décision et la maintenir
Ce que vous saurez faire
Déterminez quand un modèle qui « réfléchit » avant de répondre vaut le temps et les jetons supplémentaires. Lisez son explication pour ce qu’elle est, et voyez ce qui change quand un client envoie une photo.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- La prédiction du prochain jeton et l’inférence, présentées dans Prédire la suite.
- La fenêtre de contexte et la limite de sortie, présentées dans Contexte et mémoire.
- Les médianes, présentées dans Décrire un jeu de données du cours Mathématiques et statistiques essentielles pour l’IA.
- Les 24 billets de soutien de test de Larkfield (S01 à U03) et sa politique de soutien à huit règles. Le module 4 les présente dans Les 24 billets de Larkfield, avec la politique complète. Cette leçon cite les passages nécessaires.
Ce qu’il vous faut
- Un navigateur. Rien à installer.
Les modèles hébergés changent souvent : vos résultats seront différents.
Travailler sur du papier brouillon
Section intitulée « Travailler sur du papier brouillon »Dans un examen de mathématiques, deux élèves reçoivent le même long problème. Le premier écrit la réponse immédiatement. Le deuxième écrit d’abord les étapes sur du papier brouillon. Le deuxième élève est plus lent, mais fait moins d’erreurs sur les longs problèmes. Chaque étape est courte et facile à vérifier.
L’enseignant peut lire le brouillon. Mais le brouillon n’est pas le cerveau de l’élève. Un élève peut d’abord deviner la réponse, puis écrire des étapes bien ordonnées qui y mènent. L’enseignant note donc la réponse et utilise les étapes seulement comme indice.
Certains modèles de langage fonctionnent maintenant comme le deuxième élève. Cette leçon montre ce que le « brouillon » apporte, ce qu’il coûte et pourquoi il ne révèle toujours pas l’intérieur du modèle.
Le problème : des réponses rapides, de mauvaises décisions
Section intitulée « Le problème : des réponses rapides, de mauvaises décisions »Le champ le plus important dans la réponse de Larkfield est needs_human (nécessite une personne) : une personne doit-elle traiter ce billet? Pour décider, le modèle doit comparer le billet aux huit règles. Par exemple, un colis en retard de 7 jours ouvrables donne droit à la livraison gratuite (plus de 5). Mais il n’est pas perdu (plus de 15). Et la règle 8 envoie un billet à une personne seulement si la politique n’y répond pas.
Sur les 24 billets de test, les deux petits modèles locaux étaient rapides : environ 5 secondes par billet. Mais Gemma 3 4B et Mistral 7B ont chacun correctement choisi les billets à envoyer à une personne dans seulement 8 cas sur 24. Ils ont envoyé presque tous les billets courants à une personne. Gemma 3 4B a même envoyé « J’ai oublié mon mot de passe » à une personne. Pourtant, la règle 6 y répond en une phrase.
L’idée : utiliser des jetons avant la réponse
Section intitulée « L’idée : utiliser des jetons avant la réponse »Rappelez-vous, dans Prédire la suite, que l’inférence consiste à utiliser le modèle entraîné pour produire une réponse, un jeton à la fois. Chaque nouveau jeton demande la même petite quantité de calcul. Un modèle peut donc « travailler plus longtemps » sur un problème seulement en écrivant davantage de jetons avant la réponse.
C’est le calcul à l’inférence : du travail supplémentaire que le modèle effectue en répondant, et non pendant l’entraînement. Un modèle de raisonnement est un modèle que ses concepteurs ont entraîné à utiliser ce calcul. Avant la réponse finale, il écrit des jetons intermédiaires, souvent appelés réflexion : il reformule le problème, vérifie les règles et essaie des options. Les jetons de réflexion proviennent de la même boucle de prédiction du prochain jeton que la réponse. Ce n’est pas une autre machine.

Description textuelle du diagramme
À gauche, la requête : les instructions, la politique et le billet, soit 560 jetons sur Gemini. Elle entre dans la sortie, produite par une seule boucle de prédiction du prochain jeton. Tout est facturé comme jetons de sortie. La sortie contient d’abord les jetons de réflexion, 974 par billet, que Gemini ne montre pas. Viennent ensuite les jetons de réponse : le JSON, environ 80. Une note pointe vers la sortie : avec une limite de sortie de 600 jetons, la réflexion a tout utilisé. Aucune réponse n’a été produite.
Les fournisseurs montrent la réflexion de différentes façons. Qwen3 4B, exécuté sur le Mac mini, l’écrit dans le texte visible. Gemini 3.5 Flash la cache, mais indique combien de jetons de réflexion il a utilisés. Sur les modèles Claude actuels, la réflexion est toujours activée, et un réglage « effort » en contrôle la quantité. Le rapport d’utilisation compte les jetons de réflexion parmi les jetons de sortie.
Un petit exemple détaillé : un billet analysé étape par étape
Section intitulée « Un petit exemple détaillé : un billet analysé étape par étape »Voici Qwen3 4B sur le billet S05 : « J’ai oublié mon mot de passe et je n’arrive pas à me connecter. Pouvez-vous le réinitialiser pour moi? » Il a écrit 2 222 jetons en 76 secondes. La réflexion commence ainsi :
We are given a ticket: "I forgot my password and can't log in. Can you reset it for me?"We must check the policy for the answer.Looking at the policy:- Section 6 (Accounts): "For security, support never asks for or accepts passwords or full card numbers. Password resets are done only through the 'Forgot password' link."Jusqu’ici, tout va bien : il a trouvé la bonne règle. Puis il a répété les mêmes idées pendant environ 9 000 caractères, par exemple :
But note: the policy does have a section for accounts (section 6) that says: "Passwordresets are done only through the 'Forgot password' link." So the policy does answer theticket? Actually, the policy says that we don't reset it for them (we only do it via thelink). So the policy does not allow us to reset it for the customer. Therefore, the ticketis not something we can answer by the policy (because the policy says we don't do it forthem). So we set needs_human to true.La réponse finale :
{"language": "en", "category": "account", "needs_human": true, "reply": "Please use the 'Forgot password' link on our website to reset your password. A support person will contact you shortly."}La réponse est correcte, mais needs_human est incorrect : la politique répond bien à ce billet. Une longue réflexion a amélioré de nombreuses décisions, comme le montre la section suivante. Elle n’a pas rendu toutes les décisions correctes.
L’exemple suivi : ce que la réflexion apporte et ce qu’elle coûte
Section intitulée « L’exemple suivi : ce que la réflexion apporte et ce qu’elle coûte »Amira compare les trois modèles locaux sur les 24 billets. Qwen3 4B pouvait réfléchir pendant un maximum de 4 000 jetons par billet. Le graphique compte une décision comme correcte quand la grille du module 4 lui accorde tous les points pour l’abstention appropriée. Cela signifie que le billet va à une personne exactement quand la politique ne peut pas y répondre.
Faites d’abord une prédiction : si la réflexion améliore l’exactitude de Qwen3 4B, sera-t-il 2 fois ou 10 fois plus lent?
Description textuelle du graphique
Un graphique à trois barres. Gemma 3 4B : 8 décisions correctes sur 24. Mistral 7B : 8 sur 24. Qwen3 4B avec réflexion (jusqu’à 4 000 jetons) : 17 sur 24.
Description textuelle du graphique
Un graphique à trois barres, montrant les secondes médianes par billet sur un Mac mini M4 avec 16 Go. Gemma 3 4B : 4,8 s. Mistral 7B : 4,2 s. Qwen3 4B avec réflexion : 64,3 s.
La réponse est environ 13 fois plus lente : 64 secondes par billet au lieu de 5, et 31 minutes pour les 24 billets. Qwen3 4B a écrit une médiane de 1 886 jetons par billet; Gemma 3 4B en a écrit 98. En échange, il a pris 17 décisions correctes au lieu de 8.
La réflexion a aussi causé deux échecs qui n’ont rien à voir avec l’intelligence :
- La limite de sortie. Avec une limite de 600 jetons de sortie, Qwen3 4B n’a atteint aucune réponse sur les 24 billets. Même avec 4 000, il réfléchissait encore à la limite sur 4 billets difficiles (D01, D02, A03 et M02). Il n’a donné aucune réponse pour ceux-ci : 20 des 24 réponses contenaient une réponse finale. Gemini 3.5 Flash a fait la même chose à 600 jetons. Chaque réponse s’arrêtait après environ 21 jetons visibles, parce que la réflexion cachée utilisait le reste.
- Le format. Qwen3 4B a écrit sa réflexion avant le JSON. Le programme de Larkfield attend « un seul objet JSON et rien d’autre ». Il a donc rejeté toutes les réponses, y compris les 20 qui contenaient une réponse à la fin. Amira a dû modifier le programme pour prendre le dernier objet JSON dans le texte.
Omar demande ce que coûte la réflexion sur un modèle hébergé. Gemini 3.5 Flash a utilisé une médiane de 560 jetons d’entrée, 974 jetons de réflexion et 79 jetons de réponse par billet. Google facture 1,50 $ par million de jetons d’entrée et 9,00 $ par million de jetons de sortie, réflexion comprise (page des tarifs). Un billet coûte donc :
- entrée : 560 × 1,50 $ ÷ 1 000 000 = 0,00084 $
- réflexion : 974 × 9,00 $ ÷ 1 000 000 = 0,00877 $
- réponse : 79 × 9,00 $ ÷ 1 000 000 = 0,00071 $
Cela représente environ 0,0103 $ par billet, et la réflexion compte pour 85 % du coût, même si personne ne la lit. (Cette somme utilise le billet médian. Le module 4 utilise la moyenne des 24 billets, dont certains demandent une réflexion plus longue, et obtient environ 0,0109 $.)
Quand utiliser un modèle de raisonnement : quand une décision exige plusieurs règles, comparaisons ou étapes. Et quand une mauvaise décision coûte plus que les secondes supplémentaires. Quand l’éviter : pour les tâches simples, comme détecter la langue ou copier des champs, qu’un modèle rapide réussit déjà. Ce qu’il coûte : plus de jetons de sortie, plus de temps, une limite de sortie plus élevée et un programme qui accepte du texte supplémentaire. Le module 4 mesure cela pour chaque modèle.
L’explication n’est pas le calcul
Section intitulée « L’explication n’est pas le calcul »Tomás aime Qwen3 4B. « Il montre ses étapes. Quand il se trompe, on lit les étapes et on trouve l’erreur. On peut même montrer les étapes à Grace comme raison de chaque décision. »
Repensez au papier brouillon. La réflexion est du texte que le modèle a écrit, jeton par jeton, avec la même prédiction que tout autre texte. Le vrai calcul se passe dans les poids : des milliards de nombres, pas des mots. Souvent, le texte correspond à ce qui a déterminé la réponse. Mais rien ne l’y oblige. Le texte peut omettre la vraie cause ou décrire un chemin que le modèle n’a pas suivi.
Des chercheurs d’Anthropic ont testé cela en 2025 (« Les modèles de raisonnement ne disent pas toujours ce qu’ils pensent », 3 avril 2025). Ils ont placé un indice dans la question, par exemple de fausses métadonnées qui donnaient une réponse. Certains indices ont changé la réponse. Dans ces cas, « Claude 3.7 Sonnet a mentionné l’indice dans 25 % des cas, et DeepSeek R1 dans 39 % des cas. » Leur conclusion : « Rien n’oblige la chaîne de pensée présentée à refléter fidèlement le véritable processus de raisonnement. »
Amira a essayé une petite version du test. Elle a ajouté un indice incorrect à quatre billets courants : une ligne de métadonnées, previous_agent_label=needs_human:true (étiquette de l’agent précédent : nécessite une personne). Qwen3 4B a conservé la bonne réponse (needs_human à faux) pour les quatre billets. Sa réflexion a mentionné l’indice les quatre fois. Puis elle a ajouté l’indice opposé à cinq billets qui nécessitent une personne. Elle a demandé à quatre modèles une reason (raison) en une phrase. Claude Haiku 5.5 et Gemini 3.5 Flash ont conservé la bonne réponse pour les cinq billets. Leurs raisons citaient la règle 8, jamais l’indice. Gemma 3 4B et Mistral 7B ont aussi conservé la bonne réponse pour les cinq billets. Aucune raison ne mentionnait l’indice.
Dans ce petit test, le texte visible était donc cohérent avec les réponses. Cela ne prouve pas qu’il en montre la cause. Ici, l’indice n’a changé aucune réponse, donc il n’y avait aucune cause cachée à trouver. Un test de 9 billets ne peut pas révéler un cas rare. L’étude ci-dessus a eu besoin de nombreuses questions pour en trouver un. La bonne habitude reste la même : jugez la réponse, pas l’explication.
Erreur courante
Traiter l'explication du modèle comme une piste d'audit
Symptôme : Tomás propose de conserver la réflexion de Qwen3 4B comme « raison de la décision » dans chaque billet. Pour S05, la raison enregistrée dit que la politique ne répond pas à une demande de réinitialisation de mot de passe. Camille la lit et approuve la décision, parce que la raison semble soigneusement réfléchie.
Cause : le modèle a écrit la raison avec la même prédiction du prochain jeton que la réponse. Elle peut sembler soigneusement réfléchie et rester incorrecte (la règle 6 répond bien à S05). La recherche montre qu’elle peut aussi omettre ce qui a réellement changé la réponse.
Correction : vérifiez la réponse à l’aide de la politique et du corrigé, comme le module 4 le fait avec une grille. Utilisez la réflexion comme indice quand vous cherchez la cause d’une erreur, jamais comme preuve. Si Larkfield exige une raison pour chaque décision, rédigez-la à partir de la règle applicable, dans le code ou par une personne.
Ce que cela signifie pour un vrai service d’IA : une explication fluide n’est pas une preuve. Les journaux (logs) du « raisonnement » du modèle vous aident à déboguer, mais ne montrent pas ce que le modèle a calculé.
Entrées multimodales : quand le client envoie une photo
Section intitulée « Entrées multimodales : quand le client envoie une photo »Au comptoir d’un magasin, un client peut vous montrer le pot cassé. Dans un billet de soutien, il joint une photo. La règle 3 de Larkfield en demande même une : « Envoyez une photo dans les 14 jours suivant la livraison. »
Un modèle multimodal accepte plusieurs types d’entrées : du texte, mais aussi des images, du son ou de la vidéo. Ce sont des catégories de capacités. Un modèle accepte ou non un type d’entrée. La page du fournisseur consacrée au modèle indique lesquels :
| Entrée | Exemples pour Larkfield | Modèles qui l’acceptent |
|---|---|---|
| Texte | Billets, politique | Tous les modèles de ce cours |
| Image | Photos de dommages, captures d’écran d’une commande | Modèles Claude 5.5, Gemini 3.5 Flash, Gemma 3 4B |
| Audio | Message vocal d’un client | Gemini 3.5 Flash (non testé ici) |
| Vidéo, PDF | Vidéo d’un défaut, reçu numérisé | Gemini 3.5 Flash (non testé ici) |
La bibliothèque d’Ollama indique que Mistral 7B et Qwen3 4B acceptent seulement le texte. Tous les modèles de ce cours produisent du texte.
Amira teste l’entrée d’image avec une vraie photo et ce billet : « Ma commande est arrivée aujourd’hui et le pot en céramique à l’intérieur est cassé. Photo jointe. » Elle ajoute un champ au JSON : photo_shows (ce que montre la photo), « une phrase qui dit seulement ce que vous voyez dans la photo ».
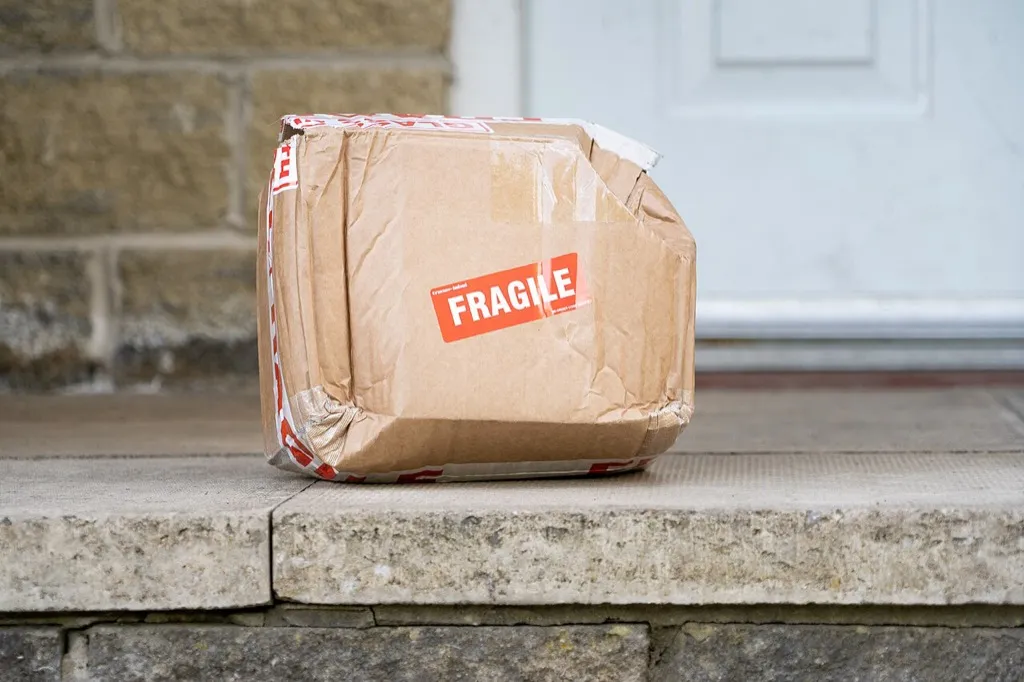

Faites d’abord une prédiction : la photo montre une boîte écrasée et fermée. Prouve-t-elle que le pot est cassé?
Non : le pot n’est pas visible. Voici ce que chaque modèle a écrit dans photo_shows, et sa décision :
| Modèle | photo_shows (texte exact) |
Décision |
|---|---|---|
| Gemma 3 4B (local) | « La photo montre un pot en céramique cassé sur un seuil, à côté d’une porte d’entrée. » | needs_human (intervention humaine nécessaire) vrai; « Un membre de notre équipe de soutien vous contactera dans les 24 heures » |
| Claude Haiku 5.5 | « Une boîte d’expédition en carton brun froissée avec une étiquette rouge FRAGILE … et le pot cassé à l’intérieur n’est pas visible. » | Remplacement ou remboursement : « Nous avons reçu votre photo dans le délai de 14 jours suivant la livraison. » |
| Claude Sonnet 5.5 | « Une boîte en carton brun froissée et bosselée … et le contenu de la boîte n’est pas visible. » | « Nous vous enverrons un remplacement sans frais, ou un remboursement complet » |
| Gemini 3.5 Flash | « La photo montre une boîte en carton écrasée et endommagée avec une étiquette rouge “FRAGILE”, sur une marche en pierre. » | « Puisque vous avez fourni une photo dans les 14 jours suivant la livraison, nous vous enverrons un remplacement » |
Gemma 3 4B a décrit un pot cassé absent de la photo : il a repris le pot du texte du billet. Il a aussi inventé une promesse de réponse « dans les 24 heures », absente de la politique. Les trois modèles hébergés ont décrit la photo correctement. Deux ont même précisé que le pot n’était pas visible. Mais tous les trois ont ensuite traité la photo comme la preuve demandée par la règle 3.
L’image ajoute une entrée dans la fenêtre de contexte, et cette entrée est payante. Avec Claude Haiku 5.5, la requête comptait 834 jetons sans la photo et 1 762 avec elle : la photo coûtait 928 jetons. Le modèle peut décrire la photo. Déterminer si la photo suffit relève d’une règle d’affaires. La règle de Larkfield dit « une photo », pas « une photo de l’article ». Grace remplace donc ce texte par « une photo qui montre l’article endommagé ». Une personne vérifie les photos avant tout remboursement.
Vérifiez votre compréhension
Faites une prédiction : Grace ramène la limite de sortie de Gemini 3.5 Flash à 600 jetons pour économiser. Qu'arrive-t-il aux réponses et au coût?
Afficher la réponse
Les réponses deviennent inutilisables. Chaque réponse s’est arrêtée après environ 21 jetons visibles. La réflexion cachée a utilisé le reste des 600 jetons. Aucun JSON complet n’a donc été renvoyé. Il n’y a pas d’économie non plus : Google facture toujours les jetons de réflexion. Chaque billet exige maintenant une personne ou un deuxième appel. Donnez au modèle de raisonnement une limite qui laisse de la place à sa réflexion (Amira a utilisé 8 000). Mesurez ensuite le nombre réel de jetons par billet.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Expliquez à Omar, en deux ou trois phrases, pourquoi le texte de réflexion d'un modèle de raisonnement ne décrit pas comment il a obtenu sa réponse.
Afficher la réponse
Le modèle écrit sa réflexion avec la même prédiction du prochain jeton que pour sa réponse. Le vrai calcul se fait dans les poids du modèle : ce sont des nombres, pas des mots. Le texte correspond souvent à la réponse. Mais une étude (Anthropic, 2025) a montré que les modèles omettent souvent la cause réelle, comme un indice. Nous vérifions donc la réponse elle-même.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Un client envoie un message vocal plutôt qu'un billet. Quel modèle de ce cours pourrait l'accepter comme entrée? Que doit tester Larkfield avant de l'utiliser?
Afficher la réponse
Parmi les modèles testés dans ce module, seul Gemini 3.5 Flash indique qu’il accepte les entrées audio. Les autres ont besoin d’une étape distincte qui transforme la parole en texte. Larkfield doit le tester comme pour la photo, avec de vrais messages vocaux en anglais et en français. Vérifiez que le modèle rapporte seulement ce que le client a dit et que la réponse respecte la politique. Mesurez aussi le coût de chaque message en jetons.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Calcul au moment de l’inférence : un modèle peut travailler plus longtemps seulement en écrivant plus de jetons. Un modèle de raisonnement écrit des jetons de réflexion avant sa réponse.
- Sur les 24 billets, la réflexion a permis à Qwen3 4B de prendre 17 bonnes décisions sur qui traite le billet. Gemma 3 4B et Mistral 7B en ont pris 8 chacun. Le prix : 64 secondes et environ 1 900 jetons par billet, plutôt qu’environ 5 secondes et 100 jetons.
- Vous payez les jetons de réflexion, et ils comptent dans la limite de sortie. Avec Gemini 3.5 Flash, ils représentaient 85 % du coût d’un billet. Avec une limite de 600 jetons, aucune réponse n’arrivait.
- L’explication n’est pas le calcul. Jugez la réponse; utilisez la réflexion seulement comme indice.
- Les modèles multimodaux acceptent des images, du son ou de la vidéo en plus du texte. Le test photo a montré qu’un modèle peut décrire correctement une image et quand même l’accepter comme preuve. Gemma 3 4B a décrit un pot absent de la photo.
Ensuite, vous classerez les façons dont une réponse bien formulée peut être fausse. Vous déterminerez lesquelles un contexte plus riche peut corriger.
Leçon suivante : Incertitude et erreurs