
Pannes des fournisseurs et des dépendances
- Leçon 18
- 55 min
- Module 6 : Gérer les incidents et la passation
Où nous en sommes
Dans la leçon précédente, nous avons écrit un guide d'exploitation pour chaque alerte. L'un d'eux couvre une défaillance que nous ne pouvons pas corriger nous-mêmes : le fournisseur d'IA ne répond plus. Dans cette leçon, nous suivons le guide du fournisseur pendant une panne : nous conservons chaque billet, nous disons la vérité aux clients, nous confions à une personne ce qui ne peut pas attendre et nous prouvons avec des chiffres que la panne est terminée. Nous commençons par un bureau de poste un jour de grève.
Leçon 18 sur 19 · MLOps et LLMOps : exploiter l'IA en productionPannes des fournisseurs et des dépendances
1. Définir la responsabilité opérationnelle
2. Versionner et reproduire le système
3. Instrumenter une télémétrie utile
4. Surveiller les changements de comportement
5. Mettre en production et améliorer en toute sécurité
6. Gérer les incidents et la passation
Ce que vous saurez faire
Décidez à l’avance ce que fait le service quand son fournisseur d’IA tombe en panne. Conservez les billets et dites honnêtement que les réponses sont en retard. Confiez à une personne ce qui ne peut pas attendre. Prouvez avec des chiffres que la panne est terminée.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les guides d’exploitation et
python -m ops alerts, vus dans Guides d’exploitation. - La file de tâches, les nouvelles tentatives et les tâches en échec définitif, vues dans Livraison et nouvelles tentatives. Le disjoncteur, vu dans Contenir les défaillances.
- Le SLO des brouillons (un brouillon valide en 10 minutes), vu dans Objectifs de service.
Ce qu’il vous faut sur votre ordinateur
- Votre projet après la dernière leçon :
python -m pytestaffiche218 passed. - Docker qui exécute PostgreSQL et Valkey, puis le simulateur, l’API et le processus dans trois terminaux. Suivez Faire tourner le service en production. Un quatrième terminal pour les commandes.
Les étapes en direct prennent environ 12 minutes. L’exécution de panne enregistrée ne nécessite pas Docker.
Le bureau de poste un jour de grève
Section intitulée « Le bureau de poste un jour de grève »Le centre de tri de la ville s’arrête pendant une journée. Un bon bureau de poste ne ferme pas ses portes. Les boîtes aux lettres restent ouvertes, et on conserve chaque lettre. Une affiche au comptoir indique : « Les livraisons sont en retard aujourd’hui. Votre lettre est en sécurité. Vous n’avez pas besoin de la renvoyer. » On remet en main propre à un coursier une lettre portant la mention urgent : médicaments. Le lendemain matin, on expédie d’abord le courrier accumulé, du plus ancien au plus récent. Le responsable vérifie que les boîtes aux lettres sont vides avant de dire « le service a repris ».
Cette histoire contient quatre plans. Ce qui fonctionne encore : les boîtes aux lettres. Ce qui attend : les lettres. Ce qu’on dit aux clients : l’affiche. Comment savoir que c’est terminé : les boîtes aux lettres vides.
Le problème : le service dépend de quelqu’un d’autre
Section intitulée « Le problème : le service dépend de quelqu’un d’autre »Le service de Larkfield ne peut pas trier un billet sans le fournisseur d’IA. Le fournisseur est une dépendance : un service dont le vôtre a besoin, mais que vous n’exploitez pas. La base de données et le cache sont aussi des dépendances, mais Mei et Amira les exploitent. Une autre entreprise exploite le fournisseur, et ses pannes surviennent indépendamment des vôtres.
Dans cette leçon, vous lisez l’exécution de panne, un incident d’exercice provoqué volontairement sur la pile réelle. Les clients envoyaient 1 billet par seconde. À +5,1 minutes d’exercice, le fournisseur simulé a commencé à faire échouer chaque appel. Il est revenu à +10,1 minutes.
Sans plan, une panne du fournisseur tourne mal de quatre façons :
- Les nouvelles tentatives aggravent la situation. Chaque processus envoie chaque billet jusqu’à 5 fois. Les 300 billets en attente deviennent 1 500 appels à un fournisseur qui ne peut pas répondre.
- Des billets se perdent. Après sa dernière tentative, une tâche devient une tâche en échec définitif. Elle attend une personne qui ignore son existence.
- Les clients doivent deviner. Le site Web dit encore « merci », mais rien n’arrive. Certains clients renvoient le billet, ce qui fait grossir la file plus vite.
- Personne ne sait quand c’est terminé. Le fournisseur est revenu, mais a-t-on traité tout le travail accumulé? Certains billets sont-ils bloqués?
L’idée : planifier la panne avant qu’elle survienne
Section intitulée « L’idée : planifier la panne avant qu’elle survienne »Vous ne pouvez pas empêcher la panne d’une autre entreprise. Vous pouvez décider, à l’avance et dans le code, comment votre service se comporte pendant cette panne. Quatre éléments :
- Modes de repli. Un repli est ce que fait le service au lieu de suivre le parcours normal. Pour les billets de Larkfield : le billet attend le fournisseur dans la file. Un billet qui n’obtient aucune réponse valide va à une personne.
- Travail en file. Acceptez chaque billet, conservez-le et réessayez plus tard sans consommer ses tentatives. Le cours sur la mise à l’échelle a construit ce mécanisme : le disjoncteur.
- État pour les utilisateurs. Dites automatiquement la vérité aux clients : ce qui fonctionne, ce qui est en retard et ce qu’ils doivent faire.
- Vérification de la reprise. « Le service est revenu » est une affirmation. Les chiffres sur les billets en sont la preuve.

Description textuelle du diagramme
L’API enregistre d’abord chaque billet et répond immédiatement 202. Ainsi, une panne ne provoque jamais le refus d’un billet. Le processus consulte le disjoncteur avant chaque appel. Tant que le disjoncteur est ouvert, la tâche retourne dans la file sans utiliser de tentative. Quand le fournisseur répond, mais que sa réponse n’est pas valide, le billet va à une personne. Quand le billet le plus ancien attend depuis plus de 120 secondes, le point de terminaison d’état avertit le site Web. Celui-ci affiche alors le message de retard.
Quel repli choisir?
Section intitulée « Quel repli choisir? »Un service d’IA a plus de choix de repli qu’un service classique. Kwame énumère ceux de Larkfield :
| Repli | Ce qu’il fait | Ce qu’il coûte |
|---|---|---|
| Attendre dans la file | le billet est trié quand le fournisseur revient | le délai; la file doit avoir de la place |
| Envoyer à une personne | un agent trie le billet à la main | le temps des agents; plus lent pour le client |
| Un deuxième fournisseur ou un modèle plus petit | un autre modèle trie le billet | un comportement différent qui nécessite sa propre évaluation, sa mise en production et son contrat |
| Une réponse fixe | « Nous avons reçu votre billet », sans triage | rien d’utile pour le service de soutien |
Larkfield utilise les deux premiers. Un deuxième fournisseur semble sûr, mais c’est une nouvelle mise en production qu’aucune barrière n’a testée. Y passer en pleine panne répète l’erreur de la semaine dernière.
Un petit exemple : combien de temps la panne peut-elle durer?
Section intitulée « Un petit exemple : combien de temps la panne peut-elle durer? »Le SLO des brouillons exige un brouillon valide en 10 minutes (600 secondes). Combien de temps le fournisseur peut-il rester indisponible avant que les billets dépassent cette limite? Prenez les chiffres de l’exécution de panne :
| Étape | Valeur | Source |
|---|---|---|
| Billets qui arrivent | 1 par seconde | le scénario |
| La panne | 300 s (+5,1 à +10,1) | le scénario |
| Billets en attente à la fin de la panne | environ 300 | 1 × 300 |
| Temps entre le retour du fournisseur et le brouillon du billet le plus ancien | environ 54 s | le prochain appel de test du disjoncteur, puis le billet le plus ancien en premier |
| Attente du billet le plus ancien | 300 + 54 = 354 s | mesure : 354,1 s |
| Marge restante sous le SLO | 600 − 354 = 246 s |
Le premier billet de la panne attend le plus longtemps : toute la panne, plus le temps nécessaire au redémarrage. Dans cette configuration, une panne d’environ 600 − 54 = 546 secondes dépasserait donc le SLO des brouillons pour les premiers billets. Cela représente environ 9 minutes. À ce rythme, chaque minute supplémentaire ajoute 60 billets qui dépassent le SLO. C’est une estimation tirée d’une seule exécution : le temps de redémarrage dépend du disjoncteur et du nombre de processus.
La file a aussi une limite. Les exécutions d’exercice utilisent QUEUE_MAX=5000. À 1 billet par seconde, cela représente 83 minutes de panne avant que l’API doive refuser des billets. Au rythme réel de Larkfield, soit 822 billets par jour, c’est environ 6 jours.
Larkfield : ce que le service fait déjà et ce que ce module ajoute
Section intitulée « Larkfield : ce que le service fait déjà et ce que ce module ajoute »Le cours sur la mise à l’échelle a déjà doté le service du travail en file. L’API enregistre chaque billet et répond 202 avant tout appel au modèle. Le disjoncteur du processus s’ouvre après 5 appels échoués de suite. Tant qu’il est ouvert, le processus ne fait aucun appel. Il remet chaque tâche dans la file, sans consommer l’une de ses 5 tentatives. Toutes les 30 secondes, le disjoncteur laisse passer un appel de test (semi-ouvert). Si l’appel réussit, le disjoncteur se ferme.
Ce module ajoute deux choses.
État pour les clients. GET /v1/status n’exige aucune clé d’API, donc le site Web peut l’appeler. Il lit la file et renvoie le texte de Grace. Extrait de ticket_api/job_routes.py :
DELAYED_AFTER_SECONDS = 120  # the "drafts-late" alert's threshold
def status_message(stats: dict) -> ServiceStatus:    """Grace's wording: say what works, what is late, and what the customer should do."""    oldest = stats["oldest_queued_seconds"]    pace = stats["succeeded_last_minute"] / 60    wait = round(stats["queued"] / pace, 1) if pace > 0 else None    if oldest <= DELAYED_AFTER_SECONDS:        return ServiceStatus(status="ok", message="We answer new tickets as usual.", ...)    minutes = "a few" if wait is None else str(max(1, round(wait / 60)))    return ServiceStatus(        status="delayed",        message=(            "Your ticket is saved, and nothing is lost. Our replies take longer than usual "            f"(about {minutes} minutes). You do not need to send your ticket again. If something "            "is unsafe, stop using the product and call us."        ), ...
Le message répond aux trois questions du client : mon billet est-il perdu, combien de temps faudra-t-il attendre et que dois-je faire? La dernière phrase concerne les billets liés à la sécurité, qui ne doivent pas attendre un fournisseur. L’état utilise les mêmes 120 secondes que l’alerte drafts-late (brouillons en retard). Les clients et la personne de garde voient donc « en retard » au même moment.
Le repli vers une personne. TRIAGE_FALLBACK=person change ce que le processus fait d’un billet qui n’obtient aucune réponse valide. Avant, la tâche échouait : le billet restait dans l’équipe par défaut, et personne n’était averti. Maintenant, le processus enregistre needs_human (besoin d’une personne) à vrai et la priorité à 1. Le billet entre donc dans la première file des agents. La tâche se termine avec le résultat sent_to_person (envoyé à une personne). Cette action vient de l’analyse post-incident de la prochaine leçon. Pendant une panne, elle ne s’applique pas : le disjoncteur rend la tâche avant toute réponse. Le billet attend donc le fournisseur.
Faites tomber le fournisseur de votre propre service en panne
Section intitulée « Faites tomber le fournisseur de votre propre service en panne »Utilisez vos quatre terminaux. Le simulateur, l’API et le processus fonctionnent comme dans Faire tourner le service en production. Les étapes envoient 1 billet toutes les 2 secondes, plutôt que 1 par seconde dans l’exécution enregistrée. Le fournisseur simulé a un quota, comme le vrai fournisseur : 100 000 jetons par minute, soit environ 45 billets. Les exécutions enregistrées désactivaient le quota et utilisaient deux processus. Sur Windows, tapez curl.exe au lieu de curl, et mettez chaque commande sur une seule ligne.
-
Demandez l’état, comme le fait le site Web :
Fenêtre de terminal curl http://127.0.0.1:8000/v1/status{"status":"ok","message":"We answer new tickets as usual.","queued":0,"oldest_waiting_seconds":0.0,"estimated_wait_seconds":null} -
Faites échouer chaque appel du fournisseur simulé. C’est une panne d’exercice, provoquée volontairement :
Fenêtre de terminal curl -X POST http://127.0.0.1:8300/admin/mode -H "Content-Type: application/json" -d '{"mode": "outage"}'{"mode":"outage"} -
Envoyez 90 billets d’exercice, 1 toutes les 2 secondes. Cela prend 3 minutes; laissez la commande s’exécuter :
Fenêtre de terminal python -m scripts.practice --tickets 90 --rate 0.5 --seed 7Sent 90 practice tickets in 178.0 s: 202: 90Chaque billet a été accepté (202), même si aucun billet ne pouvait être trié.
-
Dans le quatrième terminal, lisez la file et l’état toutes les 30 secondes :
Fenêtre de terminal curl http://127.0.0.1:8000/v1/queuecurl http://127.0.0.1:8000/v1/statusAprès 90 secondes, la file grossit et l’état indique encore ok :
{"queued":46,"ready":0,"running":0,"dead_letter":0,"failed":0,"succeeded_last_minute":0,"oldest_queued_seconds":90.0}{"status":"ok","message":"We answer new tickets as usual.","queued":46,"oldest_waiting_seconds":90.0,"estimated_wait_seconds":null}Après 120 secondes, le billet le plus ancien dépasse 120 secondes d’attente, et l’état change :
{"queued":61,"ready":1,"running":0,"dead_letter":0,"failed":0,"succeeded_last_minute":0,"oldest_queued_seconds":120.1}{"status":"delayed","message":"Your ticket is saved, and nothing is lost. Our replies take longer than usual (about a few minutes). You do not need to send your ticket again. If something is unsafe, stop using the product and call us.","queued":61,"oldest_waiting_seconds":120.1,"estimated_wait_seconds":null}Rien ne s’est terminé dans la dernière minute. Le service ne peut donc pas estimer l’attente et indique « quelques minutes ». Il ne devine pas un chiffre.
"dead_letter":0(aucune tâche en échec définitif) : aucun billet n’est perdu. -
Quand le script d’exercice est terminé, rétablissez le fournisseur :
Fenêtre de terminal curl -X POST http://127.0.0.1:8300/admin/mode -H "Content-Type: application/json" -d '{"mode": "normal"}' -
Lisez la file et l’état environ toutes les 20 secondes. Après 40 secondes :
{"queued":51,"ready":51,"running":4,"dead_letter":0,"failed":0,"succeeded_last_minute":35,"oldest_queued_seconds":218.4}{"status":"delayed","message":"Your ticket is saved, and nothing is lost. Our replies take longer than usual (about 1 minutes). You do not need to send your ticket again. If something is unsafe, stop using the product and call us.","queued":51,"oldest_waiting_seconds":218.4,"estimated_wait_seconds":87.4}Les processus terminent maintenant des billets à nouveau, donc l’état peut estimer l’attente. Avec 51 billets à 35 par minute, cela donne environ 87 secondes. (« 1 minutes » est une petite erreur grammaticale dans le code du message.) Après 140 secondes :
{"queued":0,"ready":0,"running":0,"dead_letter":0,"failed":0,"succeeded_last_minute":16,"oldest_queued_seconds":0.0}{"status":"ok","message":"We answer new tickets as usual.","queued":0,"oldest_waiting_seconds":0.0,"estimated_wait_seconds":0.0} -
Il faut de nouveaux billets pour prouver la reprise. Envoyez-en 60 autres, comme trafic normal :
Fenêtre de terminal python -m scripts.practice --tickets 60 --rate 0.5 --seed 3 -
Quand la file est vide, arrêtez l’API et le processus avec Ctrl+C. La dernière ligne du processus compte ses actions :
Done in 481.6 s: 896 taken, 170 succeeded, 60 waiting for the quota, 10 to retry later, 0 failed, 0 dead letters, 656 given back to the queue.170 billets ont réussi et 0 ont échoué. « 656 remis dans la file » montre le disjoncteur ouvert au travail : aucun n’a consommé de tentative. « 60 en attente du quota » s’est produit après la panne : le travail accumulé a atteint le quota du fournisseur. Vos comptes peuvent différer.
-
Lisez l’incident à partir de votre propre télémétrie, une ligne par minute :
Fenêtre de terminal python -m ops incident telemetry/ticket-api.jsonl telemetry/ticket-worker.jsonl --minute 1Timeline (what happened, in order):when kind event-------- ------- ------------------------------+0.5 min breaker circuit open+1.0 min breaker circuit half_open+1.0 min breaker circuit open+1.0 min alert provider-circuit-open fired+1.5 min breaker circuit half_open+1.5 min breaker circuit open+2.0 min breaker circuit half_open+2.0 min breaker circuit open+2.5 min breaker circuit half_open+2.5 min breaker circuit open+3.0 min breaker circuit half_open+3.0 min breaker circuit open+3.5 min breaker circuit half_open+3.5 min alert drafts-late fired+3.5 min alert provider-circuit-open resolved+3.5 min breaker circuit closed+5.7 min alert drafts-late resolvedPer period (minutes):minutes received refused (5xx) finished no valid draft oldest waiting (s) time to draft p95 (s)------- -------- ------------- -------- -------------- ------------------ ---------------------0-1 38 0 20 0 35 12.61-2 30 0 0 0 95 -2-3 30 0 0 0 155 -3-4 12 0 31 0 213 200.54-5 0 0 52 0 161 225.15-6 8 0 12 0 6 178.66-7 30 0 32 0 0 7.37-8 22 0 23 0 0 5.2Recovery checks (the last full period against the first):[x] tickets are accepted: 0 refused[x] drafts are valid: 0 without a valid draft (first period 0)[x] nothing is waiting long: oldest waiting 0 s[x] drafts are on time: p95 7.3 s (first period 12.6 s)Votre télémétrie ne contient aucune action d’exercice, donc la chronologie commence avec le disjoncteur. Les minutes se comptent à partir de votre premier enregistrement.
Lisez les périodes comme une histoire. Pendant les minutes 1 à 3, des billets arrivaient, mais rien ne se terminait. À partir de la minute 3, le travail accumulé a été terminé en environ 2,5 minutes. Les minutes 6 et 7 contiennent les nouveaux billets, terminés en quelques secondes chacun. Ces dernières lignes sont la preuve : le service est revenu pour les nouveaux clients, pas seulement pour le travail accumulé.
Lors de notre premier essai de ces étapes, nous avons envoyé 1 billet par seconde après la reprise. La dernière vérification est restée vide : [ ] drafts are on time: p95 105.2 s (brouillons à temps : p95 de 105,2 s). La file était vide et l’état indiquait ok, mais les nouveaux billets attendaient. Un billet par seconde dépasse ce que le quota permet. La vérification de reprise a détecté ce que l’état n’avait pas détecté.
Lire l’exécution de panne
Section intitulée « Lire l’exécution de panne »L’exécution de panne enregistrée reprend le même exercice, plus long et sur la pile complète avec Grafana. ops incident place tout sur une seule chronologie, puis compte les billets par période :
python -m ops incident data/telemetry/outage.jsonl.gzTimeline (what happened, in order):when kind event--------- -------- ----------------------------------------------------------------+0.0 min release release: active 1.5.0-4fafd1+0.1 min practice scenario start+0.1 min practice ops rollout start 1.5.0-4fafd1 --reason practice scenario outage+0.1 min practice simulator mode: normal+0.1 min grafana alert firing: cost-over-budget+0.1 min grafana alert firing: reviews-disagree+3.3 min grafana alert resolved: cost-over-budget+5.1 min practice simulator mode: outage+5.1 min breaker circuit open+5.2 min breaker circuit closed+5.3 min breaker circuit open+5.7 min alert provider-circuit-open fired+5.8 min breaker circuit half_open+5.8 min breaker circuit open+5.9 min grafana alert firing: provider-circuit-open+6.3 min breaker circuit half_open+6.3 min breaker circuit open+6.8 min breaker circuit half_open+6.8 min breaker circuit open+7.3 min breaker circuit half_open+7.3 min breaker circuit open+7.8 min breaker circuit half_open+7.8 min breaker circuit open+8.2 min alert drafts-late fired+8.3 min breaker circuit half_open+8.3 min breaker circuit open+8.4 min grafana alert firing: drafts-late+8.8 min breaker circuit half_open+8.8 min breaker circuit open+9.3 min breaker circuit half_open+9.3 min breaker circuit open+9.8 min breaker circuit half_open+9.8 min breaker circuit open+10.1 min practice simulator mode: normal+10.3 min breaker circuit half_open+10.3 min alert provider-circuit-open resolved+10.4 min breaker circuit closed+10.6 min grafana alert resolved: provider-circuit-open+11.5 min alert drafts-late resolved+11.7 min grafana alert resolved: drafts-late+22.1 min practice scenario end
Per period (minutes):minutes received refused (5xx) finished no valid draft oldest waiting (s) time to draft p95 (s)------- -------- ------------- -------- -------------- ------------------ ---------------------0-2 116 0 124 0 3 38.02-4 120 0 121 0 2 5.44-6 120 0 67 0 55 6.16-8 120 0 0 0 175 -8-10 120 0 0 0 295 -10-12 120 0 413 0 2 325.312-14 120 0 117 0 5 5.114-16 120 0 121 0 4 5.116-18 120 0 120 0 4 5.118-20 120 0 122 0 2 5.220-22 4 0 7 0 0 5.022-24 0 0 0 0 0 -
Recovery checks (the last full period against the first): [x] tickets are accepted: 0 refused [x] drafts are valid: 0 without a valid draft (first period 0) [x] nothing is waiting long: oldest waiting 0 s [x] drafts are on time: p95 5.0 s (first period 38.0 s)Lisez-la depuis le haut. Les lignes de type grafana sont les alertes de Grafana lui-même. Les lignes de type alert (alerte) sont les règles appliquées à la télémétrie enregistrée. Les deux alertes grafana à +0,1 minutes viennent de l’exécution précédente, encore présente dans les fenêtres de Grafana. Ignorez-les ici.
- +5,1 : le fournisseur tombe en panne. Le disjoncteur s’ouvre immédiatement. Chacun des deux processus a son propre disjoncteur et signale ses propres changements. Vous voyez donc encore
closed(fermé) à +5,2, puisopen(ouvert) à nouveau. - Toutes les 0,5 minutes :
half_open(semi-ouvert), puisopen. C’est l’appel de test du disjoncteur, qui échoue. Chaque test est un seul appel, pas une avalanche de nouvelles tentatives. - +5,7 et +8,2 : les deux alertes du guide d’exploitation du fournisseur. La détection a pris 0,6 et 3,1 minutes; celle de Grafana a pris 0,85 et 3,28 minutes.
- +10,1 : le fournisseur est revenu. Le prochain appel de test réussit, et le disjoncteur se ferme à +10,4.
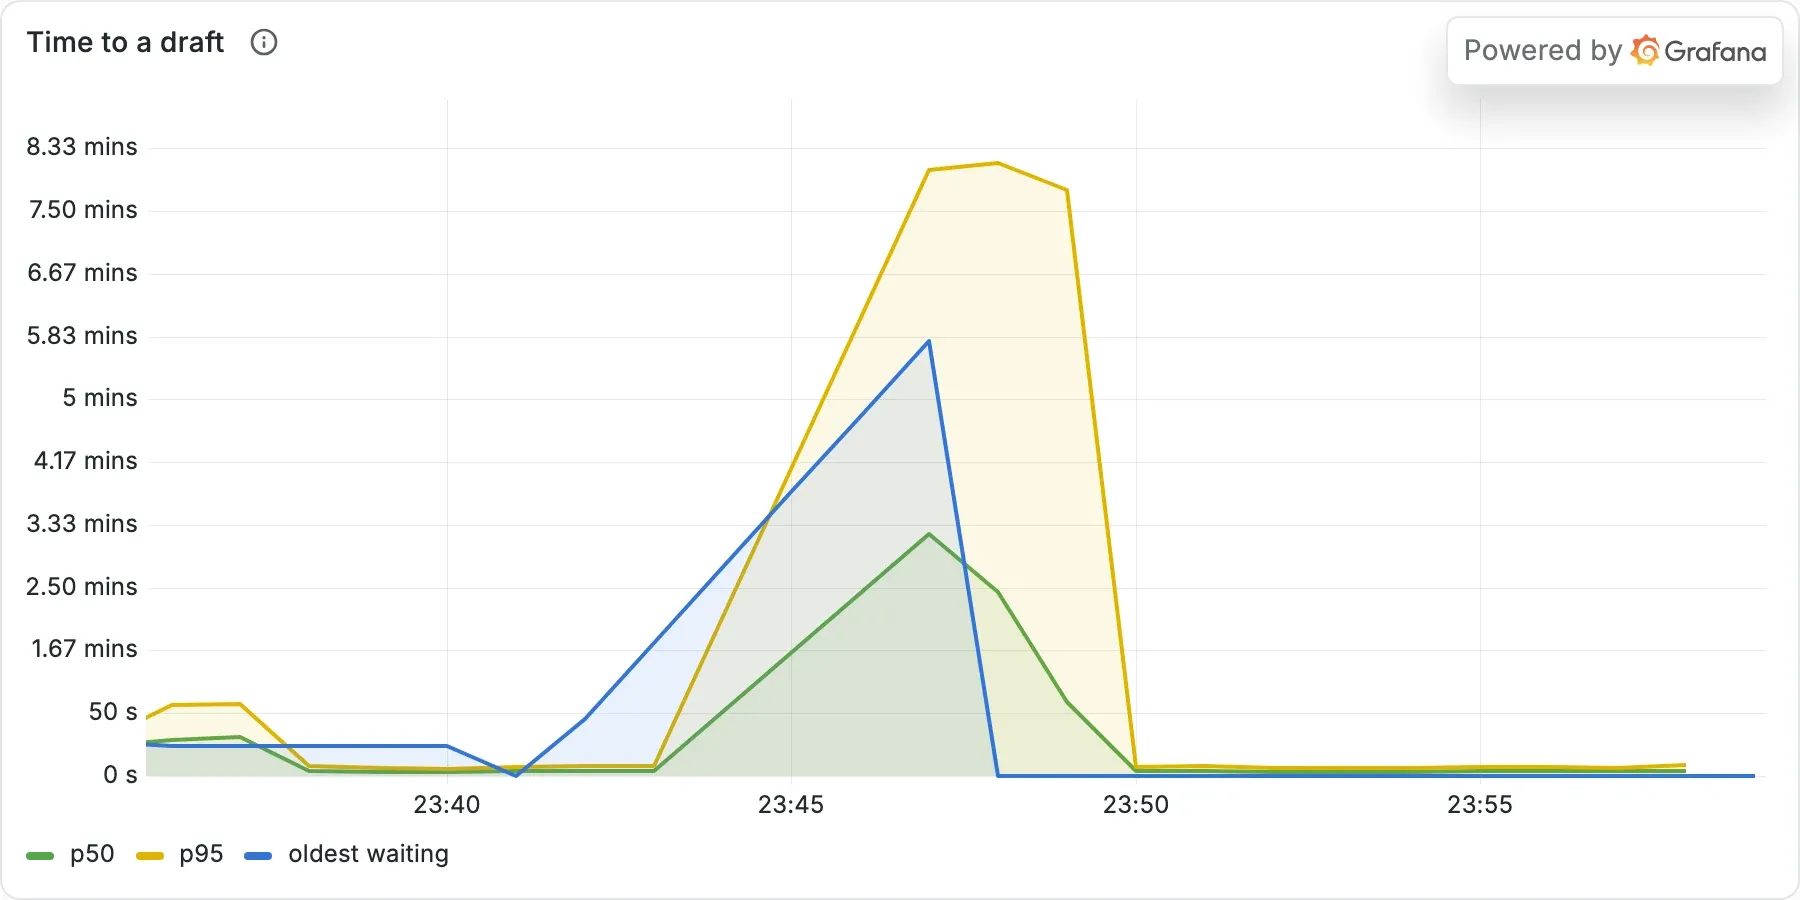
- Les périodes : aucun billet n’a été refusé, à aucun moment. De +6 à +10 minutes, rien ne s’est terminé, et l’attente du billet le plus ancien a atteint 295 secondes. Entre +10 et +12 minutes, les deux processus ont terminé 413 billets : le travail accumulé plus les nouveaux billets.
Le disjoncteur a remis les tâches dans la file 3 102 fois, et le processus a réessayé 36 fois. Aucune tâche n’a donc épuisé ses tentatives : 0 tâche en échec définitif. Le SLI des brouillons est resté à 100 % pendant l’exécution. Le billet le plus ancien a attendu 354 secondes, sous les 600 secondes du SLO.
- Billets en attente d'un brouillon
- Billet en attente le plus ancien (secondes)
Description textuelle du graphique
L’axe des x montre les 22 minutes d’exercice. Avant la panne, environ 3 billets attendent à tout moment, et le plus ancien attend depuis 2 à 3 secondes. À partir de la minute 5,1, les deux courbes augmentent d’environ 30 chaque demi-minute. Il y a 30 billets de plus en attente, et le plus ancien a 30 secondes de plus. À la minute 10, 296 billets attendent, et le plus ancien attend depuis 295 secondes. Le fournisseur revient à 10,1. À la minute 11, 170 billets attendent encore, mais le plus ancien a atteint 355 secondes. À la minute 12, les deux courbes sont revenues à 3 billets et 2 secondes.
Les deux courbes racontent des histoires différentes. Le nombre de billets en attente baisse dès que les processus redémarrent. L’attente la plus ancienne continue d’augmenter pendant une minute supplémentaire. Le billet le plus ancien n’est pas toujours terminé en premier. Le SLO concerne l’attente la plus ancienne, pas la longueur de la file.
Grafana montre la même forme. Ce panneau contient trois séries, et ses couleurs peuvent différer sur votre écran :
Vérifier le rétablissement
Section intitulée « Vérifier le rétablissement »Les vérifications de rétablissement du guide d’exploitation du fournisseur, avec les preuves de l’essai :

Description textuelle du diagramme
La panne commence à +5,1 minutes, et le disjoncteur s’ouvre aussitôt. Les règles appliquées à la télémétrie enregistrée déclenchent provider-circuit-open à +5,7 et drafts-late à +8,2; Grafana les déclenche à +5,9 et +8,4. Le fournisseur répond de nouveau à +10,1, le disjoncteur se ferme à +10,4, et drafts-late est résolue à +11,5. La liste de vérification comporte six cases. Aucun billet n’a été refusé sur 1 200. L’attente du billet le plus ancien revient à 0 seconde, après un maximum de 354. Aucun billet n’est sans brouillon valide, et les brouillons arrivent à temps, avec un p95 de 5,0 secondes. Il y a 0 tâche en échec définitif. Le disjoncteur est fermé, et l’état indique ok.
Pourquoi autant de cases? Parce que chaque élément peut échouer indépendamment :
- Le disjoncteur s’est fermé, mais la file est encore pleine : les clients attendent toujours.
- La file s’est vidée, mais certaines tâches sont en échec définitif : ces clients ne reçoivent jamais de réponse. Vérifiez
dead_letter(tâches en échec définitif) dansGET /v1/queue, et relancez chacune (POST /v1/jobs/{id}/retry). - Les brouillons sont valides, mais en retard : les processus ne suivent pas le rythme.
- L’état indique ok, mais les brouillons sont invalides : le fournisseur est revenu avec un autre modèle, ou une erreur.
Le guide d’exploitation du fournisseur (operations/runbooks/provider-outage.md) contient ces cases. Cochez chacune avec un nombre tiré de ops incident ou de l’API. L’incident est alors terminé.
Quand prévoir une panne, et combien cela coûte
Section intitulée « Quand prévoir une panne, et combien cela coûte »Tomás demande : « Le fournisseur promet 99,9 %. Pourquoi prévoir quelque chose qui arrive si rarement? »
Kwame répond : « 99,9 % permet quand même environ 43 minutes par mois. Et leur 99,9 % ne compte pas les réponses lentes, les mauvaises réponses ou un changement de modèle. »
Prévoyez une panne dès qu’une autre organisation exploite une dépendance et que vos utilisateurs l’attendent. Une file, un disjoncteur et un message d’état coûtent peu, et Larkfield avait déjà les deux premiers. N’ajoutez pas un deuxième fournisseur au cas où : cela double le travail d’évaluation, de mise en production et de contrat. Ses réponses diffèrent aussi. Ajoutez-en un seulement si le coût d’une panne dépasse celui de ce travail. Testez-le avec la barrière comme toute mise en production.
Ce que cela coûte :
- Le temps des agents. Pendant une panne, l’équipe de Grace lit manuellement les billets en file pour repérer les mots liés à la sécurité. Avec la solution de repli, chaque billet sans réponse valide passe à une personne. Cela représente environ 10 % des billets avec une mauvaise requête.
- Un état honnête. Les clients voient « en retard » plus souvent qu’avec une page qui indique toujours « ok ». C’est le but : cela les empêche d’envoyer leurs billets deux fois.
- De l’espace dans la file. La file doit contenir tout ce qui arrive pendant la panne. Dimensionnez-la à partir du taux d’arrivée, comme dans le petit exemple.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Le processus et l'API ne démarrent pas : TRIAGE_FALLBACK
Symptôme : après la modification de .env, le processus s’arrête aussitôt :
Settings error: TRIAGE_FALLBACK must be person or noneCause : une faute de frappe, par exemple TRIAGE_FALLBACK=people. Le service refuse volontairement une valeur inconnue : une valeur par défaut appliquée silencieusement pourrait désactiver la solution de repli.
Correction : écrivez TRIAGE_FALLBACK=person, ou supprimez la ligne (la valeur par défaut est person).
Erreur courante
Le fournisseur est en panne, mais l'état indique encore ok
Symptôme : le fournisseur tombe en panne, et GET /v1/status continue d’indiquer "status":"ok" (état normal) pendant environ 2 minutes.
Cause : c’est voulu. L’état change quand le billet le plus ancien a attendu 120 secondes, au même moment que l’alerte drafts-late (brouillons en retard). Avant cela, les réponses ne sont pas encore en retard.
Correction : il n’y a rien à corriger. Si Larkfield veut prévenir les clients plus tôt, elle réduit ensemble DELAYED_AFTER_SECONDS et le seuil de l’alerte. Ils restent ainsi synchronisés.
Erreur courante
Augmenter les nouvelles tentatives pendant une panne
Symptôme : quelqu’un augmente les tentatives du processus ou le délai d’expiration du fournisseur « pour que ça passe ». La file ne se vide pas plus vite, et les erreurs du fournisseur augmentent.
Cause : tant que le fournisseur ne peut pas répondre, chaque tentative supplémentaire est un autre appel échoué. Quand le disjoncteur est ouvert, aucune tentative n’est consommée de toute façon.
Correction : rétablissez les valeurs. Le guide d’exploitation le précise dans sa section d’atténuation : ne touchez pas aux processus.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Pendant l'essai de panne, aucun billet n'est passé en échec définitif. Pourtant, la panne a duré 5 minutes et chaque tâche a 5 tentatives. Pourquoi?
Afficher la réponse
Le disjoncteur s’est ouvert après 5 appels échoués de suite. Pendant qu’il était ouvert, le processus n’a fait aucun appel. Il a remis chaque tâche dans la file sans consommer de tentative, 3 102 fois pendant l’essai. Il n’y a eu que 36 véritables nouvelles tentatives, autour des moments où le disjoncteur s’est ouvert. Aucune tâche n’a donc utilisé ses 5 tentatives, et chaque billet a été trié après le retour du fournisseur.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : la même panne dure 15 minutes plutôt que 5, à 1 billet par seconde. Qu'arrive-t-il au SLO des brouillons, à la file et à l'état?
Afficher la réponse
Le billet le plus ancien attend environ 15 × 60 + 54 ≈ 954 secondes, au-delà des 600 du SLO. Chaque billet ayant attendu plus de 600 secondes est donc non conforme. Si la file se vide en environ une minute comme avant, cela représente à peu près les 6 premières minutes de panne : environ 350 billets. Le SLI des brouillons baisse, et l’alerte draft-fast-burn peut se déclencher après le rétablissement. La file contient environ 900 billets, bien en dessous de sa limite de 5 000, donc aucun billet n’est refusé. L’état indique « delayed » (en retard) environ 2 minutes après le début de la panne, jusqu’au traitement de tous les billets accumulés. C’est une estimation : une file plus longue peut prendre plus de temps à se vider.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : après votre propre panne d'exercice, quelles sorties prouvent que le service est rétabli?
Afficher la réponse
GET /v1/status indique "status":"ok", et GET /v1/queue montre "queued" (en file) revenu à 0 ou quelques billets. Il montre aussi oldest_queued_seconds (attente la plus longue en secondes) sous 120, et "dead_letter":0 (aucune tâche en échec définitif). python -m ops incident, appliqué à vos fichiers de télémétrie, montre le disjoncteur fermé et aucun billet refusé. Aucun billet n’est sans brouillon valide. Le délai de création d’un brouillon revient à quelques secondes dans la dernière période, qui contient de nouveaux billets. Chaque case exige son propre nombre.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Le fournisseur d’IA est une dépendance que vous n’exploitez pas. Prévoyez sa panne : une solution de repli, des tâches en file, un état pour les clients et des vérifications du rétablissement.
- La file et le disjoncteur conservent chaque billet. Pendant que le disjoncteur est ouvert, les tâches retournent dans la file sans consommer de tentative : 0 tâche en échec définitif pendant l’essai.
GET /v1/statusdit la vérité aux clients, après les mêmes 120 secondes que l’alertedrafts-late.TRIAGE_FALLBACK=personenvoie tout billet sans réponse valide à une personne.- L’attente la plus longue détermine le SLO des brouillons : 354 secondes pendant une panne de 5 minutes. À ce rythme, une panne d’environ 9 minutes dépasserait donc le SLO (estimation tirée d’un seul essai).
- Le rétablissement est une liste de nombres tirés de
python -m ops incidentet de l’API. La dernière période doit contenir de nouveaux billets; l’état d’une alerte ne suffit pas.
Ensuite, vous consignez les leçons de la semaine passée, sans blâme, et vous vérifiez qu’une des actions qui en découlent fonctionne.
Leçon suivante : Tirer des leçons après un incident