
Les cascades
- Leçon 26
- 40 min
- Module 6 : Modèles de décision, cascades et distillation
Où nous en sommes
Nous avons des modèles peu coûteux qui sont sûrs pour la plupart des messages, et un LLM qui coûte plus cher. Dans cette leçon, nous construisons une cascade. Le modèle peu coûteux décide quand il est sûr, le LLM reçoit seulement les messages incertains, et une personne reçoit les autres. Nous choisissons les deux seuils sur les données de validation.
Leçon 26 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitLes cascades
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Utilisez le modèle peu coûteux pour les messages dont il est sûr, le LLM pour les messages incertains, puis une personne pour les autres. Choisissez les deux seuils sur les messages de validation pour réduire autant que possible le coût par 1 000 messages, sans fausser les résultats.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient chaque cellule de code, tâche et vérification de cette leçon. Il entraîne TF-IDF + régression logistique, réexécute les réponses enregistrées du LLM et construit la cascade. Il choisit ensuite les deux seuils sur les messages de validation et évalue ce choix une seule fois sur les données de test. Ses cellules de préparation installent pandas et scikit-learn et téléchargent les données d’exercice. Aucune préparation locale ni clé n’est nécessaire. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- TF-IDF + régression logistique et ses probabilités, vus dans Bayes naïf, régression logistique et SVM linéaire.
- Le LLM avec exemples et sa confiance écrite, vus dans Exemples dans la requête et descriptions d’étiquettes.
- Un seuil qui envoie les messages incertains en révision, vu dans Le coût de chaque erreur.
Ce qu’il vous faut sur votre ordinateur (seulement pour l’étape du projet)
- Votre dossier de projet
larkroutede Demander une décision, pas du texte, avec.venvactif :python -m pytest -qaffiche23 passed(23 tests réussis). - Les fichiers d’exercice
nextia-learning-labsà côté de votre dossier de projet, comme dans Découvrir la boîte de réception.
Testé sur macOS avec Python 3.12, pandas 3.1.1 et scikit-learn 1.9.1. Les commandes Windows ne sont pas testées.
Un commis rapide, un expert et le bureau de la superviseure
Section intitulée « Un commis rapide, un expert et le bureau de la superviseure »Retournons au bureau de poste. La plupart des lettres ont une adresse claire, et un commis rapide les trie en une seconde. Certaines lettres sont difficiles à lire. Le commis rapide les met dans un casier pour l’expert. Celui-ci est plus lent et coûte plus cher, mais lit bien les écritures difficiles. Quelques lettres posent problème même à l’expert. Elles vont au bureau de la superviseure, qui décide elle-même.
Personne ne demande à l’expert de trier chaque lettre. Ce serait lent. L’expert ferait aussi des erreurs sur des lettres faciles que le commis rapide trie correctement. Personne ne demande non plus au commis rapide de deviner pour chaque lettre. L’important, c’est que chaque personne sait quand elle n’est pas sûre et transmet la lettre.
Le problème : un seul routeur pour chaque message
Section intitulée « Le problème : un seul routeur pour chaque message »Larkfield a un commis rapide et un expert. Le commis rapide est TF-IDF + régression logistique : environ 0,1 milliseconde par message, sur n’importe quel portable. L’expert est le LLM hébergé avec exemples : environ 1,7 seconde par message, et chaque message quitte les ordinateurs de Larkfield. Dans cette boîte de réception, chacun a un point faible quand il travaille seul.
| Un seul routeur pour tout | Exactitude | Coût par 1 000 messages de test |
|---|---|---|
| TF-IDF + régression logistique | 0,962 | 296,0 $ US |
| Le LLM avec exemples (enregistré) | 0,970 | 116,1 $ US |
TF-IDF coûte peu cher, mais ses erreurs coûtent cher. D’où viennent-elles? Regardez les messages dont il n’est pas sûr. Avec un seuil de certitude de 0,80, TF-IDF est sûr pour 1 718 des 2 000 messages de test. Il est incertain pour 282 messages. Comparez les deux routeurs dans chaque groupe :
| Messages de test | Erreurs de TF-IDF | Erreurs du LLM | Coût des erreurs de TF-IDF | Coût des erreurs du LLM |
|---|---|---|---|---|
| TF-IDF est sûr (1 718) | 8 | 24 | 32 $ US | 64 $ US |
| TF-IDF est incertain (282) | 68 | 37 | 560 $ US | 168 $ US |
Ce tableau résume toute l’idée. Quand TF-IDF est sûr, il a raison plus souvent que le LLM. Quand il est incertain, le LLM a raison plus souvent. Aucun des deux routeurs n’est le meilleur partout.
Utiliser le LLM pour chaque message entraîne d’autres coûts que le tableau ne montre pas. Il fait 1 000 appels par 1 000 messages. Une matinée chargée peut atteindre la limite de débit du fournisseur : le nombre maximal d’appels qu’il accepte par minute. Chaque client attend environ 1,7 seconde ou plus. Et chaque message quitte l’entreprise, ce que certains clients et certaines lois n’acceptent pas.
L’idée : une cascade
Section intitulée « L’idée : une cascade »Une cascade est une chaîne de routeurs, du moins coûteux au plus coûteux. Chaque routeur décide seulement pour les messages dont il est sûr et transmet les autres au suivant. La dernière étape est une personne. Le nom vient d’une chute d’eau qui descend par paliers. Les messages descendent, et chaque palier en garde une partie.
La cascade de Larkfield a trois étapes et deux seuils :
- TF-IDF décide quand sa probabilité la plus élevée atteint au moins
sure. - Sinon, le LLM décide quand sa confiance écrite atteint au moins
llm_sure. - Sinon, une personne lit le message (une révision, 1,50 $ US).
La confiance écrite du LLM est un nombre dans son texte, pas une probabilité mesurée. Au module 5, nous l’avons vérifiée sur cette boîte de réception. Avec des exemples, elle était proche de la réalité, avec une erreur d’étalonnage attendue de 0,008. Sans cette vérification, un seuil appliqué à cette confiance ne voudrait rien dire.
Un petit exemple détaillé : trois messages
Section intitulée « Un petit exemple détaillé : trois messages »Voici trois vrais messages de test qui passent dans la cascade, avec sure = 0.80 et llm_sure = 0.95 :
| Message | Étiquette | TF-IDF | LLM | Qui décide |
|---|---|---|---|---|
M-100001 “Est-ce que le livreur pourrait laisser mon colis … chez ma voisine?” |
delivery | delivery, 1,000 | delivery, 1,0 | TF-IDF : 1,000 ≥ 0,80 |
M-100561 “Please cancel order LK-472452 … I also need an invoice, and SPRING15 did not work …” |
orders | orders, 0,593 | orders, 0,99 | le LLM : 0,593 < 0,80, et 0,99 ≥ 0,95 |
M-100005 “Hello, just following up on my last email about LK-300801 …” |
delivery | orders, 0,416 | delivery, 0,62 | une personne : les deux sont incertains |
Le premier message est facile : TF-IDF décide, et le LLM n’est jamais appelé. Le deuxième demande trois choses, et TF-IDF hésite entre elles. Le LLM suit le guide (la première demande détermine la décision) et il est sûr. Le troisième ne donne aucun sujet : « that arrangement » (cet arrangement) se trouve dans un courriel précédent. TF-IDF devine orders (commandes) et le LLM devine delivery (livraison), tous deux sans confiance. Une personne peut ouvrir le courriel précédent; un modèle ne le peut pas.
La cascade sur les 2 000 messages de test
Section intitulée « La cascade sur les 2 000 messages de test »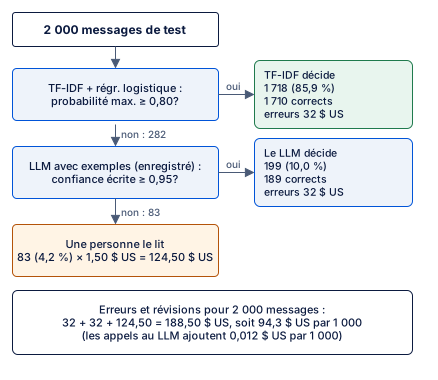
Description textuelle du diagramme
Le diagramme montre un parcours de haut en bas. Les 2 000 messages de test arrivent à la première question : la probabilité maximale de TF-IDF + régression logistique atteint-elle 0,80? Si oui, TF-IDF décide. Cela arrive pour 1 718 messages, soit 85,9 %. Il décide correctement pour 1 710 messages, et les 8 erreurs coûtent 32 $ US. Sinon, les 282 autres messages vont à la deuxième question : le LLM avec exemples a-t-il écrit une confiance de 0,95 ou plus? Si oui, le LLM décide : 199 messages, soit 10,0 %, dont 189 décisions correctes; les erreurs coûtent 32 $ US. Sinon, les 83 derniers messages (4,2 %) vont à une personne, à 1,50 $ US chacun. Cela coûte 124,50 $ US. En bas, le total pour les 2 000 messages : 32 + 32 + 124,50 = 188,50 $ US en erreurs et révisions. Cela fait 94,3 $ US par 1 000 messages. Les appels au LLM ajoutent seulement 0,012 $ US par 1 000.
La cascade coûte 94,3 $ US par 1 000 messages de test : le coût le plus bas du tableau comparatif du cours jusqu’ici. Elle appelle le LLM pour 141 messages sur 1 000, pas pour 1 000. Les décisions prises sont correctes à 99,1 %.
La cascade de Larkfield : choisir les seuils sur les données de validation
Section intitulée « La cascade de Larkfield : choisir les seuils sur les données de validation »D’où viennent 0,80 et 0,95? Priya ne les devine pas et ne les choisit pas à partir des messages de test. Elle essaie chaque paire d’une grille sur les messages de validation et garde la moins coûteuse. Sur la grille, sure va de 0,30 à 1,00 par pas de 0,05. llm_sure vaut soit 0 (le LLM décide pour tout ce qu’il reçoit), soit une valeur de la même grille.
Voici une petite partie de la recherche, en dollars US par 1 000 messages de validation :
| sure ↓ / llm_sure → | 0 (le LLM décide pour tout ce qu’il reçoit) | 0,80 | 0,90 | 0,95 |
|---|---|---|---|---|
| 0,50 | 433,0 | 400,8 | 400,8 | 385,3 |
| 0,70 | 300,0 | 233,3 | 237,5 | 224,0 |
| 0,80 | 176,0 | 108,3 | 117,8 | 103,8 |
| 0,90 | 179,0 | 114,3 | 116,0 | 109,5 |
La paire la moins coûteuse est sure = 0.80 et llm_sure = 0.95, à 103,8 $ US sur les données de validation. C’est seulement ensuite que Priya l’évalue sur les messages de test, une seule fois. Le résultat est 94,3 $ US. La validation coûte plus cher parce que ses messages comportent, par hasard, davantage d’erreurs coûteuses. Décider, faire réviser ou transférer à une personne revient sur ce bruit.
D’où viennent les 94,3 $ US
Section intitulée « D’où viennent les 94,3 $ US »Tomás sourit : « Donc la cascade économise de l’argent parce qu’elle appelle moins le LLM. » Les données disent non. À ces prix, le coût d’exécution du LLM est minuscule. Il est de 0,088 $ US par 1 000 messages pour le LLM seul, et de 0,012 $ US dans la cascade. L’économie est de 0,076 $ US par 1 000 messages. Le vrai gain vient de la réduction des erreurs coûteuses. Ajoutons les étapes une à une :
- Validation
- Test
Description textuelle du graphique
Un graphique à colonnes avec trois paires de colonnes, une pour la validation et une pour le test. Le LLM pour chaque message : 189,1 sur les données de validation et 116,1 sur les données de test. TF-IDF d’abord, puis le LLM pour les autres, sans personne : 176,0 sur la validation et 100,0 sur le test. La cascade complète, avec une personne pour les messages dont le LLM n’est pas sûr : 103,8 sur la validation et 94,3 sur le test.
- TF-IDF d’abord élimine des erreurs, car TF-IDF a raison plus souvent que le LLM pour les messages dont il est sûr. Sur le test, cette étape fait passer le coût de 116,1 à 100,0; sur la validation, de 189,1 à 176,0.
- L’étape humaine envoie en révision les 4,2 % de messages dont les deux modèles sont incertains. Sur la validation, où Priya a fait son choix, c’est l’essentiel du gain : de 176,0 à 103,8. Sur le test, le coût passe de 100,0 à 94,3.
Présentez donc le résultat honnêtement. La cascade fait mieux que le LLM seul grâce à la destination choisie pour chaque message. Surtout, une personne lit les quelques messages dont personne n’est sûr. Ce n’est pas l’économie de jetons qui lui donne l’avantage.
Explorer la cascade
Section intitulée « Explorer la cascade »L’explorateur utilise les mêmes enregistrements pour les 2 000 messages de test. Déplacez le seuil de certitude de TF-IDF. Changez ensuite ce que le LLM fait des messages qu’il reçoit. Il peut décider pour tous, ou décider seulement à partir de 0,95 et envoyer les autres à une personne.
Explorer
Un modèle peu coûteux, un LLM et une personne
Prédisez d’abord : Le seuil commence à 0,30 : TF-IDF décide pour presque chaque message, et le LLM décide pour tout ce qu'il reçoit. Quand vous augmentez le seuil jusqu'à 1,00, davantage de messages vont au LLM. Le coût descend-il jusqu'à la ligne du LLM pour tout, ou atteint-il un minimum avant?
Où vont les 2 000 messages de test
- Le LLM décide tout ce qu’il reçoit
- Le LLM décide à ≥ 0,95, sinon une personne
- TF-IDF décide
- 99,7 %
- Le LLM décide
- 0,3 %
- Une personne le lit
- 0,0 %
- Exactitude des décidés
- 96,3 %
- Erreurs et révisions pour 1 000
- 293,0 $ US
- Coût de fonctionnement pour 1 000
- 0,000 $ US
- Total pour 1 000 messages
- 293,0 $ US
Au seuil 0,30, TF-IDF décide 99,7 % des messages, le LLM en décide 0,3 % et 0,0 % vont à une personne. Les messages décidés sont justes à 96,3 %. Erreurs et révisions : 293,0 $ US; fonctionnement : 0,000 $ US; total : 293,0 $ US pour 1 000 messages. Sur cette courbe, le total le plus bas est 97,0 $ US pour 1 000, au seuil 0,85.
Description textuelle de l’explorateur
L’explorateur a un curseur pour le seuil de certitude de TF-IDF, de 0,30 à 1,00 par pas de 0,01. Deux boutons radio permettent de choisir ce que fait le LLM. Il décide pour tout ce qu’il reçoit, ou seulement quand il a écrit 0,95 ou plus, puis envoie les autres à une personne. Trois barres montrent où vont les 2 000 messages de test : décision de TF-IDF, décision du LLM, lecture par une personne. Un graphique linéaire montre le coût total par 1 000 messages selon le seuil, avec une ligne pour chaque choix du LLM. Deux lignes de référence en pointillés montrent le LLM pour tout à 116,1 $ US et TF-IDF seul à 296,0 $ US. Une ligne verticale en pointillés marque 0,80, le seuil choisi sur la validation. Des tuiles donnent les valeurs exactes. Elles montrent les trois parts, l’exactitude des décisions prises, le coût des erreurs et des révisions, le coût d’exécution et le total. À 0,30, quand le LLM décide pour tout ce qu’il reçoit, TF-IDF décide pour 99,7 % des messages. Le total est de 293,0 $ US. Le total baisse de 102 $ US entre 0,45 et 0,46, quand une prise de contrôle de compte passe de TF-IDF au LLM. De 0,73 à 0,90, il reste entre 97 $ US et 102 $ US, avec un minimum de 97,0 $ US à 0,85. Il monte à 116,1 $ US à 1,00, où le LLM décide pour tout. Avec l’étape humaine, la ligne est plus basse presque partout. Elle est à 94,3 $ US à 0,80. À 1,00, le LLM reçoit chaque message, 6,35 % vont à une personne, et le total est de 133,3 $ US.
Ce que montre l’explorateur
Section intitulée « Ce que montre l’explorateur »Commencez à 0,30, avec « Le LLM décide tout ce qu’il reçoit ». TF-IDF décide pour 99,7 % des messages, et le total est de 293,0 $ US, presque comme TF-IDF seul. Augmentez maintenant le seuil. Entre 0,45 et 0,46, le total baisse de 102 $ US. Une prise de contrôle de compte quitte les décisions de TF-IDF et va au LLM, qui l’achemine correctement. Ici, un seul message vaut 200 $ US.
La réponse à votre prédiction : il y a un minimum avant la fin. De 0,73 à 0,90, le total reste entre 97 $ US et 102 $ US. Son minimum est de 97,0 $ US, à 0,85. À 1,00, le LLM décide pour tout, et le total monte à 116,1 $ US. Au-dessus de 0,90, davantage de messages que TF-IDF traite correctement vont au LLM. Pour ces messages, le LLM se trompe plus souvent que TF-IDF.
Passez maintenant à « Le LLM décide à ≥ 0,95, sinon une personne ». À 0,80, les barres montrent 85,9 %, 10,0 % et 4,2 %. Le total est de 94,3 $ US. Passez à 1,00 : TF-IDF ne décide pour aucun message, et 6,35 % vont à une personne, pour 133,3 $ US. Sans TF-IDF en premier, le LLM est incertain pour davantage de messages, et les révisions coûtent plus cher.
Il reste une chose à voir. Sur ce graphique de test, le minimum de la deuxième ligne est de 89,0 $ US, à 0,73. Il n’est pas à 0,80. C’est le bruit propre aux données de test, et nous ne modifions pas le choix pour le suivre. Le cas d’échec ci-dessous montre pourquoi.
Exercice guidé : construire la cascade
Section intitulée « Exercice guidé : construire la cascade »- Ouvrez le carnet Jupyter de l’encadré Faites cette leçon dans un carnet Jupyter, en haut de cette page.
- Exécutez les cellules de préparation. La cellule des données se termine par
Ready: 10000 messages (6000 train, 2000 validation, 2000 test), all synthetic.(prêt : 10 000 messages, dont 6 000 d’entraînement, 2 000 de validation et 2 000 de test, tous synthétiques). - Dans la section 1, exécutez la cellule. Vous voyez
hosted LLM chat-small, few-shot (recorded) - 0.0876 dollars per 1,000 messages(LLM hébergé chat-small, avec peu d’exemples, enregistré : 0,0876 $ US par 1 000 messages). - Dans la section 2, exécutez la cellule. Vous voyez les trois messages de l’exemple détaillé, avec l’étape qui a décidé pour chacun.
- Dans la section 3, écrivez votre prédiction. Exécutez ensuite la cellule. Vous voyez
{'tfidf': 1702, 'llm': 213, 'person': 85}et103.8. - Dans la section 4, lancez la recherche. La meilleure paire est
sureà 0,8 etllm_sureà 0,95, pour103.8. - Dans la section 5, exécutez la cellule de test une seule fois. Vous voyez
94.3dollars par 1 000 et une exactitude de0.991.
Ajouter la cascade au projet
Section intitulée « Ajouter la cascade au projet »Ajoutez maintenant la cascade à votre projet. Elle comprend deux fichiers : larkroute/cascade.py (la cascade et sa recherche) et la commande larkroute/commands/cascade.py. Le projet trouve chaque commande par son fichier. Aucun autre fichier ne change.
-
Dans votre dossier de projet
larkroute, avec.venvactif, copiez la cascade, sa commande, son test et le nouveau README depuis l’instantanéend-of-m06:Fenêtre de terminal S=../nextia-learning-labs/C36/snapshots/end-of-m06cp "$S/larkroute/cascade.py" larkroute/cp "$S/larkroute/commands/cascade.py" larkroute/commands/cp "$S/tests/test_cascade.py" tests/cp "$S/README.md" .Fenêtre de terminal $S = "..\nextia-learning-labs\C36\snapshots\end-of-m06"Copy-Item "$S\larkroute\cascade.py" larkroute\Copy-Item "$S\larkroute\commands\cascade.py" larkroute\commands\Copy-Item "$S\tests\test_cascade.py" tests\Copy-Item "$S\README.md" . -
Exécutez les tests. La dernière ligne affiche
24 passed(24 tests réussis). Votre projet correspond maintenant à l’instantanéend-of-m06.Fenêtre de terminal python -m pytest -q -
Choisissez les deux seuils sur les messages de validation, puis évaluez ce choix sur les messages de test. Cela prend environ 5 secondes :
Fenêtre de terminal route cascade --searchChosen on the validation messages: sure 0.80, LLM sure 0.95Test messages: 85.9% decided by TF-IDF, 10.0% by the LLM (few-shot, recorded), 4.2% to a person. Accuracy of the decided messages 99.1%.Cost per 1,000 messages: mistakes and reviews 94.2 dollars, running 0.012 dollars, total 94.3 dollars. -
Évaluez la même première étape sans personne : le LLM décide pour chaque message qu’il reçoit.
Fenêtre de terminal route cascade --sure 0.8 --llm-sure 0Test messages: 85.9% decided by TF-IDF, 14.1% by the LLM (few-shot, recorded), 0.0% to a person. Accuracy of the decided messages 97.8%.Cost per 1,000 messages: mistakes and reviews 100.0 dollars, running 0.012 dollars, total 100.0 dollars.
route cascade réutilise les réponses enregistrées du LLM. Cette commande ne demande donc aucune clé, et aucun message ne quitte votre ordinateur. Utilisez le mode par défaut, few-shot (avec peu d’exemples). Les enregistrements du mode zéro exemple couvrent seulement les messages de test. Ainsi, --mode zero-shot fonctionne avec les seuils que vous donnez (--sure et --llm-sure). Il ne fonctionne pas avec --search, qui demande les messages de validation : la commande l’indique alors et s’arrête.
Quand utiliser une cascade, et ce qu’elle coûte
Section intitulée « Quand utiliser une cascade, et ce qu’elle coûte »Utilisez une cascade quand un modèle peu coûteux est sûr pour la plupart des messages et répond correctement lorsqu’il est sûr. Dans cette boîte de réception, TF-IDF est sûr pour 85,9 % des messages et se trompe sur seulement 8 d’entre eux. Une étape coûteuse vaut alors la peine pour les autres.
N’en utilisez pas si le modèle peu coûteux est rarement sûr, ou s’il se trompe lorsqu’il est sûr. La première étape ajoute alors seulement un délai et une source d’erreurs. Vérifiez cela sur les données de validation avant de construire quoi que ce soit. Comptez les messages au-dessus du seuil et les erreurs du modèle peu coûteux parmi eux. Aussi, si un modèle représente déjà la ligne la moins coûteuse partout, vous n’avez peut-être pas besoin des autres. Dans cette boîte de réception, l’encodeur réglé finement coûte à lui seul 103,0 $ US, presque autant que la cascade.
Ce qu’une cascade vous coûte :
- Deux seuils à choisir, puis à choisir de nouveau. Une nouvelle version du modèle, un nouveau LLM ou un nouveau produit modifie les deux. Gardez la recherche sous forme de code et exécutez-la sur les messages de validation de chaque version.
- Plus de composants à faire fonctionner. Deux modèles, un client LLM avec de nouvelles tentatives et une file de révision. Chaque composant peut tomber en panne. Décidez quoi faire si le LLM ne fonctionne plus : ici, ses messages pourraient aller à une personne.
- Le temps des personnes. L’étape humaine envoie 42 messages sur 1 000 à l’équipe de Grace. Cela représente environ 3 messages par jour, sur les 65 que Larkfield reçoit chaque jour. Vérifiez la charge avec elle avant de vous engager.
- Des attentes inégales. 85,9 % des clients attendent une fraction de milliseconde. Les autres attendent le LLM, environ 1,7 seconde, ou une personne, quelques heures. L’attente moyenne liée au LLM par message passe de 2,68 secondes (le LLM pour tout) à 0,39 seconde.
À vous de jouer : la même cascade sans le LLM
Section intitulée « À vous de jouer : la même cascade sans le LLM »Changez une seule chose : gardez TF-IDF à sure = 0.80, mais envoyez directement à une personne chaque message incertain. Il n’y a aucun LLM. Dans la section 6 du carnet (notebook) Jupyter, calculez le coût sur les messages de validation et placez-le dans no_llm_cost. Avant l’exécution, faites une prédiction : l’étape LLM vaut-elle le coût de ses appels?
Afficher la réponse
r, s = cascade(vr, vp, lv_r, lv_c, 0.80, 2.0)no_llm_cost = cascade_cost(validation, r, s)print(no_llm_cost)235.5llm_sure = 2.0 dépasse toute confiance écrite. Chaque réponse du LLM va donc à une personne. Sans le LLM, 298 messages de validation vont à une personne. Le coût est de 235,5 $ US, contre 103,8 $ US avec le LLM. Sur les données de test, il est de 227,5 $ US contre 94,3 $ US. Le LLM vaut le coût de ses appels. Il répond correctement à la plupart des messages pour lesquels TF-IDF est incertain. Un appel coûte beaucoup moins qu’une révision.
Erreur courante
Un meilleur seuil, trouvé sur les messages de test
Symptôme : Tomás essaie chaque seuil de confiance de 0,30 à 1,00, par pas de 0,01, sur les messages de test. « Regardez : à 0,73, la cascade coûte 89,0 $ US, pas 94,3 $ US. Utilisons 0,73. »
Cause : 0,73 correspond au point le plus bas sur les messages de test. Ce seuil s’ajuste donc à leur bruit. Sur les messages de validation, le même seuil coûte 225,8 $ US, contre 103,8 $ US à 0,80. Près du bas de la courbe, quelques messages coûteux déterminent où se trouve le point le plus bas. Le montant de 89,0 $ US ne se retrouvera pas le mois suivant.
Solution : choisissez sur les messages de validation. Rapportez le résultat du test une seule fois, même si un résultat inférieur est visible. Pour mieux choisir, obtenez plus de données probantes. Utilisez davantage de messages étiquetés, ou la même recherche avec validation croisée sur les messages d’entraînement. Consultez Données d’entraînement, de validation et de test.
Conséquence dans le travail en IA : un seuil ajusté sur les données de test ressemble à un gain gratuit dans le rapport. En production, il devient une surprise. Deux seuils offrent deux fois plus de façons de s’ajuster au bruit.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
La cascade coûte 94,3 $ US par 1 000 messages de test, et le LLM pour tout coûte 116,1 $ US. Tomás dit que le gain vient de la réduction des appels au LLM. Utilisez les chiffres pour expliquer sa vraie source.
Afficher la réponse
Il ne vient pas des appels. Le LLM coûte 0,088 $ US par 1 000 messages seul et 0,012 $ US dans la cascade. L’économie est de 0,076 $ US. Le gain vient de la réduction des erreurs coûteuses. Sur les messages pour lesquels TF-IDF est sûr, il fait 8 erreurs, contre 24 pour le LLM. Placer TF-IDF en premier fait passer le coût de 116,1 à 100,0 sur les données de test. Ensuite, une personne lit les 4,2 % de messages pour lesquels les deux modèles sont incertains. Cela ramène le coût à 94,3. Sur les données de validation, où les seuils ont été choisis, l’étape humaine apporte l’essentiel du gain : de 176,0 à 103,8.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Faites une prédiction : dans l'explorateur, le LLM décide pour tout ce qu'il reçoit. Qu'arrive-t-il au coût total quand vous augmentez le seuil de confiance de 0,85 à 1,00, et pourquoi?
Afficher la réponse
Il augmente, de 97,0 $ US à 116,1 $ US. Au-dessus de 0,85, davantage de messages que TF-IDF traiterait correctement vont plutôt au LLM. Sur ces messages, le LLM se trompe plus souvent que TF-IDF, donc les erreurs coûtent plus cher. Le coût d’exécution augmente aussi, mais de moins de 0,1 $ US par 1 000 messages. Le point le plus bas arrive avant la fin, pas à « le LLM pour tout ».
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : votre projet est maintenant à l'étape end-of-m06. Quelle commande choisit les deux seuils, quels seuils choisit-elle, et quelle part des messages de test va à une personne?
Afficher la réponse
route cascade --search. Elle choisit les seuils sur les messages de validation : 0,80 pour la confiance de TF-IDF et 0,95 pour la confiance écrite du LLM. Sur les messages de test, TF-IDF décide pour 85,9 %, le LLM pour 10,0 %, et 4,2 % vont à une personne. Le total est de 94,3 $ US par 1 000 messages. python -m pytest -q affiche 24 passed.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une cascade est une chaîne de routeurs, du moins coûteux au plus coûteux. Chacun décide pour les messages dont il est sûr et transmet les autres au suivant. Une personne constitue la dernière étape.
- Dans cette boîte de réception, TF-IDF est sûr pour 85,9 % des messages de test et se trompe sur 8 d’entre eux. Le LLM décide pour 10,0 %, et une personne lit 4,2 %.
- Choisissez les deux seuils sur les données de validation : 0,80 et 0,95 ici (103,8 $ US). Évaluez-les une seule fois sur les données de test : 94,3 $ US par 1 000, la ligne la moins coûteuse jusqu’ici. Le LLM pour tout coûte 116,1 $ US, et TF-IDF seul coûte 296,0 $ US.
- Le gain ne vient pas des jetons économisés (0,076 $ US par 1 000). Il vient de la réduction des erreurs coûteuses, et surtout des quelques messages qu’une personne lit.
- Votre projet est à l’étape
end-of-m06: 24 tests,route llmetroute cascade.
Vous pouvez maintenant donner au LLM seulement les messages qui en ont besoin. Mais la cascade appelle encore le LLM et envoie 14,1 % des messages à l’extérieur de Larkfield. Ensuite, vous laissez le LLM enseigner une seule fois à un modèle peu coûteux. Vous verrez ce que le modèle élève apprend, y compris les erreurs.
Leçon suivante : La distillation : laisser le LLM enseigner à un modèle bon marché