
Des modèles de décision spécialisés
- Leçon 25
- 30 min
- Module 6 : Modèles de décision, cascades et distillation
Où nous en sommes
Nous avons transformé à la main un modèle de texte en modèle de décision. Certaines entreprises créent maintenant des modèles qui prennent uniquement des décisions typées. Dans cette leçon, nous examinons les affirmations d'un fournisseur comme exemple. Nous apprenons aussi à vérifier les affirmations de tout nouveau modèle sur nos propres messages.
Leçon 25 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitDes modèles de décision spécialisés
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Jugez un nouveau modèle sur ses résultats avec vos messages, pas sur les affirmations de son fabricant. Utilisez une liste de cinq questions. Ajoutez le modèle au tableau comparatif avant de lui faire confiance.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les scores des destinations, la sortie contrainte et l’étalonnage, dans Demander une décision, pas du texte.
- Le tableau comparatif et ses colonnes, dans Découvrir la boîte de réception.
Ce qu’il vous faut sur votre ordinateur (uniquement pour l’étape du projet)
- Votre dossier de projet
larkroutede la dernière leçon, avec.venvactif :python -m pytest -qaffiche23 passed(23 tests réussis).
Cette leçon ne modifie pas le projet. Testé sur macOS avec Python 3.12. Les commandes Windows ne sont pas testées.
Une machine de tri et sa brochure
Section intitulée « Une machine de tri et sa brochure »Une entreprise visite le bureau de poste avec une nouvelle machine de tri. La brochure annonce : « 200 fois plus rapide qu’une personne. Ne met jamais une lettre dans un sac qui n’existe pas. Sait quand elle hésite. » La gestionnaire est intéressée. Une machine plus rapide changerait toute sa matinée.
Elle ne l’achète pas sur la foi de la brochure. Elle demande une chose : « Testez-la sur une semaine de nos lettres, à côté de nos commis. » Les lettres de la brochure étaient tapées et propres. Les siennes sont manuscrites, en deux langues, avec d’anciennes adresses. Elle demande aussi ce qui arrive quand l’entreprise modifie la machine, et combien coûte l’abandon de son utilisation.
Le problème : les affirmations ne sont pas des preuves
Section intitulée « Le problème : les affirmations ne sont pas des preuves »Chaque modèle de ce cours était accompagné d’un discours convaincant. Pour cette boîte de réception, plusieurs de ces discours ne tenaient pas. Voici quatre résultats réels des leçons précédentes :
| Ce que vous pourriez attendre | Ce que les messages de test de Larkfield ont montré |
|---|---|
| Un modèle de plongement plus récent est meilleur | Le modèle de 2026 : 0,906, 26,9 ms par message (7,0 ms en float32). Le modèle de 2021 : 0,920, 6,8 ms |
| Un modèle conçu pour la classification zéro exemple fonctionne sans étiquettes | GLiClass : 0,516. Le modèle NLI : 0,329 |
| Une réponse valide est une bonne réponse | Qwen3-0.6B avec Outlines : 100 % de noms de destinations valides, 12,8 % de bonnes réponses |
| « Confiance de 0,99 » signifie une certitude de 99 % | Le LLM sans exemples a écrit 0,99 à 693 reprises, et avait raison dans 86,6 % de ces cas |
Aucun de ces modèles n’est mauvais en général. Ils ont été conçus et testés sur d’autres données, et ne convenaient pas à cette boîte de réception. Les affirmations décrivent les données du fabricant. Seules vos données décrivent votre situation.
L’idée : des modèles conçus pour les décisions
Section intitulée « L’idée : des modèles conçus pour les décisions »Dans la dernière leçon, nous avons pris un modèle de texte et l’avons adapté à la main pour prendre des décisions. Nous avons calculé un score pour chaque nom de destination, ou limité ce qu’il pouvait écrire. Un modèle de décision spécialisé le fait par conception. Vous lui donnez la liste des réponses possibles, le schéma. Il retourne l’une d’elles, avec une probabilité pour chacune, sans écrire de texte libre. « Typée » signifie que la réponse a toujours le type demandé par le schéma : ici, un des sept noms de destinations.
Pourquoi créer un tel modèle? Pour trois raisons, si les affirmations se confirment :
- Aucune analyse de la sortie. La réponse est toujours une destination valide. Elle ne peut jamais être « - delivery » ni du JSON tronqué.
- Une vraie probabilité. On peut entraîner le modèle pour que « 0,9 » corresponde à une bonne réponse environ 9 fois sur 10. Un seuil a alors un sens.
- La vitesse. Il n’écrit pas jeton par jeton, donc il peut répondre en un seul passage rapide.
Un exemple : Jev
Section intitulée « Un exemple : Jev »Au moment de la rédaction, un fournisseur vend ce type de modèle. TypeSafe AI a annoncé ses modèles System One en septembre 2026, avec Jev comme premier modèle. Voici ce que dit l’article du fournisseur. Chaque ligne est une affirmation du fournisseur : l’équipe du cours ne s’est pas inscrite, n’a pas appelé le modèle et n’a rien mesuré.
| Ce que dit le fournisseur | Les preuves présentées dans l’article |
|---|---|
| Uniquement des décisions typées : les sorties possibles et leur structure sont fixées à l’avance; aucun texte libre | Une description de la conception |
| Chaque réponse s’accompagne de probabilités bien étalonnées | Aucun chiffre sur l’étalonnage |
| De 70 à 500 ms par requête, de bout en bout; de 40 à 200 fois plus rapide que les LLM de pointe | Mesuré par le fournisseur depuis des ordinateurs portables sur la côte ouest des États-Unis |
| 0 % d’erreurs de type | Vrai par conception : la réponse respecte toujours le schéma. Ce n’est pas une mesure d’exactitude |
| Entrée à 0,042 $ US par million de jetons; sortie gratuite | Le fournisseur dit ne pas pouvoir prouver que le prix n’est pas subventionné |
| Exactitude « exceptionnelle » sur ses propres tests de flux de travail | Aucun chiffre d’exactitude; aucun banc d’essai public |
Au moment de la lecture de l’article, Jev était en accès anticipé pour les développeurs inscrits sur une liste d’attente. L’article ne dit pas que les poids sont ouverts, donc vous ne pouvez pas l’exécuter sur votre ordinateur. L’équipe du cours ne s’est pas inscrite sur la liste d’attente.
Regardez la colonne de droite. La vitesse a une source, mais les mesures viennent des ordinateurs du fournisseur. « 0 % d’erreurs de type » est vrai, et c’est la même promesse qu’Outlines nous faisait : une réponse valide, pas une bonne réponse. L’étalonnage et l’exactitude, les deux éléments les plus importants pour un routeur, n’ont aucun chiffre.
Une liste de vérification pour les affirmations de tout nouveau modèle
Section intitulée « Une liste de vérification pour les affirmations de tout nouveau modèle »Priya écrit une liste de vérification pour Grace et Omar. Elle s’applique à Jev, au prochain LLM et à tout modèle qu’un fournisseur leur présente :
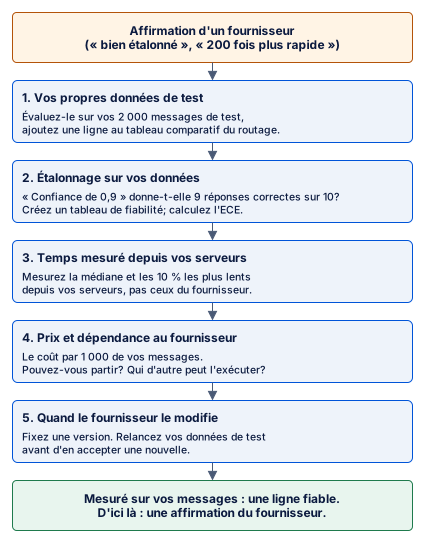
Description textuelle du diagramme
Le diagramme présente une colonne de cases, d’une affirmation du fournisseur en haut à une ligne fiable en bas. L’affirmation est, par exemple, « bien étalonné » ou « 200 fois plus rapide ». Cinq questions suivent, une par case. Premièrement, vos propres données de test : évaluez le modèle sur vos 2 000 messages de test, comme ligne supplémentaire de route compare. Deuxièmement, l’étalonnage sur vos données : une « certitude de 0,9 » donne-t-elle une bonne réponse 9 fois sur 10 sur vos messages? Créez un tableau de fiabilité et calculez l’erreur d’étalonnage attendue. Troisièmement, le temps depuis votre emplacement : mesurez la médiane et les 10 % de requêtes les plus lentes depuis vos serveurs, pas ceux du fournisseur. Quatrièmement, le prix et la dépendance au fournisseur : calculez le coût par 1 000 de vos propres messages. Demandez si vous pouvez partir, et qui d’autre peut exécuter le modèle. Cinquièmement, quand le fournisseur modifie le modèle : fixez une version et testez à nouveau sur vos données avant d’en accepter une nouvelle. La dernière case dit : mesuré sur vos messages, le modèle est une ligne fiable. Jusque-là, c’est une affirmation du fournisseur.
1. Vos propres données de test
Section intitulée « 1. Vos propres données de test »Exécutez le modèle sur les mêmes 2 000 messages de test que les autres lignes, avec le même tableau des coûts. Ce n’est qu’ensuite que vous pouvez le comparer aux autres lignes. TF-IDF coûte 296,0 $ US et l’encodeur réglé finement, 103,0 $ US. Le banc d’essai d’un fournisseur utilise d’autres messages, d’autres étiquettes et un autre coût par erreur.
2. L’étalonnage sur vos données
Section intitulée « 2. L’étalonnage sur vos données »Une probabilité est utile seulement si elle correspond à la réalité sur vos messages. Créez le tableau de fiabilité de Demander une décision, pas du texte, et calculez l’erreur d’étalonnage attendue. Un modèle peut être bien étalonné sur les tests du fournisseur. Il peut l’être beaucoup moins sur des messages de clavardage en français concernant des meubles de jardin.
3. Le temps depuis votre emplacement
Section intitulée « 3. Le temps depuis votre emplacement »Le fournisseur a mesuré ses 70 à 500 ms depuis ses propres ordinateurs portables. Vos requêtes partent de vos serveurs, traversent votre réseau, à vos heures de pointe. Mesurez la médiane et les 10 % de requêtes les plus lentes, comme le cours pour chaque ligne de modèle hébergé. Le graphique situe l’affirmation parmi les temps mesurés dans le cours :

Description textuelle du diagramme
Le graphique présente un point par méthode sur une échelle logarithmique de millisecondes par message, de 0,01 à 10 000. Chaque étape de l’échelle est 10 fois plus lente que la précédente. TF-IDF avec Bayes naïf prend 0,02 ms, et TF-IDF avec régression logistique, 0,16 ms. L’encodeur réglé finement et les plongements de 2021 prennent environ 7 ms. GLiClass prend 21,3 ms, et les plongements de 2026, 26,9 ms. Qwen3-0.6B local prend 453 ms avec les scores des destinations et 2 128 ms quand il écrit du JSON. Le LLM hébergé prend 1 200 ms sans exemples et 1 708 ms avec exemples, et le modèle de raisonnement, 2 040 ms. Une bande orange de 70 à 500 ms indique l’affirmation du fournisseur pour Jev. Elle se situe entre les modèles locaux et les LLM hébergés, et ne représente pas une mesure.
Si l’affirmation se confirme depuis vos serveurs, Jev serait environ 3 à 24 fois plus rapide que le LLM hébergé. Il resterait de 10 à 3 000 fois plus lent que les modèles entraînés exécutés sur l’ordinateur de Larkfield.
4. Le prix et la dépendance au fournisseur
Section intitulée « 4. Le prix et la dépendance au fournisseur »Convertissez le prix en coût par 1 000 messages. Notre requête de LLM avec exemples contient environ 717 jetons d’entrée. Au prix d’entrée du fournisseur, 1 000 messages semblables coûteraient environ 0,03 $ US, avec une sortie gratuite. C’est notre calcul à partir d’une affirmation du fournisseur. Pour cette boîte de réception, cela change peu : le LLM hébergé ne coûte déjà que 0,088 $ US par 1 000 messages à exécuter. Le coût de ses erreurs est de 116,0 $ US. Un modèle moins cher qui fait plus d’erreurs coûte plus.
Posez ensuite des questions sur la dépendance au fournisseur : la difficulté de partir. Un modèle fermé sans poids ouverts fonctionne uniquement chez son fournisseur. Si le fournisseur change le prix, arrête le modèle ou ferme, pouvez-vous migrer? Les modèles entraînés de ce cours sont des fichiers sur le disque de Larkfield.
5. Quand le fournisseur le modifie
Section intitulée « 5. Quand le fournisseur le modifie »Un modèle hébergé peut changer tout en gardant le même nom. Demandez si vous pouvez fixer une version : appeler une version précise jusqu’à ce que vous décidiez de changer. Avant de changer, testez à nouveau sur vos données de test et comparez les deux lignes. Les lignes hébergées du cours ont été enregistrées une seule fois, donc elles ne peuvent pas changer. Un modèle en service peut changer.
Larkfield : le tableau comparatif avec une ligne supplémentaire
Section intitulée « Larkfield : le tableau comparatif avec une ligne supplémentaire »Priya ajoute le modèle du fournisseur au tableau comparatif comme ligne facultative, clairement indiquée :
| Méthode | Exactitude | Total ($ US par 1 000) | ms par message | Étiquette |
|---|---|---|---|---|
| Encodeur MiniLM-L12 réglé finement | 0,980 | 103,0 | 6,7 | mesuré |
| LLM hébergé chat-small, avec peu d’exemples | 0,970 | 116,1 | 1 708 | enregistré |
| Jev (TypeSafe AI) | non mesuré | non mesuré | 70–500 | affirmation du fournisseur, tirée de son article (septembre 2026) |
La ligne dit la vérité : personne ne sait où Jev se situe pour cette boîte de réception. Ce ne peut être la « meilleure » ligne, ni la « pire ». Pour obtenir de vrais chiffres, il faut ses réponses aux messages de validation et de test. Il passe ensuite par les mêmes colonnes que tous les autres.
Ajouter un nouveau modèle comme ligne supplémentaire
Section intitulée « Ajouter un nouveau modèle comme ligne supplémentaire »Votre projet peut déjà évaluer un modèle qu’il ne peut pas exécuter. Les méthodes enregistrées des modules 4 et 5 ne sont que des fichiers. Chaque méthode a un fichier CSV et un fichier JSON dans data/predictions/. route compare lit chaque paire qu’il y trouve. Un nouveau modèle n’a donc besoin d’aucun nouveau code. Il a besoin de ses réponses.
-
Dans votre dossier de projet
larkroute, avec.venvactif, évaluez chaque méthode sur les messages de test. Cela prend environ 10 secondes :Fenêtre de terminal route compareLa commande affiche une ligne par méthode pendant l’évaluation, puis un tableau de 15 lignes, les moins coûteuses en premier. Le tableau commence ainsi (la colonne
ms/msg, millisecondes par message, varie légèrement d’une exécution à l’autre) :method accuracy macro-F1 takeover needs person EN FR mistakes $/1k run $/1k total $/1k ms/msgfine-tuned MiniLM-L12 multilingual encoder 0.980 0.980 1.000 1.000 0.980 0.978 103.0 0.000 103.0 6.73hosted LLM chat-small, few-shot (recorded) 0.970 0.962 1.000 1.000 0.973 0.961 116.0 0.088 116.1 1708.00TF-IDF + linear SVM 0.966 0.969 1.000 1.000 0.971 0.954 175.0 0.000 175.0 0.12 -
Regardez comment une méthode enregistrée est stockée : sa description, puis ses deux premières réponses.
Fenêtre de terminal cat data/predictions/llm-few-shot.jsonhead -3 data/predictions/llm-few-shot.csvFenêtre de terminal Get-Content data\predictions\llm-few-shot.jsonGet-Content data\predictions\llm-few-shot.csv -TotalCount 3{"method": "hosted LLM chat-small, few-shot (recorded)","label": "recorded","model": "chat-small (gpt-6-luna-2026-09-22)","ms_per_message": 1708.0,"run_per_1000": 0.0876,"messages": 4000,"notes": "Recorded once from the Azure deployment chat-small (reasoning effort none); replayed. The confidence is the number the model wrote, not a probability."}message_id,prediction,confidenceM-100006,delivery,0.99M-100010,product,0.99
Pour ajouter un nouveau modèle, vous écririez les mêmes deux fichiers. Ils contiennent une réponse par message de validation et de test, le temps par message que vous avez mesuré et le coût d’exécution par 1 000 messages. Un modèle de décision donne aussi une probabilité par destination. Ajoutez les colonnes de p_orders à p_needs_person, comme dans data/predictions/local-llm-scores.csv. Ensuite, route compare l’évalue comme toutes les autres lignes. Cette leçon n’ajoute aucun nouveau modèle : le cours n’a aucune réponse de Jev.
Quand un modèle de décision spécialisé est pertinent
Section intitulée « Quand un modèle de décision spécialisé est pertinent »Envisagez-en un si vous avez besoin de décisions typées à grande échelle, avec une probabilité. Le LLM hébergé doit aussi être trop lent ou trop coûteux à appeler. Envisagez-en aussi un si vous ne pouvez pas entraîner votre modèle : aucune étiquette, ou personne pour exploiter un modèle.
Soyez prudent si vous avez déjà des étiquettes et un modèle entraîné qui fonctionne. Pour cette boîte de réception, l’encodeur réglé finement décide en 6,7 ms sur un ordinateur portable. Son exécution est gratuite, et il fait peu d’erreurs. Un modèle fermé doit faire mieux sur vos données de test, et vous acceptez aussi la dépendance au fournisseur. Soyez aussi prudent avec les messages sensibles : un modèle hébergé voit chaque message que vous lui envoyez.
À vous de jouer : appliquer la liste de vérification à GLiClass
Section intitulée « À vous de jouer : appliquer la liste de vérification à GLiClass »GLiClass est aussi un modèle conçu uniquement pour la classification. Comme un modèle de décision, il attribue une probabilité à chaque nom d’étiquette et n’écrit aucun texte. Ses fabricants le décrivent comme un classificateur zéro exemple : il n’a besoin d’aucune étiquette d’entraînement. Utilisez la liste de vérification et les chiffres du cours pour répondre : Larkfield devrait-elle l’utiliser comme routeur?
Afficher la réponse
Non, pas pour cette boîte de réception. Parcourez la liste de vérification :
- Vos propres données de test : une exactitude de 0,516 et 4 431 $ US par 1 000 messages. C’est environ trois fois le coût d’une personne qui lit tout (1 500 $ US).
- L’étalonnage : son erreur d’étalonnage attendue sur les données de test est de 0,089, contre 0,050 pour TF-IDF + régression logistique. Ses probabilités correspondent moins à la réalité, et sa destination est incorrecte la moitié du temps.
- Le temps : 21 ms par message sur le processeur d’un ordinateur portable : assez rapide.
- Le prix et la dépendance au fournisseur : poids ouverts (Apache-2.0). Il fonctionne sur l’ordinateur de Larkfield sans coût par appel, et personne ne peut le lui retirer.
- Les changements : une révision fixée sur Hugging Face ne change jamais.
Il satisfait aux questions 3 à 5, mais échoue aux deux premières, les plus importantes. Son affirmation de « classification zéro exemple » est vraie; ce n’est pas suffisant ici. Il reste utile pour une tâche : trouver une nouvelle destination sans réentraînement. Dans Classification zéro exemple sans LLM, il a trouvé 31 des 80 messages concernant le nouvel appareil.
Erreur courante
Plus récent, donc meilleur
Symptôme : Tomás lit qu’un nouveau modèle de plongement de 2026 bat celui de 2021 sur des bancs d’essai publics. Il le remplace sans test. Une semaine plus tard, Grace signale plus de messages dans les mauvaises files d’attente.
Cause : sur les messages de test de Larkfield, le modèle plus récent est moins bon. Il obtient 0,906 contre 0,920, et coûte 895 $ US par 1 000 messages contre 779 $ US. Chargé dans son format de stockage (bfloat16), il prenait 26,9 ms contre 6,8 ms. Chargé avec des nombres de 32 bits, il prenait 7,0 ms. Les bancs d’essai publics mesuraient d’autres tâches, sur d’autres textes. Un modèle plus récent est un candidat, pas une amélioration.
Solution : traitez chaque nouveau modèle, y compris une nouvelle version du même modèle, comme une nouvelle ligne. Évaluez-le sur les mêmes données de test et avec le même tableau des coûts. Vérifiez son étalonnage et son temps. Gardez l’ancienne ligne jusqu’à ce que la nouvelle gagne.
Conséquence dans le travail en IA : remplacer un modèle sans test cause souvent des baisses discrètes de qualité en production. Recalculer le tableau comparatif coûte peu. Une semaine de messages dans les mauvaises files coûte cher.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Le fournisseur de Jev annonce 0 % d'erreurs de type. Expliquez pourquoi ce n'est pas l'exactitude, avec un exemple du cours.
Afficher la réponse
« 0 % d’erreurs de type » signifie que chaque réponse respecte le schéma : elle contient toujours une des valeurs permises. La conception du modèle le garantit, mais cela ne dit rien sur la justesse de la valeur. Dans ce cours, Qwen3-0.6B avec Outlines a donné un nom de destination valide pour 100 % des 500 messages de test. Il a donné la bonne destination pour seulement 12,8 % des messages. Une réponse valide n’est pas une réponse juste. Seul un test sur vos propres messages étiquetés mesure l’exactitude.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Un fournisseur dit que son modèle est bien étalonné et répond en 70 à 500 ms. Quelles sont les deux vérifications de la liste qui testent ces affirmations, et que mesurez-vous exactement?
Afficher la réponse
L’étalonnage sur vos données. Exécutez le modèle sur vos messages de validation ou de test, puis regroupez les réponses selon leur probabilité. Dans chaque groupe, comparez la probabilité moyenne à la proportion de réponses justes : c’est un tableau de fiabilité. Calculez ensuite l’erreur d’étalonnage attendue. Le temps de réponse depuis votre emplacement. Envoyez vos propres messages depuis vos propres serveurs. Mesurez le temps médian et les 10 % de requêtes les plus lentes, aux heures normales et de forte activité. Le fournisseur a pris ses mesures depuis ses propres ordinateurs portables.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : votre projet évalue des méthodes enregistrées qu'il ne peut pas exécuter. Où sont-elles? Que faut-il pour ajouter un nouveau modèle comme ligne supplémentaire dans route compare?
Afficher la réponse
Elles sont dans data/predictions/, avec un fichier CSV et un fichier JSON par méthode. Le CSV contient une ligne par message de validation et de test : message_id, prediction, confidence. Pour un modèle avec des probabilités, il contient aussi les colonnes p_orders à p_needs_person. Le fichier JSON donne le nom de la méthode et indique comment ses réponses ont été produites. Il donne aussi le temps mesuré en millisecondes par message et le coût d’exécution par 1 000 messages. Avec ces deux fichiers, route compare évalue le nouveau modèle avec les mêmes données de test et le même tableau des coûts que les autres lignes.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un modèle de décision spécialisé renvoie une valeur d’une liste fixe (le schéma), avec une probabilité, sans écrire de texte.
- Jev (TypeSafe AI, annoncé en septembre 2026, en accès anticipé) en est un exemple. Sa vitesse, son prix et son étalonnage sont des affirmations du fournisseur : le cours ne les a pas mesurés. Sa ligne indique donc « non mesuré ».
- « 0 % d’erreurs de type » n’est pas l’exactitude. Outlines a donné 100 % de réponses valides et 12,8 % de réponses justes.
- La liste de vérification : vos propres données de test, l’étalonnage sur vos données, le temps de réponse depuis votre emplacement, le prix et la dépendance au fournisseur, et ce qui arrive quand le fournisseur change le modèle.
- Un nouveau modèle s’ajoute au projet sous forme de deux fichiers dans
data/predictions/.route comparel’évalue comme toutes les autres lignes.
Vous pouvez maintenant juger tout modèle selon ses résultats sur vos messages. Mais le tableau comparatif vous demande encore de choisir un seul routeur. Ensuite, vous les combinez : le modèle peu coûteux décide quand il est sûr, le LLM reçoit les messages incertains. Une personne reçoit le reste.
Leçon suivante : Les cascades