
Règles par mots-clés et expressions régulières
- Leçon 9
- 35 min
- Module 3 : Références de base : règles et modèles classiques
Où nous en sommes
Nos étiquettes sont maintenant assez bonnes pour servir à l'apprentissage. Avant d'entraîner un modèle, nous essayons la solution la plus simple : des règles écrites par une personne. Dans cette leçon, nous écrivons des règles par mots-clés et des expressions régulières. Nous voyons où elles sont le meilleur outil et comment elles échouent.
Leçon 9 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitRègles par mots-clés et expressions régulières
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Écrivez des règles par mots-clés que les gens peuvent lire et modifier. Mesurez leur coût avant de leur faire confiance. Un ensemble de règles qui traite trois messages sur quatre peut coûter plus cher qu’une personne qui lit chaque message.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient toutes les cellules de code, les tâches et les vérifications de cette leçon. Il écrit deux expressions régulières et exécute les 11 règles de Larkfield sur les 2 000 messages de test. Il répartit leur coût par type d’erreur et vous demande d’ajouter une règle. Ses cellules de préparation installent pandas et scikit-learn et téléchargent les données d’exercice. Aucune préparation locale n’est donc nécessaire. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les sept destinations et le guide d’étiquetage, dans Guide d’étiquetage.
- Le tableau des coûts, dans Le coût de chaque erreur. Une révision coûte 1,50 $ US et une mauvaise file d’attente, 4 $ US. Un message urgent dans une mauvaise file coûte 20 $ US, et une prise de contrôle de compte manquée, 200 $ US.
- Les données de test : 2 000 messages dont aucune méthode ne tire d’apprentissage, dans Découvrir la boîte de réception.
Ce qu’il vous faut sur votre ordinateur (seulement pour l’étape du projet; le carnet n’en a pas besoin)
- Votre dossier de projet
larkrouteà l’état du dernier module, avec son.venvactif.python -m pytest -qaffiche12 passed(12 tests réussis). - Le dépôt d’exercices
nextia-learning-labsà côté de votre dossier de projet, comme dans Le projet sur votre ordinateur.
Testé sur macOS avec Python 3.12, pandas 3.1.1 et scikit-learn 1.9.1. Les commandes Windows n’ont pas été testées.
Une fiche de tri au bureau de poste
Section intitulée « Une fiche de tri au bureau de poste »Imaginez une nouvelle commis dans un bureau de poste. Le premier jour, elle reçoit une petite fiche avec des règles de tri. « Une lettre avec un timbre express va dans le sac rouge. Une lettre pour la France va dans le sac bleu. Un colis de plus de 2 kg va sur l’étagère. » Elle lit chaque lettre, trouve la première règle qui convient et met la lettre dans ce sac. Une lettre qui ne correspond à aucune règle va à sa gestionnaire.
La fiche est un bon départ. Tout le monde peut la lire et la modifier en une minute. Personne n’a besoin d’un modèle ni d’une semaine de formation.
Mais un matin, une lettre arrive pour « Paris, Texas ». La fiche dit « Paris va en France ». La lettre va donc dans le sac bleu et part vers le mauvais pays. La règle a vu le mot. Elle n’a pas compris l’adresse.
Le problème : un mot n’est pas une demande
Section intitulée « Le problème : un mot n’est pas une demande »La boîte de réception du soutien de Larkfield a le même problème. Un client écrit :
“Can I return the storage box if I don’t like the colour? Just checking.”
Le mot « return » est là. Mais le client n’a encore rien acheté. Selon le guide d’étiquetage, une question sur la politique de retour avant l’achat va à l’équipe product (produits). Vous avez rencontré ce piège dans Un message dans la mauvaise file, avec la règle rapide de Tomás. Cette leçon le mesure sur toutes les données de test.
Une personne lit le message entier et comprend la demande. Une règle ne voit que les mots de son motif. Avant de créer un modèle, nous devons donc connaître les capacités des règles simples et le coût de leurs erreurs.
L’idée : des règles par mots-clés et des expressions régulières
Section intitulée « L’idée : des règles par mots-clés et des expressions régulières »Une règle par mots-clés dit : « si le message contient ces mots, envoyez-le à cette destination ». C’est la fiche de la commis, écrite pour un ordinateur. Chaque règle a une destination, une liste de mots et une raison qu’une personne peut lire.
Pour écrire la liste de mots, nous utilisons une expression régulière, ou regex en abrégé. Une regex est un petit langage de motifs pour le texte. Le nom vient des mathématiques, où « régulier » décrit ce genre de motif simple. Le module re de Python trouve une regex dans une chaîne de caractères. Trois éléments suffisent pour cette leçon :
| Élément | Signification | Exemple | Correspondances |
|---|---|---|---|
\b |
une limite de mot : le début ou la fin d’un mot | \bcard\b |
« card », pas « discard » |
\d{6} |
six chiffres | LK-\d{6} |
« LK-123456 » |
(a|b) et \w* |
a ou b; puis n’importe quelles lettres |
(refund\w*|return\w*) |
« refund », « refunded », « returning » |
L’option re.IGNORECASE fait ignorer les majuscules et les minuscules au motif. « Refund » correspond donc aussi.
Un petit exemple : trois messages, deux motifs
Section intitulée « Un petit exemple : trois messages, deux motifs »Voici deux motifs. Le premier trouve un numéro de commande Larkfield : \bLK-\d{6}\b. Le second est une règle de remboursement : \b(refund\w*|return\w*)\b. Nous les essayons sur trois courts messages :
import re
samples = ["Where is order LK-123456? Tracking has not moved.",           "I sent the chair back. When is my refund coming?",           "Can I return the bench if I don't like the colour?"]for text in samples:    order = re.search(r"\bLK-\d{6}\b", text)    refund = re.search(r"\b(refund\w*|return\w*)\b", text, re.IGNORECASE)    print(order.group(0) if order else "-", "|", refund.group(0) if refund else "-", "|", text)
La sortie :
LK-123456 | - | Where is order LK-123456? Tracking has not moved.- | refund | I sent the chair back. When is my refund coming?- | return | Can I return the bench if I don't like the colour?Le motif de numéro de commande est parfait : il trouve le numéro, et rien d’autre. Le motif de remboursement convient au deuxième message. Pour le troisième, il trouve « return », et la destination serait mauvaise. Le motif a fait exactement son travail. C’est le travail demandé qui était mauvais.
Toute la leçon porte sur cette différence. Un motif est excellent pour trouver une forme : un numéro de commande, un code de produit, une expression exacte. Il est faible pour comprendre une demande, car les mêmes mots apparaissent dans de nombreuses demandes.
L’ensemble de règles de Larkfield
Section intitulée « L’ensemble de règles de Larkfield »Priya et Grace ont écrit 11 règles dans config/rules.json, le fichier présent dans le projet depuis le début. Chaque règle a une destination, un motif, une raison (why) et un indicateur strong (fort). Grace a marqué comme fortes les quatre règles auxquelles elle fait le plus confiance. Elles concernent les menaces juridiques, les problèmes de sécurité, un compte utilisé par quelqu’un d’autre et une double facturation. La dernière leçon de ce module utilise cet indicateur.
Les règles s’exécutent dans l’ordre. La première règle qui correspond décide de la destination. Un message qui ne correspond à aucune règle va à une personne, qui le lit et le transmet. Le projet appelle cette méthode règles ou une personne.
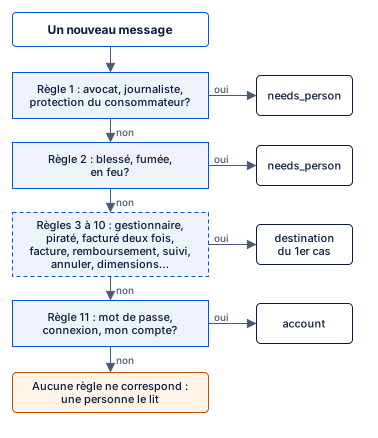
Description textuelle du diagramme
Le schéma est une échelle de haut en bas. Un nouveau message arrive à la règle 1 : contient-il avocat, journaliste ou protection du consommateur? Si oui, la destination est needs_person (besoin d’une personne). Sinon, le message descend à la règle 2 : blessure, fumée ou en feu? Si oui, la destination est needs_person. Sinon, il descend à travers les règles 3 à 10. Elles cherchent des mots comme gestionnaire, piratage, double facturation, facture, remboursement, suivi, annulation et dimensions. La première qui correspond donne sa destination. Si aucune ne correspond, le message atteint la règle 11 : mot de passe, connexion ou mon compte. Si oui, la destination est account (compte). Si aucune règle ne correspond, une personne lit le message.
L’ordre compte. Prenez un message qui dit « I was charged twice, and I want to return the chair » (on m’a facturé deux fois, et je veux retourner la chaise). Il correspond d’abord à la règle de double facturation. Il va donc à billing (facturation), même si le retour est la demande principale. Monter ou descendre une règle change la destination de nombreux messages.
Exécutez les règles sur les messages de test
Section intitulée « Exécutez les règles sur les messages de test »Priya exécute l’ensemble de règles sur les 2 000 messages de test. Dans le carnet, first_match() renvoie la première règle qui correspond, ou None (aucune) :
hits = [first_match(t, rules) for t in test["text"]]rule_pred = [h["route"] if h else "review" for h in hits]matched = np.array([h is not None for h in hits])right = np.array(rule_pred) == test["route"].to_numpy()print("matched by a rule:", matched.sum(), "of", len(test), "- share", np.round(matched.mean(), 3))print("right when a rule matched:", right[matched].sum(), "- share", np.round(right[matched].mean(), 3))print("sent to a person:", (~matched).sum())La sortie :
matched by a rule: 1527 of 2000 - share 0.764right when a rule matched: 1110 - share 0.727sent to a person: 473Deux mots nomment ces nombres. La couverture est la part des messages dont une règle décide la destination : 76,4 %. La précision est la part de ces décisions qui sont bonnes : 72,7 %. Les règles décident donc pour trois messages sur quatre. Environ trois de ces quatre décisions sont bonnes.
Tomás est content. « Les trois quarts de la boîte de réception, sans modèle et sans entraînement. Mettons ça en production. » Grace pose la question du module 1 : « Combien ça coûte? »
Ce que coûtent les règles
Section intitulée « Ce que coûtent les règles »rt.score() évalue une méthode avec les mêmes colonnes et le même tableau des coûts que route compare. Priya évalue « tout à une personne », la méthode actuelle de Larkfield, et les règles :
method accuracy macro_f1 ... total_per_10000 everything to a person 0.000 0.000 ... 1500.01 rules or a person 0.555 0.625 ... 1757.8Les règles coûtent 1 757,8 $ US par 1 000 messages. Une personne qui lit chaque message coûte 1 500 $ US. L’ensemble de règles qui « traite les trois quarts de la boîte de réception » coûte plus cher que l’absence d’automatisation.
Pour comprendre pourquoi, Priya classe chaque message de test dans un groupe du tableau des coûts. Elle additionne les dollars par groupe :

Description textuelle du diagramme
Le graphique a deux colonnes, en dollars US par 1 000 messages de test. La colonne de gauche, tout à une personne, forme un bloc de 1 500 : une personne lit les 2 000 messages. La colonne de droite, règles ou une personne, comporte six blocs et atteint 1 757,8. Elle dépasse une ligne rouge pointillée à 1 500. À partir du bas, les blocs sont :
- 354,75 $ US pour les 473 messages qui ne correspondent à aucune règle et qu’une personne lit;
- 634 pour 317 messages dans une mauvaise file;
- 460 pour 46 messages urgents dans une mauvaise file;
- 200 pour 2 prises de contrôle de compte manquées;
- 60 pour 3 messages
needs_personenvoyés à une équipe; - 49 pour 49 messages d’équipe envoyés à
needs_person.
Les révisions coûtent 354,75 $ US par 1 000 messages. Cette part coûte peu, car une révision ne coûte que 1,50 $ US. La part coûteuse est celle des 417 messages qu’une règle envoie à une mauvaise destination (20,9 % des données de test). Une mauvaise file coûte 4 $ US, un message urgent mal dirigé, 20 $ US, et une prise de contrôle manquée, 200 $ US. Même l’erreur la moins chère, un message d’équipe envoyé à needs_person, coûte 2 $ US : plus qu’une révision. Ensemble, les mauvaises décisions coûtent 1 403 $ US par 1 000 messages : presque autant que la lecture de tous les messages.
La couverture n’était donc pas le bon nombre à examiner. Une règle qui décide mal est pire que l’absence de règle. Une personne aurait lu ce message pour 1,50 $ US.
Lisez les messages que les règles ont mal dirigés
Section intitulée « Lisez les messages que les règles ont mal dirigés »Les nombres disent combien. Seuls les messages disent pourquoi. Voici cinq vrais messages de test, la règle qui a retenu chacun et le mot auquel elle a correspondu :
| Message | Étiquette | Règle (destination) | Correspondance | Ce qui a mal tourné |
|---|---|---|---|---|
| M-100017: “I think someone got into my account… a new order, which definitely wasn’t me. I’m also looking to return an item…” | account (prise de contrôle de compte) |
retours, remboursements (returns_refunds) |
« return » | La règle de prise de contrôle cherche « hacked » ou « didn’t order ». Ce client a écrit « wasn’t me ». La règle de retour venait ensuite. Coût : 200 $ US. |
| M-100056: “J’ai reçu le mauvais article…” | returns_refunds |
factures et reçus (billing) |
« reçu » | En français, reçu désigne un document et signifie aussi qu’on a reçu quelque chose. |
| M-100318: “…j’ai pas trouvé ses dimensions. Vous pouvez me les donner? Le remboursement, ça n’a rien à voir” | product |
retours, remboursements (returns_refunds) |
« remboursement » | Le client a dit « pas un remboursement ». Une règle ne peut pas lire « pas ». |
| M-100516: “…the smoker box can’t arrive that day. Please arrange delivery for another day…” | delivery (livraison) |
un problème de sécurité (needs_person) |
« smoker » | Une boîte de fumage est un produit Larkfield. Le motif pour la fumée le retient. |
| M-100053: “I would like to return order LK-195050… Separately, I was charged twice…” | returns_refunds |
une double facturation (billing) |
« charged twice » | La demande principale vient d’abord; la règle de double facturation est plus haute dans l’ensemble de règles. |
Chaque règle a correspondu à un vrai mot, et chaque destination est mauvaise. Le mot reçu décide à lui seul pour 60 messages de test. Seulement 8 concernent la facturation. Chaque fois, une personne comprendrait immédiatement la demande.
Une règle qui ne se déclenche presque jamais
Section intitulée « Une règle qui ne se déclenche presque jamais »Les règles échouent aussi de façon plus discrète : elles manquent des cas. La règle de prise de contrôle cherche didn'?t (make|place|order), avec une apostrophe droite ('). Les téléphones et les logiciels de traitement de texte écrivent souvent une apostrophe courbe (’). Dans les données de test, 1 396 messages utilisent l’apostrophe courbe, et seulement 78 utilisent la droite. « an order that I didn’t make » ne correspond donc pas. La règle de prise de contrôle décide pour seulement 3 messages de test.
Priya essaie la correction évidente, didn['’]?t, qui accepte les deux apostrophes. La règle correspond maintenant à 18 messages de test et trouve 6 des 12 prises de contrôle de compte. Mais 12 des 18 messages ont une autre demande principale. Par exemple : “How do I return the sun lounger? I changed my mind. Order LK-121497. Also, I noticed an order I didn’t make on my account.” Le client mentionne le compte à la fin. L’étiquette suit la première demande, un retour. Chaque correction crée une nouvelle possibilité d’erreur. Aucun message d’erreur n’a signalé le problème d’apostrophe; seule la lecture des messages l’a révélé.
Erreur courante
Règles ou une personne coûte plus cher qu'une personne
Symptôme : les règles correspondent à 76,4 % des messages de test. Un examen rapide de quelques correspondances semble satisfaisant. Tomás veut envoyer chaque message correspondant directement à son équipe.
Cause : la couverture compte les décisions, pas les bonnes décisions. Les 417 mauvaises correspondances vont à une mauvaise destination sans avertissement. Chacune coûte plus qu’une révision.
Correction : évaluez chaque méthode avec le tableau des coûts avant de l’utiliser, et non avec la couverture. Utilisez route compare ou rt.score(). Ils regroupent le coût de révision et celui de chaque type d’erreur en un seul nombre. Gardez les règles pour les tâches précises ci-dessous, où elles se trompent rarement.
Conséquence dans le travail en IA : une équipe met en production un ensemble de règles parce qu’il « traite presque toute la boîte de réception ». Les mauvaises files se manifestent plus tard par des réponses lentes. Personne ne fait le lien avec les règles. Ici, les règles coûtent 257,8 $ US de plus par 1 000 messages que l’absence d’automatisation.
Où les règles sont le meilleur outil
Section intitulée « Où les règles sont le meilleur outil »Les règles ont échoué comme routeur ici. Elles restent le meilleur outil pour certaines tâches : elles sont exactes, rapides, gratuites à exécuter et faciles à lire.
- Trouver une forme. Un numéro de commande (
LK-\d{6}), un code de produit, une adresse courriel ou une date a une forme fixe. Une regex la trouve sans erreur. L’équipe qui reçoit le message peut utiliser le numéro de commande immédiatement. - Des expressions exactes au sens clair. « Charged twice » signifie presque toujours une double facturation. Une règle pour cette expression est un bon indicateur pour une personne ou un modèle. Elle ne donne pas nécessairement une bonne destination finale.
- Une première version dès le premier jour. Un nouveau produit n’a pas encore de messages étiquetés. Une règle sur son nom peut envoyer ses messages à une destination raisonnable, en attendant des étiquettes pour l’apprentissage.
- Un test de comportement connu. Un ensemble de règles est facile à tester : « ce message doit correspondre à cette règle ». Les tests du projet le font, comme vous le voyez ci-dessous.
Les règles font un mauvais routeur quand les mêmes mots apparaissent dans de nombreuses demandes. C’est le cas de « return », « refund » et « account » ici. Chaque nouvelle règle ajoute aussi du travail. Quelqu’un doit lire les erreurs et vérifier qu’une correction pour un message ne nuit pas aux autres. Avec 300 règles écrites par cinq personnes, personne ne sait pourquoi un message a pris une destination donnée. Le coût des règles est donc le temps des gens. Le temps de calcul est négligeable : environ 0,03 milliseconde par message.
Exercice guidé : exécuter l’ensemble de règles
Section intitulée « Exercice guidé : exécuter l’ensemble de règles »- Ouvrez le carnet depuis l’encadré Faites cette leçon dans un carnet Jupyter en haut de cette page.
- Exécutez les cellules de configuration. La cellule de données se termine par
Ready: 10000 messages (6000 train, 2000 validation, 2000 test), all synthetic.(prêt : 10 000 messages, dont 6 000 d’entraînement, 2 000 de validation et 2 000 de test, tous synthétiques). - Dans la section 1, prédisez quel message contient un numéro de commande. Exécutez ensuite la cellule. Seul le premier message contient
LK-123456. - Dans la section 2, exécutez la cellule. Vous voyez les 11 règles de l’ensemble.
- Dans la section 3, écrivez votre prédiction de la couverture. Exécutez ensuite la cellule. Vous voyez
1527 of 2000(1 527 sur 2 000) et une proportion de0.764. - Exécutez la cellule de calcul du coût. Les règles coûtent
1757.8; tout transférer à une personne coûte1500.0. - Dans la section 4, exécutez la cellule. La ligne la plus élevée est
wrong queue(mauvaise file), avec634.00par 1 000. - Dans la section 5, lisez les cinq messages et le mot auquel chaque règle a correspondu.
- Dans la section 6, exécutez la cellule. Vous voyez
60messages envoyés à la facturation à cause de reçu.
Ajoutez maintenant les tests de l’ensemble de règles à votre projet. Ils vérifient que les messages clairs déclenchent la bonne règle. Ils consignent aussi une faiblesse connue : une question avant l’achat va à returns_refunds. Un test qui consigne une faiblesse est utile. Si quelqu’un modifie les règles, le test montre si la faiblesse a changé aussi.
-
Dans votre dossier de projet
larkroute, avec.venvactif, copiez le fichier de tests depuis l’instantanéend-of-m03:Fenêtre de terminal S=../nextia-learning-labs/C36/snapshots/end-of-m03cp "$S/tests/test_rules.py" tests/Fenêtre de terminal $S = "..\nextia-learning-labs\C36\snapshots\end-of-m03"Copy-Item "$S\tests\test_rules.py" tests\ -
Ouvrez
tests/test_rules.pyet lisez les trois tests. Le deuxième s’appelletest_a_refund_word_is_not_always_a_refund_request. -
Exécutez les tests :
Fenêtre de terminal python -m pytest -qLa dernière ligne est
15 passed(15 tests réussis) : les 12 tests précédents et les 3 nouveaux. -
Exécutez à nouveau la première comparaison et trouvez la ligne des règles :
Fenêtre de terminal route compare --quickmethod accuracy macro-F1 takeover needs person EN FR mistakes $/1k run $/1k total $/1k ms/msgTF-IDF + logistic regression 0.962 0.965 0.917 1.000 0.966 0.952 296.0 0.0 296.0 0.12everything to a person 0.000 0.000 0.000 0.000 0.000 0.000 1500.0 0.0 1500.0 0.00rules or a person 0.555 0.625 0.833 0.818 0.577 0.503 1757.8 0.0 1757.8 0.03Les règles occupent la dernière ligne : c’est la méthode de routage la plus coûteuse ici. La colonne
ms/msg(millisecondes par message) varie un peu d’une exécution à l’autre.
À vous : une règle pour les questions avant l’achat
Section intitulée « À vous : une règle pour les questions avant l’achat »La règle de remboursement envoie les questions avant l’achat à returns_refunds. Dans les données de test, 36 des 144 questions sur les produits mentionnent un retour ou un remboursement. Les règles en envoient 32 à returns_refunds. Priya écrit une règle pour ces questions :
policy = {"route": "product", "strong": False, "why": "a question before buying", "pattern": r"\b(can i return|may i return|if i (buy|get|order)|before i (buy|order|decide)|je peux le retourner|si je (l'achète|commande))\b"}Où faut-il la placer dans l’ensemble de règles, et pourquoi à cet endroit? Avant toute exécution, prédisez : le coût passera-t-il sous 1 500 $ US? Dans la section 7 du carnet, créez fixed_rules : une copie de rules avec policy inséré juste avant la première règle returns_refunds. La cellule suivante calcule le coût des deux ensembles de règles sur les messages de validation.
Afficher la réponse
policy["regex"] = re.compile(policy["pattern"], re.IGNORECASE)at = next(i for i, r in enumerate(rules) if r["route"] == "returns_refunds")fixed_rules = rules[:at] + [policy] + rules[at:]before validation cost per 1,000: 1677.0after validation cost per 1,000: 1660.2La règle doit venir avant la règle de remboursement. La première règle qui correspond décide. Placée après la règle de remboursement, elle ne s’exécuterait donc jamais. Elle économise 16,8 $ US par 1 000 messages de validation. Le ensemble de règles coûte encore plus qu’une personne qui lit tout. Une règle corrige un type de message. Les 417 mauvaises décisions ont de nombreuses causes différentes.
Pourquoi la validation, et non le test? Vous avez écrit cette règle après avoir lu les messages de test. Si vous l’évaluez aussi sur ces messages, vous l’évaluez sur les messages pour lesquels vous l’avez écrite. Le score est alors trop bon. Les données de validation contiennent des messages qui n’ont pas servi à écrire la règle. Données d’entraînement, de validation et de test, dans le cours d’apprentissage automatique, explique cette règle en détail.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Les règles décident pour 76,4 % des messages de test, et 72,7 % de ces décisions sont correctes. Une personne qui lit tout coûte 1 500 $ US par 1 000 messages. Expliquez comment les règles peuvent coûter plus cher (1 757,8 $ US).
Afficher la réponse
Les révisions coûtent peu : les 473 messages auxquels aucune règle ne correspond coûtent 1,50 $ US chacun, soit 354,75 $ US par 1 000. Ce sont les mauvaises décisions qui coûtent cher. Les règles envoient 417 messages à une mauvaise destination, et chacun coûte plus qu’une révision. La plupart coûtent 4 $ US, un message urgent coûte 20 $ US, et chaque prise de contrôle de compte manquée coûte 200 $ US. Il y en a deux. Les mauvaises décisions ajoutent environ 1 403 $ US par 1 000. Une mauvaise décision automatique est pire qu’une révision. Une couverture élevée avec une précision de 72,7 % fait donc perdre de l’argent. Évaluez une méthode selon son coût, pas selon sa couverture.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : la règle de remboursement rencontre le message français « je regardais votre corner sofa… j'ai pas trouvé ses dimensions… Le remboursement, ça n'a rien à voir ». Quelle destination la règle choisit-elle, et pourquoi une personne en choisirait-elle une autre?
Afficher la réponse
La règle choisit returns_refunds, car le motif rembours\w* correspond à « remboursement ». Un motif voit les mots, pas leur sens. Il ne peut donc pas interpréter « ça n’a rien à voir ». Une personne lit la demande : le client veut connaître les dimensions d’un produit, donc la destination est product. Il s’agit du message M-100318 des données de test. C’est la première règle du guide : étiquetez la demande, pas les mots.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Nommez deux tâches pour lesquelles une expression régulière est le bon outil chez Larkfield, et une pour laquelle elle ne convient pas. Donnez une raison pour chacune.
Afficher la réponse
Bon outil : trouver le numéro de commande avec \bLK-\d{6}\b, car sa forme est fixe et une expression régulière le trouve sans erreur. Bon outil : signaler une expression exacte au sens clair, comme « charged twice » (facturé deux fois), pour une personne ou un modèle. Une règle pour le nom d’un nouveau produit convient aussi durant les premiers jours, avant que des étiquettes existent. Mauvais outil : choisir la destination à partir de mots comme « return » (retour), « refund » (remboursement) ou « account » (compte). Les mêmes mots apparaissent dans de nombreuses demandes différentes. Dans cette boîte de réception, les règles envoient 417 messages de test à la mauvaise équipe.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une règle par mots-clés envoie un message à une destination quand son motif correspond. Une expression régulière décrit le motif :
\bpour une limite de mot,\d{6}pour six chiffres,(a|b)pour un choix. - Les 11 règles de Larkfield décident pour 76,4 % des messages de test (couverture), et 72,7 % de ces décisions sont correctes (précision). La première règle qui correspond décide, donc l’ordre des règles compte.
- Règles ou personne coûte 1 757,8 $ US par 1 000 messages, plus qu’une personne qui lit tout (1 500 $ US). Les 417 mauvaises décisions coûtent plus que toutes les révisions.
- Un mot n’est pas une demande : « return » avant l’achat, reçu au sens de « réceptionné », « not a refund » (pas un remboursement), une boîte de fumage. Un motif ne peut pas interpréter le sens.
- Les règles sont le meilleur outil pour trouver une forme (numéros de commande, codes), signaler des éléments et créer une première version sans étiquettes. Évaluez chaque méthode selon son coût.
Vous pouvez maintenant écrire des règles et mesurer leur coût. Mais une règle ne lit que les mots qu’une personne a choisis pour elle. Ensuite, nous transformons chaque message en nombres, pour qu’un modèle puisse choisir lui-même les mots utiles.
Leçon suivante : Le texte en nombres : sac de mots et TF-IDF