
La distillation : laisser le LLM enseigner à un modèle bon marché
- Leçon 27
- 35 min
- Module 6 : Modèles de décision, cascades et distillation
Où nous en sommes
Notre cascade appelle encore le LLM pour certains messages. Une autre approche consiste à le laisser enseigner une fois à un modèle peu coûteux. Dans cette leçon, le LLM étiquette 5 000 messages. Nous vérifions un échantillon à la main, puis entraînons un modèle peu coûteux sur ces étiquettes.
Leçon 27 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitLa distillation : laisser le LLM enseigner à un modèle bon marché
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Laissez un LLM étiqueter vos messages une fois, puis entraînez un modèle peu coûteux sur ces étiquettes. Ce modèle assure ensuite le routage rapidement, pour presque rien, sans envoyer les messages à l’extérieur. Vous devez aussi vérifier ce qu’il a copié de son modèle enseignant.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient toutes les cellules de code, les tâches et les vérifications de cette leçon. Il réutilise les 5 000 étiquettes enregistrées du LLM et vérifie un échantillon de 200. Ensuite, il entraîne le modèle élève et un modèle sur des étiquettes humaines, puis trouve les erreurs copiées par l’élève. Ses cellules de préparation installent pandas et scikit-learn et téléchargent les données d’exercice. Vous n’avez donc besoin ni de configuration locale ni de clé. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- TF-IDF + régression logistique, dans Bayes naïf, régression logistique et SVM linéaire.
- Les étiquettes bruitées et leurs effets sur un modèle, dans Trouver les étiquettes bruitées.
- Le LLM comme classificateur, dans Classification zéro exemple avec un LLM.
Ce qu’il vous faut sur votre ordinateur
Rien pour cette leçon; le carnet s’exécute dans Colab ou Kaggle. Cette leçon ne modifie pas le projet.
Un nouveau commis apprend de l’experte
Section intitulée « Un nouveau commis apprend de l’experte »Retournons au bureau de poste. L’experte du tri travaille bien, mais lentement. Le bureau ne peut pas lui confier chaque lettre. Un nouveau commis s’assoit donc à côté d’elle pendant une semaine. Il la regarde trier des milliers de lettres et note où chacune est allée. Après cette semaine, il trie seul, et il est rapide.
Il a appris ses bonnes habitudes. Il a aussi appris ses mauvaises habitudes. L’experte met toujours les magazines de jardinage dans le mauvais sac. Le nouveau commis fait maintenant la même chose. Personne ne le remarque, parce qu’il fait exactement comme l’experte.
Le problème : le LLM est bon, mais les appels répétés coûtent cher
Section intitulée « Le problème : le LLM est bon, mais les appels répétés coûtent cher »Dans la dernière leçon, la cascade envoie encore 14,1 % des messages de Larkfield au LLM. Pour Larkfield, la dépense est faible. Les autres coûts ne le sont pas :
- Vitesse. Le LLM prend environ 1,7 seconde par message (la médiane); TF-IDF prend environ 0,1 milliseconde.
- Vie privée. Chaque message envoyé au LLM quitte les ordinateurs de Larkfield. Certains clients et certains contrats ne le permettent pas.
- Limites et pannes. Un fournisseur n’accepte qu’un certain nombre d’appels par minute, et il est parfois en panne.
Un modèle peu coûteux évite ces trois problèmes, mais il a besoin d’étiquettes pour apprendre. Obtenir des étiquettes humaines prend du temps. Selon le tableau des coûts du cours, une personne prend environ une minute par message. Ainsi, 5 000 étiquettes demandent environ 83 heures à Chloé : deux semaines de travail, pour environ 2 300 $ US. C’est une estimation fondée sur l’hypothèse du tableau des coûts, pas une mesure.
Le LLM a étiqueté les mêmes 5 000 messages en 250 appels, pour 0,081 $ US, en quelques minutes. Pouvons-nous utiliser ses étiquettes pour entraîner le modèle peu coûteux?
L’idée : la distillation
Section intitulée « L’idée : la distillation »La distillation consiste à entraîner un modèle peu coûteux, le modèle élève, sur les réponses d’un modèle coûteux, le modèle enseignant. Le nom vient de la distillation d’une boisson : on garde la partie concentrée et on laisse le reste. Le modèle élève est beaucoup plus petit et rapide que le modèle enseignant. Il s’exécute où vous voulez.
Il existe deux formes. Dans la forme classique, le modèle élève apprend les probabilités du modèle enseignant pour chaque étiquette. Ici, le LLM hébergé donne une seule étiquette par message. Le modèle élève apprend donc ces étiquettes comme si une personne les avait écrites. C’est la forme simple, et la plus courante avec les LLM hébergés.
Le modèle élève peut être n’importe quel modèle qui apprend à partir d’étiquettes. Ici, c’est TF-IDF + régression logistique, le modèle du projet. L’encodeur réglé finement du module 4 fonctionnerait de la même façon.
Un petit exemple détaillé : cinq étiquettes du modèle enseignant
Section intitulée « Un petit exemple détaillé : cinq étiquettes du modèle enseignant »Voici cinq des 5 000 messages d’entraînement, avec l’étiquette donnée par des personnes et celle donnée par le LLM :
| Message | Personnes | LLM (sa confiance) |
|---|---|---|
M-100026 “Please cancel my order LK-817564. I don’t need it anymore.” |
orders | orders (1,0) |
M-100037 “svp, fermez mon compte et arrêtez les courriels. merci.” |
account | account (1,0) |
M-100070 “My son cut his hand on the swing seat. The edge is way too sharp.” |
needs_person | needs_person (1,0) |
M-101118 “Can I return the rug if I don’t like the colour? Just checking the refund policy.” |
product | returns_refunds (0,98) |
M-101701 “@Larkfield, we’re a café interested in ordering 20 coffee maker. Is there a business order form we can use?” |
orders | product (0,89) |
Les trois premiers sont faciles, et le LLM a raison. Les deux derniers suivent le guide de Larkfield, que le LLM n’a pas entièrement appris. Une question sur la politique de retour avant l’achat va à product (produit). Une commande d’entreprise va à orders (commandes). Les étiquettes du LLM semblent correctes, et sa confiance est élevée. Un modèle élève entraîné sur ces étiquettes apprendra que « return » avant l’achat signifie returns_refunds (retours et remboursements).
Le processus complet
Section intitulée « Le processus complet »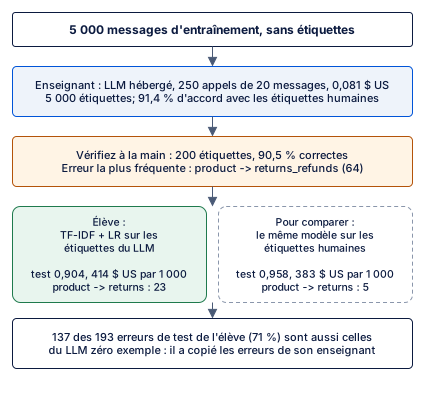
Description textuelle du diagramme
Le diagramme montre un flux de haut en bas. En haut se trouvent 5 000 messages d’entraînement, sans étiquettes. Le modèle enseignant est le LLM hébergé. Il les étiquette en 250 appels de 20 messages, pour 0,081 $ US. Ses 5 000 étiquettes correspondent aux étiquettes humaines pour 91,4 % des messages. Ensuite, une personne vérifie à la main un échantillon de 200 étiquettes : 90,5 % sont correctes. L’erreur la plus courante parmi les 5 000 est product vers returns_refunds, 64 fois. Ensuite, deux cases sont côte à côte. À gauche, le modèle élève : TF-IDF + régression logistique entraîné sur les étiquettes du LLM. Sur les messages de test, son exactitude est de 0,904 et son coût est de 414 $ US par 1 000 messages. Il envoie 23 questions sur les produits aux retours. À droite, une case en pointillés présente le même modèle, entraîné sur les étiquettes humaines des mêmes messages, pour comparer. Il obtient 0,958 et 383 $ US par 1 000. Il envoie 5 questions sur les produits aux retours. En bas : 137 des 193 erreurs de test du modèle élève, soit 71 %, sont aussi des erreurs des réponses du LLM lui-même. Le modèle élève a copié les erreurs de son modèle enseignant.
Larkfield : le LLM étiquette 5 000 messages
Section intitulée « Larkfield : le LLM étiquette 5 000 messages »Priya donne au LLM les descriptions des destinations, sans exemples. Il étiquette les 5 000 premiers messages d’entraînement, 20 par appel. Le cours a enregistré ces étiquettes une fois; vous les réutilisez donc dans le carnet.
Vérifier un échantillon à la main
Section intitulée « Vérifier un échantillon à la main »Dans un vrai projet, vous n’auriez pas d’étiquettes humaines pour ces messages. C’est pourquoi vous avez demandé au LLM. Vous vérifiez donc un échantillon aléatoire. Chloé révise 200 étiquettes du LLM : 90,5 % sont correctes. Pour cette boîte de réception, nous pouvons aussi vérifier les 5 000, car des personnes les ont déjà étiquetées : 91,4 %. L’échantillon a donné une bonne estimation.
Le résultat global cache de grandes différences entre les destinations :
Description textuelle du graphique
Un diagramme à colonnes montre la part des étiquettes du LLM qui correspondent aux étiquettes humaines pour chacune des sept destinations. Les destinations vont de la part la plus faible à la plus élevée. Commandes : 83,0 %, pour 718 messages. Produit : 86,3 %, pour 722. Facturation : 93,4 %. Retours : 93,5 %. Livraison : 93,7 %. Compte : 95,5 %. Besoin d’une personne : 98,8 %, pour 241 messages. Les colonnes des commandes et des produits sont mises en évidence.
Les destinations les plus faibles sont orders (83,0 %) et product (86,3 %). Ce sont exactement les cas de l’exemple détaillé : commandes d’entreprise et questions sur les politiques avant l’achat. Le LLM est très bon pour needs_person (besoin d’une personne), avec 98,8 %. Les mots liés à la sécurité et au droit sont clairs, peu importe le guide.
Entraîner le modèle élève et comparer
Section intitulée « Entraîner le modèle élève et comparer »Entraînez maintenant TF-IDF + régression logistique sur les 5 000 étiquettes du LLM : c’est le modèle élève. Cela prend environ 2 secondes. Pour voir le coût des erreurs d’étiquetage, entraînez aussi le même modèle sur les étiquettes humaines des mêmes 5 000 messages. Évaluez les deux sur les 2 000 messages de test, qui ont des étiquettes humaines.
| Modèle (TF-IDF + LR, 5 000 messages) | Exactitude | Prise de contrôle de compte (12) | Besoin d’une personne (99) | Coût par 1 000 |
|---|---|---|---|---|
| Sur les étiquettes humaines | 0,958 | 0,917 | 0,980 | 383 $ US |
| Sur les étiquettes du LLM (le modèle élève) | 0,904 | 1,000 | 1,000 | 414 $ US |
Le modèle élève perd 5,4 points d’exactitude. Son coût par 1 000 augmente moins : de 31 $ US. Pourquoi si peu? Le modèle élève a trouvé toutes les prises de contrôle de compte et tous les messages needs_person. Le modèle sur les étiquettes humaines a manqué une prise de contrôle (200 $ US) et deux messages needs_person (40 $ US chacun). La plupart des erreurs supplémentaires du modèle élève coûtent peu : un message normal dans la file d’attente de la mauvaise équipe, à 4 $ US.
Remarquez un autre point. Les étiquettes étaient correctes à 91,4 %, et le modèle élève a raison à 90,4 %. Il n’a pas corrigé les erreurs de son modèle enseignant. Quand les erreurs d’étiquetage sont aléatoires, un modèle arrive souvent à apprendre malgré elles. Ces erreurs sont systématiques : le même type de message reçoit chaque fois la même mauvaise étiquette. Le modèle élève apprend donc l’erreur comme une règle.
Les erreurs copiées par le modèle élève
Section intitulée « Les erreurs copiées par le modèle élève »Prenez les trois erreurs d’étiquetage les plus courantes du modèle enseignant. À quelle fréquence chaque modèle fait-il la même erreur sur les messages de test?
- Modèle élève (étiquettes du LLM)
- Même modèle sur les étiquettes humaines
Description textuelle du graphique
Un diagramme à colonnes présente deux colonnes pour chacune des trois erreurs d’étiquetage les plus courantes du modèle enseignant. Questions sur les produits envoyées aux retours : 23 messages de test pour le modèle élève, 5 pour le modèle sur les étiquettes humaines. Commandes envoyées aux produits : 25 pour le modèle élève, 2 pour le modèle sur les étiquettes humaines. Livraison envoyée aux produits : 11 pour le modèle élève, 2 pour le modèle sur les étiquettes humaines. Dans les étiquettes d’entraînement, ces erreurs apparaissent 64, 55 et 29 fois.
Le modèle élève envoie 23 questions sur les produits à returns_refunds, contre 5 pour le modèle sur les étiquettes humaines. Il envoie 25 commandes à product, contre 2. Ce sont les habitudes de son modèle enseignant.
Encore une vérification : parmi les 193 erreurs de test du modèle élève, 137 (71 %) sont aussi des erreurs des réponses zéro exemple du LLM sur les mêmes messages. Ces réponses ne sont pas exactement les étiquettes du modèle enseignant : celui-ci avait aussi les descriptions des destinations. Mais ce sont les réponses enregistrées les plus proches du même LLM sur les messages de test. Pour le modèle sur les étiquettes humaines, le chevauchement est de 64 sur 85. Le modèle élève n’a pas inventé beaucoup de nouvelles erreurs. Il a appris celles de son modèle enseignant.
Ce que la distillation apporte et ce qu’elle fait perdre
Section intitulée « Ce que la distillation apporte et ce qu’elle fait perdre »| Le LLM avec des exemples | Le modèle élève (TF-IDF sur les étiquettes du LLM) | |
|---|---|---|
| Exactitude sur le test | 0,970 | 0,904 |
| Coût par 1 000 messages | 116,1 $ US | 414 $ US |
| Temps par message | environ 1,7 s | environ 0,1 ms |
| Messages qui quittent Larkfield | chaque message, toujours | 5 000, une fois, pour créer les étiquettes |
| Appels par 1 000 messages | 1 000 | 0 |
| Coût unique | aucun | 0,081 $ US pour les étiquettes, et la vérification de 200 par une personne |
La distillation apporte de la vitesse, un coût d’exécution presque nul, aucune limite d’appels et la confidentialité après la première étape. Le modèle élève s’exécute sur l’ordinateur de Larkfield. Il perd en exactitude. Ici, le modèle élève coûte 414 $ US par 1 000 messages. TF-IDF + régression logistique coûte 296 $ US. Le même modèle sur les étiquettes humaines des mêmes 5 000 messages coûte 383 $ US. Il hérite aussi des points faibles du modèle enseignant. Personne ne les voit sans examiner les résultats par destination et par paire.
Utilisez donc la distillation quand vous avez beaucoup de messages et aucune étiquette. Elle convient quand la vitesse, la confidentialité ou le nombre d’appels comptent plus que les derniers points d’exactitude. Consacrez ensuite le temps des personnes aux points faibles du modèle enseignant. Ici, Chloé pourrait réétiqueter les 64 questions sur les produits que le LLM a envoyées aux retours. Priya pourrait aussi ajouter une ligne aux descriptions des destinations du LLM, puis recommencer l’étiquetage. Ne l’utilisez pas quand de bonnes étiquettes humaines existent déjà, comme pour cette boîte de réception. Le modèle sur les étiquettes humaines est meilleur et ne coûte pas plus cher à exécuter.
Exercice guidé : entraîner le modèle élève
Section intitulée « Exercice guidé : entraîner le modèle élève »- Ouvrez le carnet dans l’encadré Faites cette leçon dans un carnet Jupyter, en haut de cette page.
- Exécutez les cellules de préparation. La cellule de données se termine par
Ready: 10000 messages (6000 train, 2000 validation, 2000 test), all synthetic.(prêt : 10 000 messages, dont 6 000 d’entraînement, 2 000 de validation et 2 000 de test, tous synthétiques). - Dans la section 1, exécutez la cellule. Vous voyez
5000 labels, 20 messages per call, cost 0.081 dollars(5 000 étiquettes, 20 messages par appel, coût de 0,081 $ US) et un accord de0.9142. - Dans la section 2, exécutez les deux cellules. L’échantillon de 200 donne
0.905, et la paire la plus courante estproduct -> returns_refunds(produit vers retours et remboursements), avec 64 cas. - Dans la section 3, écrivez votre prédiction. Exécutez ensuite la cellule. Le modèle élève obtient
0.904, et le modèle sur les étiquettes humaines,0.958. - Dans la section 4, exécutez la cellule. Vous voyez
student 23 - model on people's labels 5(modèle élève 23 - modèle sur les étiquettes humaines 5), puis193erreurs et137communes.
À vous de jouer : garder seulement les étiquettes dont le modèle enseignant est sûr
Section intitulée « À vous de jouer : garder seulement les étiquettes dont le modèle enseignant est sûr »Le LLM a écrit une confiance pour chaque étiquette. Tomás a une idée : « Gardons seulement les étiquettes avec une confiance d’au moins 0,9. Le modèle élève apprendra alors seulement à partir de bonnes étiquettes. » Dans la section 5 du carnet, entraînez le modèle élève uniquement sur ces messages. Placez son exactitude sur le test dans sure_accuracy. Avant l’exécution, faites une prédiction : meilleure ou pire que celle du modèle élève sur les 5 000 messages?
Afficher la réponse
keep = five[five["llm_conf"] >= 0.9]m = tfidf_lr().fit(keep["text"], keep["llm_route"])row = rt.score("student, labels >= 0.9", test, m.predict(test["text"]))sure_accuracy = row["accuracy"]print(len(keep), sure_accuracy, row["total_per_1000"])4331 0.902 559.0Pire : 0,902 et 559,0 $ US par 1 000, contre 0,904 et 414 $ US sur les 5 000. Les étiquettes conservées sont plus souvent correctes : 94,6 %, contre 91,4 %. Mais le filtre retire 669 messages. Ce sont les cas difficiles, où le modèle élève a le plus besoin d’un exemple. Un modèle enseignant confiant n’est pas un modèle enseignant complet.
Erreur courante
L'échantillon indiquait 90,5 %, mais a manqué l'erreur la plus courante
Symptôme : Chloé vérifie 200 étiquettes aléatoires du LLM et trouve 19 erreurs : 90,5 % sont correctes. Priya entraîne le modèle élève, qui envoie beaucoup de questions sur les produits à returns_refunds en production. « Mais l’échantillon était bon », dit-elle.
Cause : l’échantillon a bien mesuré le taux d’erreurs : 90,5 % contre 91,4 % pour les 5 000. Il n’a pas montré où elles se trouvent. Ses 19 erreurs se répartissent entre 13 paires différentes, avec au plus 4 erreurs du même type. Aucune des 64 questions sur les produits étiquetées returns_refunds ne se trouve dans l’échantillon. Un échantillon aléatoire de 200 est un bon thermomètre, mais une mauvaise carte.
Correction : après l’échantillon aléatoire, vérifiez par destination et par paire. Examinez quelques étiquettes de chaque destination. Examinez-en davantage pour les destinations où le modèle enseignant est faible (ici, orders et product). Comparez ensuite les erreurs du modèle élève sur les messages de test aux habitudes de son modèle enseignant. C’est ce que fait la section 4 du carnet.
Conséquence dans le travail en IA : un modèle élève hérite des erreurs systématiques de son modèle enseignant, et l’exactitude globale les cache. En production, ces erreurs apparaissent alors comme un type de message toujours envoyé à la mauvaise équipe.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Les étiquettes du LLM concordent avec celles des personnes pour 91,4 % des messages. Pourtant, l'exactitude du modèle élève atteint seulement 90,4 % sur les données de test. Pourquoi n'a-t-il pas fait mieux que ses étiquettes?
Afficher la réponse
Les erreurs d’étiquetage sont systématiques, pas aléatoires. Le même type de message reçoit chaque fois la même mauvaise étiquette. Par exemple, 64 questions sur les produits concernant la politique de retour portent l’étiquette returns_refunds (retours et remboursements). Un modèle peut souvent apprendre malgré du bruit aléatoire. Mais une erreur systématique ressemble à une règle, alors le modèle élève l’apprend. Sur les données de test, le modèle élève envoie 23 questions sur les produits à returns_refunds. Le même modèle entraîné sur les étiquettes des personnes en envoie 5. Parmi ses 193 erreurs, 137 sont aussi des erreurs dans les réponses du LLM.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Larkfield doit cesser d'envoyer des messages à un fournisseur externe. Nommez les avantages et les coûts de la distillation, avec les chiffres de cette leçon.
Afficher la réponse
Elle fournit un routeur qui fonctionne sur l’ordinateur de Larkfield. Il prend environ 0,1 milliseconde par message, sans appels ni limites de débit. Après l’étiquetage unique des 5 000 messages (0,081 $ US), aucun message ne quitte Larkfield. Elle coûte de l’exactitude. Le modèle élève atteint une exactitude de 0,904 (414 $ US par 1 000 messages). Le même modèle entraîné sur les étiquettes des personnes atteint 0,958 (383 $ US). Le LLM avec des exemples atteint 0,970 (116,1 $ US). Il copie aussi les angles morts du LLM, comme les questions sur les produits envoyées aux retours. Une personne doit donc vérifier les étiquettes par destination.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : dans le carnet, combien de questions sur les produits le modèle élève envoie-t-il à returns_refunds parmi les messages de test? Et combien le modèle entraîné sur les étiquettes des personnes en envoie-t-il?
Afficher la réponse
Le modèle élève en envoie 23, et le modèle entraîné sur les étiquettes des personnes en envoie 5. Les étiquettes du modèle enseignant contenaient 64 erreurs de ce type parmi les 5 000 messages d’entraînement. Le modèle élève a appris cette erreur à partir de ces étiquettes.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- La distillation entraîne un modèle élève peu coûteux sur les étiquettes d’un modèle enseignant coûteux. Ici, le LLM hébergé a étiqueté 5 000 messages en 250 appels, pour 0,081 $ US.
- Vérifiez un échantillon aléatoire pour mesurer le taux d’erreur (200 étiquettes : 90,5 %). Puis vérifiez par destination et par paire pour repérer les erreurs. L’échantillon de 200 n’a pas révélé l’erreur la plus fréquente.
- Pour cette boîte de réception, le modèle élève atteint une exactitude de 0,904 (414 $ US par 1 000 messages). Le même modèle entraîné sur les étiquettes des personnes atteint 0,958 (383 $ US).
- Le modèle élève copie les erreurs systématiques de son modèle enseignant : 23 questions sur les produits envoyées aux retours, contre 5. Le LLM fait aussi 71 % de ses erreurs.
- La distillation apporte de la rapidité, protège la vie privée et élimine les appels; elle réduit l’exactitude. Garder seulement les étiquettes certaines du modèle enseignant a dégradé les résultats du modèle élève (0,902).
Vous pouvez maintenant choisir entre un LLM, une cascade et un modèle élève issu de la distillation. Vous pouvez aussi préciser le coût de chacun. Mais tous considéraient chaque destination comme aussi fréquente et attribuaient une seule destination à chaque message. Ensuite, vous travaillerez sur la destination rare qui coûte le plus : la prise de contrôle de compte. Elle compte seulement 44 exemples d’entraînement.
Leçon suivante : Le déséquilibre et les classes rares