
Données d'entraînement, de validation et de test
- Leçon 7
- 60 min
- Module 3 : Évaluer les modèles supervisés
Leçon 7 sur 27 · Apprentissage automatique : du problème à un modèle fiableDonnées d'entraînement, de validation et de test
1. Comprendre l'apprentissage automatique
2. Cadrer le problème de prédiction
3. Évaluer les modèles supervisés
4. Créer les premiers modèles
5. Essayer d'autres familles de modèles
6. Régler et finaliser le modèle
7. Comprendre et choisir le modèle
8. Préparer la passation du modèle
Ce que vous saurez faire
Jugez un modèle sur des données dont il n’a pas appris, et gardez des données distinctes pour un score final. Un modèle qui a mémorisé ses données d’entraînement semble parfait sur ces données. Aucun message d’erreur ne vous indique qu’il échoue sur de nouveaux billets de soutien.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient toutes les cellules de code, les tâches et les vérifications de cette leçon, avec les consignes. Il exécute le modèle qui mémorise sur 12 billets et sur les données réelles, les 100 règles de Tomás et la validation croisée. Ses cellules de préparation installent pandas et scikit-learn et téléchargent les données de pratique. Vous n’avez donc rien à configurer localement. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les caractéristiques et les étiquettes : un modèle apprend à partir d’exemples dont les bonnes réponses sont connues. Voir L’apprentissage supervisé : caractéristiques et étiquettes.
- La décision de Larkfield, la cible
escalated_72het la capacité de 20 %, dans Traduire un besoin. - Les références de base et la règle « signaler les billets de priorité 1 » (elle détecte 61 des 183 escalades de mai), dans Définir une référence de base.
- La séparation des données selon le temps et la nouvelle politique de garantie du 1er mai 2026, dans Choisir une séparation du cours SQL et préparation des données pour l’IA.
- La fuite de données et pourquoi chaque étape qui apprend des données utilise seulement les données d’entraînement, dans Ajuster les transformations correctement du cours SQL et préparation des données pour l’IA.
Ce qu’il vous faut sur votre ordinateur (seulement pour travailler localement; le carnet n’en a pas besoin)
- Le dossier de projet
~/projects/ticket-modelavec son environnement.venv, dans Définir une référence de base : préparer votre projet. Sipython -c "import sklearn"échoue, activez de nouveau.venv(source .venv/bin/activatesur macOS et Linux,.venv\Scripts\Activate.ps1sur Windows). data/train.csv,data/valid.csvetdata/test.csv, dans Définir une référence de base : télécharger les données. Si un fichier manque ou a changé, exécutezpython get_data.py --reset.- Un carnet dans le dossier de projet, comme dans Définir une référence de base : ouvrir un carnet dans VS Code. Le code de cette leçon utilise les fonctions utilitaires du carnet de la leçon. Copiez d’abord sa cellule « Helpers for this lesson » (fonctions utilitaires pour cette leçon) dans votre carnet.
Testé sur macOS avec Python 3.14.6, pandas 3.0.6 et scikit-learn 1.9.1. Le carnet a été testé dans Jupyter.
Comment une élève apprend les mathématiques
Section intitulée « Comment une élève apprend les mathématiques »Pensez à une élève qui apprend un nouveau chapitre de mathématiques, par exemple les fractions. D’abord, elle fait les exercices de pratique de son livre. Les réponses se trouvent à la fin du livre. Après chaque exercice, elle vérifie donc sa réponse et apprend de ses erreurs. Elle en fait beaucoup, et certains plus d’une fois.
Ensuite, l’enseignant veut savoir si elle comprend vraiment les fractions. Il lui donne donc les exercices de fin de chapitre. Ce sont de nouvelles questions sur les mêmes sujets, qu’elle n’a pas pratiquées. Ses notes révèlent ses points faibles. Peut-être qu’elle additionne bien les fractions, mais fait des erreurs quand les nombres du bas sont différents. Elle revient donc pratiquer ce type de question, puis essaie une nouvelle série d’exercices de fin de chapitre. Ce cycle peut se répéter plusieurs fois.
À la fin de la session arrive l’examen final. Ses questions sont encore nouvelles. L’enseignant garde l’examen scellé jusqu’au jour prévu. L’élève le passe une seule fois, et sa note figure sur son bulletin. L’école, ses parents et son prochain enseignant font confiance à cette note, car personne n’a pratiqué ces questions.

Description textuelle du diagramme
L’image comporte trois parties. À gauche se trouve un cahier d’exercices ouvert. Chaque exercice a une case de réponse et une coche verte, car l’élève vérifie chaque réponse à la fin du livre. Une flèche mène à la partie centrale, une feuille d’exercices de fin de chapitre. Quatre exercices ont une coche verte et un autre a une croix rouge, entourée d’une ligne rouge en pointillés : un point faible. Une flèche rouge en pointillés revient de cette feuille vers le cahier, car l’élève retourne pratiquer. Une deuxième flèche mène à la partie droite : une enveloppe fermée avec un cadenas sur son sceau. C’est l’examen final, que personne n’ouvre avant la fin.
Imaginez maintenant un enseignant paresseux qui utilise les exercices de pratique comme examen final. Une élève qui a mémorisé toutes les réponses à la fin du livre obtient 100 %. Elle peut ne rien comprendre aux fractions, et l’examen ne peut pas le révéler. La note mesure sa mémoire de ces questions précises, pas sa capacité à répondre à de nouvelles questions. C’est pourquoi on garde les trois types de questions séparés.
Le même problème en apprentissage automatique
Section intitulée « Le même problème en apprentissage automatique »Un modèle supervisé apprend comme l’élève. Il reçoit des exemples dont les bonnes réponses, les étiquettes, sont connues. Il apprend à partir de ces exemples, puis doit donner des réponses pour de nouveaux cas. Pour Larkfield, les exemples sont d’anciens billets, et les nouveaux cas sont les billets que les clients créeront demain.
Les étiquettes permettent aussi de vérifier un modèle. Pour chaque billet dont nous connaissons la réponse, nous comparons la prédiction du modèle à la vraie réponse et comptons les erreurs. Mais sur quels billets faisons-nous cette vérification? Si nous utilisons les billets dont le modèle a appris, nous répétons l’erreur de l’enseignant paresseux. Un modèle qui a mémorisé ces billets obtient un score parfait, et nous n’apprenons rien sur les billets de demain.
Cette erreur porte un nom. Un modèle fait du surapprentissage quand il apprend trop bien les détails et les particularités dues au hasard de ses exemples d’entraînement. Il fonctionne alors beaucoup moins bien sur de nouveaux exemples. Il a mémorisé au lieu de comprendre. Le surapprentissage est invisible sur les données d’entraînement : le modèle qui en fait semble être le meilleur sur ces données.
Un petit exemple : le modèle qui mémorise et la règle
Section intitulée « Un petit exemple : le modèle qui mémorise et la règle »Voici 8 billets de pratique avec leurs réponses. Trois ont fait l’objet d’une escalade : P-1, P-3 et P-6.
| Billet | Priorité | Équipe | Mots | Escalade |
|---|---|---|---|---|
| P-1 | 1 | payment | 120 | 1 |
| P-2 | 3 | delivery | 40 | 0 |
| P-3 | 2 | warranty | 210 | 1 |
| P-4 | 1 | returns | 60 | 0 |
| P-5 | 3 | account | 25 | 0 |
| P-6 | 1 | payment | 95 | 1 |
| P-7 | 2 | delivery | 70 | 0 |
| P-8 | 3 | returns | 30 | 0 |
Deux « modèles » apprennent à partir de ces billets. Le modèle qui mémorise retient la réponse de chaque billet de pratique. Pour chaque billet, il cherche une copie exacte : même priorité, même équipe et même nombre de mots. S’il en trouve une, il donne la réponse mémorisée; sinon, il dit « non ». La règle a plutôt appris une tendance : les billets de priorité 1 font plus souvent l’objet d’une escalade. Elle signale donc chaque billet de priorité 1.
Sur les billets de pratique, le modèle qui mémorise a raison 8 fois sur 8. La règle signale P-1, P-4 et P-6. Elle détecte deux escalades, donne une fausse alerte (P-4) et manque P-3. Elle a donc raison 6 fois sur 8. Maintenant, quatre nouveaux billets arrivent. N-1 et N-3 ont fait l’objet d’une escalade :
| Billet | Priorité | Équipe | Mots | Escalade | Modèle qui mémorise | Règle |
|---|---|---|---|---|---|---|
| N-1 | 1 | payment | 110 | 1 | non (aucune copie) | oui |
| N-2 | 3 | delivery | 45 | 0 | non (aucune copie) | non |
| N-3 | 2 | warranty | 190 | 1 | non (aucune copie) | non |
| N-4 | 2 | returns | 50 | 0 | non (aucune copie) | non |
Aucun nouveau billet n’est une copie exacte d’un billet de pratique. Le modèle qui mémorise n’a donc aucune réponse en mémoire. Il dit « non » quatre fois et ne détecte aucune des deux escalades. La règle détecte N-1 et manque N-3. Dans le carnet, flag_report() fait ce décompte pour vous. Cette fonction vient de Définir une référence de base. Elle compte les escalades détectées et manquées, les fausses alertes et les billets correctement laissés sans signalement :
COLUMNS = ["priority", "team", "word_count"]memory = {tuple(row[COLUMNS]): row["escalated"] for _, row in practice.iterrows()}
def memoriser(part):    """The remembered answer for an exact copy of a practice ticket, else 0."""    return [memory.get(tuple(row[COLUMNS]), 0) for _, row in part.iterrows()]
def rule(part):    """Flag priority 1."""    return (part["priority"] == 1).tolist()
tiny = pd.DataFrame.from_dict({    "memoriser, practice": flag_report(practice["escalated"], memoriser(practice)),    "rule, practice": flag_report(practice["escalated"], rule(practice)),    "memoriser, new": flag_report(new["escalated"], memoriser(new)),    "rule, new": flag_report(new["escalated"], rule(new)),}, orient="index")tiny[["flagged", "caught", "missed", "false alarms", "accuracy"]]
La sortie :
flagged caught missed false alarms accuracymemoriser, practice 3 3 0 0 1.00rule, practice 3 2 1 1 0.75memoriser, new 0 0 2 0 0.50rule, new 1 1 1 0 0.75Sur les billets de pratique, le modèle qui mémorise gagne clairement. Sur les nouveaux billets, il ne détecte rien, et la règle est meilleure. La règle conserve l’essentiel de sa capacité parce qu’elle a appris une tendance. Le modèle qui mémorise a appris des billets.
Les données réelles : un modèle qui mémorise
Section intitulée « Les données réelles : un modèle qui mémorise »Avec douze billets, le problème est facile à voir. Arrive-t-il la même chose avec un vrai modèle et des milliers de billets? Priya essaie avec un arbre de décision. Un arbre de décision pose des questions oui/non sur les caractéristiques d’un billet, une après l’autre, jusqu’à obtenir une réponse. La priorité est-elle 1? L’équipe est-elle payment? Y a-t-il plus de 150 mots? Les arbres de décision explique comment un arbre choisit ses questions. Ici, vous devez savoir une seule chose. Sans limite, l’arbre continue à poser des questions jusqu’à ce que chaque groupe de billets d’entraînement ait une seule réponse. C’est de la mémorisation, sous une forme moins évidente.
Dans le carnet, la fonction utilitaire memorising_tree() crée cet arbre et prépare les colonnes dont il a besoin. Priya l’ajuste sur les 16 939 billets d’entraînement :
train = read("data/train.csv")valid = read("data/valid.csv")memoriser_tree = memorising_tree().fit(train[FEATURES], train[TARGET])print("Groups of train tickets at the end of the questions:", memoriser_tree.named_steps["model"].get_n_leaves())La sortie :
Groups of train tickets at the end of the questions: 2210L’arbre a séparé les billets d’entraînement en 2 210 petits groupes, chacun avec une seule réponse. Avant de continuer, faites une prédiction : combien des 1 983 escalades d’entraînement détectera-t-il? Et combien des 183 escalades de mai? Priya le compare à la règle « signaler les billets de priorité 1 », sur les billets d’entraînement et les données de validation (mai) :
real = pd.DataFrame.from_dict({ "memoriser on train": flag_report(train[TARGET], memoriser_tree.predict(train[FEATURES])), "memoriser on May": flag_report(valid[TARGET], memoriser_tree.predict(valid[FEATURES])), "rule on train": flag_report(train[TARGET], train["priority"] == 1), "rule on May": flag_report(valid[TARGET], valid["priority"] == 1),}, orient="index")real[["flagged", "caught", "missed", "precision", "recall"]]La sortie :
flagged caught missed precision recallmemoriser on train 1983 1983 0 1.000 1.000memoriser on May 177 46 137 0.260 0.251rule on train 2385 693 1290 0.291 0.349rule on May 163 61 122 0.374 0.333Lisez d’abord la colonne du rappel : la proportion des escalades détectées. Sur les billets dont il a appris, l’arbre est parfait. Il signale exactement les 1 983 escalades et rien d’autre. En mai, il en détecte 46 sur 183, soit environ une sur quatre. C’est moins que la règle simple, qui en détecte 61. La colonne de précision, la proportion de signalements corrects, montre la même chose. Environ un signalement de l’arbre sur quatre est correct, contre plus d’un sur trois pour la règle.
- Arbre qui mémorise
- Règle : signaler les billets de priorité 1
Description textuelle du graphique
Un graphique à quatre colonnes, avec un axe allant de 0 à 100 %. L’arbre qui mémorise détecte 100 % des escalades sur les billets d’entraînement et 25,1 % sur les billets de mai. La règle « signaler les billets de priorité 1 » en détecte 34,9 % sur les données d’entraînement et 33,3 % en mai. L’arbre a la colonne la plus haute pour l’entraînement et la plus basse pour mai. Les deux colonnes de la règle ont presque la même hauteur.
La règle change peu entre l’entraînement et mai, car elle a appris une vraie tendance : les billets urgents entraînent davantage d’escalades. L’arbre a appris les particularités dues au hasard de 16 939 anciens billets. Par exemple, le nombre exact de mots d’un billet de paiement à 14 h. Ces particularités ne se répètent pas en mai. Voilà du surapprentissage, mesuré.
Omar, le gestionnaire de produit, demande : « L’arbre en sait tellement plus que la règle. Comment peut-il être moins bon? » Priya répond : « Il connaît les anciens billets, pas ce qui provoque une escalade. La plupart de ce qu’il a retenu était dû au hasard. » Tomás a une autre idée : « Alors, jugeons chaque modèle sur les billets d’entraînement, et choisissons un modèle qui ne mémorise pas. » Mais vous ne pouvez pas voir quel modèle mémorise en regardant seulement les billets dont il a appris. Chaque modèle y semble meilleur qu’il ne l’est vraiment. Seuls les billets que le modèle n’a pas vus montrent la différence.
Trois jeux de données, trois rôles
Section intitulée « Trois jeux de données, trois rôles »On divise donc les données, comme les exercices de l’étudiante, en trois parties qui ont trois rôles différents :
- Les données d’entraînement sont les exercices de pratique. Le modèle apprend à partir de ces données, tout comme chaque autre étape qui apprend des données. On ne juge jamais un modèle par son score sur les données d’entraînement.
- Les données de validation sont les exercices de fin de chapitre. Le modèle n’a pas appris à partir de ces données. Elles servent à comparer les versions, à trouver les points faibles et à choisir les caractéristiques, le modèle et les réglages. On les consulte souvent.
- Les données de test sont l’examen final. Personne ne les regarde pendant le travail. Une fois tous les choix faits, on évalue le modèle final une seule fois sur ces données. C’est ce résultat qu’on présente à Grace.

Description textuelle du diagramme
Le schéma présente trois cases de gauche à droite, ou de haut en bas sur un téléphone. La première indique que les exercices de pratique sont les données d’entraînement : le modèle apprend à partir de ces données. Les données d’entraînement de Larkfield comptent 16 939 billets de juillet 2024 à avril 2026. Une flèche nommée « vérifier avec de nouvelles questions » mène à la deuxième case. Les exercices de fin de chapitre sont les données de validation. Vous les utilisez pour comparer les versions, trouver les points faibles et choisir, et vous les consultez souvent. Les données de validation de Larkfield comptent 1 179 billets de mai 2026. Une flèche en pointillés nommée « corriger les points faibles » retourne des données de validation aux données d’entraînement. Une dernière flèche, nommée « une fois tous les choix faits », mène à la troisième case. L’examen final est constitué des données de test. Il donne un seul score final pour les autres, et vous le consultez une seule fois, à la fin. Les données de test de Larkfield comptent 1 002 billets de juin 2026.
Pour Larkfield, ces trois jeux de données viennent de la séparation vue dans SQL et préparation des données pour l’IA. Vous la connaissez déjà. Dans le code, ce sont les DataFrames (tableaux de données) train, valid et test. Le cours emploie donc souvent « données train » comme forme courte. Le tableau présente l’analogie et les chiffres côte à côte :
| Jeu de données | Équivalent | Larkfield | Rôle | Fréquence de consultation |
|---|---|---|---|---|
| Données d’entraînement | Exercices de pratique | 16 939 billets, juillet 2024 à avril 2026, 11,7 % transférés au niveau supérieur | Le modèle apprend à partir de ces données | Jamais pour juger le modèle |
| Données de validation | Exercices de fin de chapitre | 1 179 billets, mai 2026, 15,5 % transférés au niveau supérieur | Comparer, trouver les points faibles, choisir | Souvent |
| Données de test | Examen final | 1 002 billets, du 1er au 27 juin 2026, 15,7 % transférés au niveau supérieur | Un seul score final et honnête | Une fois, à la fin |
Dans ce cours, vous utilisez les données de test une seule fois, au module 6, dans Seuils et calibration. Un petit script y refuse de s’exécuter deux fois. D’ici là, vous ne regardez pas le score sur ces données.
Pourquoi chaque consultation use un peu les données de validation
Section intitulée « Pourquoi chaque consultation use un peu les données de validation »Les données de validation ont aussi une faiblesse. Repensez à l’étudiante. Si elle refait sans cesse les mêmes exercices de chapitre, elle commence à les mémoriser. Après le cinquième essai, une bonne note en dit moins sur les fractions que sur ces questions précises. La même chose arrive avec un modèle, de façon moins visible. Vous essayez un changement et le gardez parce que le score de validation a augmenté. Chaque fois, une partie de cette hausse peut venir du hasard. Ces 1 179 billets convenaient au changement par hasard.
Tomás le montre sans le vouloir. Il écrit 100 règles. Chacune signale environ un billet sur cinq, choisi seulement à partir de l’identifiant du billet. Dans le carnet (notebook) Jupyter, la fonction utilitaire id_rule() les crée. Les règles ne savent rien des billets. À long terme, chacune détecte donc environ 20 % des transferts au niveau supérieur. Tomás évalue les 100 règles sur mai et garde la meilleure :
may_recall = [flag_report(valid[TARGET], id_rule(number, valid))["recall"] for number in range(100)]best = int(np.argmax(may_recall))print("May, 100 rules: mean", round(np.mean(may_recall), 3), " lowest", min(may_recall), " highest", max(may_recall))print("The best rule on May is rule", best)Le résultat :
May, 100 rules: mean 0.199 lowest 0.142 highest 0.251The best rule on May is rule 7« La règle 7 en détecte 25,1 %, dit Tomás. C’est beaucoup mieux que le hasard. » Priya vérifie la règle 7 sur beaucoup plus de billets qui n’ont pas servi au choix : les 16 939 billets d’entraînement. C’est juste ici, car ces règles n’ont rien appris des données d’entraînement.
train_recall = [flag_report(train[TARGET], id_rule(number, train))["recall"] for number in range(100)]print("Rule", best, "on train:", train_recall[best])print("train, 100 rules: mean", round(np.mean(train_recall), 3), " lowest", min(train_recall), " highest", max(train_recall))Le résultat :
Rule 7 on train: 0.206train, 100 rules: mean 0.2 lowest 0.177 highest 0.229Sur les données d’entraînement, la règle 7 détecte 20,6 % des transferts, comme les autres règles. Son résultat de 25,1 % sur mai venait du hasard. Davantage des 183 transferts de mai correspondaient par hasard aux billets qu’elle signalait.
Description textuelle du graphique
Le graphique présente deux rangées de 100 points chacune, sur un axe allant de 10 % à 30 % des transferts détectés. Les points ayant la même valeur arrondie s’empilent. Dans la rangée de mai, les points vont de 14,2 % à 25,1 %, avec une moyenne de 19,9 %. Le point à droite, à 25,1 %, est la règle 7. Dans la rangée d’entraînement, les points forment un amas étroit et haut allant de 17,7 % à 22,9 %. Leur moyenne est de 20,0 %. La règle 7 se trouve près du milieu de cet amas, à 20,6 %.
Ce graphique mène à deux leçons. Premièrement, un choix fait sur les données de validation sélectionne aussi une part de chance. Plus vous comparez de versions, plus le score de validation de la gagnante est trop bon. Le score de validation de votre modèle final est donc un peu optimiste, même si vous avez tout fait correctement. Deuxièmement, un petit jeu de données varie davantage au hasard. Avec 183 transferts, des règles qui ne savent rien obtiennent des scores de 14 % à 25 %. Avec 1 983 transferts, les mêmes règles restent entre 18 % et 23 %. La validation croisée, ci-dessous, utilise ce deuxième point.
Pourquoi les données de test servent une seule fois
Section intitulée « Pourquoi les données de test servent une seule fois »Le premier point explique la raison d’être des données de test. Les données de validation vous ont aidé à choisir, donc leur score est un peu trop bon. Il vous faut un autre jeu de données qui n’a joué aucun rôle dans les choix : l’examen sous enveloppe scellée. Son score donne une estimation honnête pour les billets de demain.
Cela fonctionne seulement si vous consultez les données de test une fois, à la fin. Supposons que vous regardez le score de test, qu’il vous déplaît, puis que vous changez quelque chose et regardez encore. Les données de test vous ont maintenant aussi aidé à choisir. Elles sont devenues un deuxième jeu de données de validation, avec le même optimisme. Vous n’avez plus de résultat honnête. L’étudiante qui a vu l’examen la veille est dans la même situation. Sa note est élevée, mais elle ne montre plus ce qu’elle sait faire.
Donc, si le score de test est inférieur au score de validation, vous le présentez tel quel. Un score un peu inférieur est normal et attendu. S’il est beaucoup plus bas, vous le notez et planifiez un nouveau travail avec de nouvelles données.
Comment séparer : au hasard ou selon le temps
Section intitulée « Comment séparer : au hasard ou selon le temps »Quelles lignes vont dans quel jeu de données? Il existe deux réponses courantes. Choisir une séparation, dans SQL et préparation des données pour l’IA, les compare en détail.
Une séparation aléatoire place chaque ligne dans un jeu de données au hasard. C’est comme mélanger des fiches d’exercices et en prendre quelques-unes pour l’examen. C’est juste lorsque les lignes sont indépendantes et que leur ordre n’importe pas. Les photos de fleurs destinées à un modèle qui nomme les fleurs sont un bon exemple. Une photo prise en mai ne dit rien de particulier au modèle sur une photo prise en juin.
Une séparation temporelle place les lignes les plus anciennes dans les données d’entraînement. Elle place les plus récentes dans les données de validation et de test. Utilisez-la lorsque le modèle doit prédire le futur à partir du passé. C’est ainsi qu’on utilise presque tous les modèles en entreprise. Le test reproduit alors l’utilisation réelle : le modèle apprend de ce qui s’est passé avant une date. On le juge sur ce qui s’est passé après cette date.
Larkfield évaluera les billets de demain avec un modèle entraîné sur le passé. Larkfield sépare donc les données selon le temps. Le graphique montre pourquoi c’est important ici :
- Données d'entraînement
- Données de validation (mai 2026)
- Données de test (juin 2026)
Description textuelle du graphique
Le graphique montre la part des billets transférés au niveau supérieur chaque mois, de juillet 2024 à juin 2026. Les 22 mois des données d’entraînement varient entre 9,5 % en septembre 2025 et 13,9 % en août 2024. Avril 2026, le dernier mois d’entraînement, affiche 9,8 %. Le mois de validation, mai 2026, affiche ensuite 15,5 %, et le mois de test, juin 2026, affiche 15,7 %. Ces deux taux dépassent celui de tous les mois d’entraînement. La nouvelle politique de garantie est entrée en vigueur le 1er mai 2026.
Le 1er mai 2026, Larkfield a instauré une nouvelle politique de garantie. Depuis, davantage de billets sont transférés au niveau supérieur. Une séparation temporelle garde ce changement visible. Les données de validation sont la première rencontre du modèle avec les nouvelles conditions, exactement comme en utilisation réelle. Une séparation aléatoire le masque, comme le montre le cas d’échec ci-dessous. Un troisième type, la séparation par groupe, garde tous les billets d’un client dans un même jeu de données. Utilisez-la lorsque le modèle doit fonctionner pour des clients qu’il n’a jamais vus. SQL et préparation des données pour l’IA la présente.
Validation croisée
Section intitulée « Validation croisée »Revenons à l’étudiante. Supposons qu’il n’y ait qu’une feuille d’exercices de chapitre. Sa note dépend en partie des questions qui se trouvent sur cette feuille. Une feuille remplie de ses questions préférées donne une note trop bonne. Un enseignant attentif peut faire mieux avec le cahier de pratique lui-même. Il le divise en cinq parties. L’étudiante s’exerce sur quatre parties, puis passe un test sur la cinquième, qu’elle n’a pas vue. Ils répètent cela cinq fois, avec une partie différente comme test chaque fois, puis calculent la moyenne des cinq notes. Chaque question sert au test une fois, et jamais pour une étudiante qui s’est exercée sur cette question.
Larkfield a le même problème avec une seule feuille. Mai ne compte que 183 transferts au niveau supérieur. Un score sur mai varie donc beaucoup au hasard, comme l’ont montré les 100 règles de Tomás. Et chaque consultation de mai use un peu ces données. La validation croisée résout les deux problèmes avec la méthode de l’enseignant. Elle utilise les nombreuses données d’entraînement pour les vérifications :
- Divisez les billets d’entraînement en 5 parties égales, appelées plis.
- Ajustez le modèle sur 4 plis, puis évaluez-le sur le cinquième, qu’il n’a pas vu.
- Répétez cela 5 fois, pour que chaque pli joue une fois le rôle des « exercices de chapitre ».
- Présentez la moyenne des 5 scores et leur écart-type : la variation du score d’un pli à l’autre.
C’est la validation croisée à 5 plis, souvent écrite CV. Le nom décrit la méthode. Chaque ligne aide le modèle à apprendre dans certains tours et sert à le vérifier dans un tour. L’apprentissage et la vérification se « croisent » donc.
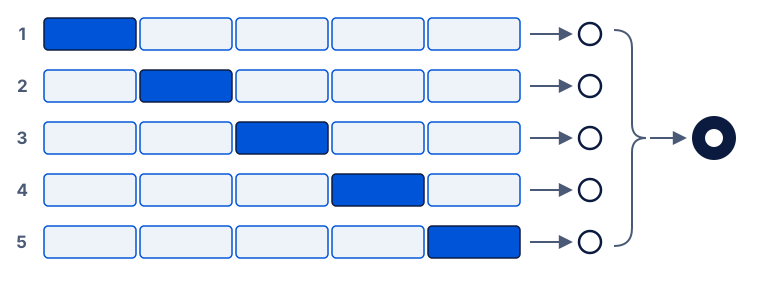
Description textuelle du diagramme
L’image présente cinq rangées, numérotées de 1 à 5. Chaque rangée représente un tour et montre les données d’entraînement comme une barre de cinq blocs égaux, les plis. Au tour 1, le premier bloc est foncé et les quatre autres sont clairs. Au tour 2, le deuxième bloc est foncé, et ainsi de suite jusqu’au tour 5, où le dernier bloc est foncé. Le modèle apprend des blocs clairs et est évalué sur le bloc foncé. Chaque rangée se termine par une flèche vers un petit cercle : le score de ce tour. Une accolade à droite réunit les cinq cercles en un grand point : la moyenne des cinq scores.
Diviser les plis avec soin
Section intitulée « Diviser les plis avec soin »Chaque pli doit être une petite copie fidèle des données d’entraînement. Voici 20 lignes, avec les 5 transferts au niveau supérieur en haut du fichier, comme dans un fichier trié par cible. Le simple KFold(5) divise les lignes dans l’ordre du fichier; StratifiedKFold(5) ne le fait pas :
from sklearn.model_selection import KFold, StratifiedKFold
y_20 = np.array([1] * 5 + [0] * 15)x_20 = np.arange(20).reshape(-1, 1)for name, folds in [("KFold", KFold(5)), ("StratifiedKFold", StratifiedKFold(5))]:    print(name, "escalated per fold:", [int(y_20[rows].sum()) for _, rows in folds.split(x_20, y_20)])
Le résultat :
KFold escalated per fold: [4, 1, 0, 0, 0]StratifiedKFold escalated per fold: [1, 1, 1, 1, 1]Avec le simple KFold, trois plis n’ont aucun transfert au niveau supérieur, donc rien à détecter, et le premier en compte quatre. Une séparation stratifiée garde la même proportion de transferts dans chaque pli. Pour une cible oui/non, utilisez StratifiedKFold. Le cours utilise toujours StratifiedKFold(5, shuffle=True, random_state=0) : une séparation stratifiée, avec les lignes mélangées au préalable. La valeur fixe de random_state donne les mêmes plis à chaque exécution.
Validation croisée sur les données d’entraînement de Larkfield
Section intitulée « Validation croisée sur les données d’entraînement de Larkfield »Priya exécute une validation croisée à 5 plis sur l’arbre qui mémorise. cross_validate effectue les quatre étapes ci-dessus. Avec return_train_score=True, il évalue aussi le modèle de chaque tour sur les quatre plis dont il a appris :
from sklearn.model_selection import cross_validate
cv = StratifiedKFold(5, shuffle=True, random_state=0)result = cross_validate(memorising_tree(), train[FEATURES], train[TARGET], cv=cv,                        scoring="recall", return_train_score=True)print("caught on the 4 folds it learned from:", result["train_score"].round(3))print("caught on the fold it did not see:    ", result["test_score"].round(3))print(f"mean {result['test_score'].mean():.3f}, standard deviation {result['test_score'].std():.3f}")
Le résultat :
caught on the 4 folds it learned from: [1. 1. 1. 1. 1.]caught on the fold it did not see: [0.247 0.204 0.247 0.229 0.21 ]mean 0.227, standard deviation 0.018À chaque tour, l’arbre détecte tous les transferts au niveau supérieur dans les plis dont il a appris. Sur le pli qu’il n’a pas vu, il en détecte environ un sur cinq. La validation croisée a trouvé le problème de mémorisation sans utiliser mai du tout. Chaque pli compte 3 388 billets, avec 396 ou 397 transferts. Ces scores sont donc plus stables qu’un seul score sur mai. Les leçons suivantes utilisent souvent un autre score, la précision moyenne, expliqué dans Le compromis entre précision et rappel. Avec ce score, le même arbre obtient 1,000 sur l’entraînement et 0,137 ± 0,004 en validation croisée : le même écart.
Notez un nom qui peut prêter à confusion. scikit-learn appelle le score sur le pli mis de côté test_score (score de test). Mais ce pli fait partie de nos données d’entraînement. Les vraies données de test, juin, ne servent jamais dans la validation croisée.
Passons à l’écart-type. Priya évalue la règle « signaler la priorité 1 » sur les cinq mêmes plis. La règle n’apprend rien, donc toute variation d’un pli à l’autre ne peut venir que du hasard :
rule_recall = [flag_report(train[TARGET].iloc[rows], train["priority"].iloc[rows] == 1)["recall"] for _, rows in cv.split(train, train[TARGET])]print("rule, caught per fold:", rule_recall)print(f"mean {np.mean(rule_recall):.3f}, standard deviation {np.std(rule_recall):.3f}")Le résultat :
rule, caught per fold: [0.371, 0.315, 0.343, 0.343, 0.376]mean 0.350, standard deviation 0.022La même règle détecte de 31,5 % à 37,6 % des transferts, uniquement parce que chaque pli contient des billets différents. Si l’écart entre deux modèles est inférieur à ce type de variation, la différence peut donc venir du hasard. Écrivez un résultat de validation croisée avec sa variation, par exemple « 0,350 ± 0,022 ». Régler les hyperparamètres en fait une règle pour choisir entre les modèles.
Validation croisée et mois de validation
Section intitulée « Validation croisée et mois de validation »Si la validation croisée est si bonne, pourquoi garder mai? Parce que les 22 mois d’entraînement viennent tous d’avant la nouvelle politique de garantie. La validation croisée les mélange. Chaque pli contient donc les anciennes conditions, avec des taux mensuels de 9,5 % à 13,9 %. Elle ne peut pas montrer comment un modèle fonctionne après le changement. Mai le peut. Larkfield utilise donc les deux, chacun pour son rôle :
- La validation croisée sur les données d’entraînement compare les modèles et les réglages. Elle compte 1 983 transferts au niveau supérieur, donc ses moyennes sont stables, et elle n’use pas les données de mai.
- Le mois de validation vérifie le modèle choisi dans les nouvelles conditions. Le module 6 l’utilise aussi pour fixer le seuil.
- Le mois de test donne le seul score final.
La validation croisée a aussi des coûts. Elle ajuste le modèle 5 fois plutôt qu’une, ce qui compte pour les modèles lents. Et sur des données ordonnées dans le temps, elle mélange les lignes anciennes et récentes au sein des données d’entraînement. C’est acceptable ici seulement parce que le mois de validation vérifie séparément les conditions les plus récentes.
Garder les jeux de données séparés
Section intitulée « Garder les jeux de données séparés »Trois jeux de données aident seulement si rien ne passe de l’un à l’autre. Une fuite de données est une information qui atteint le modèle depuis un endroit interdit : les lignes de validation, de test, ou le futur. Vous l’avez vue dans SQL et préparation des données pour l’IA. C’est l’étudiante qui a vu l’examen la veille. Deux formes comptent surtout :
- Une étape qui apprend de toutes les lignes. Supposons que vous calculez la médiane pour les valeurs manquantes, ou la moyenne pour la mise à l’échelle. Vous le faites sur les données d’entraînement, de validation et de test réunies. Un peu des données de validation et de test entre alors dans l’entraînement. Chaque étape qui apprend des données doit utiliser seulement les lignes d’entraînement. C’est ce que montre Ajuster les transformations correctement, dans SQL et préparation des données pour l’IA. Le module 4 construit un pipeline qui le fait pour vous.
- Une colonne provenant du futur. Une colonne comme
priority_now, écrite par le transfert au niveau supérieur lui-même, contient la réponse. Caractéristiques et moment de la cible, dans SQL et préparation des données pour l’IA, et Traduire un besoin l’ont montré.
La fuite de données, comme le surapprentissage, ne déclenche aucune erreur. Elle rend les scores de validation et de test trop bons, et le modèle déçoit en utilisation réelle.
Exercice guidé : surapprentissage et plis dans le carnet
Section intitulée « Exercice guidé : surapprentissage et plis dans le carnet »- Ouvrez le carnet (notebook) Jupyter depuis l’encadré Faites cette leçon dans un carnet en haut de cette page.
- Exécutez les cellules de configuration et la cellule utilitaire. La cellule de données se termine par la ligne
Ready:(prêt). - Dans la section 2, prédisez quel modèle réussit mieux sur les billets de soutien d’exercice et sur les nouveaux billets. Puis exécutez la cellule. Vous voyez une exactitude de
1.00pour le modèle qui mémorise sur les billets d’exercice et de0.50sur les nouveaux. - Dans la section 3, exécutez la cellule qui entraîne l’arbre. Vous voyez
2210groupes. - Prédisez le rappel de l’arbre sur les données d’entraînement et sur celles de mai. Puis exécutez la cellule suivante. Vous voyez
1983cas détectés sur les données d’entraînement et46en mai. - Dans la cellule Your turn (à vous de jouer), calculez
gap: le rappel du modèle qui mémorise sur les données d’entraînement moins son rappel en mai. - Exécutez la cellule de vérification. Elle affiche
Check passed(vérification réussie). - Dans la section 4, exécutez les 100 règles. Vous voyez
rule 7(règle 7), avec0.251en mai et0.206sur les données d’entraînement. - Exécutez la cellule du graphique. La rangée de points de mai est plus étalée que celle des données d’entraînement.
- Dans la section 6, exécutez la cellule de 20 lignes, puis la validation croisée de l’arbre. Vous voyez une moyenne de
0.227et un écart-type de0.018. - Exécutez la validation croisée de la règle. Vous voyez une moyenne de
0.350et un écart-type de0.022.
Afficher la réponse à l’étape 6
gap = round(real.loc["memoriser on train", "recall"] - real.loc["memoriser on May", "recall"], 3)print(gap)0.749L’arbre manque trois quarts des cas transférés au niveau supérieur (1,000 − 0,251 = 0,749) sur des billets qu’il n’a pas utilisés pour apprendre. Pour la règle, le même écart est de 0,349 − 0,333 = 0,016.
À vous de jouer : 10 plis
Section intitulée « À vous de jouer : 10 plis »Changez une seule chose : le nombre de plis. Avec 10 plis, le modèle apprend sur 9 parties à chaque tour, et vous l’évaluez sur la dixième. Chaque pli contient donc deux fois moins de billets qu’avant. Avant l’exécution, prédisez : la moyenne du rappel de la règle changera-t-elle? L’écart-type diminuera-t-il ou augmentera-t-il? Dans la section 7 du carnet, créez cv_10 = StratifiedKFold(10, shuffle=True, random_state=0). Calculez le rappel de la règle sur chaque pli et placez la moyenne et l’écart-type dans mean_and_std.
Afficher la réponse
cv_10 = StratifiedKFold(10, shuffle=True, random_state=0)rule_recall_10 = [flag_report(train[TARGET].iloc[rows], train["priority"].iloc[rows] == 1)["recall"] for _, rows in cv_10.split(train, train[TARGET])]mean_and_std = [round(float(np.mean(rule_recall_10)), 3), round(float(np.std(rule_recall_10)), 3)]print(mean_and_std)[0.35, 0.037]La moyenne reste à 0,350, car c’est la même règle sur les mêmes billets. L’écart-type passe de 0,022 à 0,037. Chaque pli ne contient maintenant qu’environ 198 cas transférés au niveau supérieur, et un ensemble plus petit varie davantage par hasard. Avec plus de plis, chaque modèle apprend sur plus de données (90 % des données d’entraînement au lieu de 80 %). Mais le score de chaque pli varie davantage, et il faut exécuter plus d’entraînements. Cinq et dix plis sont deux choix courants; ce cours en utilise cinq.
Erreur courante
Une séparation aléatoire masque le changement
Symptôme : Tomás dit : « La séparation aléatoire, c’est la norme. Mélangeons les 19 120 billets et séparons-les en trois ensembles de mêmes tailles qu’avant. » Dans le carnet, every réunit les données d’entraînement, de validation et de test. Il obtient ceci :
shuffled = every.sample(frac=1, random_state=0)random_parts = {"test": shuffled.iloc[:1002], "valid": shuffled.iloc[1002:2181], "train": shuffled.iloc[2181:]}for name, part in random_parts.items(): recent = (part["created_at"] >= "2026-05-01").sum() print(f"random {name}: {len(part)} tickets, rate {part[TARGET].mean():.3f}, from May or June 2026: {recent}")random test: 1002 tickets, rate 0.131, from May or June 2026: 112random valid: 1179 tickets, rate 0.105, from May or June 2026: 122random train: 16939 tickets, rate 0.122, from May or June 2026: 1947Les trois ensembles semblent normaux, et rien ne déclenche d’erreur.
Cause : L’ordre chronologique des billets de Larkfield compte. Les données de test aléatoires mélangent les 24 mois. Leur taux est donc de 13,1 %, alors que le véritable futur, juin, présente un taux de 15,7 %. Pire encore, les données d’entraînement aléatoires contiennent 1 947 billets de mai et de juin. Le modèle apprendrait du futur, puis vous le testeriez en partie sur le passé. Un tel test répond à la mauvaise question. Il demande « le modèle fonctionne-t-il bien sur un mélange d’anciens billets? », et non « fonctionnera-t-il bien demain? »
Correction : séparez les données par période, comme Mei dans le cours SQL et préparation des données pour l’IA. Utilisez celles d’avant le 1 mai 2026 pour l’entraînement, celles de mai pour la validation et celles de juin pour le test. Utilisez une séparation aléatoire seulement si les lignes sont indépendantes et si leur ordre n’a pas d’importance.
Conséquence dans le travail en IA : une séparation aléatoire donne un score trop optimiste pour un modèle qui prédit le futur. Le modèle a vu des données ultérieures. Le test ne montre jamais de changement dans le monde, comme la nouvelle politique de Larkfield. L’équipe se fie au nombre, et le modèle fonctionne moins bien en usage réel dès le premier jour.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Associez les trois types d'exercices de l'élève aux trois ensembles de données. Pour chaque ensemble, indiquez son utilité et la fréquence à laquelle vous consultez son score.
Afficher la réponse
- Exercices d’entraînement = données d’entraînement. Le modèle et chaque étape qui apprend à partir de données les utilisent pour apprendre. Vous ne jugez jamais le modèle par son score sur ces données.
- Exercices de fin de chapitre = données de validation. Le modèle ne les a pas utilisées pour apprendre. Vous les utilisez pour comparer les versions, trouver les points faibles et choisir. Vous les consultez souvent, et chaque consultation réduit un peu leur valeur.
- Examen final = données de test. Elles ne servent à aucun choix. Vous évaluez le modèle final sur ces données une seule fois, à la fin, et vous rapportez ce nombre.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez et expliquez : un nouveau modèle détecte 96 % des cas transférés au niveau supérieur dans les données d'entraînement et 22 % en mai. Que se passe-t-il? Comment auriez-vous pu le voir sans les données de mai?
Afficher la réponse
Le modèle fait du surapprentissage : il a mémorisé les billets d’entraînement au lieu d’apprendre une régularité applicable aux nouveaux billets. L’arbre qui mémorise dans cette leçon se comporte de la même façon (100 % sur les données d’entraînement, 25,1 % en mai). Le score de 96 % sur les données d’entraînement ne dit presque rien sur les nouveaux billets. Sans mai, la validation croisée sur les données d’entraînement révèle le problème. À chaque tour, elle évalue le modèle sur un pli qu’il n’a pas utilisé pour apprendre. Pour l’arbre qui mémorise, cela donnait environ 23 % sur les plis réservés, contre 100 % sur les plis utilisés pour apprendre.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Tomás essaie 30 versions d'un modèle et garde celle qui obtient le meilleur score en mai. Il veut ensuite essayer quelques versions supplémentaires et garder la meilleure sur les données de test de juin. Que lui dites-vous sur chaque étape?
Afficher la réponse
Choisir à partir de mai est le rôle des données de validation, mais le score de la version gagnante est un peu trop bon. Une partie de son avance vient du hasard, comme l’ont montré les 100 règles (25,1 % en mai, 20,6 % sur d’autres billets). C’est pourquoi les données de test existent. Choisir à partir de juin leur enlève leur utilité : juin devient alors un deuxième ensemble de validation. Son score est trop bon de la même façon. Personne n’aurait de nombre honnête pour les nouveaux billets. Faites tous les choix avec la validation croisée sur les données d’entraînement et avec les données de mai. Puis évaluez le modèle final sur juin une seule fois et rapportez ce score tel quel.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Il faut juger un modèle sur des données qu’il n’a pas utilisées pour apprendre. Un arbre de décision qui mémorise détecte les 1 983 cas transférés au niveau supérieur des données d’entraînement. Il n’en détecte que 46 sur 183 en mai : moins que la règle « signaler la priorité 1 » (61). C’est du surapprentissage, et un score sur les données d’entraînement ne peut pas le révéler.
- Trois ensembles, trois rôles. Les données d’entraînement sont les exercices d’entraînement : le modèle les utilise pour apprendre. Les données de validation sont les exercices de fin de chapitre : comparer et choisir, en les consultant souvent. Les données de test sont l’examen final : un seul score final, une seule consultation.
- Chaque choix sur les données de validation retient une part de chance. La meilleure des 100 règles qui ne savent rien a détecté 25,1 % des cas en mai et 20,6 % sur d’autres billets. Les données de test donnent le nombre honnête, mais seulement si personne ne les utilise pour choisir.
- Larkfield sépare les données par période, car le modèle prédit le futur. Une séparation aléatoire mélange les mois et masque le changement du 1 mai 2026.
- La validation croisée évalue un modèle 5 fois sur les données d’entraînement, chaque fois sur un pli qu’il n’a pas vu. Rapportez la moyenne avec son écart-type : la règle donne 0,350 ± 0,022.
Ensuite, vous mesurez la qualité d’une prédiction numérique à partir des erreurs d’une prévision du nombre de billets par jour.
Leçon suivante : Les métriques de régression