
Demander une décision, pas du texte
- Leçon 24
- 40 min
- Module 6 : Modèles de décision, cascades et distillation
Où nous en sommes
Nos LLM ont rédigé leurs réponses en texte, et certains ont aussi écrit un nombre pour leur confiance. Un routeur a besoin d'une étiquette et d'une vraie probabilité. Dans cette leçon, nous obtenons les deux avec un petit modèle local. Nous évaluons chaque étiquette, limitons la sortie et vérifions si les probabilités sont justes.
Leçon 24 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitDemander une décision, pas du texte
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Obtenez une destination et une probabilité d’un modèle de langage, plutôt qu’une phrase à lire et à croire. Évaluez chaque destination, limitez ce que le modèle peut écrire ou lisez une tête entraînée. Vérifiez ensuite que les probabilités sont justes.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter charge un petit modèle local, Qwen3-0.6B, sur le processeur de votre ordinateur. Il évalue les sept noms de destination pour un message, puis pour 100 messages de test. Il lit aussi le tableau de fiabilité de l’exécution complète du cours. Ses cellules de préparation installent pandas, scikit-learn, Transformers et PyTorch. Le téléchargement du modèle fait environ 1,5 Go, une seule fois. Il faut environ 4 Go de mémoire libre et aucune clé. Environ 40 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le LLM comme classificateur, sa réponse JSON et sa confiance écrite, vus dans Classification zéro exemple avec un LLM.
- Les petits LLM locaux, vus dans Petits LLM locaux.
- L’étalonnage et le diagramme de fiabilité, vus dans Seuils et calibration du cours Apprentissage automatique : du problème à un modèle fiable (utile). Cette leçon explique les notions nécessaires.
Ce qu’il vous faut sur votre ordinateur (seulement pour l’étape du projet)
- Votre dossier de projet
larkrouteà l’étapeend-of-m03, avec.venvactif :python -m pytest -qaffiche18 passed(18 tests réussis). - Les fichiers d’exercice
nextia-learning-labsà côté de votre dossier de projet, comme dans Découvrir la boîte de réception.
Testé sur macOS avec Python 3.12, pandas 3.1.1, scikit-learn 1.9.1, Transformers 5.22.2 et PyTorch 2.15.0 (processeur). Les commandes Windows ne sont pas testées.
Un formulaire avec sept cases
Section intitulée « Un formulaire avec sept cases »Au bureau de poste, un nouveau commis hésite devant une lettre. Vous lui demandez : « Où faut-il l’envoyer? » Il répond : « Eh bien, probablement dans le sac du nord, je pense. Sauf si c’est un colis, alors peut-être au comptoir des colis. » Vous ne pouvez pas entrer cette réponse dans la machine de tri. Vous devez la lire, deviner ce qu’il veut dire et deviner à quel point il est sûr.
Le gestionnaire lui donne donc un formulaire. Il contient une case par sac, et le commis doit répartir 100 points entre les cases. Il met plus de points là où il est plus sûr. Chaque réponse a maintenant la même forme, et la machine peut la lire. Sur un mois, le gestionnaire peut aussi vérifier ses réponses. Quand il mettait 80 points sur un sac, avait-il raison environ 80 fois sur 100?
Le problème : le texte n’est pas une décision
Section intitulée « Le problème : le texte n’est pas une décision »Dans le module 5, les LLM répondaient en texte : un petit objet JSON avec une destination, une confiance et une raison. Un routeur a besoin de deux choses dans ce texte : une destination de la liste et une probabilité fiable. Le texte ne garantit ni l’une ni l’autre.
D’abord, le texte peut ne pas être une destination du tout. Avec une courte requête (prompt) demandant seulement le nom de destination, 93 % des réponses de Qwen3-0.6B étaient exactement un nom de destination. Les autres ressemblaient à - delivery (un tiret suivi de la destination de livraison). La requête présentait les destinations avec des tirets, et le modèle copiait le tiret.
Ensuite, la confiance est un mot que le modèle écrit, pas une mesure. Voici un message de test, avec la réponse enregistrée du LLM hébergé sans exemples :
M-102840 (en, chat): Can I return the storage box if I don’t like the colour?Label: productRecorded answer of chat-small (gpt-6-luna-2026-09-22) (zero-shot): returns_refunds, stated confidence 0.99, reason: Asks about returning a product due to its colour.La question concerne la politique de retour avant l’achat. Le guide de Larkfield l’envoie donc à product (produit). Le LLM a écrit « 0,99 » et s’est trompé. Ce n’est pas rare : il a écrit 0,99 pour 693 messages de test et avait raison pour 86,6 % d’entre eux.
L’idée : demander une décision
Section intitulée « L’idée : demander une décision »Au lieu de demander au modèle d’écrire une réponse, demandez-lui d’en choisir une dans une liste fixe. Obtenez aussi un nombre pour chaque option. Un modèle de langage permet de le faire de trois façons :
- Évaluer chaque destination. Ajoutez le nom de chaque destination après la requête. Demandez au modèle quelle est la probabilité de ce nom comme réponse. Transformez les sept scores en probabilités.
- Limiter la sortie. Laissez le modèle écrire, mais permettez seulement les mots qui maintiennent la réponse sur un des noms de destination. C’est le décodage contraint.
- Lire une tête de classification. Entraînez une petite couche au-dessus du modèle qui donne une probabilité par destination. L’encodeur réglé finement du module 4 fonctionne ainsi.
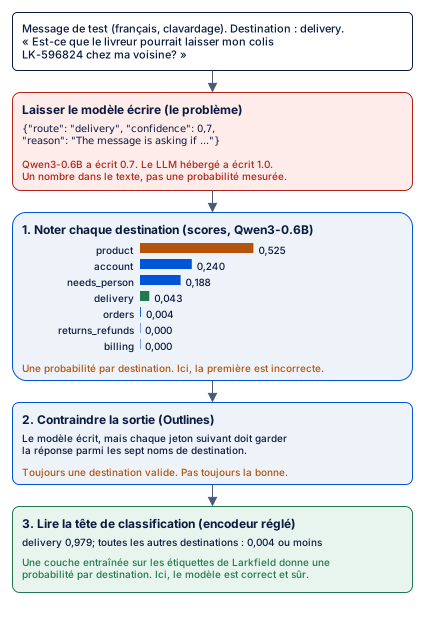
Description textuelle du diagramme
Le diagramme suit un message de test en français, M-100001 : « Est-ce que le livreur pourrait laisser mon colis LK-596824 chez ma voisine? ». La bonne destination est delivery. La première case montre le problème : quand Qwen3-0.6B écrit sa réponse, il donne la destination delivery et une confiance de 0,7. Le LLM hébergé a écrit 1,0. Ce sont des nombres dans le texte, pas des probabilités mesurées. La deuxième case évalue chaque destination avec Qwen3-0.6B. Product obtient 0,525, account 0,240, needs_person 0,188 et delivery 0,043. Orders obtient 0,004, et returns_refunds et billing presque 0. Chaque destination a une probabilité, mais la première est incorrecte. La troisième case limite la sortie avec Outlines. Le modèle écrit, mais chaque jeton suivant doit maintenir la réponse sur un des sept noms de destination. La réponse est toujours une destination valide, mais pas toujours la bonne. La quatrième case lit une tête de classification : l’encodeur réglé finement du module 4. Delivery obtient 0,979, et toutes les autres destinations 0,004 ou moins. La tête a été entraînée sur les étiquettes de Larkfield. Ici, elle est correcte et sûre.
Façon 1 : évaluer chaque destination
Section intitulée « Façon 1 : évaluer chaque destination »Un modèle de langage traite un jeton (token) à la fois : un mot ou une partie de mot. Il donne une probabilité à chaque jeton suivant possible. Une log-probabilité est le logarithme de cette probabilité : un nombre négatif, plus probable quand il se rapproche de 0. Pour évaluer un nom de destination, additionnez les log-probabilités de ses jetons après la requête. Transformez ensuite les sept scores en probabilités dont la somme est 1. Cette dernière étape est le softmax : élevez e à la puissance de chaque score, puis divisez chaque résultat par leur somme.
Voici le calcul réel pour M-100001, avec toutes les valeurs :
| Destination | Score | escore | ÷ 0,4164 |
|---|---|---|---|
| orders | -6,36 | 0,0017 | 0,004 |
| delivery | -4,03 | 0,0178 | 0,043 |
| returns_refunds | -9,22 | 0,0001 | 0,000 |
| billing | -11,50 | 0,0000 | 0,000 |
| product | -1,52 | 0,2187 | 0,525 |
| account | -2,30 | 0,0999 | 0,240 |
| needs_person | -2,55 | 0,0782 | 0,188 |
La dernière colonne divise chaque valeur de la troisième colonne par leur somme, 0,4164. Ainsi, product obtient 0,2187 ÷ 0,4164 = 0,525. Le modèle se trompe : l’étiquette est delivery (livraison), à 0,043. Mais nous avons maintenant un nombre pour chaque destination, et aucun texte à analyser.
Le cours a mesuré cette méthode sur les 2 000 messages de test. Elle a pris environ 453 ms par message sur un processeur de portable. Le modèle lit la requête une fois, puis fait un court passage pour les sept noms.
Façon 2 : limiter la sortie
Section intitulée « Façon 2 : limiter la sortie »Le décodage contraint laisse le modèle écrire, jeton par jeton, mais retire chaque jeton qui ferait sortir la réponse de la liste. Si la réponse commence par del (le début du nom de destination), seuls les jetons suivants menant à delivery sont permis. La bibliothèque Outlines le fait pour une liste de choix, une expression régulière ou un schéma JSON.
Sur 500 messages de test, Qwen3-0.6B avec Outlines a donné un nom de destination valide pour 100 % des messages. Cela a pris environ 813 ms par message. Il a donné la bonne destination pour 12,8 %. Le décodage contraint corrige la forme de la réponse; il ne donne pas plus de connaissances au modèle.
Façon 3 : lire une tête de classification
Section intitulée « Façon 3 : lire une tête de classification »Une tête de classification est une petite couche au-dessus d’un modèle. Elle prend les nombres du modèle pour le message entier et donne une probabilité par destination. Il faut l’entraîner sur des messages étiquetés. L’encodeur réglé finement du module 4 fait exactement cela. C’est un petit modèle multilingue avec une tête entraînée sur les 6 000 messages d’entraînement de Larkfield. Pour M-100001, il donne 0,979 à delivery. La même idée fonctionne sur un modèle de langage, avec une tête à sept sorties plutôt que la partie prédisant le jeton suivant. Le cours n’en a pas entraîné : l’encodeur montre déjà l’idée.
Les probabilités sont-elles justes?
Section intitulée « Les probabilités sont-elles justes? »Une probabilité est bien étalonnée quand elle correspond à la fréquence des bonnes réponses du modèle. Parmi tous les messages où il annonce 0,8, il devrait avoir raison environ 8 fois sur 10. Pour vérifier, regroupez les messages selon leur probabilité. Comparez la probabilité moyenne de chaque groupe à son exactitude. C’est un tableau de fiabilité et, sous forme de graphique, un diagramme de fiabilité. L’erreur d’étalonnage attendue (ECE) est l’écart moyen entre les deux, pondéré par le nombre de messages de chaque groupe. Le cours d’apprentissage automatique l’explique dans Seuils et calibration. Le module 8 de ce cours vérifie chaque routeur de cette façon, étape par étape. Ici, il nous faut seulement l’idée et un nombre.
Les scores de destination de Qwen3-0.6B ne sont pas bien étalonnés. Sur les messages de test, l’ECE est de 0,390. Le modèle annonce souvent une confiance de 0,6 ou 0,7, mais a raison seulement environ 20 % du temps.
Mise à l’échelle par température
Section intitulée « Mise à l’échelle par température »La mise à l’échelle par température (temperature scaling) corrige l’échelle des probabilités avec un seul nombre, la température. Divisez chaque score par ce nombre avant le softmax. Une température supérieure à 1 rend les probabilités plus uniformes, plus proches de « Je ne suis pas sûr ». Choisissez-la sur les messages de validation : celle dont les probabilités correspondent le mieux à l’exactitude. Ici, c’est 5,0, la valeur maximale de la grille de recherche.
Pour M-100001, les scores divisés par 5 donnent 0,250 à product, 0,214 à account (compte), 0,203 à needs_person (besoin d’une personne) et 0,151 à delivery. L’ordre des destinations ne change pas, donc l’exactitude ne change pas non plus. Seule la confiance change : le modèle dit maintenant qu’il hésite, ce qui est vrai.
- Étalonnage parfait
- Scores des destinations (ECE 0,390)
- Après la mise à l'échelle par température (ECE 0,112)
Description textuelle du graphique
L’axe horizontal représente la probabilité moyenne de la première destination, et l’axe vertical, la proportion de bonnes réponses. Les deux vont de 0 à 1. Une diagonale en pointillés indique l’étalonnage parfait. Avant la mise à l’échelle, il y a sept points, tous bien sous la diagonale. Par exemple, les messages avec une probabilité moyenne de 0,65 ont une bonne réponse 23 % du temps. Ceux à 0,85 ont une bonne réponse 32 % du temps. Ceux à 0,94 ont une bonne réponse 64 % du temps. Après la mise à l’échelle par température, presque tous les messages ont une probabilité entre 0,2 et 0,4. Il y a deux points : 1 630 messages à 0,26, avec une bonne réponse 14 % du temps, et 350 messages à 0,32, avec une bonne réponse 41 % du temps. Les deux sont proches de la diagonale.
La mise à l’échelle par température fait passer l’ECE de 0,390 à 0,112 sur les messages de test. Le modèle reste mauvais en routage, mais maintenant il le dit. Un routeur avec un seuil, comme dans Le coût de chaque erreur, transférerait presque tous ses messages à une personne. Avec ce modèle, c’est la bonne décision.
Larkfield : un petit modèle échoue, un plus grand fait le routage
Section intitulée « Larkfield : un petit modèle échoue, un plus grand fait le routage »Petits LLM locaux présentait les deux modèles locaux et leurs réponses écrites. Voici les trois façons de cette leçon côte à côte, pour Qwen3-0.6B sur les messages de test :
| Façon (Qwen3-0.6B, test) | Réponses valides | Exactitude | Coût par 1 000 | Temps par message |
|---|---|---|---|---|
| Écrire une réponse JSON | 97,2 % | 0,282 | 7 198,3 $ US | 2,1 s |
| Évaluer chaque destination | 100 % | 0,194 | 3 410,0 $ US | 453 ms |
| Limiter la sortie (500 messages) | 100 % | 0,128 | 813 ms |
Les trois coûtent plus cher qu’une personne qui lit tout (1 500 $ US par 1 000 messages). Ce modèle est trop petit pour cette tâche. Évaluer les destinations lui donne une probabilité pour chacune; cela ne rend pas un modèle faible plus fort.
Un plus grand modèle : Qwen2.5-1.5B
Section intitulée « Un plus grand modèle : Qwen2.5-1.5B »Gardez donc la méthode et changez le modèle. Le cours a exécuté Qwen2.5-1.5B-Instruct, un modèle 2,5 fois plus grand, avec le même code, sur un échantillon de 500 messages de test (les 500 premiers par identifiant de message). Petits LLM locaux présente l’échantillon et ses intervalles à 95 %. Sur cet échantillon, évaluer les destinations double l’exactitude : 0,734 (intervalle à 95 % de 0,694 à 0,771), contre 0,368 pour la réponse écrite. Chaque réponse évaluée est une destination valide, alors que 20,2 % des réponses écrites n’étaient pas du JSON valide. Demander une décision a éliminé la difficulté d’écrire une réponse bien formée.
Une réserve rend cette comparaison moins nette qu’elle en a l’air. Les deux façons n’utilisaient pas la même requête. La réponse écrite avait seulement les noms de destination. Les scores de destination utilisaient une requête décrivant aussi chaque destination en une ligne. Une partie du gain peut donc venir des descriptions. Considérez que « double » décrit le résultat des deux changements combinés.
Ce n’est toujours pas un routeur pour Larkfield. Il n’envoie aucune prise de contrôle de compte à account, prend 7,7 secondes par message et ses scores ne sont pas bien étalonnés (ECE de 0,161). La méthode reste toutefois applicable : le même code évalue tout modèle ouvert dont vous pouvez lire les log-probabilités.
Quand utiliser chaque façon
Section intitulée « Quand utiliser chaque façon »| Façon | Utilisez-la quand | Son coût |
|---|---|---|
| Évaluer chaque destination | Vous pouvez exécuter le modèle et lire ses log-probabilités (poids ouverts, modèle local) | Un passage par message, plus les noms d’étiquette; vous devez l’étalonner |
| Limiter la sortie | Vous avez besoin d’une réponse valide d’un modèle qui écrit, par exemple un modèle hébergé avec un schéma | Aucun gain d’exactitude : valide ne veut pas dire correct |
| Tête de classification | Vous avez des messages étiquetés et pouvez entraîner le modèle | Temps d’entraînement et étiquettes; ensuite, la plus rapide et la mieux étalonnée ici |
Beaucoup de LLM hébergés donnent les log-probabilités seulement pour les quelques jetons les plus probables, ou pas du tout. Dans ce cas, les scores de destination sont impossibles, et un schéma est le mieux que vous puissiez obtenir. C’est le problème qui ouvre la prochaine leçon.
Exercice guidé : évaluer les destinations
Section intitulée « Exercice guidé : évaluer les destinations »- Ouvrez le carnet depuis l’encadré Faites cette leçon dans un carnet Jupyter en haut de cette page.
- Exécutez les cellules de préparation. Elles installent les paquets et téléchargent les données. La cellule de données se termine par
Ready: 10000 messages (6000 train, 2000 validation, 2000 test), all synthetic.(prêt : 10 000 messages, dont 6 000 d’entraînement, 2 000 de validation et 2 000 de test, tous synthétiques). - Dans la section 1, exécutez la cellule. Elle télécharge Qwen3-0.6B (environ 1,5 Go, une seule fois) et affiche la fin de la requête.
- Dans la section 2, écrivez votre prédiction. Exécutez ensuite la cellule. Vous voyez sept probabilités, avec
producten premier à0.525. - Dans la section 3, exécutez la cellule. Elle évalue 100 messages de test, à environ 1 seconde par message. L’exactitude est d’environ
0.27. - Dans la section 4, exécutez la cellule. Vous voyez l’exécution complète du cours, avec une ECE de
0.1116après la mise à l’échelle par température.
Ajouter les méthodes enregistrées au projet
Section intitulée « Ajouter les méthodes enregistrées au projet »Votre projet peut maintenant rejouer les réponses de chaque méthode enregistrée par le cours. Ce sont les modèles de plongement (embedding) et l’encodeur réglé finement du module 4, les modèles zéro exemple, le LLM hébergé et le modèle local. Leurs fichiers sont dans data/predictions/ et data/recordings/, téléchargés par get_data.py. Vous ajoutez le code qui les lit et la commande route llm, qui affiche une réponse enregistrée de LLM.
-
Dans votre dossier de projet
larkroute, avec.venvactif, copiez les fichiers de l’instantanéend-of-m06:Fenêtre de terminal S=../nextia-learning-labs/C36/snapshots/end-of-m06cp "$S/larkroute/llm.py" larkroute/cp "$S/larkroute/commands/llm.py" larkroute/commands/cp "$S/larkroute/methods/recorded.py" larkroute/methods/cp "$S/tests/test_llm.py" "$S/tests/test_recorded.py" tests/Fenêtre de terminal $S = "..\nextia-learning-labs\C36\snapshots\end-of-m06"Copy-Item "$S\larkroute\llm.py" larkroute\Copy-Item "$S\larkroute\commands\llm.py" larkroute\commands\Copy-Item "$S\larkroute\methods\recorded.py" larkroute\methods\Copy-Item "$S\tests\test_llm.py", "$S\tests\test_recorded.py" tests\ -
Exécutez les tests. La dernière ligne est
23 passed(23 tests réussis).Fenêtre de terminal python -m pytest -q -
Affichez la réponse enregistrée du LLM sans exemples pour le message de cette leçon :
Fenêtre de terminal route llm M-102840 --mode zero-shotM-102840 (en, chat): Can I return the storage box if I don’t like the colour?Label: productRecorded answer of chat-small (gpt-6-luna-2026-09-22) (zero-shot): returns_refunds, stated confidence 0.99, reason: Asks about returning a product due to its colour.Tokens: 160 in, 33 out; cost 0.032 dollars per 1,000 such messages; 2.00 s. (A replayed answer: no call was made.) -
Affichez la réponse du LLM avec exemples pour le même message :
Fenêtre de terminal route llm M-102840M-102840 (en, chat): Can I return the storage box if I don’t like the colour?Label: productRecorded answer of chat-small (gpt-6-luna-2026-09-22) (few-shot): product, stated confidence 0.99, reason: Asks about return eligibility based on colour preference.Tokens: 545 in, 30 out; cost 0.069 dollars per 1,000 such messages; 1.35 s. (A replayed answer: no call was made.)
Les deux réponses annoncent 0,99, et une seule est correcte. « Confiance déclarée » désigne le nombre écrit par le modèle. route llm rejoue un enregistrement, donc aucun message ne quitte votre ordinateur.
À vous de jouer : l’étalonnage de l’encodeur
Section intitulée « À vous de jouer : l’étalonnage de l’encodeur »Changez une chose : au lieu du modèle local, vérifiez l’encodeur réglé finement du module 4. Dans la section 5 du carnet Jupyter, calculez son erreur d’étalonnage attendue sur les messages de test. Utilisez data/predictions/encoder-finetuned.csv et placez le résultat dans ece_encoder. Avant de l’exécuter, faites une prédiction : meilleur ou moins bon que le modèle local après mise à l’échelle (0,112)?
Afficher la réponse
enc = pd.read_csv("data/predictions/encoder-finetuned.csv").set_index("message_id").loc[test["message_id"]]_, ece_encoder = rt.reliability(enc["confidence"], enc["prediction"].to_numpy() == test["route"].to_numpy())print(ece_encoder)0.0313Beaucoup mieux : 0,031 sans aucune mise à l’échelle, et une réponse correcte pour 98,0 % des messages de test. Une tête entraînée sur les étiquettes de Larkfield donne à la fois une bonne destination et une probabilité fiable.
Erreur courante
Un JSON valide, et une confiance de 0
Symptôme : Tomás exécute Qwen3-0.6B avec la requête du LLM hébergé et vérifie les réponses. Dans 97,2 % des cas, le JSON est valide et contient une destination et une confiance. « Bien, dit-il, on garde les réponses dont la confiance dépasse 0,5. » Il constate que la plupart des réponses ont une confiance de 0.
Cause : le modèle a écrit "confidence": 0 (confiance de 0) dans 1 271 de ses 1 945 réponses valides. Sa destination était correcte pour 13,8 % de ces réponses. Il a aussi écrit 0,7 pour 276 messages et 1,0 pour 169. Un petit modèle reproduit la forme de réponse demandée par la requête; le nombre qu’il y inscrit signifie peu. Une vérification du JSON confirme la forme, pas le contenu.
Solution : n’utilisez pas une confiance écrite comme probabilité avant de la vérifier sur des messages étiquetés avec un tableau de fiabilité. Mieux encore, demandez une décision : attribuez un score aux destinations, ou utilisez une tête entraînée. Étalonnez ensuite le résultat sur les données de validation.
Conséquence dans le travail en IA : les équipes établissent des seuils à partir d’un champ de confiance qui ressemble seulement à une probabilité. Sans vérification de l’étalonnage, le seuil transfère les mauvais messages aux personnes.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Expliquez la différence entre demander à un modèle d'écrire sa réponse et lui demander une décision, avec les chiffres de cette leçon.
Afficher la réponse
Quand le modèle écrit, vous obtenez du texte. Ce texte n’est pas toujours une destination : seulement 93 % des réponses courtes de Qwen3-0.6B étaient des noms exacts de destinations. Sa confiance est un nombre écrit : le LLM sans exemples a écrit 0,99 et s’est trompé sur M-102840. Quand vous demandez une décision, vous obtenez toujours une destination valide. Avec des scores ou une tête, vous obtenez aussi une probabilité pour chaque destination. Vous pouvez la vérifier avec un tableau de fiabilité.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
La mise à l'échelle par température a fait passer l'ECE des scores de destination de 0,390 à 0,112. L'exactitude est toutefois restée à 0,194. Pourquoi l'exactitude n'a-t-elle pas changé, et pourquoi la mise à l'échelle reste-t-elle utile?
Afficher la réponse
Diviser chaque score par la même température conserve leur ordre. La première destination et l’exactitude restent donc les mêmes. Seules les probabilités changent : elles se rapprochent, surtout entre 0,2 et 0,4, et sont maintenant fiables. Un routeur doté d’un seuil transfère alors ces messages à une personne. Il ne se fie plus à des réponses erronées qui semblaient sûres à 0,6 ou 0,7.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : après l'étape du projet, quelle commande affiche une réponse enregistrée du LLM? Que montre-t-elle pour M-102840 sans exemples?
Afficher la réponse
route llm M-102840 --mode zero-shot. Elle affiche le message, son étiquette product (produit) et la réponse enregistrée : returns_refunds (retours et remboursements). Elle montre une confiance déclarée de 0,99, ainsi que les jetons, le coût et le temps. Elle indique qu’aucun appel n’a été fait. python -m pytest -q affiche 23 passed (23 tests réussis).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un routeur a besoin d’une destination de la liste et d’une probabilité fiable. Une réponse écrite ne garantit ni l’une ni l’autre.
- Trois façons d’obtenir une décision : attribuer un score à chaque destination (log-probabilités et une fonction softmax), contraindre la sortie (Outlines), ou lire une tête de classification.
- Vérifiez chaque probabilité avec un tableau de fiabilité et l’ECE. La mise à l’échelle par température corrige l’échelle avec un seul nombre choisi sur les données de validation : ici, 0,390 → 0,112.
- Une réponse valide n’est pas une réponse correcte. Qwen3-0.6B est trop petit pour cette boîte de réception : 0,282 avec les réponses écrites, 0,194 avec les scores de destination, 0,128 avec Outlines.
- Avec un modèle plus grand, Qwen2.5-1.5B, les scores de destination doublent l’exactitude des réponses écrites sur un échantillon de 500 messages (0,734 contre 0,368). Il manque encore tous les cas de prise de contrôle d’un compte.
- Votre projet réexécute maintenant toutes les méthodes enregistrées :
route llmet 23 tests.
Vous pouvez maintenant obtenir une vraie décision d’un modèle que vous exécutez vous-même. Mais vous ne pouvez pas lire les log-probabilités de la plupart des modèles hébergés. Ensuite, vous examinerez des modèles que les entreprises construisent pour donner des décisions typées. Vous apprendrez aussi à vérifier les affirmations de tout nouveau modèle sur vos propres messages.
Leçon suivante : Des modèles de décision spécialisés