
Priorité, urgence et langue
- Leçon 30
- 30 min
- Module 7 : Des formes d'étiquettes plus difficiles
Où nous en sommes
Nous acheminons chaque message à la bonne équipe. L'équipe doit aussi connaître son urgence et sa langue. Dans cette leçon, nous entraînons un modèle distinct pour la priorité, détectons la langue et ajoutons des règles pour les mots qui indiquent toujours une urgence.
Leçon 30 sur 37 · Classification et routage de textes : envoyer chaque message au bon endroitPriorité, urgence et langue
1. Le problème du routage et son coût
2. Des étiquettes fiables
3. Références de base : règles et modèles classiques
4. Plongements et petits modèles réglés finement
5. Les LLM comme classificateurs
6. Modèles de décision, cascades et distillation
7. Des formes d'étiquettes plus difficiles
8. La confiance et les personnes dans la boucle
9. Exploiter le routeur en production
Ce que vous saurez faire
Ajoutez une priorité et une langue à la destination de chaque message. La bonne personne pourra ainsi répondre en premier, dans la bonne langue. La destination seule indique qui répond, pas dans quel délai ni dans quelle langue.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient toutes les cellules de code, tâches et vérifications de cette leçon. Il entraîne un modèle de priorité, teste une règle pour les mots urgents et combine les deux. Ensuite, il entraîne un détecteur de langue, examine ses désaccords et compare le routeur sur les messages anglais et français. Ses cellules de préparation installent pandas et scikit-learn et téléchargent les données d’exercice. Aucune configuration locale n’est donc nécessaire. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- La précision et le rappel, dans Les métriques de classification du cours Apprentissage automatique : du problème à un modèle fiable. Une matrice de confusion compte, pour chaque vraie étiquette, combien de fois le modèle a donné chaque réponse.
- Les groupes de lettres (n-grammes de caractères), dans Le texte en nombres : sac de mots et TF-IDF.
- Les expressions régulières, dans Règles par mots-clés et expressions régulières.
- Bayes naïf, dans Bayes naïf, régression logistique et SVM linéaire.
- La consigne sur les mentions en passant, dans Guide d’étiquetage.
Ce qu’il vous faut sur votre ordinateur : rien pour cette leçon. Le carnet s’exécute dans Colab, Kaggle ou VS Code. Le projet ne change pas dans ce module.
Testé sur macOS avec Python 3.12, pandas 3.1.1 et scikit-learn 1.9.1.
Trois questions sur une lettre
Section intitulée « Trois questions sur une lettre »Au bureau de poste, la commis pose trois questions sur chaque lettre. Chacune a son propre indice. L’adresse indique quelle camionnette la transporte. Un timbre rouge express indique qu’elle part en premier. Dans une ville bilingue, la langue sur l’enveloppe indique quel comptoir rappelle le client.
Les trois questions sont indépendantes. Une lettre express peut aller n’importe où dans la ville. Une lettre en français peut être urgente ou non. La commis ne cherche donc pas un indice combiné, comme « camionnette nord, express, français ». Elle répond à chaque question séparément.
Le problème : la destination indique qui répond, pas dans quel délai
Section intitulée « Le problème : la destination indique qui répond, pas dans quel délai »Le routeur de Larkfield répond à la première question : quelle équipe. Les équipes ont aussi besoin des deux autres réponses.
- Priorité. Chaque message est
urgent(urgent),normal(normal) oulow(faible priorité). Les données de test contiennent 372 messages urgents, 1 275 normaux et 353 de faible priorité. Un message urgent qui attend dans une pile normale coûte cher. Le tableau des coûts attribue 20 $ US à un message urgent dans la mauvaise file d’attente. C’est cinq fois le coût d’un message normal. - Langue. 29 % des messages de test sont en français. Larkfield a des agents francophones, comme Chloé. Un message français envoyé à un agent qui lit seulement l’anglais attend ou reçoit une mauvaise réponse.
Pourquoi pas une étiquette combinée, comme delivery-urgent-fr? Sept destinations × trois priorités × deux langues donnent 42 étiquettes. Beaucoup auraient très peu de messages d’entraînement : les données de test contiennent un seul message urgent sur les produits. Trois petites questions, chacune avec beaucoup d’exemples, sont plus faciles à apprendre.
L’idée : un modèle par question
Section intitulée « L’idée : un modèle par question »Chaque question a donc son modèle, entraîné sur les mêmes messages avec une colonne d’étiquettes différente. Le modèle d’équipe lit route, le modèle de priorité lit priority et le détecteur de langue lit language. Leurs trois réponses déterminent ensuite la file ensemble.

Description textuelle du diagramme
À gauche, un message français : « Bonjour, mon colis LK-… devait arriver hier, j’en ai besoin aujourd’hui pour un cadeau ». Trois flèches mènent à trois modèles. Le modèle d’équipe, avec 7 destinations, répond livraison. Le modèle de priorité, avec la règle des mots urgents, répond urgent. Le détecteur de langue répond fr. Les trois réponses mènent à une case : agents de livraison francophones, en tête de leur file.
Un modèle distinct pour la priorité
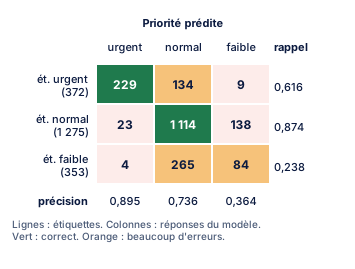
Section intitulée « Un modèle distinct pour la priorité »Priya entraîne un modèle de priorité : TF-IDF avec régression logistique, comme pour la destination, mais sur la colonne priority. Son exactitude sur les messages de test est de 0,714. Le routeur atteint 0,962 sur cette boîte de réception. La priorité est donc beaucoup plus difficile. Pourquoi? La matrice de confusion montre où se trouvent les erreurs.
Description textuelle du diagramme
Un tableau avec trois lignes et trois colonnes. Les lignes représentent l’étiquette; les colonnes représentent la réponse du modèle, dans l’ordre urgent, normal, faible priorité. Ligne urgent (372 messages) : 229 réponses urgent, 134 normal, 9 faible priorité; rappel 0,616. Ligne normal (1 275) : 23 urgent, 1 114 normal, 138 faible priorité; rappel 0,874. Ligne faible priorité (353) : 4 urgent, 265 normal, 84 faible priorité; rappel 0,238. Sous les colonnes, la précision de chaque réponse : urgent 0,895, normal 0,736, faible priorité 0,364. Les cellules de la diagonale sont les bonnes réponses. Les deux plus grandes erreurs sont 134 messages urgents lus comme normaux et 265 messages de faible priorité lus comme normaux.
Lisez-la ligne par ligne. Presque toutes les erreurs touchent des catégories voisines. Un message urgent est lu comme normal (134), ou un message de faible priorité comme normal (265). Urgent et faible priorité ne sont presque jamais inversés (9 et 4). C’est logique : l’urgence est une question de degré. « J’en ai besoin d’ici vendredi » se situe entre normal et urgent. Deux personnes pourraient l’étiqueter différemment.
Pour Grace, une ligne compte surtout : celle des messages urgents. Sur 372 messages urgents, le modèle en trouve 229 : rappel urgent de 0,616. Quand il dit « urgent », il a raison 229 fois sur 256 : précision de 0,895. Il est donc prudent et manque plus du tiers des messages urgents.
Une règle pour les mots qui indiquent toujours une urgence
Section intitulée « Une règle pour les mots qui indiquent toujours une urgence »Certains mots indiquent presque toujours une urgence : « urgent », « today », « immediately », « right now » en anglais, et aujourd’hui, tout de suite, urgence en français. Une expression régulière les trouve :
URGENT_WORDS = re.compile(r"\b(?:urgent\w*|asap|today|tonight|immediately|right now|urgence|aujourd'hui|" r"imm[ée]diatement|tout de suite|vite)\b", re.I)rule_urgent = test["text"].str.contains(URGENT_WORDS).to_numpy()La règle correspond à 132 messages de test. Parmi eux, 127 sont urgents : précision de 0,962. Mais elle trouve seulement 127 des 372 messages urgents : rappel de 0,341. Beaucoup de clients pressés n’écrivent jamais « urgent ». Ils écrivent « my order is missing and it was a gift for tomorrow ».
Toutes les valeurs : le modèle ou la règle
Section intitulée « Toutes les valeurs : le modèle ou la règle »Grace demande : « Marquez un message urgent si le modèle le dit ou si la règle correspond. » Faites le compte :
- Le modèle marque 256 messages, dont 229 correctement. La règle correspond à 132 messages, dont 127 correctement.
- Le modèle marque déjà la plupart des messages qui correspondent à la règle. Ensemble, ils marquent 266 messages, dont 235 urgents.
- Rappel : 235 ÷ 372 = 0,632. Précision : 235 ÷ 266 = 0,883.

Description textuelle du diagramme
Trois paires de barres horizontales. Les barres bleues représentent le rappel, sur les 372 messages urgents de test; les barres orange représentent la précision. Règle des mots urgents : rappel 0,341 (127 sur 372), précision 0,962 (127 sur 132). Modèle de priorité : rappel 0,616 (229 sur 372), précision 0,895 (229 sur 256). Modèle ou règle : rappel 0,632 (235 sur 372), précision 0,883 (235 sur 266).
La règle ajoute seulement 6 messages urgents que le modèle a manqués. Alors pourquoi la garder? Parce qu’elle est certaine et facile à expliquer. Si un client écrit « aujourd’hui », le message passe en premier, et un agent peut voir pourquoi. Un modèle peut perdre un mot comme celui-là après un réentraînement. Une règle ne le peut pas.
Les mentions en passant augmentent la priorité
Section intitulée « Les mentions en passant augmentent la priorité »Le Guide d’étiquetage établit une autre règle. Un problème de sécurité, une menace juridique ou une prise de contrôle de compte mentionnés en passant ne changent pas la destination. Cela augmente la priorité du message, et une personne le signale. La priorité assure donc une partie de la protection. Le signalement de prise de contrôle de la leçon Le déséquilibre et les classes rares a aussi sa place ici : un message signalé passe en tête de file.
Détecter la langue
Section intitulée « Détecter la langue »La question de la langue est beaucoup plus facile. Un détecteur de langue n’a pas besoin de comprendre un message. Il examine des groupes de lettres : ou, é, qu', the, ing. Ces groupes sont très différents en anglais et en français. Un modèle Bayes naïf sur des groupes de 1 à 3 lettres suffit. Priya l’entraîne sur la colonne language des 6 000 messages d’entraînement.
Toutes les valeurs pour une phrase
Section intitulée « Toutes les valeurs pour une phrase »Pour la phrase « Mon colis n’est pas arrivé », le détecteur donne fr 0,985 et en 0,015. Les lettres é, n', est et pas n’apparaissent presque jamais dans les messages anglais.
Sur les 2 000 messages de test, le détecteur est d’accord avec l’étiquette 1 995 fois : exactitude de 0,9975. Priya lit les 5 désaccords. Le cas d’échec ci-dessous montre ce qu’elle trouve.
Les messages français reçoivent-ils le même service?
Section intitulée « Les messages français reçoivent-ils le même service? »La colonne de langue permet aussi à Priya de vérifier le routeur pour chaque langue. C’est une tranche : la même mesure, sur une partie des données. Sur les messages de test de cette boîte de réception, le routeur atteint 0,966 en anglais (1 411 messages) et 0,952 en français (589). La tranche française est un peu plus faible. La différence est de 1,4 point sur 589 messages, soit environ 8 messages. C’est peu, mais elle continue de la surveiller avec chaque nouveau modèle.
Une fois la langue connue, la règle de file est simple : un message français va aux agents francophones de son équipe. Chloé lit les messages français qui ont besoin d’une personne.
Quand utiliser des modèles distincts
Section intitulée « Quand utiliser des modèles distincts »- Utilisez un modèle distinct pour chaque question dont la réponse ne dépend pas des autres : destination, priorité, langue. Chacun a plus d’exemples d’entraînement qu’une étiquette combinée.
- Ajoutez une règle pour les mots qui doivent toujours compter, même si le modèle les manque : mots urgents, rappel de produit, mot juridique. Gardez peu de règles, faciles à lire.
- Faites moins confiance à la priorité qu’à la destination. Sur cette boîte de réception, la priorité atteint 0,714 contre 0,962 pour la destination. C’est une question de degré. Utilisez-la pour ordonner une file, pas pour cacher un message.
- Un détecteur de langue coûte peu et est très exact entre deux langues d’apparence différente. Il peut échouer pour des langues qui partagent la plupart des lettres ou pour des messages très courts. Testez-le sur vos propres données.
- Ce que cela coûte : trois modèles au lieu d’un, chacun avec ses vérifications, et quelques règles à maintenir. Ici, chacun s’entraîne en quelques secondes.
Exercice guidé : trois réponses dans le carnet
Section intitulée « Exercice guidé : trois réponses dans le carnet »- Ouvrez le carnet depuis l’encadré Faites cette leçon dans un carnet Jupyter en haut de cette page.
- Exécutez les cellules de préparation. La cellule de données se termine par
Ready: 10000 messages (6000 train, 2000 validation, 2000 test), all synthetic.(prêt : 10 000 messages, dont 6 000 d’entraînement, 2 000 de validation et 2 000 de test, tous synthétiques). - Dans la section 1, exécutez la cellule. Vous voyez une exactitude de
0.714et la matrice de confusion. - Dans la section 2, exécutez la cellule. Vous voyez un rappel urgent de
0.616et une précision de0.895. - Dans la section 3, exécutez la règle. Vous voyez un rappel de
0.341et une précision de0.962. - Dans la section 5, exécutez le détecteur de langue. Vous voyez
language accuracy 0.9975, 5 disagreements(exactitude de la langue de 0,9975, 5 désaccords). - Dans la section 6, exécutez la cellule. Vous voyez
0.966pour l’anglais et0.952pour le français.
À vous de jouer : le modèle ou la règle
Section intitulée « À vous de jouer : le modèle ou la règle »Dans la section 4 du carnet, marquez un message urgent quand le modèle dit urgent ou que la règle correspond. Calculez le rappel et la précision de cette combinaison, arrondis à 3 décimales. Avant d’exécuter le code, faites une prédiction : le rappel augmentera-t-il beaucoup?
Afficher la réponse
both = model_urgent | rule_urgentboth_recall = round(float(both[urgent].mean()), 3)both_precision = round(float(urgent[both].mean()), 3)print(both_recall, both_precision)0.632 0.883Le rappel passe seulement de 0,616 à 0,632. La précision baisse un peu, de 0,895 à 0,883. Le modèle trouve déjà la plupart des messages qui contiennent un mot urgent. La règle mérite quand même d’être conservée pour sa certitude, pas pour son rappel.
Erreur courante
Les erreurs du détecteur sont celles des étiquettes
Symptôme : le détecteur de langue est en désaccord avec l’étiquette sur 5 messages de test. Tomás veut annoncer « 5 erreurs » et essayer un modèle plus grand.
Cause : Priya lit les 5 messages. Quatre sont étiquetés en, mais écrits en français, comme M-100856 : « Bonjour, je n’ai toujours pas reçu mon toaster… ». Un est étiqueté fr, mais écrit en anglais (M-108940). Le détecteur a raison chaque fois. Les étiquettes sont fausses. Ici, ce sont des erreurs du programme qui a créé cette boîte de réception d’exercice. Dans une vraie boîte de réception, elles viennent d’un champ de langue choisi par le client ou d’une valeur par défaut.
Correction : corrigez les 5 étiquettes avant de vous fier aux tranches par langue. Ensuite, utilisez le détecteur, pas le champ enregistré, pour choisir la file.
Conséquence pour le travail en IA : lorsqu’un modèle simple et performant « échoue » sur quelques exemples, lisez-les avant de changer le modèle. Un désaccord est souvent une erreur d’étiquette. C’est la même idée que la recherche d’étiquettes bruitées dans Trouver les étiquettes bruitées.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Le modèle de priorité a raison sur 0,714 des messages de test. Presque toutes ses erreurs touchent des catégories voisines (urgent ↔ normal, normal ↔ faible priorité). Expliquez pourquoi ce résultat est moins mauvais que l'exactitude le suggère, et quelle erreur compte encore le plus.
Afficher la réponse
La priorité est une question de degré. Un message entre normal et urgent peut donc raisonnablement aller d’un côté ou de l’autre. Deux personnes pourraient l’étiqueter différemment. Un message de faible priorité lu comme normal (265) monte seulement un peu dans la file. Urgent et faible priorité ne sont presque jamais inversés (9 et 4). L’erreur qui compte encore le plus est un message urgent lu comme normal : 134 sur 372. Chacun attend comme un message normal. Le tableau des coûts attribue 20 $ US à un message urgent dans la mauvaise file.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Faites une prédiction : vous ajoutez la règle des mots urgents au modèle de priorité (modèle ou règle). Le rappel augmentera-t-il beaucoup? Qu'ajoute la règle, sinon du rappel?
Afficher la réponse
Non. Sur cette boîte de réception, le rappel passe seulement de 0,616 à 0,632. La règle trouve 127 messages urgents, et le modèle les marque déjà tous sauf 6. La règle ajoute de la certitude et une raison claire. Un message qui dit « aujourd’hui » passe toujours en premier, même après un réentraînement. Un agent peut voir pourquoi. Sa précision est élevée (0,962), donc elle ajoute très peu de fausses alertes.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
En pratique : votre détecteur de langue est en désaccord avec la langue enregistrée sur 0,25 % des messages. Que faites-vous avant de présenter ce chiffre comme le taux d'erreur du détecteur?
Afficher la réponse
Lisez les messages où ils sont en désaccord. Sur les données de test de Larkfield, les 5 désaccords étaient des erreurs d’étiquette. Quatre messages étiquetés en étaient écrits en français, et un étiqueté fr était en anglais. Si le détecteur a raison, corrigez les étiquettes et signalez que le champ enregistré est faux, pas le détecteur. Ensuite, utilisez le détecteur pour choisir la file française ou anglaise.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- La destination, la priorité et la langue sont trois questions distinctes, chacune avec son modèle et les mêmes messages.
- Le modèle de priorité atteint 0,714 sur cette boîte de réception; rappel urgent de 0,616, précision de 0,895. Ses erreurs touchent surtout des catégories voisines.
- Une règle des mots urgents a une précision de 0,962 et un rappel de 0,341. Modèle ou règle : rappel de 0,632, précision de 0,883. La règle ajoute surtout de la certitude, plutôt que du rappel.
- Un détecteur de langue sur des groupes de lettres concorde avec l’étiquette sur 0,9975 des messages de test. Ses 5 désaccords sont des erreurs d’étiquette. Le routeur atteint 0,966 en anglais et 0,952 en français.
Vous pouvez maintenant répondre à trois questions : qui, dans quel délai et dans quelle langue. Mais chaque équipe a aussi ses propres sujets. Les étiquettes de destination et de sujet forment un arbre. Ensuite, nous nous demandons si un modèle devrait suivre cet arbre.
Leçon suivante : Les étiquettes hiérarchiques