
Tester comme dans le futur : le test rétrospectif
- Leçon 9
- 35 min
- Module 3 : Références de base et tests honnêtes
Où nous en sommes
Nous avons quatre prévisions simples, mais nous ne les avons pas encore testées équitablement. Une séparation aléatoire laisse le futur entrer dans l'entraînement. Dans cette leçon, nous testons les prévisions comme le futur le fera : avec un test rétrospectif à origine glissante. Il utilise plusieurs dates de coupure. Pensez d'abord à la façon de tester un prévisionniste météo.
Leçon 9 sur 27 · Prévision et séries chronologiques : prévoir la suiteTester comme dans le futur : le test rétrospectif
1. Les prévisions servent des décisions
2. Lire une série chronologique
3. Références de base et tests honnêtes
4. Méthodes statistiques
5. Méthodes par apprentissage automatique
6. Séries difficiles et séries nombreuses
7. L'incertitude et la décision
8. Exploiter une prévision en production
Ce que vous saurez faire
Testez une prévision comme le futur la testera. Coupez l’historique à plusieurs dates passées, prévoyez les jours après chaque coupure et évaluez l’ensemble. Une séparation aléatoire laisse le futur entrer dans l’entraînement. La prévision semble alors meilleure qu’elle ne le sera.
Carnet JupyterFaites cette leçon dans un carnet
Le carnet (notebook) Jupyter contient chaque cellule de code, tâche et vérification de cette leçon. Il exécute un test rétrospectif à la main et montre les dates de coupure du cours. Il teste le parasol à 13 dates et compare une séparation aléatoire à un test rétrospectif honnête. Ses cellules de préparation installent les paquets et téléchargent les données de Larkfield. Aucune configuration locale n’est donc nécessaire. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les quatre prévisions naïves et l’utilitaire
backtest.py, présentés dans Prévisions naïves. - Les ventes d’hier prédisent celles d’aujourd’hui (autocorrélation), présenté dans Hier prédit aujourd’hui.
- Données d’entraînement et de test : vous jugez un modèle sur des données dont il n’a pas appris. Consultez Données d’entraînement, de validation et de test dans le cours sur l’apprentissage automatique.
Ce qu’il vous faut sur votre ordinateur
Rien : le carnet fonctionne dans Colab ou Kaggle. La section 4 du carnet installe aussi scikit-learn.
Testé avec Python 3.12, pandas 2.3.3, statsforecast 2.1.1 et scikit-learn 1.9.1, dans Jupyter sur macOS.
Comment tester un prévisionniste météo
Section intitulée « Comment tester un prévisionniste météo »Vous voulez savoir si un prévisionniste météo est bon, sans attendre une année entière. Vous trouvez donc de vieux journaux. Vous prenez la prévision publiée un lundi et la comparez à la météo des jours qui suivent ce lundi.
Deux règles rendent ce test équitable. D’abord, la prévision doit être publiée avant que la météo se produise. Un « prévisionniste » qui écrit après avoir lu le bulletin météo semble parfait, mais ne vous apprend rien. Ensuite, un seul journal ne suffit pas. Pendant une semaine calme et ensoleillée, tous les prévisionnistes semblent bons. Vous vérifiez donc plusieurs lundis répartis sur l’année entière.
Les prévisions de Larkfield ont besoin des deux mêmes règles. Vous avez brièvement vu ce test dans Découvrir les données de Larkfield, avec deux applications météo. Cette leçon montre ce qui arrive quand on enfreint la première règle. Elle construit ensuite un test qui respecte les deux.
Le problème : une séparation aléatoire laisse entrer le futur
Section intitulée « Le problème : une séparation aléatoire laisse entrer le futur »Dans le cours sur l’apprentissage automatique, on teste souvent un modèle avec une séparation aléatoire. Vous mélangez les lignes et en gardez 20 % comme données de test. Cela fonctionne quand les lignes ne dépendent pas les unes des autres. Les ventes, elles, dépendent les unes des autres : les ventes d’hier prédisent celles d’aujourd’hui. Hier prédit aujourd’hui montrait un premier cas : une règle qui lisait les jours voisins de chaque jour de test.
Tomás teste un modèle de cette façon. C’est un modèle d’amplification de gradient (gradient boosting), du même type que celui construit dans le cours sur l’apprentissage automatique. Ses entrées sont les ventes d’il y a 1, 7 et 14 jours, le jour de la semaine et l’indicateur de promotion. Il mélange les jours des 50 produits du cours et en garde 20 % pour le test :
d = sales.sort_values(["unique_id", "ds"]).copy()g = d.groupby("unique_id")["y"]d["lag1"], d["lag7"], d["lag14"] = g.shift(1), g.shift(7), g.shift(14)d["dow"] = d.ds.dt.dayofweekd = d.dropna()X, y = d[["lag1", "lag7", "lag14", "dow", "on_promotion"]], d["y"]Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.2, random_state=35)model = HistGradientBoostingRegressor(random_state=35).fit(Xtr, ytr)print("random 20% test, WAPE %:", round(float(100 * np.abs(yte - model.predict(Xte)).sum() / yte.sum()), 1))shift(1) décale les ventes d’un jour vers le bas. Chaque ligne reçoit donc les ventes du jour précédent. On appelle ces colonnes des variables décalées : lag1 contient les ventes d’hier, et lag7, celles d’une semaine auparavant. La sortie :
random 20% test, WAPE %: 40.4Une WAPE de 40,4 % bat toutes les prévisions naïves de la dernière leçon (la meilleure atteignait 43,5 %). Mais regardez ce que le test aléatoire permettait :
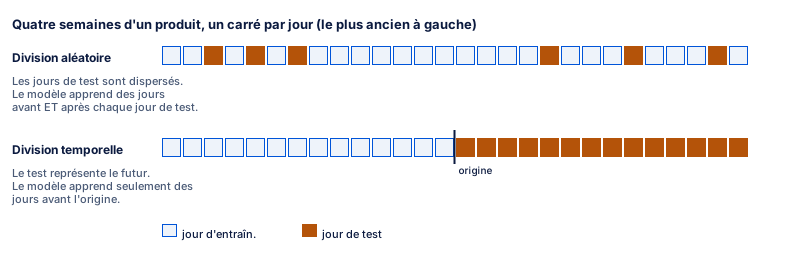
Description textuelle du diagramme
L’image montre quatre semaines d’un produit sous forme de deux rangées de 28 carrés, un par jour. Dans la rangée du haut, la séparation aléatoire place six carrés de test orange parmi les carrés d’entraînement bleus. Le modèle apprend des jours qui entourent chaque jour de test. Dans la rangée du bas, la séparation chronologique commence par 14 jours d’entraînement bleus. Une ligne noire marque l’origine, suivie de 14 jours de test orange.
Un jour de test a des jours d’entraînement de chaque côté. Son entrée lag1 contient les ventes réelles du jour précédent. Le lundi de Kenji, personne ne connaît les ventes du parasol pour le deuxième jeudi. Le test vérifie une situation qui ne se produit jamais.
Priya exécute la version honnête. À chaque date de coupure du cours, le même type de modèle apprend seulement des jours jusqu’à cette date. Pour une prévision de 14 jours, il peut seulement utiliser des ventes datant d’au moins 14 jours. Ici, celles d’il y a 14 et 21 jours.
honest 14-day backtest, WAPE %: 47.1Description textuelle du graphique
Un diagramme à deux colonnes sur un axe de 0 à 60 %. Le test aléatoire de 20 % donne une WAPE de 40,4 %. Le test rétrospectif honnête de 14 jours du même type de modèle donne 47,1 %.
Le modèle n’a pas empiré. Le test est devenu honnête. Maintenant, le modèle perd contre une simple moyenne sur 28 jours (43,5 %). Cette erreur est une forme de fuite de données. L’information parvient au modèle depuis un endroit interdit, ici le futur.
L’idée : un test rétrospectif à origine glissante
Section intitulée « L’idée : un test rétrospectif à origine glissante »Un test rétrospectif (backtest) teste une prévision sur le passé, comme si ce passé était le futur. Il reproduit le test du prévisionniste météo :
- Choisissez une date de coupure dans le passé. On l’appelle origine de la prévision, ou simplement origine. La prévision part de cette date, et la méthode peut seulement voir les jours jusqu’à celle-ci.
- Donnez à la méthode tous les jours jusqu’à l’origine. Elle en apprend : c’est sa fenêtre d’entraînement.
- Demandez une prévision pour les h prochains jours. h est l’horizon.
- Comparez la prévision aux ventes réelles de ces jours.
- Avancez l’origine et recommencez. La méthode apprend de nouveau à chaque origine, à partir de l’historique plus long. C’est un réajustement.
Comme l’origine avance pas à pas, c’est un test rétrospectif à origine glissante. Plusieurs bibliothèques l’appellent validation croisée pour séries chronologiques. À la fin, vous évaluez ensemble toutes les prévisions de toutes les origines.
Un tout petit test rétrospectif
Section intitulée « Un tout petit test rétrospectif »Voici les unités vendues d’un produit pendant 12 jours :
| Jour | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Ventes | 4 | 6 | 5 | 7 | 9 | 6 | 8 | 10 | 7 | 9 | 12 | 8 |
Nous testons la prévision naïve (la dernière valeur) avec un horizon de 2 jours, à trois origines : jours 6, 8 et 10.
| Origine | Jours visibles | Dernière valeur | Jours prévus | Prévision | Ventes | Écart |
|---|---|---|---|---|---|---|
| Jour 6 | 1 à 6 | 6 | 7, 8 | 6, 6 | 8, 10 | 2, 4 |
| Jour 8 | 1 à 8 | 10 | 9, 10 | 10, 10 | 7, 9 | 3, 1 |
| Jour 10 | 1 à 10 | 9 | 11, 12 | 9, 9 | 12, 8 | 3, 1 |
Les écarts totalisent 2 + 4 + 3 + 1 + 3 + 1 = 14 unités. Les ventes des six jours totalisent 54 unités. La WAPE est donc de 14 ÷ 54 = 25,9 %. bt.backtest() fait le même travail pour toute méthode de prévision :
tiny = pd.DataFrame({"unique_id": "shop", "ds": pd.date_range("2025-06-01", periods=12, freq="D"), "y": [4, 6, 5, 7, 9, 6, 8, 10, 7, 9, 12, 8]})cuts = [pd.Timestamp("2025-06-06"), pd.Timestamp("2025-06-08"), pd.Timestamp("2025-06-10")]fc = bt.backtest(tiny, bt.naive, h=2, origins=cuts)fc["miss"] = (fc["y"] - fc["yhat"]).abs()print(fc[["origin", "step", "ds", "y", "yhat", "miss"]].to_string(index=False))print("misses added up:", fc["miss"].sum(), "| units sold:", fc["y"].sum(), "| WAPE %:", round(100 * fc["miss"].sum() / fc["y"].sum(), 1))La sortie :
origin step ds y yhat miss2025-06-06 1 2025-06-07 8 6 22025-06-06 2 2025-06-08 10 6 42025-06-08 1 2025-06-09 7 10 32025-06-08 2 2025-06-10 9 10 12025-06-10 1 2025-06-11 12 9 32025-06-10 2 2025-06-12 8 9 1misses added up: 14 | units sold: 54 | WAPE %: 25.9step (pas) compte les jours après l’origine. Chaque ligne est une prévision faite sans connaître sa valeur réelle, comme en utilisation réelle.
Le test rétrospectif du cours
Section intitulée « Le test rétrospectif du cours »Chaque module de ce cours utilise le même test rétrospectif. Toutes les lignes du tableau du test rétrospectif sont donc comparables. Il comprend 13 origines espacées de 28 jours; la dernière est le dimanche 15 mars 2026. À chaque origine, une méthode prévoit les 14 prochains jours.

Description textuelle du diagramme
Le diagramme comprend 13 rangées sur un même axe temporel, d’avril 2024 à mars 2026. Chaque rangée représente une origine, du 13 avril 2025 (en haut) au 15 mars 2026 (en bas). Dans chaque rangée, une barre bleue va du 1er avril 2024 à l’origine : la fenêtre d’entraînement. Une courte barre orange couvre les 14 prochains jours : le test. D’une rangée à l’autre, la barre bleue s’allonge de 28 jours et la barre orange se décale de 28 jours. La dernière barre orange se termine le 29 mars 2026.
print(len(ORIGINS), "origins:", [o.date().isoformat() for o in ORIGINS])start = pd.Timestamp("2024-04-01")for o in [ORIGINS[0], ORIGINS[-1]]: print(f"origin {o.date()}: trains on {(o - start).days + 1} days, tests {o.date() + pd.Timedelta(days=1)} " f"to {o.date() + pd.Timedelta(days=14)}")13 origins: ['2025-04-13', '2025-05-11', '2025-06-08', '2025-07-06', '2025-08-03', '2025-08-31', '2025-09-28', '2025-10-26', '2025-11-23', '2025-12-21', '2026-01-18', '2026-02-15', '2026-03-15']origin 2025-04-13: trains on 378 days, tests 2025-04-14 to 2025-04-27origin 2026-03-15: trains on 714 days, tests 2026-03-16 to 2026-03-29Chaque choix a une raison :
- 14 jours à l’avance, parce que Kenji commande le lundi et que la commande doit couvrir deux semaines. L’horizon découle de la décision, comme dans Définir le cadre de prévision.
- 28 jours d’intervalle, pour que les fenêtres de test ne se chevauchent jamais. Treize fenêtres couvrent une année entière : la montée printanière, le sommet estival, le Vendredi fou, Noël et l’hiver calme.
- La première origine après plus d’un an d’historique, pour permettre l’exécution à chaque origine d’une méthode nécessitant une saison annuelle complète.
- Un réajustement à chaque origine, parce qu’en utilisation réelle, la méthode apprend de nouveau des données les plus récentes chaque semaine.
- Des origines le dimanche, parce que la commande de Kenji du lundi utilise les ventes jusqu’au dimanche.
Les semaines après le 29 mars 2026 sont le futur caché. Le cours les réserve au travail final. Ainsi, un test honnête reste inutilisé jusqu’à la fin.
L’horizon détermine l’écart
Section intitulée « L’horizon détermine l’écart »Le lundi, Kenji connaît les ventes jusqu’au dimanche. Pour le deuxième dimanche de la commande, la vente connue la plus récente date de 14 jours. Un modèle avec les mêmes entrées pour toute la commande peut donc seulement utiliser ce qui date d’au moins 14 jours. L’horizon de la décision fixe cet écart. Le lag1 de Tomás ne le respectait pas; le modèle honnête utilisait lag14 et lag21. Le module 5 montre deux autres façons de construire un modèle qui respecte l’écart : une prévision récursive et un modèle par jour à prévoir.
Larkfield : le parasol à 13 origines
Section intitulée « Larkfield : le parasol à 13 origines »Priya fait un test rétrospectif de la prévision naïve saisonnière (le même jour de la semaine précédente) sur le parasol seulement. Elle évalue chaque origine séparément :
parasol = load_sales(["P025"])fc = bt.backtest(parasol, bt.seasonal_naive(7), h=14, origins=ORIGINS)per_origin = fc.groupby("origin").apply(lambda g: 100 * (g["y"] - g["yhat"]).abs().sum() / g["y"].sum())print(per_origin.round(1).to_string())print("all 13 origins together:", bt.score(fc, parasol, "seasonal naive", season=7)["WAPE %"])origin2025-04-13 55.62025-05-11 38.92025-06-08 74.32025-07-06 98.92025-08-03 49.42025-08-31 35.42025-09-28 69.92025-10-26 176.92025-11-23 157.12025-12-21 154.52026-01-18 100.02026-02-15 118.22026-03-15 116.7all 13 origins together: 66.1Description textuelle du graphique
Le graphique comprend 13 points, un par origine, reliés par une ligne. D’avril à septembre 2025, la WAPE reste entre 35,4 % (31 août) et 98,9 % (6 juillet, la semaine après la canicule). D’octobre 2025 à mars 2026, elle atteint 100 % ou plus. La valeur la plus élevée, 176,9 %, survient le 26 octobre. La WAPE sur l’ensemble des 13 origines est de 66,1 %.
Une WAPE supérieure à 100 % signifie que les écarts totalisent plus que les unités vendues. En hiver, le parasol se vend très peu. Un petit écart représente donc une grande part des ventes. Une seule origine vous en dit plus sur sa date que sur la méthode. Treize origines réparties sur un an couvrent toutes les saisons.
Quelle méthode gagne pour le parasol?
Section intitulée « Quelle méthode gagne pour le parasol? »L’explorateur ci-dessous utilise les mêmes 13 origines et huit méthodes. Quatre arrivent plus tard dans le cours; considérez-les comme des boîtes noires pour l’instant :
- ETS et AutoARIMA : des méthodes statistiques qui ajustent un modèle à chaque série (module 4).
- LightGBM (récursif) : un modèle d’amplification de gradient pour tous les produits (module 5).
- Chronos-Bolt : un modèle préentraîné qui prévoit sans entraînement sur les données de Larkfield (module 5).
Déplacez l’origine au fil de l’année et passez d’une méthode à l’autre. La ligne pointillée représente la référence de base naïve saisonnière.
Explorer
Le parasol dans le test rétrospectif du cours
Prédisez d’abord : Quelle méthode gagne pour le parasol sur 14 jours, selon l'ensemble des 13 origines?
- Vendus en 14 jours
- 101
- Prévision pour les 14 jours
- 118
- WAPE à cette origine
- 74,3 %
- WAPE, les 13 origines
- 66,1 %
À l’origine du 8 juin 2025, la méthode naïve saisonnière prévoit 118 unités pour les 14 jours suivants. 101 unités ont été vendues. Sa WAPE ici est de 74,3 % : sa prévision est trop haute. Sur les 13 origines, la méthode naïve saisonnière a une WAPE de 66,1 % : rang 6 sur 8 méthodes.
- Unités vendues
- Prévision de la méthode choisie
- Référence de base : naïve saisonnière
Montrer toutes les méthodes, classées
| Rang | Méthode | Famille | WAPE à cette origine | WAPE, les 13 origines |
|---|---|---|---|---|
| 1 | Chronos-Bolt | modèle de fondation | 58,1 % | 45,0 % |
| 2 | LightGBM (récursif) | apprentissage automatique | 44,8 % | 49,3 % |
| 3 | AutoARIMA | statistique | 51,7 % | 62,6 % |
| 4 | moyenne mobile (28 jours) | référence de base | 101,3 % | 64,9 % |
| 5 | ETS | statistique | 45,5 % | 65,1 % |
| 6 | naïve saisonnière | référence de base | 74,3 % | 66,1 % |
| 7 | naïve | référence de base | 50,5 % | 90,9 % |
| 8 | dérive | référence de base | 50,3 % | 92,5 % |
Description textuelle de l’explorateur
L’explorateur montre les ventes quotidiennes du parasol. Les quatre semaines avant l’origine choisie sont une ligne grise, et les 14 jours suivants sont des points gris. La prévision de la méthode choisie est une ligne bleue. La prévision naïve saisonnière est une ligne orange pointillée. Une bande au-dessus montre les 13 fenêtres de test. Les commandes permettent de choisir l’origine et l’une des huit méthodes. L’affichage indique les unités vendues, la prévision et la WAPE à cette origine ainsi que sur l’ensemble des 13 origines. À l’origine du 8 juin 2025, 101 parasols ont été vendus. La prévision naïve saisonnière était de 118, soit une WAPE de 74,3 % à cette origine. Sur l’ensemble des 13 origines, la WAPE de chaque méthode est : Chronos-Bolt 45,0 %, LightGBM (récursif) 49,3 %, AutoARIMA 62,6 %, moyenne mobile (28 jours) 64,9 %, ETS 65,1 %, naïve saisonnière 66,1 %, naïve 90,9 % et dérive 92,5 %.
Pour le parasol, Chronos-Bolt gagne avec une WAPE de 45,0 %, suivi de LightGBM avec 49,3 %. Les deux devancent largement la référence de base naïve saisonnière (66,1 %). ETS et AutoARIMA la battent de peu, et la moyenne mobile sur 28 jours fait aussi bien qu’ETS.
Il s’agit d’un seul produit. Pour d’autres, l’ordre change : la prévision naïve saisonnière bat LightGBM sur 3 des 50 produits. Ce qui compte ici, c’est l’équité de la comparaison : les mêmes origines, le même horizon et les mêmes jours pour chaque méthode.
Quand utiliser un test rétrospectif et ce qu’il coûte
Section intitulée « Quand utiliser un test rétrospectif et ce qu’il coûte »Utilisez un test rétrospectif à origine glissante pour chaque prévision que vous comparez ou présentez. Gardez-le identique pour chaque méthode, sinon les lignes du tableau ne sont pas comparables.
Il a des coûts :
- Temps. Un réajustement à chaque origine signifie 13 ajustements par série plutôt qu’un seul. AutoARIMA dans le module 4 a pris environ 1 000 secondes pour 50 produits et 13 origines.
- Historique. Chaque origine nécessite un historique avant elle. Avec quelques mois de données, vous obtenez moins d’origines, et le hasard pèse davantage sur le score.
- Essais multiples. Si vous essayez 30 versions d’une méthode et gardez le meilleur score rétrospectif, une partie de son avance vient du hasard. Le cours Apprentissage automatique : du problème à un modèle fiable montrait la même chose avec des données de validation. C’est pourquoi le trimestre caché reste inutilisé jusqu’au travail final.
Quand l’horizon ou le coût d’un réajustement est très grand, vous pouvez réajuster moins souvent : par exemple, toutes les quatre origines. bt.backtest() a un argument refit_every pour cela. Indiquez-le à côté du score.
Erreur courante
Une seule date de coupure
Symptôme : Tomás teste la prévision naïve saisonnière du parasol à une seule origine, le 31 août 2025. Il obtient une WAPE de 35,4 % et écrit : « Le même jour de la semaine précédente fonctionne bien pour les parasols. » Kenji l’essaie fin octobre. Ses écarts dépassent alors toutes les unités vendues (176,9 %).
Cause : une origine correspond à une fenêtre de 14 jours. Son score dépend autant de la saison et du hasard que de la méthode. La fin août est calme et stable pour les parasols; la fin octobre compte très peu de ventes.
Correction : faites un test rétrospectif à plusieurs origines réparties sur une année entière. Présentez le score de leur ensemble : 66,1 % pour le parasol. Regardez aussi les scores par origine.
Conséquence dans le travail en IA : une seule fenêtre de test fait paraître une prévision meilleure ou pire qu’elle ne l’est, par hasard. Les décisions fondées sur elle, comme une méthode pour une catégorie entière, échouent à la saison suivante.
Exercice guidé : un test rétrospectif dans le carnet
Section intitulée « Exercice guidé : un test rétrospectif dans le carnet »- Ouvrez le carnet dans l’encadré Faites cette leçon dans un carnet en haut de cette page.
- Exécutez les cellules de préparation et la cellule de l’utilitaire. La cellule des données se termine par la ligne
Ready:(prêt). - Dans la section 1, prédisez à quelle origine la prévision se trompe le plus. Exécutez ensuite la cellule. Vous voyez
WAPE %: 25.9. - Dans la section 2, exécutez la cellule. Vous voyez
13 origins(13 origines) et les jours d’entraînement de la première et de la dernière origine. - Dans la section 3, prédisez si la WAPE est identique à chaque origine. Exécutez ensuite la cellule. Vous voyez 13 valeurs et
66.1pour leur ensemble. - Dans la section 4, prédisez quel test donne la WAPE la plus basse. Exécutez ensuite la séparation aléatoire. Vous voyez
40.4. - Exécutez le test rétrospectif honnête. Vous voyez
47.1. - Dans la section 5, écrivez votre réponse dans la cellule Your turn (à vous), puis exécutez la cellule de vérification.
À vous de jouer : un horizon plus court
Section intitulée « À vous de jouer : un horizon plus court »bt.score() accepte l’argument horizon=, qui conserve seulement les premiers jours après chaque origine. Avant de l’exécuter, faites une prédiction : la prévision naïve saisonnière est-elle meilleure sur les 7 premiers jours que sur les 14? Dans la section 5 du carnet, évaluez fc_sn avec horizon=7 et mettez sa WAPE en pourcentage dans wape_h7.
Afficher la réponse
wape_h7 = bt.score(fc_sn, sales, "seasonal naive", season=7, horizon=7)["WAPE %"]print(wape_h7)49.8La première semaine est plus facile : 49,8 % contre 51,3 % pour les 14 jours. Durant la deuxième semaine, la prévision répète une semaine qui date déjà de 8 à 14 jours. Une prévision se dégrade à mesure qu’elle s’éloigne dans le temps. Évaluez-la donc à l’horizon de la décision. Un score sur 7 jours ferait paraître la méthode meilleure qu’elle ne le sera pour la commande de 14 jours de Kenji.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Expliquez avec les chiffres de Larkfield comment une séparation aléatoire a fait paraître un modèle meilleur qu'il ne l'est. Qu'a montré le test honnête?
Afficher la réponse
Sur des données de test de 20 % choisies au hasard, un modèle d’amplification de gradient (gradient boosting) manquait 40,4 % des unités. Il utilisait les ventes de 1, 7 et 14 jours auparavant. Ce résultat dépasse toutes les références de base. Mais le test aléatoire laissait entrer le futur. Chaque jour de test avait des jours d’entraînement avant et après lui. Son entrée lag1 correspondait aux ventes réelles de la veille. Kenji ne les connaît pas pour la plupart des jours d’une commande de 14 jours. Dans un test rétrospectif honnête sur 14 jours, ce type de modèle peut seulement utiliser des ventes datant d’au moins 14 jours. Il manquait 47,1 % des unités, un résultat pire que la moyenne mobile sur 28 jours (43,5 %).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Nommez les éléments d'un test rétrospectif à origine glissante et donnez les valeurs du test rétrospectif du cours.
Afficher la réponse
- Origine : la date de coupure; la méthode voit seulement les jours jusqu’à cette date. Le cours utilise 13 origines, du 13 avril 2025 au 15 mars 2026, espacées de 28 jours.
- Fenêtre d’entraînement : tous les jours du 1er avril 2024 à l’origine.
- Horizon : les jours prévus après chaque origine : 14, soit la durée couverte par la commande de Kenji.
- Réajustement : la méthode apprend de nouveau à chaque origine.
- Score : toutes les prévisions de toutes les origines ensemble. Par exemple, la WAPE de l’ensemble des 9 100 jours prévus pour les 50 produits.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Faites une prédiction : Grace prépare l'horaire du centre d'assistance une semaine à l'avance, heure par heure. Quel horizon le test rétrospectif des billets doit-il utiliser, et quels décalages un modèle peut-il utiliser?
Afficher la réponse
L’horizon est d’une semaine : 168 heures, soit la période que l’horaire doit couvrir. Le jour où Grace prépare l’horaire, elle connaît les billets reçus jusqu’à ce jour. Pour la dernière heure de la semaine, la valeur connue la plus récente date donc de 168 heures. Un modèle qui prévoit chaque heure de la semaine avec les mêmes entrées peut seulement utiliser des décalages d’au moins 168 heures. Un décalage de 1 heure ou de 24 heures laisserait entrer le futur, comme lag1 dans le test aléatoire de Tomás. Le test rétrospectif des billets du cours utilise cet horizon.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une séparation aléatoire laisse entrer le futur dans l’entraînement. Le même type de modèle manquait 40,4 % sur un test aléatoire et 47,1 % sur un test rétrospectif honnête.
- Un test rétrospectif à origine glissante coupe l’historique à plusieurs origines, prévoit l’horizon après chacune et évalue l’ensemble.
- Le test rétrospectif du cours : 13 origines, espacées de 28 jours, du 13 avril 2025 au 15 mars 2026; un horizon de 14 jours (la commande de Kenji); un réajustement à chaque origine.
- L’horizon détermine l’écart : une prévision sur 14 jours peut seulement utiliser ce qui date d’au moins 14 jours.
- Une seule origine ne constitue pas un test : la WAPE de la prévision naïve saisonnière du parasol passait de 35,4 % à 176,9 % selon la date. Sur les 13 origines, Chronos-Bolt gagne pour le parasol (45,0 %), suivi de LightGBM (49,3 %).
Vous pouvez maintenant tester toute prévision de façon équitable. Mais nous avons seulement utilisé la WAPE, et un seul chiffre peut cacher ce qui compte pour Kenji. Ensuite, vous comparerez les mesures d’erreur et verrez les limites de chacune.
Leçon suivante : Mesurer l'erreur qui compte