
Quand ne pas construire de modèle
- Leçon 17
- 30 min
- Module 5 : Méthodes par apprentissage automatique
Où nous en sommes
Dans les trois dernières leçons, nous avons ajouté des méthodes d'apprentissage automatique et des modèles de fondation au tableau du test rétrospectif. La méthode la plus exacte n'était pas la moins chère, et la moins chère prenait dix fois plus de temps à ajuster. Dans cette leçon, nous lisons tout le tableau pour évaluer le coût, la rapidité et la confiance. Nous voyons aussi où utiliser un LLM : pour la note de prévision, pas pour les chiffres. Pensez d'abord à la façon dont une famille choisit une voiture.
Leçon 17 sur 27 · Prévision et séries chronologiques : prévoir la suiteQuand ne pas construire de modèle
1. Les prévisions servent des décisions
2. Lire une série chronologique
3. Références de base et tests honnêtes
4. Méthodes statistiques
5. Méthodes par apprentissage automatique
6. Séries difficiles et séries nombreuses
7. L'incertitude et la décision
8. Exploiter une prévision en production
Ce que vous saurez faire
Choisissez une méthode de prévision en tenant compte de ce que Kenji paie. Examinez le coût de la décision, le travail pour exécuter la méthode et la confiance qu’elle mérite. Parfois, la méthode simple gagne. Un LLM peut écrire la note hebdomadaire sur la prévision, mais il ne doit jamais produire les chiffres.
Carnet JupyterFaites cette leçon dans un carnet
Le carnet (notebook) Jupyter contient toutes les cellules de code, les tâches et les vérifications de cette leçon. Il trie le tableau du test rétrospectif de trois façons. Il compare ETS, la prévision naïve saisonnière et LightGBM, produit par produit. Ensuite, il vérifie chaque nombre dans dix notes de prévision rédigées par un LLM. Il ne fait aucun appel de modèle : les notes ont été enregistrées une seule fois. Ses cellules de préparation installent les paquets et téléchargent les données. Vous n’avez donc rien à préparer sur votre ordinateur. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le tableau du test rétrospectif (backtests) et ses colonnes, présentés dans Mesurer l’erreur qui compte.
- Les méthodes de ce module : La prévision comme régression, Amplification de gradient avec LightGBM et Modèles profonds et modèles de fondation.
- Ce qu’est un LLM : un modèle qui écrit du texte à partir d’une requête (prompt). Consultez Les LLM : comment ils fonctionnent et comment en choisir un si ce sujet est nouveau pour vous.
Ce qu’il vous faut sur votre ordinateur
Rien : le carnet fonctionne dans Colab ou Kaggle. Il ne nécessite aucune clé d’API.
Testé dans Jupyter sur macOS, avec Python 3.12, pandas 2.3.3, statsforecast 2.1.1, mlforecast 1.1.0 et LightGBM 4.7.0.
Comment une famille choisit une voiture
Section intitulée « Comment une famille choisit une voiture »Une famille a besoin d’une voiture pour conduire les enfants à l’école et faire l’épicerie de la semaine. Selon l’essai du magazine, une voiture sport est la plus rapide sur la piste. La famille ne l’achète pas. Elle coûte plus cher à acheter, à assurer et à réparer. Elle n’a pas de place pour l’épicerie. Une petite voiture est plus lente sur la piste, mais convient mieux à leur semaine.
L’essai sur la piste est réel. Il répond à une autre question. Pour bien choisir, il faut lire chaque colonne de l’essai : vitesse, prix, frais d’utilisation et usage prévu.
Le problème : la méthode gagnante change selon la colonne
Section intitulée « Le problème : la méthode gagnante change selon la colonne »Le tableau du test rétrospectif des commandes compte maintenant 13 lignes. Trois personnes le lisent, et chacune trouve une méthode gagnante différente.
- Tomás trie selon la WAPE : Chronos-Bolt gagne avec 38,7 %.
- Priya trie selon le coût : LightGBM direct gagne avec 13 711 dollars par commande.
- Mei trie selon le temps d’ajustement : la prévision naïve gagne avec 0,02 seconde pour les 13 origines.
Chacun a raison pour sa colonne. Aucun n’a répondu à la question de Kenji : « Quelle méthode devrait s’exécuter chaque lundi? »
Le graphique classe chaque ligne selon le coût pour Kenji, avec la WAPE à côté.
- Référence de base
- Méthode statistique
- Apprentissage automatique
- Modèle de fondation
Description textuelle du graphique
Les 13 méthodes, de la commande la moins chère à la plus chère, avec le coût par commande et la WAPE : LightGBM direct 13 711 $ US (40,7 %); LightGBM décalages ≥ 14 14 629 $ US (40,9 %); LightGBM récursif 14 749 $ US (40,7 %); Chronos-Bolt 14 750 $ US (38,7 %); régr. linéaire, par produit 15 137 $ US (41,7 %); AutoARIMA 16 257 $ US (41,4 %); ETS 16 578 $ US (41,3 %); naïve saisonnière 16 739 $ US (51,3 %); Theta 16 812 $ US (41,5 %); régr. linéaire, globale 17 264 $ US (42,6 %); moyenne mobile 28 j 19 444 $ US (43,5 %); naïve 28 261 $ US (53,2 %); dérive 28 570 $ US (53,8 %).
Toutes les valeurs du tableau, dans le même ordre :
| Méthode | Type | MASE | WAPE % | biais % | ajustement en s (13 origines) | coût en $ par commande |
|---|---|---|---|---|---|---|
| LightGBM direct | apprentissage automatique | 0,813 | 40,7 | −0,6 | 156 | 13 711 |
| LightGBM décalages ≥ 14 | apprentissage automatique | 0,828 | 40,9 | −0,7 | 12 | 14 629 |
| LightGBM récursif | apprentissage automatique | 0,816 | 40,7 | +0,7 | 16 | 14 749 |
| Chronos-Bolt | modèle de fondation | 0,784 | 38,7 | −5,6 | 2 | 14 750 |
| régr. linéaire, par produit | apprentissage automatique | 0,835 | 41,7 | −1,4 | 13 | 15 137 |
| AutoARIMA | méthode statistique | 0,834 | 41,4 | +1,4 | 996 | 16 257 |
| ETS | méthode statistique | 0,832 | 41,3 | +0,1 | 46 | 16 578 |
| naïve saisonnière | référence de base | 1,034 | 51,3 | −0,5 | 0,05 | 16 739 |
| Theta | méthode statistique | 0,837 | 41,5 | +0,1 | 42 | 16 812 |
| régr. linéaire, globale | apprentissage automatique | 0,866 | 42,6 | −0,1 | 0,33 | 17 264 |
| moyenne mobile 28 j | référence de base | 0,875 | 43,5 | −0,1 | 0,11 | 19 444 |
| naïve | référence de base | 1,065 | 53,2 | +7,4 | 0,02 | 28 261 |
| dérive | référence de base | 1,075 | 53,8 | +7,8 | 0,04 | 28 570 |
Lisez le milieu du tableau. La prévision naïve saisonnière, « le même jour de la semaine dernière », coûte 16 739 dollars. C’est moins que Theta et la régression linéaire globale, et seulement 161 dollars de plus qu’ETS. AutoARIMA coûte environ autant qu’ETS et a pris environ 1 000 secondes plutôt que 46. La moyenne mobile sur 28 jours a une meilleure WAPE que la prévision naïve saisonnière. Pourtant, elle coûte 2 705 dollars de plus par commande.
L’idée : un modèle complexe doit justifier son coût
Section intitulée « L’idée : un modèle complexe doit justifier son coût »Un modèle complexe vaut son coût seulement si son gain dépasse tout ce qu’il coûte. Le tableau montre une partie du coût : le temps d’ajustement. Le reste n’y figure pas :
- L’exécution : une tâche hebdomadaire, ses paquets, sa mémoire et quelqu’un pour la réparer quand elle tombe en panne. Chronos-Bolt a même eu besoin de son propre processus.
- La confiance : Kenji doit assez bien comprendre une prévision pour la modifier lorsqu’il sait quelque chose que le modèle ignore.
- Le changement : un ensemble de variables ou un modèle préentraîné peut échouer de plus de façons quand les données changent.
La question n’est donc jamais « quelle méthode est la meilleure? ». C’est « le gain par rapport à la méthode simple vaut-il ce que coûte la méthode complexe ici? »
Exemple détaillé : LightGBM vaut-il son coût pour les commandes de Larkfield?
Section intitulée « Exemple détaillé : LightGBM vaut-il son coût pour les commandes de Larkfield? »Prenez la méthode simple la moins chère et la méthode complexe la moins chère :
| Naïve saisonnière | LightGBM, direct | |
|---|---|---|
| Coût par commande | 16 739 dollars | 13 711 dollars |
| Temps d’ajustement, 13 origines | 0,05 secondes | environ 156 secondes |
| Code à exécuter | une ligne | variables, indicateurs de jours fériés, 14 modèles |
Le gain est de 3 028 dollars par commande pour les 50 produits. Quelques minutes d’ajustement par semaine coûtent peu. Ici, le modèle complexe vaut la peine d’être construit. Le test rétrospectif le montre en dollars, selon les hypothèses de coût du cours. Faire ce calcul est le but de la leçon. Les prochains cas montrent où le même calcul donne le résultat inverse.
Où la méthode simple a gagné
Section intitulée « Où la méthode simple a gagné »Produit par produit
Section intitulée « Produit par produit »Le tableau additionne les résultats de 50 produits. Le carnet compare la WAPE de chaque produit :
Description textuelle du graphique
WAPE le plus bas par produit : Chronos-Bolt pour 28 produits, LightGBM (récursif) pour 16, ETS pour 3, AutoARIMA pour 3. ETS bat LightGBM pour 21 des 50 produits; la prévision naïve saisonnière bat LightGBM pour 3.
ETS bat LightGBM pour 21 des 50 produits. La prévision naïve saisonnière le bat pour 3 : P013, P029 et P075. LightGBM gagne au total grâce à de grands gains pour des produits comme le parasol (49,3 % contre 65,1 % pour ETS). Pour les autres produits, son avance est petite ou négative.
Produits à faibles ventes (module 6)
Section intitulée « Produits à faibles ventes (module 6) »Le module 6 prévoit 140 séries produit-région à faibles ventes. Ces produits ne se vendent pas pendant au moins 70 % des jours. Demande intermittente les présente; ici, seul le résultat vous est nécessaire. Dans ce cas, une prévision de toujours 0 a la meilleure MASE de toutes (0,599). Mais elle ne commande rien, donc sa commande coûte 4 371 dollars. La commande la moins chère vient de la simple prévision naïve saisonnière (2 885 dollars). La méthode de Croston, conçue pour les produits à faibles ventes, coûte 3 733.
L’horaire du centre d’assistance (module 7)
Section intitulée « L’horaire du centre d’assistance (module 7) »Pour l’horaire de Grace, Theta a la meilleure WAPE des billets de soutien (27,1 %). De la prévision à la commande et à l’horaire établit l’horaire à partir d’un quantile élevé de la prévision. MSTL donne alors l’horaire le moins cher : 3 718 dollars par semaine, contre 5 845 pour Theta, dont l’intervalle est beaucoup trop large. MSTL est une méthode statistique qui s’ajuste en environ 3 secondes.
Signes qu’un modèle complexe ne vaut pas son coût
Section intitulée « Signes qu’un modèle complexe ne vaut pas son coût »- Son gain par rapport à la prévision naïve saisonnière ou à ETS, dans le coût de la décision, est petit comparé à ses frais d’exécution.
- Il gagne selon la mesure d’erreur, mais pas selon le coût (Chronos-Bolt ici, ou Theta pour l’horaire).
- Il gagne au total, mais perd pour beaucoup de produits.
- Vous avez peu de séries ou un historique court, donc peu de choses à apprendre.
- Personne dans l’équipe ne peut expliquer sa prévision à la personne qui l’utilise pour agir.
- Il nécessite son propre processus, un processeur graphique (GPU) ou un gros téléchargement que l’équipe ne peut pas prendre en charge.
Où utiliser un LLM : la note de prévision
Section intitulée « Où utiliser un LLM : la note de prévision »Chaque lundi, Omar veut une courte note : ce que le plan commande, les heures d’agents prévues et les points à surveiller. Priya l’écrit à la main. Un grand modèle de langage (LLM) peut la rédiger en quelques secondes.
Tomás va plus loin : « Pourquoi ne pas demander au LLM la prévision elle-même? » Parce qu’il échoue à tous les tests de ce cours. Un LLM écrit du texte probable, pas des nombres ajustés aux 400 000 lignes de Larkfield. Personne ne peut le tester rétrospectivement de la même façon. Il peut répondre différemment à la même question et ne peut pas montrer sa colonne de coût. La tâche de prévision planifiée calcule les chiffres. Le LLM les transforme seulement en phrases.
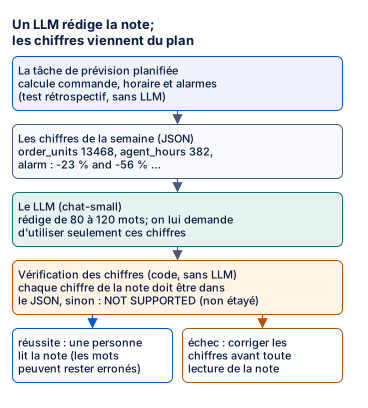
Description textuelle du diagramme
Quatre boîtes de haut en bas. La tâche de prévision planifiée calcule la commande, l’horaire et les alarmes, avec des méthodes testées rétrospectivement, sans LLM. Les chiffres de la semaine sortent en JSON. Par exemple : 13 468 unités à commander, 382 heures d’agents et une alarme de −23 % et −56 %. Le LLM, chat-small, écrit de 80 à 120 mots et reçoit la consigne d’utiliser seulement ces chiffres. Une vérification des nombres, écrite en code sans LLM, exige que chaque nombre de la note figure dans le JSON. Il y a ensuite deux résultats. Si la note réussit, une personne la lit, car les mots peuvent encore être faux. Si elle échoue, quelqu’un corrige d’abord les chiffres.
La vérification de dix notes enregistrées
Section intitulée « La vérification de dix notes enregistrées »Le cours a enregistré 10 notes une seule fois, avec le déploiement chat-small d’Azure. Elles couvrent 10 semaines de la tâche de prévision planifiée du module 8. Elles ont utilisé 3 831 jetons (tokens) d’entrée et 4 546 jetons de sortie. Le total est d’environ 0,003 $ US selon la grille de prix du cours (les prix changent : consultez la page actuelle). La vérification trouve chaque nombre de la note et le cherche parmi les nombres reçus par le LLM :
NUMBER = re.compile(r"(?<![\w.])[-+]?\d[\d,]*(?:\.\d+)?%?")   # 12,839 or -23% or 0.5
def check(note, facts):    """The numbers in the note that are not in the facts (within 1%). 1, 2, 7 and 14 are always allowed."""    allowed = {value(m) for m in NUMBER.findall(json.dumps(facts))} | {1.0, 2.0, 7.0, 14.0}    return [m for m in NUMBER.findall(note) if not any(abs(value(m) - a) <= 0.01 * max(abs(a), 1) for a in allowed)]
La sortie pour les dix notes :
2025-03-10 passes2025-03-17 NOT SUPPORTED: ['23%', '56%']2025-03-24 passes2025-03-31 passes2025-04-07 passes2025-04-14 passes2025-04-21 passes2025-04-28 passes2025-05-05 passes2025-05-12 passesNeuf notes réussissent. Celle du 17 mars 2025 échoue. Le carnet affiche les 115 premiers caractères de l’alarme et la phrase de la note contenant les mêmes nombres :
ALARM: BIAS ALARM plants-and-seeds: the forecast was too low 2 weeks in a row (-23% and -56%, weeks of 2025-03-03, 2025-03NOTE: A bias alarm says the plants-and-seeds forecast was too low for 2 weeks in a row: by 23% and 56% in the weeks of 2025-03-03 and 2025-03-10Le LLM a supprimé les signes moins. Dans cette phrase, « trop bas de 23 % » garde le même sens. Mais la vérification ne peut pas comprendre le sens. Dans un tableau ou une phrase plus courte, « +23 % » et « −23 % » donnent des conseils opposés : commander plus ou moins.
La vérification a aussi une limite dans l’autre sens. La note du 10 mars réussit. Sa première phrase dit : « Le plan de Larkfield pour la semaine du 10 mars 2025 prévoit de traiter 12 839 commandes ». Le plan dit order_units: 12839 : 12 839 unités à commander, pas des commandes de clients. Le nombre est correct; le mot est faux. Une vérification des nombres ne vérifie pas le sens. Une personne lit donc encore chaque note avant son envoi.
Ce que coûte la note du LLM
Section intitulée « Ce que coûte la note du LLM »- L’argent : une fraction de cent par note.
- La vérification : quelques lignes de code, exécutées pour chaque note.
- Un lecteur : quelqu’un qui compare la note au plan, car certaines erreurs passent la vérification.
- De petites surprises :
chat-smallest un modèle de raisonnement : il suit des étapes cachées avant d’écrire sa réponse. Le premier appel d’enregistrement a échoué avec une erreur, car il n’accepte pas le paramètre habituelmax_tokens.
Erreur courante
Un signe moins supprimé
Symptôme : la note du 17 mars dit que la prévision des plantes et des semences était trop basse « de 23 % et 56 % ». L’alarme du plan indique −23 % et −56 %. La vérification des nombres signale la note : NOT SUPPORTED: 23%, 56% (non pris en charge : 23 %, 56 %).
Cause : le LLM a réécrit les nombres dans sa propre phrase et supprimé leurs signes. Il avait reçu la consigne d’utiliser seulement les nombres fournis. Une consigne n’est pas une garantie.
Correction : n’envoyez jamais une note qui échoue à la vérification. Demandez les nombres exactement comme ils figurent dans le plan. Ou laissez la tâche insérer les nombres dans des phrases fixes, et le LLM écrire seulement le reste. Ensuite, une personne lit la note.
Conséquence pour le travail en IA : un lecteur fait confiance à une note bien écrite. Un signe erroné dans un texte fluide inverse le conseil, et personne ne le remarque sans vérification.
Exercice guidé : lire le tableau, vérifier les notes
Section intitulée « Exercice guidé : lire le tableau, vérifier les notes »- Ouvrez le carnet dans l’encadré Faites cette leçon dans un carnet en haut de cette page.
- Exécutez les cellules de préparation et la cellule utilitaire. La cellule des données se termine par la ligne
Ready:(prêt). - Dans la section 1, prédisez si la WAPE la plus basse correspond au coût le plus bas. Puis exécutez la cellule. Vous voyez trois méthodes gagnantes différentes.
- Dans la section 2, prédisez pour combien de produits ETS bat LightGBM. Puis exécutez la cellule (environ une minute). Vous voyez 21 sur 50.
- Dans la section 3, écrivez votre réponse dans la cellule Your turn (à vous), puis exécutez la cellule de vérification.
- Dans la section 4, prédisez si les 10 notes réussissent. Puis exécutez la vérification. Vous voyez une note signalée.
- Exécutez les deux cellules suivantes. Comparez l’alarme à la note, puis lisez la note du 10 mars.
À vous de jouer : la méthode la plus simple
Section intitulée « À vous de jouer : la méthode la plus simple »Avant d’exécuter quoi que ce soit, prédisez : pour combien des 50 produits, « le même jour de la semaine dernière » bat-il LightGBM? Dans la section 3 du carnet, comptez-les à partir de per_product et placez le nombre dans naive_wins.
Afficher la réponse
naive_wins = int((per_product["seasonal naive"] < per_product["LightGBM"]).sum())print(naive_wins, per_product.index[per_product["seasonal naive"] < per_product["LightGBM"]].tolist())3 ['P013', 'P029', 'P075']Pour 3 produits, une prévision d’une ligne bat un modèle de 400 arbres. P029 est le produit aux ventes les plus faibles des 50, et P075 est le plus vendu. Le volume des ventes d’un produit ne prédit donc pas où la méthode simple gagne. Seul le test rétrospectif vous le dit.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
À partir du tableau du test rétrospectif, expliquez pourquoi Kenji ne devrait pas simplement choisir la méthode à la WAPE la plus faible.
Afficher la réponse
Kenji paie la commande, pas l’erreur quotidienne. Chronos-Bolt a la WAPE la plus faible (38,7 %), mais un biais négatif (−5,6 %). Sa commande coûte 14 750 $ US. LightGBM en prévision directe a une WAPE de 40,7 % et le coût le plus faible, soit 13 711 $ US. La moyenne mobile sur 28 jours a une meilleure WAPE que la prévision naïve saisonnière (43,5 % contre 51,3 %). Mais elle coûte 19 444 $ US contre 16 739. Il faut choisir la méthode selon le coût de la décision, puis le temps d’ajustement, les coûts d’exécution et la confiance.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Donnez deux cas du cours où une méthode simple bat une méthode complexe, et un cas où la méthode complexe justifie son coût.
Afficher la réponse
La méthode simple gagne : ETS bat LightGBM pour 21 des 50 produits, et la prévision naïve saisonnière le bat pour 3. Pour les produits qui se vendent peu, la prévision naïve saisonnière donne la commande la moins chère (2 885 $ US). Elle coûte moins que celle de la méthode de Croston (3 733). Pour l’horaire à un quantile élevé, MSTL coûte le moins cher (3 718 $ US par semaine), malgré la meilleure WAPE de Theta. La méthode complexe justifie son coût pour les commandes des 50 produits. LightGBM en prévision directe coûte 3 028 $ US de moins par commande que la prévision naïve saisonnière. Son ajustement prend quelques minutes.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Pourquoi Larkfield utilise-t-elle un LLM pour la note hebdomadaire, mais pas pour la prévision? Que manque la vérification des nombres?
Afficher la réponse
La prévision doit passer un test rétrospectif, être reproductible et être évaluée selon le coût de la décision. Un LLM écrit du texte probable, pas des nombres ajustés aux données. La tâche évaluée par test rétrospectif calcule donc les nombres. Le LLM les transforme seulement en phrases. Le code vérifie que chaque nombre de la note figure dans le plan. Sur 10 notes enregistrées, 9 ont réussi la vérification. La vérification a signalé la note qui avait supprimé les signes moins de −23 % et −56 %. Elle ne peut pas détecter un sens erroné : la note du 10 mars appelle 12 839 unités des « commandes » et réussit. Une personne doit donc encore lire la note.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Le gagnant change selon la colonne. Chronos-Bolt gagne selon la WAPE (38,7 %). LightGBM en prévision directe gagne selon le coût (13 711 $ US). La prévision naïve gagne selon le temps d’ajustement.
- Un modèle complexe doit justifier son coût par les dollars économisés sur la décision, en tenant compte des coûts d’exécution et de la confiance. Pour les commandes, LightGBM le fait : 3 028 $ US de moins par commande que la prévision naïve saisonnière.
- Les méthodes simples gagnent ailleurs : ETS bat LightGBM pour 21 des 50 produits. Pour les produits qui se vendent peu, la prévision naïve saisonnière donne la commande la moins chère. MSTL donne l’horaire le moins cher.
- Un LLM écrit la note, jamais les nombres. Vérifiez chaque nombre par le code : 9 notes sur 10 ont réussi, et une avait perdu ses signes moins. Faites ensuite lire la note par une personne.
Vous pouvez maintenant choisir une méthode de prévision selon son coût, pas seulement selon son erreur. Mais jusqu’ici, chaque prévision portait sur un seul produit à la fois. Les produits de Larkfield se regroupent en catégories, en régions et en un total, et les prévisions doivent concorder. Ensuite, vous ferez concorder les totaux des prévisions à chaque niveau de la hiérarchie.
Leçon suivante : Des hiérarchies qui doivent s'additionner