
Modèles profonds et modèles de fondation
- Leçon 16
- 40 min
- Module 5 : Méthodes par apprentissage automatique
Où nous en sommes
Dans la leçon précédente, LightGBM a appris de tous nos produits à la fois et obtenu le plus faible coût de commande. Tomás pose une bonne question : pourquoi entraîner un modèle si un modèle de fondation préentraîné peut prévoir n'importe quelle série? Dans cette leçon, nous en exécutons un sur processeur, sans entraînement, et comparons honnêtement son coût et son exactitude. Pensez d'abord à une nouvelle collègue qui a travaillé dans cent magasins.
Leçon 16 sur 27 · Prévision et séries chronologiques : prévoir la suiteModèles profonds et modèles de fondation
1. Les prévisions servent des décisions
2. Lire une série chronologique
3. Références de base et tests honnêtes
4. Méthodes statistiques
5. Méthodes par apprentissage automatique
6. Séries difficiles et séries nombreuses
7. L'incertitude et la décision
8. Exploiter une prévision en production
Ce que vous saurez faire
Exécutez un modèle préentraîné pour séries chronologiques sur processeur, sans entraînement sur les données de Larkfield. Puis jugez-le comme toute autre méthode : dans le même test rétrospectif (backtest), selon son exactitude et son coût. Sur Larkfield, il obtient la meilleure exactitude du tableau du cours. Il n’a pas le coût le plus faible.
Carnet JupyterFaites cette leçon dans un carnet
Le carnet (notebook) Jupyter contient toutes les cellules de code, tâches et vérifications de cette leçon. Il charge Chronos-Bolt small sur le processeur et prévoit les ventes du parasol sans entraînement. Puis il exécute le modèle dans le test rétrospectif du cours. Il mesure son biais, son intervalle et ses erreurs les jours de promotion. Ses cellules de préparation installent les paquets (dont PyTorch) et téléchargent les données de Larkfield et le modèle. Il ne nécessite donc aucune configuration locale ni aucun processeur graphique. Environ 40 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le tableau du test rétrospectif et sa colonne de coût, dans Mesurer l’erreur qui compte.
- Les lignes de LightGBM et le biais les jours de promotion, dans Amplification de gradient avec LightGBM.
- Les réseaux de neurones, pour comprendre les détails de la première section : consultez Ce qu’est l’apprentissage profond dans le cours sur l’apprentissage profond. Cette leçon ne nécessite pas ces connaissances.
Ce qu’il vous faut sur votre ordinateur
Rien : le carnet s’exécute dans Colab ou Kaggle, sur processeur. Sa première cellule installe chronos-forecasting 2.3.2 et PyTorch 2.15.0 (processeur, environ 200 Mo). La section 1 télécharge le modèle (environ 190 Mo).
Testé avec Python 3.12, pandas 2.3.3, chronos-forecasting 2.3.2 et PyTorch 2.15.0 (processeur), dans Jupyter sur macOS. Non testé sur un processeur de Colab gratuit.
Une nouvelle collègue qui a connu cent magasins
Section intitulée « Une nouvelle collègue qui a connu cent magasins »Larkfield embauche une planificatrice des stocks qui a travaillé dans cent magasins. Le premier jour, Kenji lui montre les ventes du parasol de l’année passée. Il demande : « Combien en vendrons-nous dans les deux prochaines semaines? » Elle n’a jamais vu les données de Larkfield. Mais elle a vu des milliers de graphiques de ventes : hausses printanières, sommets estivaux, hivers tranquilles. Elle regarde le graphique et donne un nombre raisonnable en quelques secondes.
Elle est rapide et a souvent raison. Certaines choses lui échappent aussi. Elle ignore que le marketing a prévu une promotion du parasol jeudi prochain. Et quand Kenji demande « à quel point êtes-vous certaine? », elle peut répondre « entre 100 et 300 ». Mais pas « je suis certaine à 95 % que ce sera moins de 350 ».
Le problème : toutes les méthodes apprennent d’abord de Larkfield
Section intitulée « Le problème : toutes les méthodes apprennent d’abord de Larkfield »Toutes les méthodes de prévision du tableau apprennent jusqu’ici de l’historique de Larkfield. ETS s’ajuste à chaque produit, à chaque origine. LightGBM apprend des 50 produits. Il faut donc assez d’historique, des variables, des paramètres et un entraînement chaque semaine.
Tomás voit les choses simplement : « Les grands modèles ont changé le texte. Un modèle de fondation pour séries chronologiques battra tout, sans aucun entraînement. » La question est légitime, et le test rétrospectif peut y répondre. D’abord, quelques mots sur les méthodes neuronales qui l’ont précédé.
Méthodes neuronales de prévision : leur apport sur de grands jeux de données
Section intitulée « Méthodes neuronales de prévision : leur apport sur de grands jeux de données »Une méthode neuronale de prévision est un réseau de neurones qui apprend à prévoir à partir de nombreuses séries. Voici deux types connus :
- N-BEATS lit une fenêtre de valeurs passées, par exemple les 8 dernières semaines, puis les transmet à des groupes de couches. Chaque groupe produit une partie de la prévision et une partie du passé qu’il explique.
- Un réseau de neurones récurrent (RNN) lit la série un jour à la fois. Il conserve une petite mémoire, la met à jour après chaque jour, puis prévoit à partir de cette mémoire.
Avec des milliers de séries et des années d’historique, ces méthodes peuvent apprendre des formes que les variables créées manuellement manquent. Elles coûtent aussi plus cher : beaucoup plus de données, un long entraînement (souvent sur processeur graphique) et de nombreux paramètres à ajuster. Le test rétrospectif de Larkfield couvre 50 produits et deux ans. Le cours n’a pas entraîné de méthode neuronale de prévision, donc cette leçon ne donne aucun résultat pour ces méthodes. Le cours sur l’apprentissage profond compare un réseau profond à l’amplification de gradient sur un tableau dans Réseau profond ou gradient boosting?.
L’idée : un modèle préentraîné sur de nombreuses séries
Section intitulée « L’idée : un modèle préentraîné sur de nombreuses séries »Les auteurs d’un modèle de fondation l’entraînent une seule fois sur une très grande collection de données variées. On l’utilise ensuite pour de nombreuses tâches auxquelles il n’a pas été entraîné. Pour les séries chronologiques, il apprend de nombreuses séries publiques : ventes, énergie, circulation, météo. Vous lui donnez ensuite une nouvelle série, et il prévoit sans entraînement sur vos données. C’est la prévision sans exemple (zero-shot) : aucun exemple de votre propre tâche.
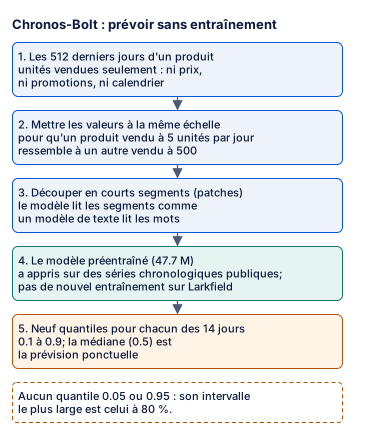
Le modèle de cette leçon est Chronos-Bolt (la petite version), d’Amazon, sous licence Apache-2.0. L’image montre le parcours d’une série jusqu’à une prévision dans le code du cours.
Description textuelle du diagramme
Cinq cases, l’une sous l’autre. Première case, les 512 derniers jours d’un produit : uniquement les unités vendues, sans prix, promotions ni calendrier. Deuxième case, les valeurs sont mises à l’échelle. Un produit vendu à 5 unités par jour ressemble ainsi à un produit vendu à 500 unités par jour. Troisième case, la série est découpée en petits morceaux appelés patches (blocs). Le modèle les lit comme un modèle de texte lit des mots. Quatrième case, le modèle préentraîné, avec 47,7 millions de paramètres. Il a appris de nombreuses séries chronologiques publiques, sans nouvel entraînement sur Larkfield. Cinquième case, la sortie : neuf quantiles pour chacun des 14 jours, de 0,1 à 0,9. La médiane, 0,5, est la prévision ponctuelle. Une case en pointillés précise qu’il n’existe aucun quantile 0,05 ou 0,95. L’intervalle le plus large fourni est donc celui à 80 %.
Un quantile est un niveau sous lequel la valeur réelle devrait tomber une certaine proportion du temps. Le quantile 0,9 devrait être dépassé environ 1 jour sur 10. Les quantiles 0,1 à 0,9 forment un intervalle à 80 % : environ 8 jours réels sur 10 devraient s’y trouver. Le module 7 porte sur les intervalles; ici, cette idée suffit.
Petit exemple détaillé : le parasol le 11 mai 2025
Section intitulée « Petit exemple détaillé : le parasol le 11 mai 2025 »Priya donne au modèle les 512 derniers jours du parasol, jusqu’au dimanche 11 mai 2025, au début de la hausse printanière. Elle demande les quantiles 0,1, 0,5 et 0,9 des 14 prochains jours.
pipe = BaseChronosPipeline.from_pretrained("amazon/chronos-bolt-small", revision="772f3d25d38aec6d914c8949dab4462e2d46f5d8", device_map="cpu", torch_dtype=torch.float32)context = torch.tensor(parasol.loc[parasol["ds"] <= origin, "y"].to_numpy()[-512:], dtype=torch.float32)q, _ = pipe.predict_quantiles([context], prediction_length=14, quantile_levels=[0.1, 0.5, 0.9])revision (révision) fixe la version exacte du modèle. La prévision ne change donc pas quand ses auteurs publient une nouvelle version. Voici la sortie, additionnée sur les 14 jours :
{'q10': 96.7, 'q50': 181.8, 'q90': 309.7} | real: 216 | days inside the range: 12 of 14- Ventes avant la date de coupure
- Prévision : médiane et quantiles 0,1 et 0,9 (en tirets)
- Ventes sur les 14 jours
Description textuelle du graphique
Le graphique montre les ventes quotidiennes du parasol pendant les quatre semaines avant le 11 mai 2025. Elles passent d’environ 3 à 20 par jour. Après la date de coupure, trois lignes bleues montrent la prévision sur 14 jours. La médiane se situe entre 10,5 et 16,8 par jour. Le quantile 0,1 se situe entre 4,5 et 10,1, et le quantile 0,9 entre 19,0 et 26,6. Les ventes réelles sont des points entre 8 et 25 par jour. Sur les 14 jours, la médiane totalise 181,8 et les ventes réelles, 216. 12 des 14 jours se trouvent dans l’intervalle.
Lisez le résultat comme Kenji. La médiane annonce 182 parasols; les ventes atteignent 216. L’intervalle annonce « entre environ 97 et 310 » et contient la valeur réelle pour 12 des 14 jours. C’est une prévision raisonnable pour un modèle qui n’avait jamais vu Larkfield. Sa médiane est trop basse ici, car la hausse printanière est plus rapide qu’il ne le prévoit.
Larkfield : Chronos-Bolt dans le test rétrospectif du cours
Section intitulée « Larkfield : Chronos-Bolt dans le test rétrospectif du cours »Voici maintenant le vrai test. Les mêmes 50 produits, les mêmes 13 origines, les mêmes 14 jours que toutes les autres lignes. 650 prévisions, sans entraînement :
method horizon MASE WAPE % bias % pinball fit s cost $Chronos-Bolt small, no training 14 0.784 38.7 -5.6 0.099 1.18 14750coverage of the 80% range: 0.789coverage of the 90% range: 0.789Il gagne en exactitude. Sa MASE de 0,784 et sa WAPE de 38,7 % sont les meilleures du tableau entier. Il dépasse LightGBM (40,7 %), ETS (41,3 %) et toutes les références de base. Sa perte pinball (perte quantile), un score d’intervalle expliqué au module 7, est aussi la meilleure : 0,099 contre 0,110 pour ETS. Produit par produit, il obtient la WAPE la plus faible sur 28 des 50 produits, et sur le parasol (45,0 %). La prédiction est rapide : 650 prévisions en environ 2 secondes sur le processeur d’un portable.
Le cours prévoyait l’inverse : un modèle entraîné sur d’autres données perdrait sur celles de Larkfield. Il n’a pas perdu. Dites-le clairement. Une réserve honnête : les données de Larkfield sont synthétiques, produites par un générateur simple avec des saisons hebdomadaires et annuelles régulières. Des données réelles aux événements complexes pourraient moins lui convenir. C’est une raison de le tester rétrospectivement sur vos données, pas de douter de ce résultat.
Explorer
Chronos-Bolt face aux autres méthodes, sur le parasol
Prédisez d’abord : Sur les 13 origines, quelle méthode gagne sur le parasol : LightGBM ou Chronos-Bolt?
- Vendus en 14 jours
- 216
- Prévision pour les 14 jours
- 182
- WAPE à cette origine
- 29,0 %
- WAPE, les 13 origines
- 45,0 %
À l’origine du 11 mai 2025, la méthode Chronos-Bolt prévoit 182 unités pour les 14 jours suivants. 216 unités ont été vendues. Sa WAPE ici est de 29,0 % : sa prévision est trop basse. Sur les 13 origines, la méthode Chronos-Bolt a une WAPE de 45,0 % : rang 1 sur 6 méthodes. Elle bat la référence de base, naïve saisonnière (66,1 %).
- Unités vendues
- Prévision de la méthode choisie
- Référence de base : naïve saisonnière
Montrer toutes les méthodes, classées
| Rang | Méthode | Famille | WAPE à cette origine | WAPE, les 13 origines |
|---|---|---|---|---|
| 1 | Chronos-Bolt | modèle de fondation | 29,0 % | 45,0 % |
| 2 | LightGBM (récursif) | apprentissage automatique | 33,3 % | 49,3 % |
| 3 | AutoARIMA | statistique | 26,6 % | 62,6 % |
| 4 | moyenne mobile (28 jours) | référence de base | 54,2 % | 64,9 % |
| 5 | ETS | statistique | 31,8 % | 65,1 % |
| 6 | naïve saisonnière | référence de base | 38,9 % | 66,1 % |
Description textuelle de l’explorateur
L’explorateur montre un graphique des ventes quotidiennes du parasol. Les quatre semaines avant l’origine choisie forment une ligne grise, et les 14 jours suivants sont des points gris. La prévision de la méthode choisie est une ligne bleue, et la prévision naïve saisonnière, une ligne orange en tirets. Les commandes permettent de choisir l’origine (du 13 avril 2025 au 15 mars 2026) et une des six méthodes. À l’origine du 11 mai 2025, les ventes atteignent 216 parasols. Sur les 13 origines, la WAPE de chaque méthode est : Chronos-Bolt 45,0 %, LightGBM (récursif) 49,3 %, AutoARIMA 62,6 %, moyenne mobile (28 jours) 64,9 %, ETS 65,1 % et naïve saisonnière 66,1 %.
Ce que cela coûte : lisez le reste de la ligne
Section intitulée « Ce que cela coûte : lisez le reste de la ligne »Une ligne contient d’autres colonnes que la WAPE. Kenji les lit toutes.
- Méthode statistique
- Apprentissage automatique
- Modèle de fondation
Description textuelle du graphique
Trois panneaux. WAPE : ETS 41,3 %, LightGBM récursif 40,7 %, LightGBM direct 40,7 %, Chronos-Bolt 38,7 %. Biais : ETS +0,1 %, LightGBM récursif +0,7 %, LightGBM direct -0,6 %, Chronos-Bolt -5,6 %. Coût de commande : ETS 16 578 dollars, LightGBM récursif 14 749, LightGBM direct 13 711, Chronos-Bolt 14 750.
Ses prévisions sont trop basses
Section intitulée « Ses prévisions sont trop basses »Le biais est de −5,6 % : sur tout le test rétrospectif, les prévisions totalisent 5,6 % d’unités de moins que les ventes. Les autres méthodes restent à moins de 1,5 % de zéro. Des prévisions trop basses donnent des commandes trop petites. Supposons que Kenji commande la somme des prévisions sur 14 jours. Alors 56,6 % des commandes de Chronos-Bolt ne suffisent pas, contre 50,0 % pour ETS (mesuré au module 7). Sa commande coûte donc 14 750 dollars, soit 1 039 de plus que LightGBM direct, malgré une WAPE meilleure de 2 points.
Il ne voit pas le calendrier des promotions
Section intitulée « Il ne voit pas le calendrier des promotions »Le modèle lit uniquement les unités vendues. Sur les 154 jours de promotion, il a prévu 1 060 unités pour 1 927 vendues : -45 %, aussi aveugle qu’ETS (-43,5 %). LightGBM, qui voit l’indicateur, était à +5,2 %. Certaines versions de Chronos acceptent des entrées connues, comme un indicateur de promotion. La version de ce cours ne les utilise pas.
Son intervalle s’arrête à 80 %
Section intitulée « Son intervalle s’arrête à 80 % »Description textuelle du graphique
Couverture de l’intervalle à 80 % : naïve saisonnière 87,7 %, ETS 83,5 %, AutoARIMA 83,0 %, Chronos-Bolt 78,9 %. Couverture de l’intervalle à 90 % : naïve saisonnière 92,9 %, ETS 90,5 %, AutoARIMA 90,2 %, Chronos-Bolt 78,9 %.
Son intervalle à 80 % est un peu étroit : il contient 78,9 % des valeurs réelles plutôt que 80 %. Le vrai problème est l’intervalle à 90 %. Chronos-Bolt a été entraîné à fournir uniquement les quantiles 0,1 à 0,9. Si vous demandez 0,05 ou 0,95, il émet un avertissement et renvoie plutôt ses quantiles 0,1 et 0,9. Son « intervalle à 90 % » contient donc 78,9 % des valeurs, et non 90 %. Le module 7 commande du stock à partir d’un quantile élevé, donc cela compte.
Il lui faut son propre processus et de la mémoire
Section intitulée « Il lui faut son propre processus et de la mémoire »Dans les tests du cours sur un Mac avec puce Apple, Chronos-Bolt et LightGBM dans un même processus Python plantaient sans message d’erreur. Le plantage arrivait juste après le chargement du modèle. Les deux chargent leur propre copie d’une bibliothèque de travail parallèle (OpenMP). Le cours exécute maintenant Chronos dans un processus séparé, et le carnet de cette leçon n’importe pas LightGBM. En production, cela signifie une deuxième tâche à exécuter et à surveiller.
Le modèle compte 47,7 millions de paramètres. ETS conserve quelques nombres par produit. Le téléchargement fait environ 190 Mo, le chargement prend quelques secondes, et le processus Python a utilisé jusqu’à environ 895 Mo de mémoire. Sur processeur, il est rapide : le coût n’est donc pas le temps. Le coût est une grosse dépendance de plus, fixée à une révision. Quelqu’un d’autre l’a entraîné, sur des données que vous n’avez pas vues.
Quand utiliser un modèle de fondation, et quand l’éviter
Section intitulée « Quand utiliser un modèle de fondation, et quand l’éviter »Utilisez-le :
- comme référence de base solide sans coût d’entraînement : si votre modèle ne le bat pas au test rétrospectif, vous avez appris quelque chose;
- pour de nombreuses séries avec peu d’historique, ou une nouvelle entreprise, quand entraîner votre propre modèle est difficile;
- quand une première prévision rapide vaut plus que les derniers points de pourcentage.
Ne l’utilisez pas, ou pas seul :
- quand des entrées futures connues déterminent la série (promotions, prix) et que votre configuration ne peut pas les transmettre;
- quand la décision exige un quantile élevé que le modèle ne fournit pas;
- quand son biais coûte de l’argent, comme ici; vérifiez la colonne du biais, pas seulement la WAPE;
- quand vous ne pouvez pas exécuter et surveiller un autre gros modèle, ni en fixer la version.
Erreur courante
Un intervalle à 90 % qui n'existe pas
Symptôme : Tomás fixe le stock de sécurité à partir du quantile 0,95 de Chronos-Bolt. Il veut manquer de stock pour environ 1 commande sur 20 seulement. Dans le test rétrospectif, les ventes réelles dépassent ce quantile bien plus souvent qu’une fois sur 20.
Cause : Chronos-Bolt fournit uniquement les quantiles 0,1 à 0,9. Pour 0,05 et 0,95, il affiche un avertissement et renvoie ses quantiles 0,1 et 0,9. Son « intervalle à 90 % » contient 78,9 % des valeurs réelles, comme son intervalle à 80 %.
Correction : lisez les avertissements et mesurez la couverture de chaque intervalle utilisé dans le test rétrospectif. Utilisez une méthode dont l’intervalle respecte sa promesse à ce niveau, ou élargissez l’intervalle à partir des erreurs du test rétrospectif (module 7).
Conséquence pour le travail en IA : un modèle peut renvoyer un nombre pour toute question, même s’il n’a pas été conçu pour y répondre. Un intervalle apparemment correct, mais contenant moins de valeurs qu’annoncé, provoque des ruptures de stock que personne n’avait prévues.
Exercices guidés : un modèle de fondation dans le carnet
Section intitulée « Exercices guidés : un modèle de fondation dans le carnet »- Ouvrez le carnet dans l’encadré Faites cette leçon dans un carnet en haut de cette page.
- Exécutez les cellules de préparation et la cellule utilitaire. La première cellule peut prendre 2 minutes, car elle installe PyTorch.
- Dans la section 1, estimez la taille du modèle. Puis exécutez la cellule. Vous voyez
parameters (millions): 47.7(paramètres en millions : 47,7). - Dans la section 2, estimez si la médiane sera supérieure ou inférieure à 216. Puis exécutez la cellule. Vous voyez 181,8 et un graphique de l’intervalle.
- Dans la section 3, estimez si l’intervalle à 90 % contient 90 % des valeurs. Puis exécutez le test rétrospectif. Vous voyez une WAPE de 38,7 %, un biais de −5,6 % et deux couvertures de 0,789.
- Dans la section 4, écrivez votre réponse dans la cellule Your turn (à vous), puis exécutez la cellule de vérification.
À vous de jouer : ce que le modèle ne voit pas
Section intitulée « À vous de jouer : ce que le modèle ne voit pas »Avant toute exécution, faites une prédiction : les jours de promotion, Chronos-Bolt se rapproche-t-il d’ETS (−43,5 %) ou de LightGBM (+5,2 %)? Dans la section 4 du carnet (notebook) Jupyter, gardez les jours de promotion de fc_chronos. Calculez leur biais en % et placez-le dans promo_bias_chronos.
Afficher la réponse
p = fc_chronos.merge(sales[["unique_id", "ds", "on_promotion"]], on=["unique_id", "ds"])p = p[p["on_promotion"] == 1]promo_bias_chronos = round(float(100 * (p["yhat"].sum() - p["y"].sum()) / p["y"].sum()), 1)print(promo_bias_chronos, "% on", len(p), "promotion days")-45.0 % on 154 promotion daysChronos-Bolt prévoit 45,0 % trop bas les jours de promotion, comme ETS. Les deux lisent seulement le passé de la série. La meilleure exactitude globale ne garantit pas la meilleure prévision pour les jours les plus importants pour Kenji.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Tomás dit : « Le modèle de fondation a gagné. On devrait donc tout remplacer par ce modèle. » Donnez deux chiffres qui l'appuient et trois qui ne l'appuient pas.
Afficher la réponse
Pour lui : Chronos-Bolt obtient les meilleures MASE (0,784) et WAPE (38,7 %) du tableau du cours, sans entraînement. Il obtient la plus faible WAPE pour 28 des 50 produits. Contre lui : son biais est de −5,6 %, donc ses commandes sont plus souvent insuffisantes. Sa commande coûte 14 750 $ US, contre 13 711 pour le LightGBM direct. Sur les 154 jours de promotion, il prévoit 45,0 % trop bas, car il ne voit pas le calendrier des promotions. Et son intervalle à 90 % ne couvre que 78,9 % des valeurs réelles. Il n’a aucun quantile au-delà de 0,1 et 0,9.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Que signifie « sans exemple » pour Chronos-Bolt? Que lit-il dans une série de Larkfield avec la configuration du cours?
Afficher la réponse
Sans exemple (zero-shot) signifie que le modèle prévoit une série sans entraînement sur celle-ci, ni sur aucune donnée de Larkfield. Ses auteurs l’ont entraîné une fois sur de nombreuses séries chronologiques publiques. Dans la configuration du cours, il lit seulement les 512 dernières valeurs quotidiennes des unités vendues. Il les met à l’échelle et les découpe en blocs. Il ne lit ni les prix, ni les promotions, ni le calendrier. Il retourne neuf quantiles, de 0,1 à 0,9, pour chacun des 14 jours; la médiane est la prévision ponctuelle.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Nommez trois coûts d'exécution de Chronos-Bolt dans la tâche hebdomadaire de Larkfield qui n'apparaissent pas dans la colonne WAPE.
Afficher la réponse
Il a besoin de son propre processus : exécuté avec LightGBM dans un même processus Python, il a planté sans message d’erreur. C’est une dépendance volumineuse, fixée à une révision précise. Il compte 47,7 millions de paramètres. Son téléchargement fait environ 190 Mo et sa consommation de mémoire atteint environ 895 Mo. Et son intervalle s’arrête aux quantiles 0,1 et 0,9. Une décision qui exige un niveau de 95 % reçoit celui de 90 %, à moins que quelqu’un lise l’avertissement. Son biais de −5,6 % augmente aussi le coût de la commande, mais celui-ci apparaît dans le tableau.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Les méthodes de prévision neuronales (N-BEATS, un RNN) apprennent à partir de nombreuses séries. Elles exigent beaucoup de données, un long entraînement et des ajustements. Le cours ne les a pas exécutées.
- Un modèle de fondation est préentraîné sur de nombreuses séries et prévoit sans exemple. Chronos-Bolt small lit seulement les unités vendues et retourne les quantiles de 0,1 à 0,9.
- Sur Larkfield, il gagne en exactitude : MASE de 0,784 et WAPE de 38,7 %, la meilleure méthode pour 28 des 50 produits. Il produit 650 prévisions en environ 2 secondes sur un processeur.
- Ce qu’il coûte : un biais de −5,6 %, donc sa commande (14 750 $ US) n’est pas la moins chère. Il est à −45,0 % les jours de promotion et n’a aucun intervalle à 90 %. Il exige son propre processus et compte 47,7 millions de paramètres.
Le tableau contient maintenant des méthodes simples, statistiques, d’apprentissage automatique et des modèles de fondation. La méthode la plus exacte n’est pas la moins chère, et la moins chère n’est pas la plus simple. Ensuite, vous lirez le tableau complet pour comparer les coûts, la vitesse et la fiabilité. Vous déciderez quand un modèle complexe ne vaut pas la peine.
Leçon suivante : Quand ne pas construire de modèle