
Amplification de gradient avec LightGBM
- Leçon 15
- 45 min
- Module 5 : Méthodes par apprentissage automatique
Où nous en sommes
Dans la leçon précédente, nous avons créé des variables de prévision à la main et ajusté une régression linéaire. Elle utilisait l'indicateur de promotion, mais ajoutait le même nombre d'unités pour chaque produit. Dans cette leçon, nous entraînons un seul modèle LightGBM pour tous les produits avec mlforecast. Nous prévoyons plusieurs jours à l'avance de deux façons et évitons les pièges de fuite cachés dans les variables mobiles. Pensez d'abord à un golfeur sur le vert.
Leçon 15 sur 27 · Prévision et séries chronologiques : prévoir la suiteAmplification de gradient avec LightGBM
1. Les prévisions servent des décisions
2. Lire une série chronologique
3. Références de base et tests honnêtes
4. Méthodes statistiques
5. Méthodes par apprentissage automatique
6. Séries difficiles et séries nombreuses
7. L'incertitude et la décision
8. Exploiter une prévision en production
Ce que vous saurez faire
Entraînez un seul modèle d’amplification de gradient pour tous les produits. Prévoyez 14 jours à l’avance sans franchir l’écart temporel et reconnaissez une variable mobile qui laisse fuir le futur. LightGBM donne le coût de commande le plus bas du tableau du cours, si vous le configurez sans fuite.
Carnet JupyterFaites cette leçon dans un carnet
Le carnet (notebook) Jupyter contient toutes les cellules de code, les tâches et les vérifications de cette leçon. Il entraîne LightGBM, teste rétrospectivement trois configurations et trouve la fuite dans une moyenne mobile. Ses cellules de configuration installent les paquets et téléchargent les données de Larkfield. Aucune configuration locale n’est donc nécessaire. Environ 45 minutes, dont 2 à 3 minutes d’attente.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les décalages (lags), les moyennes mobiles, les entrées futures connues et le modèle global, dans La prévision comme régression.
- Les arbres de décision et l’amplification de gradient (gradient boosting) : consultez Les arbres de décision et Les méthodes d’ensemble du cours d’apprentissage automatique. Cette leçon rappelle brièvement l’idée.
- La colonne de coût du tableau du test rétrospectif (backtest), dans Mesurer l’erreur qui compte.
Ce qu’il vous faut sur votre ordinateur
Rien : le carnet fonctionne dans Colab ou Kaggle. Sa première cellule installe mlforecast 1.1.0 et LightGBM 4.7.0.
Testé avec Python 3.12, pandas 2.3.3, mlforecast 1.1.0 et LightGBM 4.7.0, dans Jupyter sur macOS.
Un golfeur sur le vert
Section intitulée « Un golfeur sur le vert »Un golfeur est sur le vert, à 10 mètres du trou. Son premier coup roulé s’arrête 2 mètres avant le trou. Le deuxième vise seulement les 2 mètres restants. Il s’arrête 30 centimètres après le trou, et le troisième corrige ces 30 centimètres.
Chaque coup est petit et imparfait. Mais chacun corrige ce que les coups précédents ont laissé. Ensemble, ils atteignent le trou.
Le problème : un nombre fixe pour chaque produit
Section intitulée « Le problème : un nombre fixe pour chaque produit »La régression linéaire globale de la leçon précédente utilisait l’indicateur de promotion. Elle apprenait un seul poids pour cet indicateur : « en promotion, ajouter w unités ». Le même w pour chaque produit.
Voici un petit exemple construit. Deux produits, chacun observé un jour normal et un jour de promotion :
| Produit | En promotion | Unités vendues | Modèle linéaire | Erreur |
|---|---|---|---|---|
| lent | non | 4 | 0 | 4 |
| lent | oui | 8 | 12 | −4 |
| rapide | non | 20 | 24 | −4 |
| rapide | oui | 40 | 36 | 4 |
Une promotion double les ventes des deux produits : +4 pour le produit lent, +20 pour le rapide. Le meilleur modèle linéaire avec les colonnes « rapide » et « en promotion » est : unités = 24 × rapide + 12 × promotion. Ses 12 unités sont trop nombreuses pour le produit lent et trop peu nombreuses pour le rapide. Aucun poids ne corrige cela, car l’effet d’une promotion dépend du produit. Deux variables qui agissent ensemble de cette façon ont une interaction.
Les promotions de Larkfield fonctionnent ainsi. Leur hausse médiane due à la promotion (uplift) est de ×1,87 (voir Calendriers, jours fériés et événements). C’est une multiplication, pas une addition.
L’idée : plusieurs petits arbres, chacun corrigeant les dernières erreurs
Section intitulée « L’idée : plusieurs petits arbres, chacun corrigeant les dernières erreurs »Un arbre de décision prédit en posant des questions auxquelles on répond par oui ou non. « Le produit se vend-il vite? Est-il en promotion? » Chaque réponse mène à une feuille contenant un nombre. Un arbre peut poser la question sur la promotion après celle sur le produit. Il peut donc donner une hausse différente à chaque type de produit.
Un petit arbre seul est une méthode de prévision faible. L’amplification de gradient en construit plusieurs, comme les coups roulés du golfeur :
- Commencez avec un seul nombre pour chaque ligne : la moyenne.
- Calculez les erreurs restantes.
- Ajustez un petit arbre qui prédit ces erreurs.
- Ajoutez une petite part de la prédiction de cet arbre à la prévision.
- Répétez des centaines de fois.
Le nom décrit ce que fait la méthode. Amplification : des modèles faibles, l’un après l’autre, deviennent un modèle fort. Gradient : chaque nouvel arbre suit la direction qui réduit le plus l’erreur. LightGBM est une bibliothèque qui fait cela rapidement sur de grands tableaux. Le cours d’apprentissage automatique l’explique en détail dans Les méthodes d’ensemble.
Un petit exemple détaillé : deux arbres
Section intitulée « Un petit exemple détaillé : deux arbres »Les quatre mêmes lignes. Les bibliothèques réelles font de très petits pas (ici 0,05) et construisent de nombreux arbres. Cet exemple fait des pas complets, pour que deux arbres suffisent.
| Produit | Promotion | Ventes | Départ (moyenne) | Erreur restante | Arbre 1 : rapide? | Après l’arbre 1 | Erreur restante | Arbre 2 : rapide? puis promotion? | Après l’arbre 2 |
|---|---|---|---|---|---|---|---|---|---|
| lent | non | 4 | 18 | −14 | −12 | 6 | −2 | −2 | 4 |
| lent | oui | 8 | 18 | −10 | −12 | 6 | 2 | +2 | 8 |
| rapide | non | 20 | 18 | 2 | +12 | 30 | −10 | −10 | 20 |
| rapide | oui | 40 | 18 | 22 | +12 | 30 | 10 | +10 | 40 |
Suivez le produit lent en promotion, à la deuxième ligne. Le départ est la moyenne des quatre lignes : (4 + 8 + 20 + 40) ÷ 4 = 18. L’arbre 1 pose une question, « se vend vite? », et prédit l’erreur moyenne de chaque groupe : −12 pour les lignes lentes. La prévision devient donc 18 − 12 = 6. L’erreur restante est 8 − 6 = 2. L’arbre 2 pose deux questions, « rapide? » puis « en promotion? », et prédit +2 pour cette feuille. La prévision est 6 + 2 = 8.
L’arbre 2 donne +2 au produit lent en promotion et +10 au rapide. C’est l’interaction que le modèle linéaire ne pouvait pas apprendre. Avec des données réelles, les nombreux petits pas empêchent le modèle d’apprendre le bruit.
Larkfield : un seul modèle LightGBM pour tous les produits
Section intitulée « Larkfield : un seul modèle LightGBM pour tous les produits »Priya entraîne LightGBM avec mlforecast, avec les entrées du tableau du cours. Ce sont les décalages de 1, 7, 14 et 28 jours et les moyennes des 7 et 28 derniers jours. Une autre entrée est la moyenne des décalages 7 à 10 : les 4 jours qui se terminent une semaine auparavant. Le calendrier ajoute le jour de la semaine, le mois et le jour de l’année. Les entrées connues sont le prix, l’indicateur de promotion et trois indicateurs de jours fériés.
import lightgbm as lgbfrom mlforecast import MLForecastfrom mlforecast.lag_transforms import RollingMean
LGB = dict(n_estimators=400, learning_rate=0.05, num_leaves=63, min_child_samples=20, subsample=0.8,           subsample_freq=1, colsample_bytree=0.8, random_state=35, n_jobs=2, verbose=-1)
def make_model(lags, lag_transforms):    return MLForecast(models={"lgbm": lgb.LGBMRegressor(**LGB)}, freq="D", lags=lags, lag_transforms=lag_transforms,                      date_features=["dayofweek", "month", "dayofyear"], num_threads=1)
RECURSIVE = dict(lags=[1, 7, 14, 28], lag_transforms={1: [RollingMean(7), RollingMean(28)], 7: [RollingMean(4)]})
n_estimators=400 est le nombre d’arbres. learning_rate=0.05 est la taille de chaque pas. num_leaves=63 limite la taille de chaque arbre. Ce sont les paramètres du tableau du cours, pas des valeurs optimisées.
Aux 13 origines du test rétrospectif du cours, le carnet affiche :
method horizon MASE WAPE % bias % pinball fit s cost $LightGBM, recursive 14 0.816 40.7 0.7 12.54 14749LightGBM bat ETS (41,3 %) et les deux régressions linéaires (41,7 % et 42,6 %) selon la WAPE. Sa commande coûte 14 749 dollars contre 16 578 pour ETS. Sur les 154 jours de promotion, son biais est de +5,2 %. Celui d’ETS était de −43,5 %.
Le parasol dans le test rétrospectif
Section intitulée « Le parasol dans le test rétrospectif »L’explorateur contient les méthodes que vous avez vues jusqu’ici. Déplacez l’origine et comparez LightGBM avec ETS et les références de base pour le parasol.
Explorer
LightGBM pour le parasol
Prédisez d’abord : Sur les 13 origines, LightGBM bat-il ETS pour le parasol, et de combien?
- Vendus en 14 jours
- 101
- Prévision pour les 14 jours
- 114
- WAPE à cette origine
- 44,8 %
- WAPE, les 13 origines
- 49,3 %
À l’origine du 8 juin 2025, la méthode LightGBM (récursif) prévoit 114 unités pour les 14 jours suivants. 101 unités ont été vendues. Sa WAPE ici est de 44,8 % : sa prévision est trop haute. Sur les 13 origines, la méthode LightGBM (récursif) a une WAPE de 49,3 % : rang 1 sur 5 méthodes. Elle bat la référence de base, naïve saisonnière (66,1 %).
- Unités vendues
- Prévision de la méthode choisie
- Référence de base : naïve saisonnière
Montrer toutes les méthodes, classées
| Rang | Méthode | Famille | WAPE à cette origine | WAPE, les 13 origines |
|---|---|---|---|---|
| 1 | LightGBM (récursif) | apprentissage automatique | 44,8 % | 49,3 % |
| 2 | AutoARIMA | statistique | 51,7 % | 62,6 % |
| 3 | moyenne mobile (28 jours) | référence de base | 101,3 % | 64,9 % |
| 4 | ETS | statistique | 45,5 % | 65,1 % |
| 5 | naïve saisonnière | référence de base | 74,3 % | 66,1 % |
Description textuelle de l’explorateur
L’explorateur montre les ventes quotidiennes du parasol : les quatre semaines avant l’origine choisie (ligne grise) et les 14 jours après (points gris). Il ajoute la prévision de la méthode choisie (bleu) et la prévision naïve saisonnière (orange en tirets). Les commandes permettent de choisir l’origine (du 13 avril 2025 au 15 mars 2026) et l’une des cinq méthodes. À l’origine du 8 juin 2025, 101 parasols ont été vendus. LightGBM en prévoyait 114 (WAPE de 44,8 % à cette origine) et ETS, 92 (45,5 %). Sur les 13 origines, la WAPE de chaque méthode est : LightGBM (récursif) 49,3 %, AutoARIMA 62,6 %, moyenne mobile (28 jours) 64,9 %, ETS 65,1 % et naïve saisonnière 66,1 %.
Pour le parasol, LightGBM gagne nettement. Sur les 50 produits, son avance est beaucoup plus petite, et ETS gagne encore pour 21 produits. La dernière leçon de ce module examine cela.
Plusieurs jours à l’avance : récursive ou directe
Section intitulée « Plusieurs jours à l’avance : récursive ou directe »La commande de Kenji couvre 14 jours. Le modèle ci-dessus utilise lag1, mais au jour 5 de la commande, « hier » n’a pas encore eu lieu. Il y a trois réponses sans fuite.

Description textuelle du diagramme
Le panneau du haut, récursif, montre une boîte « connu jusqu’au dimanche », puis un modèle qui alimente les jours 1, 2, 3 et 14. Les flèches indiquent que chaque prévision devient le décalage 1 du lendemain. Une erreur au jour 1 peut donc s’accumuler. Le panneau du bas, direct, montre les mêmes jours, chacun avec son modèle, du modèle 1 au modèle 14. Chaque modèle voit seulement ce qui est connu le dimanche.
- Récursive (par défaut dans mlforecast) : un seul modèle. Sa prévision pour le jour 1 devient
lag1pour le jour 2, et ainsi de suite. C’est rapide, mais une erreur au jour 1 se propage au jour 2. - Décalages de 14 jours et plus : un seul modèle avec des entrées datant toutes d’au moins 14 jours. Rien n’a besoin d’être rempli, mais le modèle ne voit jamais les deux dernières semaines.
- Directe :
max_horizon=14entraîne 14 modèles. Le modèle du jour 5 apprend à partir de lignes dont les entrées précèdent la cible de 5 jours. Aucune prévision n’est réutilisée comme entrée, mais l’ajustement prend beaucoup plus de temps.
Le tableau du cours contient les trois :
- Méthode statistique
- Apprentissage automatique
Description textuelle du graphique
Trois panneaux. WAPE : ETS 41,3 %, LightGBM récursif 40,7 %, décalages de 14 jours et plus 40,9 %, direct 40,7 %. Coût de la commande de 14 jours : ETS 16 578 dollars, récursif 14 749, décalages de 14 jours et plus 14 629, direct 13 711. Temps d’ajustement pour les 13 origines : ETS environ 46 secondes, récursif environ 16, décalages de 14 jours et plus environ 12, direct environ 156.
Les trois ont presque la même WAPE, mais leurs coûts diffèrent. La prévision directe coûte 1 038 dollars de moins par commande que la récursive.
Méfiez-vous des petits tests. Pour gagner du temps, le carnet exécute la prévision directe aux 4 dernières origines seulement. Là, elle est la plus coûteuse des trois :
method horizon MASE WAPE % bias % pinball fit s cost $lags >= 14, last 4 cut-offs 14 0.652 38.9 -1.4 12.49 9174 recursive, last 4 cut-offs 14 0.682 41.9 0.2 12.54 9756 direct, last 4 cut-offs 14 0.696 42.0 2.7 93.53 9926(Le fit s (temps d’ajustement en secondes) des deux premières lignes couvre les 13 origines.) Ces quatre origines correspondent à quatre fenêtres d’hiver et de début de printemps. Le classement des méthodes change d’une origine à l’autre. Comparez-les sur les 13.
La fuite se cache dans les variables mobiles
Section intitulée « La fuite se cache dans les variables mobiles »Une moyenne mobile est la variable la plus utile de LightGBM, comme le montre la prochaine section. C’est aussi la plus facile à mal construire.
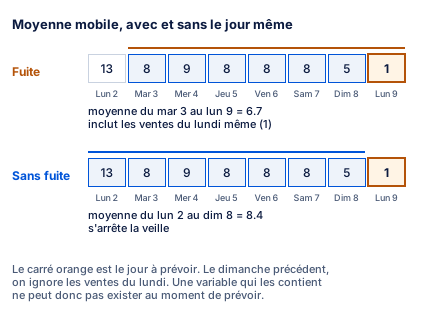
Description textuelle du diagramme
Deux lignes montrent les parasols vendus du lundi 2 au lundi 9 juin 2025 : 13, 8, 9, 8, 8, 8, 5 et 1. Le lundi 9, en orange, est le jour à prévoir. Dans la ligne avec fuite, la fenêtre couvre le mardi 3 au lundi 9. Sa moyenne, 6,7, inclut donc la vente de 1 du lundi lui-même. Dans la ligne sans fuite, la fenêtre couvre le lundi 2 au dimanche 8, et sa moyenne est de 8,4.
s.rolling(7).mean() dans pandas inclut la ligne actuelle. Tomás la calcule sur toute la série avant le test rétrospectif. Il la donne à LightGBM, avec le jour de la semaine et l’indicateur de promotion. Dans le test rétrospectif :
| Méthode | MASE | WAPE % | Coût $ par commande |
|---|---|---|---|
| LightGBM avec la moyenne mobile qui fuit | 0,671 | 33,5 | 4 899 |
| LightGBM, récursif (sans fuite) | 0,816 | 40,7 | 14 749 |
Le modèle avec fuite coûte le tiers du modèle sans fuite : c’est le signal d’alerte. Le modèle a appris à copier une entrée qui n’existera pas pendant la semaine de commande.
mlforecast évite ce piège : lag_transforms={1: [RollingMean(7)]} calcule la moyenne à partir du décalage 1, et s’arrête donc la veille. Quand vous créez une variable dans pandas, décalez d’abord, puis calculez la moyenne mobile.
Ce que le modèle a utilisé : l’importance des variables
Section intitulée « Ce que le modèle a utilisé : l’importance des variables »LightGBM peut indiquer combien chaque variable a aidé. Le gain d’une variable est la réduction d’erreur obtenue par ses divisions, additionnée sur tous les arbres. Voici la part de chaque variable dans le modèle entraîné à la dernière origine :
Description textuelle du graphique
Les 10 premières variables selon leur part du gain : moyenne des 7 derniers jours 52,4 %, moyenne des 28 derniers jours 22,5 %, hier (décalage 1) 6,7 %, jour de l’année 4,3 %, moyenne du même jour de semaine, 4 semaines 4,1 %, décalage 28 1,8 %, décalage 7 1,8 %, décalage 14 1,8 %, jour de la semaine 1,5 %, prix 1,2 %.
Le modèle demande surtout « combien ce produit s’est-il vendu récemment? », puis ajuste. Tomás ne voit aucun indicateur de promotion parmi les 10 premières variables et conclut : « Les promotions ne comptent pas. » C’est faux. Les jours de promotion sont rares, donc les divisions sur cet indicateur réduisent moins l’erreur totale. Ils comptent pourtant beaucoup ces jours-là. L’importance indique ce que le modèle a utilisé, pas ce qui cause les ventes. Le cours d’apprentissage automatique explique cette limite dans Expliquer les prédictions.
Quand utiliser LightGBM, et ce qu’il coûte
Section intitulée « Quand utiliser LightGBM, et ce qu’il coûte »Utilisez un modèle global d’amplification de gradient quand vous avez plusieurs séries liées et des entrées futures connues. Il est le plus fort quand les effets interagissent, comme une promotion qui multiplie les ventes.
Ses coûts :
- Paramètres. Le nombre d’arbres, la taille des pas et la taille des arbres changent le résultat. Les optimiser sur le test rétrospectif rend le score meilleur qu’il ne le sera réellement. Tester comme dans le futur l’expliquait (« essais multiples »).
- Temps d’ajustement. Des secondes pour le modèle récursif, des minutes pour le direct, à chaque réajustement.
- Aucun intervalle. LightGBM donne un nombre par jour. Le module 7 ajoute un intervalle.
- Aucune valeur au-delà de ce qu’il a vu. Un arbre ne peut pas prévoir plus haut que sa feuille la plus élevée. Si les ventes d’un produit atteignent un niveau inédit, ETS peut suivre la tendance; un arbre ne le peut pas.
- Confiance. Kenji peut lire une prévision ETS comme « niveau récent plus le motif hebdomadaire ». Un modèle de 400 arbres est plus difficile à expliquer.
Erreur courante
Une moyenne mobile qui inclut le jour
Symptôme : un nouveau modèle LightGBM a une WAPE de 33,5 % et un coût de commande de 4 899 $ US. Le modèle sans fuite a 40,7 % et 14 749.
Cause : sa moyenne mobile a été calculée avec rolling(7) sur toute la série avant le test rétrospectif. La variable de chaque jour contient les ventes de ce jour, inconnues au moment de prévoir.
Correction : construisez les variables mobiles à partir des décalages (shift d’abord, puis rolling), ou avec lag_transforms de mlforecast. Recalculez les variables dans le test rétrospectif, seulement à partir des données d’entraînement de chaque origine.
Conséquence pour le travail en IA : un modèle avec fuite gagne tous les tests rétrospectifs, puis échoue en production. Quand un modèle bat toutes les autres méthodes de loin, cherchez une fuite avant de célébrer.
Exercice guidé : LightGBM dans le carnet
Section intitulée « Exercice guidé : LightGBM dans le carnet »- Ouvrez le carnet dans l’encadré Faites cette leçon dans un carnet en haut de cette page.
- Exécutez les cellules de configuration et la cellule des fonctions utilitaires. La cellule de données se termine par la ligne
Ready:(prêt). - Dans la section 1, prédisez quelle variable LightGBM utilise le plus. Puis exécutez la cellule. Vous voyez
rolling_mean_lag1_window_size7en premier, avec 52,4. - Dans la section 2, prédisez si LightGBM bat ETS. Puis exécutez le test rétrospectif. Vous voyez une WAPE % de 40,7 et un coût de 14 749.
- Dans la section 3, exécutez les trois configurations (environ une minute). Vous voyez les décalages de 14 jours et plus avec une WAPE % de 40,9, puis trois lignes pour les 4 dernières origines.
- Dans la section 4, prédisez si le modèle avec fuite semble meilleur ou pire. Puis exécutez-le. Vous voyez une WAPE % de 33,5.
- Dans la section 5, écrivez votre réponse dans la cellule Your turn (à vous), puis exécutez la cellule de vérification.
À vous de jouer : LightGBM les jours de promotion
Section intitulée « À vous de jouer : LightGBM les jours de promotion »ETS a sous-estimé les unités de 43,5 % pendant les 154 jours de promotion. Avant de lancer quoi que ce soit, faites une prédiction : LightGBM prévoit-il trop ou trop peu ces jours-là? Dans le carnet (notebook) Jupyter, à la section 5, gardez les jours de promotion de fc_rec. Calculez leur biais en % et placez-le dans promo_bias_lgbm.
Afficher la réponse
p = fc_rec.merge(sales[["unique_id", "ds", "on_promotion"]], on=["unique_id", "ds"])p = p[p["on_promotion"] == 1]promo_bias_lgbm = round(float(100 * (p["yhat"].sum() - p["y"].sum()) / p["y"].sum()), 1)print(promo_bias_lgbm, "% on", len(p), "promotion days")5.2 % on 154 promotion daysLightGBM prévoit 5,2 % de trop les jours de promotion. Il est proche de la régression linéaire globale (+5,9 %) et loin d’ETS (−43,5 %). Il voit l’indicateur de promotion. Les autres jours, il prévoit seulement 0,5 % de trop.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Avec le petit exemple, expliquez pourquoi un modèle linéaire ne peut pas apprendre une promotion qui double les ventes. Comment deux arbres entraînés par amplification de gradient y arrivent-ils?
Afficher la réponse
Le produit peu vendu se vend à 4 unités, ou 8 en promotion; le produit très vendu, à 20 ou 40. La promotion ajoute 4 unités à l’un et 20 à l’autre. Un modèle linéaire a un seul poids pour « en promotion ». Il ajoute donc le même nombre aux deux. Il ajoute 12 unités : trop pour le produit peu vendu et trop peu pour le produit très vendu. L’amplification de gradient (gradient boosting) part de la moyenne (18) et ajoute des arbres qui prédisent les erreurs restantes. L’arbre 1 demande « produit très vendu? » (−12 ou +12). L’arbre 2 demande « très vendu? », puis « en promotion? ». Il donne +2 au produit peu vendu en promotion et +10 au produit très vendu. Un arbre peut donner à chaque type de produit sa propre hausse due à la promotion (uplift).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Nommez les trois façons de prévoir les 14 prochains jours avec LightGBM. Donnez un avantage et un coût de la prévision directe, avec les chiffres de Larkfield.
Afficher la réponse
Prévision récursive : un modèle utilise ses propres prévisions comme décalages (lags) pour les jours suivants. Décalages de 14 jours et plus : un modèle dont toutes les entrées sont connues pour l’ensemble de la commande. Prévision directe : un modèle par jour à prévoir (14 modèles), chacun utilisant seulement ce qui est connu à l’origine. La prévision directe avait le coût de commande le plus bas du tableau du cours : 13 711 $ US. La prévision récursive coûtait 14 749 $ US. Le temps d’ajustement était environ dix fois plus long : environ 156 secondes contre 16 pour les 13 origines. Et pour les 4 dernières origines seulement, elle était la plus chère des trois. Un petit test peut donc induire en erreur.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Faites une prédiction : la nouvelle variable d'un collègue fait passer la WAPE de LightGBM de 40,7 % à 33,5 %. Que vérifiez-vous d'abord, et comment?
Afficher la réponse
Vérifiez d’abord s’il y a une fuite de données. Une amélioration aussi forte avec une seule variable signale une variable qui contient la cible. Regardez comment la variable est calculée. Une moyenne mobile avec rolling(7) sur toute la série, sans décalage, inclut le jour lui-même. Recalculez-la à partir des décalages : décalez d’abord, puis calculez la moyenne mobile. Faites-le dans le test rétrospectif (backtest), à partir des données d’entraînement de chaque origine. Sur Larkfield, la moyenne mobile avec fuite donnait 33,5 % et un coût de commande de 4 899 $ US. Sans la fuite, le modèle revient à 40,7 % et à 14 749.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- L’amplification de gradient ajoute de nombreux petits arbres de décision. Chacun prédit les erreurs laissées par les arbres précédents. Les arbres apprennent des interactions, comme une promotion qui double les ventes.
- Un modèle LightGBM global pour les 50 produits : WAPE de 40,7 %, coût de commande de 14 749 $ US, +5,2 % les jours de promotion.
- Plusieurs jours à prévoir : prévision récursive (rapide), décalages de 14 jours et plus, ou directe : un modèle par jour. La prévision directe a le coût le plus bas du tableau, soit 13 711 $ US. Son temps d’ajustement est environ dix fois plus long.
- Une moyenne mobile qui inclut le jour est une fuite de données. Elle donne une WAPE de 33,5 % et un coût de 4 899 $ US impossibles à obtenir en pratique. Décalez d’abord, puis calculez la moyenne mobile.
- L’importance des variables indique ce que le modèle a utilisé, pas ce qui cause les ventes. Les moyennes récentes représentent les trois quarts du gain.
Vous pouvez maintenant entraîner une méthode de prévision globale par apprentissage automatique et la soumettre à un test rétrospectif. Mais Tomás a une question : pourquoi entraîner un modèle si un modèle préentraîné peut prévoir n’importe quelle série? Ensuite, vous utilisez un modèle de fondation sans entraînement et mesurez son coût.
Leçon suivante : Modèles profonds et modèles de fondation