
Ce qu'une vue conçue pour les agents ajoute
- Leçon 28
- 35 min
- Module 8 : Outils : Langfuse, les autres et l'inspecteur d'exécutions
Où nous en sommes
Dans la dernière leçon, nous avons comparé des outils généraux selon des critères précis et vu leurs points forts. Certaines questions prennent encore du temps dans ces outils, comme raconter une exécution à un auditeur. Dans cette leçon, nous explorons l'inspecteur d'exécutions et découvrons le calcul d'un de ses indicateurs de défaillance. Nous choisissons aussi les vues nécessaires à notre équipe. Nous commençons dans un hôpital.
Leçon 28 sur 28 · Observabilité des agents d'IA : traces, coûts et pistes d'auditCe qu'une vue conçue pour les agents ajoute
1. Pourquoi les agents ont besoin de leur propre observabilité
2. OpenTelemetry pour les agents
3. Instrumenter le flux de travail
4. Trouver les défaillances des agents dans Grafana
5. Le coût
6. Pistes d'audit
7. Alertes, niveaux de service et qualité
8. Outils : Langfuse, les autres et l'inspecteur d'exécutions
Ce que vous saurez faire
Découvrez les questions auxquelles une petite vue réservée aux exécutions d’agents répond plus vite que Grafana ou Langfuse. Vérifiez ensuite le fonctionnement d’un indicateur et choisissez les vues nécessaires à votre équipe.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les cinq modèles de défaillance et leurs indicateurs, dans Les modèles de défaillance des agents.
- Le récit d’audit d’une exécution, dans Répondre à une question d’audit.
- Les outils comparés dans Choisir des outils pour une équipe.
Ce qu’il vous faut sur votre ordinateur
- Le dossier de travaux pratiques
nextia-learning-labs/C31/inspector, à côté de votre projet, et Python 3.12 ou une version ultérieure. L’inspecteur utilise uniquement la bibliothèque standard. L’environnement virtuel de votre projet convient donc. Aucun besoin de Node.js, de Docker ou d’un compte. - Un navigateur. L’inspecteur fonctionne uniquement sur votre ordinateur, à l’adresse
127.0.0.1, et n’envoie aucune donnée ailleurs.
Testé sur macOS (Apple silicon) avec Python 3.12.13. Les commandes Windows et Linux sont fournies, mais n’ont pas été exécutées. L’inspecteur d’exécutions est une application de référence de ce cours : vous l’utilisez et lisez son code, sans la construire.
Trois documents pour un patient
Section intitulée « Trois documents pour un patient »Dans un hôpital, un patient a trois documents. La fiche de l’infirmière montre le pouls et la température chaque heure. Elle avertit quand une valeur sort de la plage prévue. Le rapport de laboratoire montre chaque test et son résultat. Quand le patient rentre chez lui, le médecin rédige une lettre de congé pour la famille. Elle explique simplement ce qui s’est passé, les soins donnés, qui a décidé et les prochaines étapes.
Les trois documents reposent sur les mêmes faits. Mais la famille ne peut pas lire la fiche, et l’infirmière n’a pas besoin de la lettre. Chaque document vise un lecteur et une question.
Le problème : la question de Grace dans un outil général
Section intitulée « Le problème : la question de Grace dans un outil général »Grace dirige le soutien et approuve les remboursements. Elle pose une question à Amira sur le double remboursement : « Avons-nous payé deux fois le client du billet T-90104? Et qui l’a approuvé? »
Amira peut répondre dans Grafana. Elle écrit la requête TraceQL pour une écriture en double, ouvre la trace 2 et lit deux spans (portions de trace) execute_tool request_refund. Elle compare ensuite leurs attributs. Puis elle suit le lien du span vers la trace 1 pour retrouver la proposition. Elle peut aussi répondre dans Langfuse, à partir de la session. Mais Grace ne peut faire ni l’un ni l’autre : elle ne lit ni TraceQL ni les attributs des spans. Aucun outil ne dit non plus si la piste d’audit est intacte, la première question d’un auditeur.
Chaque question d’audit passe donc par un ingénieur. La réponse existe dans les données, mais personne n’a écrit la « lettre de congé ».
L’idée : une petite vue pour un type de lecteur
Section intitulée « L’idée : une petite vue pour un type de lecteur »Une vue conçue pour les agents est une petite application qui lit les mêmes données que les outils généraux. Elle répond à quelques questions fixes pour un type de lecteur. Elle ne remplace pas Grafana ou Langfuse. Elle lit les mêmes spans OpenTelemetry et la même piste d’audit, selon les mêmes règles. Elle les présente dans les mots du lecteur.
L’inspecteur d’exécutions du cours en est un exemple. Il compte cinq écrans : Runs (exécutions), Run (exécution), Audit (audit), Cost (coût) et Compare (comparaison). Il est en lecture seule. Il n’offre volontairement ni évaluations, ni alertes, ni comptes : les outils généraux s’en chargent.
Démarrer l’inspecteur
Section intitulée « Démarrer l’inspecteur »-
Ouvrez un terminal dans le dossier de travaux pratiques de l’inspecteur :
Fenêtre de terminal cd ../nextia-learning-labs/C31/inspectorFenêtre de terminal cd ..\nextia-learning-labs\C31\inspectorFenêtre de terminal cd ../nextia-learning-labs/C31/inspector -
Démarrez-le avec ses données intégrées, la semaine rejouée :
Fenêtre de terminal python -m larkfield_inspectorRun inspector 1.0.0 on http://127.0.0.1:8318/ (saved mode: the built-in replayed week).The saved data is a replayed week: real recorded model decisions from the agents course, constructed traffic and practice incidents. No data leaves this computer.Press Ctrl+C to stop.Votre navigateur ouvre l’écran Runs. Sinon, ouvrez
http://127.0.0.1:8318/. -
Gardez ce terminal ouvert. Appuyez sur Ctrl+C dans ce terminal quand vous avez terminé.
Visite des cinq écrans
Section intitulée « Visite des cinq écrans »Runs : les exécutions signalées de la semaine
Section intitulée « Runs : les exécutions signalées de la semaine »Sur l’écran Runs, réglez Flag (indicateur) sur Any flag (tout indicateur) :
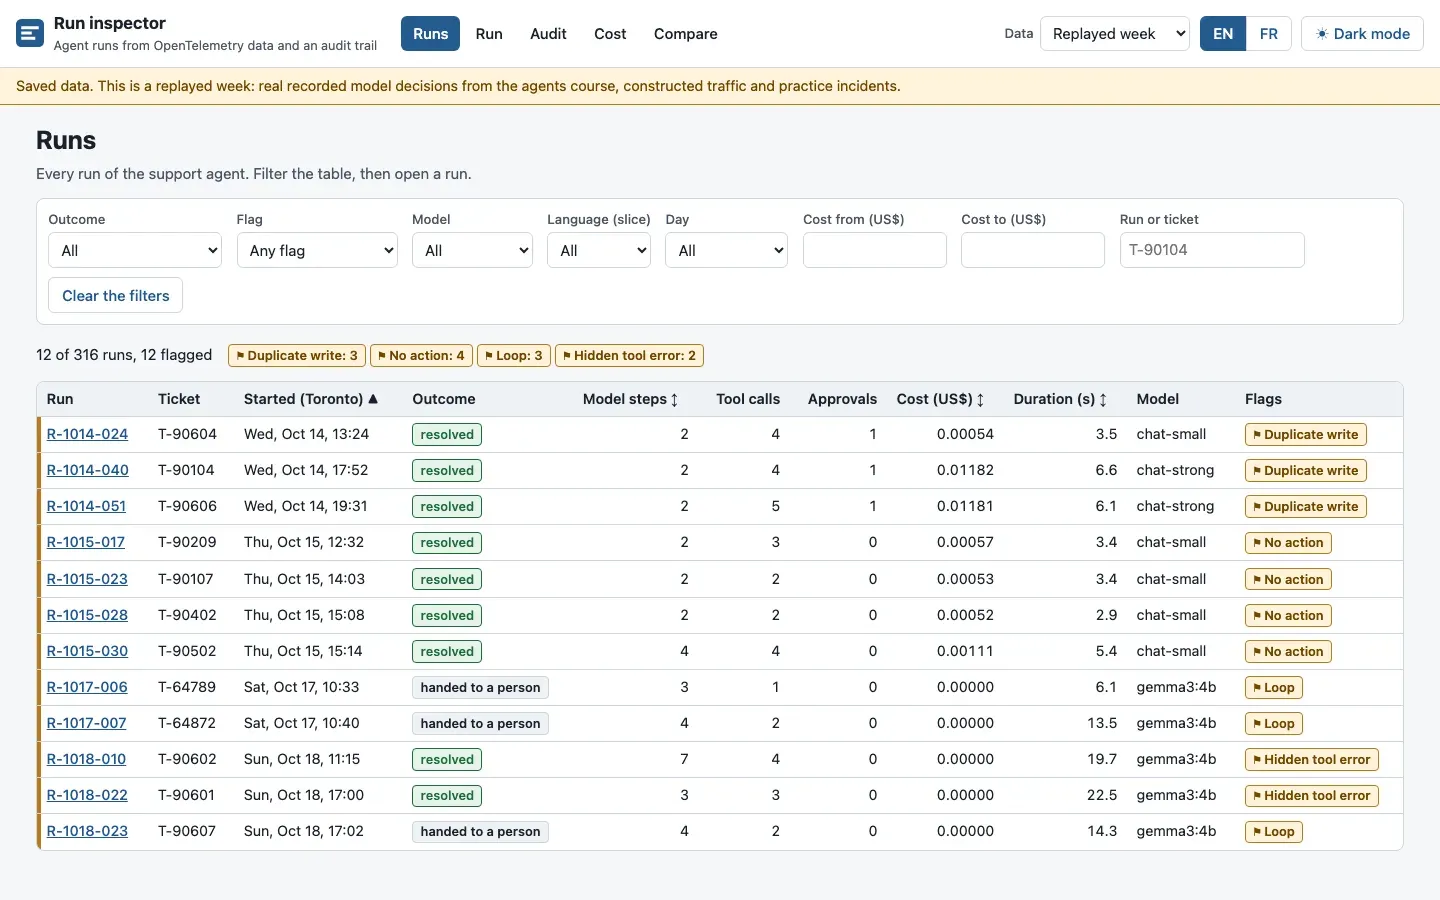
Ce sont les mêmes 12 exécutions que python -m obs find all a trouvées au module 4. C’est obligatoire : le code des indicateurs de l’inspecteur est une copie du fichier obs/flags.py du projet, vérifiée par un test. Deux ne sont pas de vraies défaillances selon les faits du scénario : R-1014-024 (écriture en double) et R-1018-022 (erreur d’outil cachée). Vous retrouverez la première plus bas.
Run : pourquoi une exécution est signalée
Section intitulée « Run : pourquoi une exécution est signalée »Ouvrez R-1014-040 :
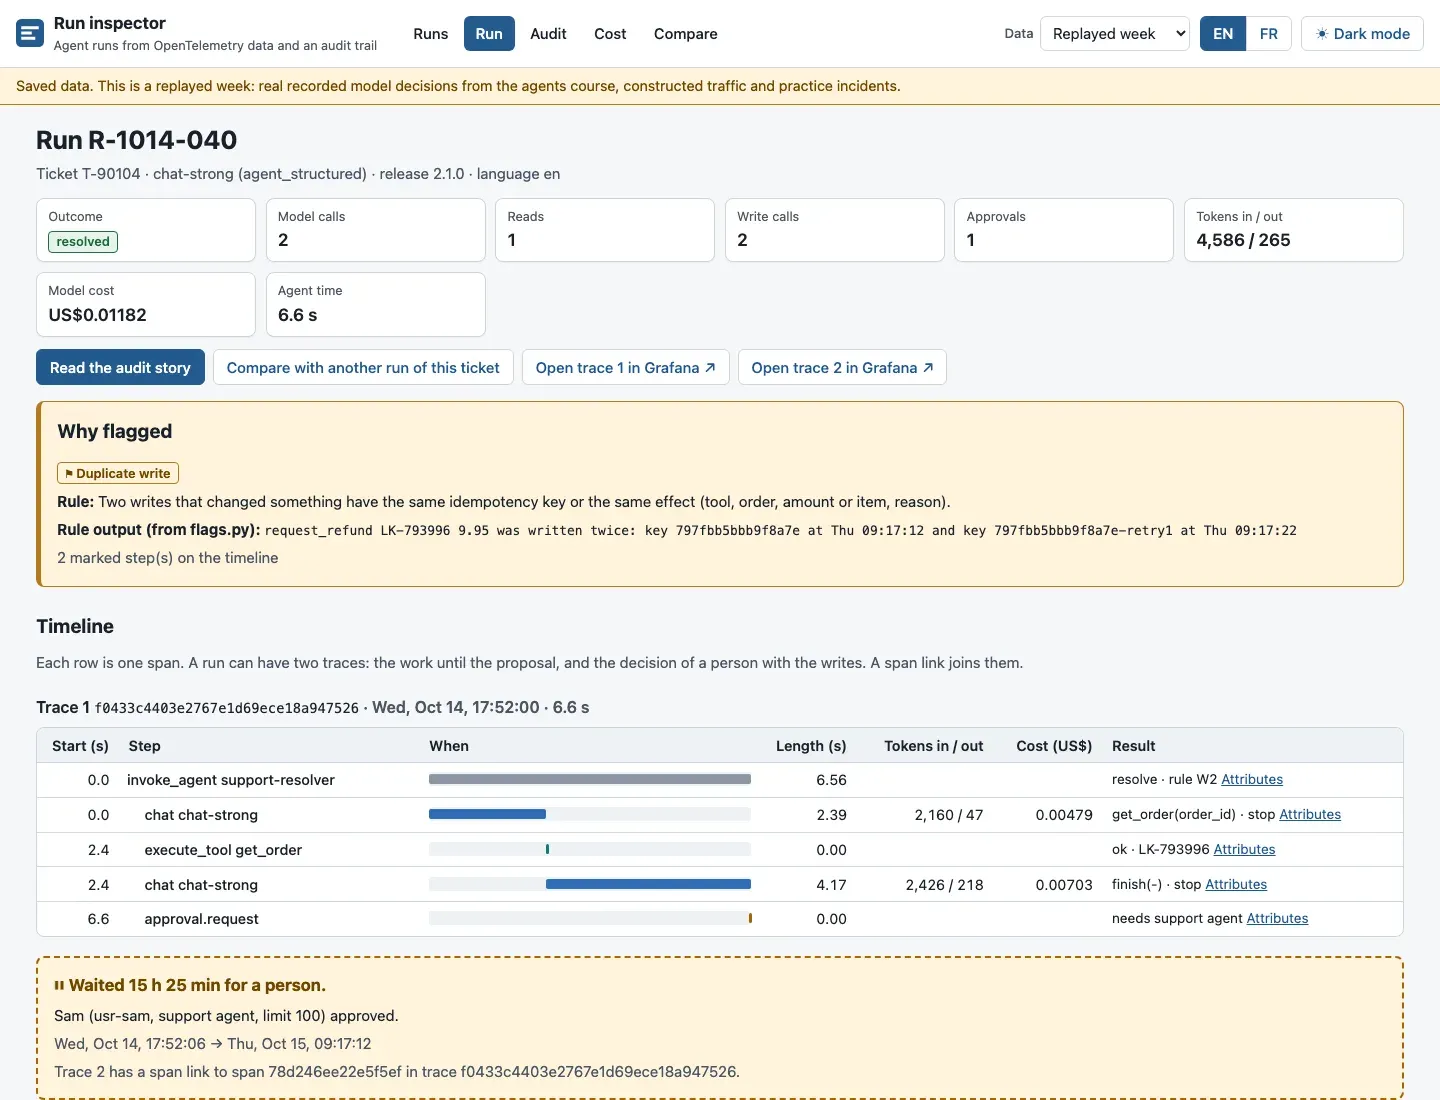
L’écran répond à la première partie de la question de Grace en une phrase. Le remboursement de 9,95 sur LK-793996 a été écrit deux fois, avec deux clés, à dix secondes d’intervalle. En dessous, la chronologie montre les deux traces. L’attente de Sam de 15 h 25 minutes apparaît comme un encadré, pas une barre. Les boutons ouvrent les mêmes traces dans Grafana, et dans Langfuse si vous définissez LANGFUSE_URL.
Audit : la lettre de congé
Section intitulée « Audit : la lettre de congé »Sélectionnez Read the audit story :
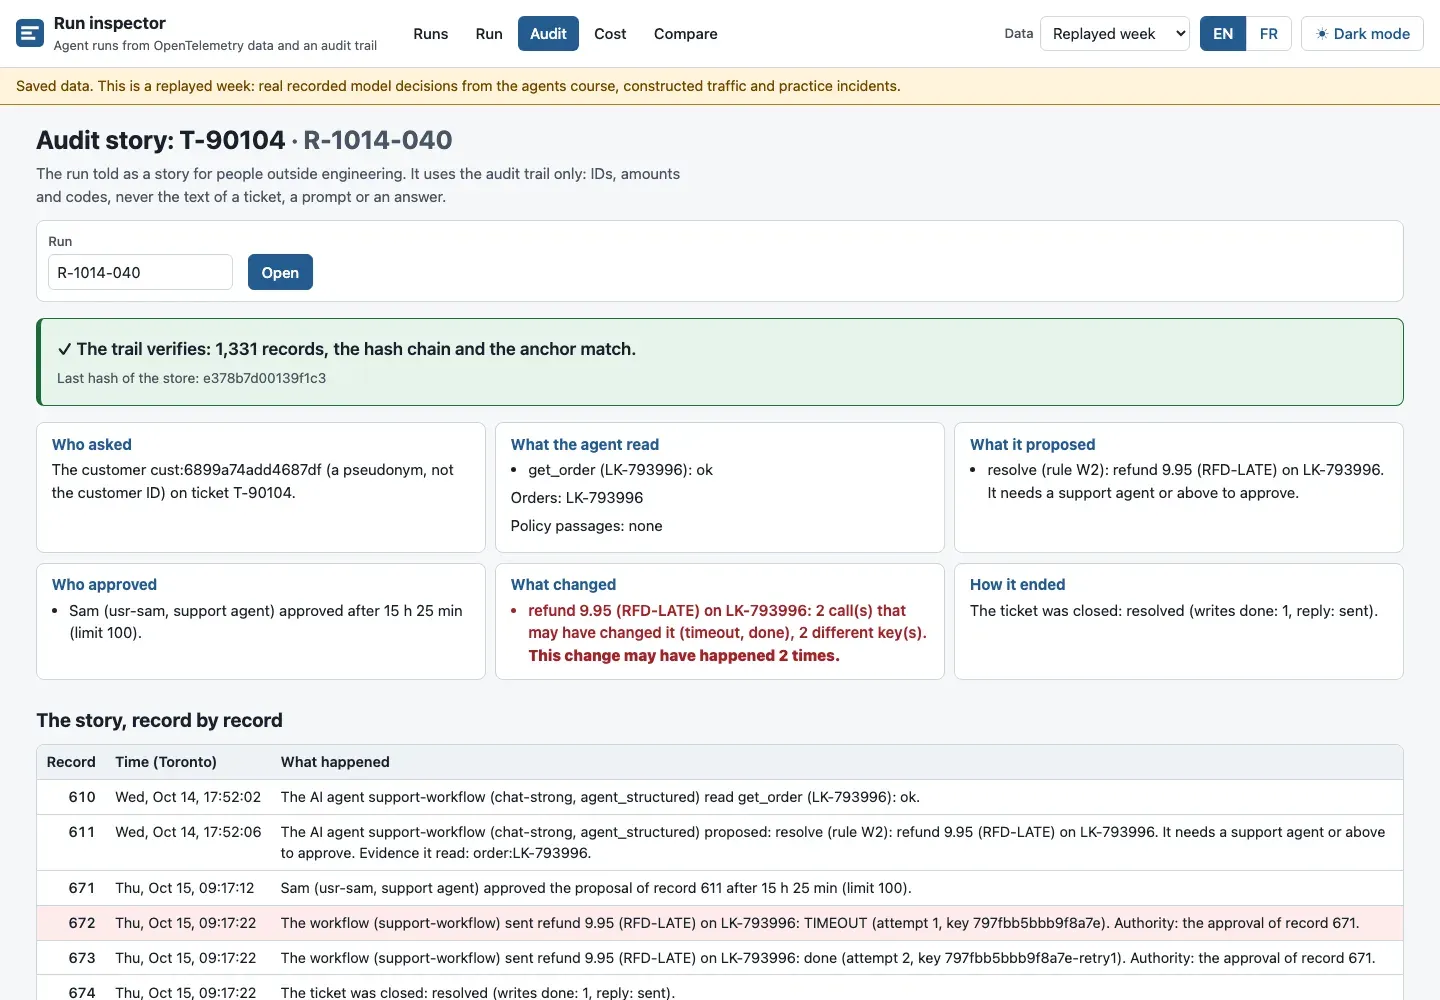
Cet écran s’adresse à Grace et à un auditeur. Il lit uniquement la piste d’audit, pas les traces. Il montre qui a demandé, ce que l’agent a lu et proposé, et qui a approuvé avec quel rôle et quelle limite. Il montre aussi ce qui a changé. Il commence par la vérification de la chaîne : 1 331 enregistrements, empreinte de tête e378b7d00139f1c3, comme obs audit verify. La carte rouge répond à la deuxième partie de la question de Grace. Sam a approuvé une fois, et le changement a peut-être eu lieu deux fois.
Cost : un chiffre qui mène à une décision
Section intitulée « Cost : un chiffre qui mène à une décision »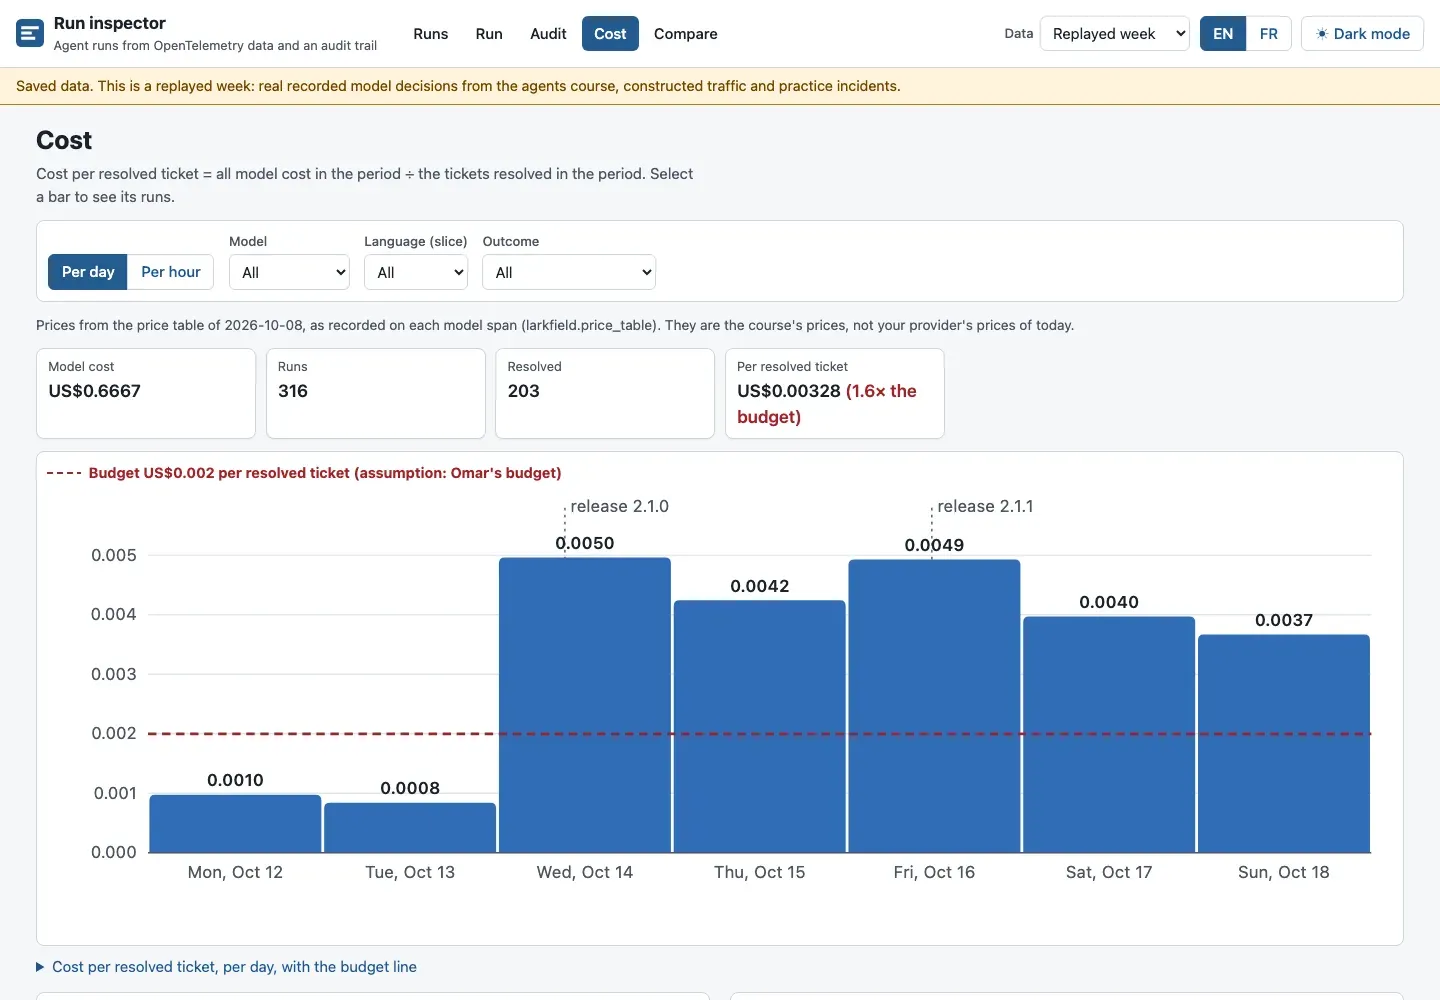
Le module 5 demandait : « Le passage à chat-strong a-t-il été rentable? » Cet écran donne la réponse dans les mots d’Omar : le coût par billet résolu, pas par appel, comparé à son budget. La mise en production du changement est indiquée mercredi. La semaine coûte 0,00328 $ US, soit 1,6 fois le budget. Sélectionnez la barre de mercredi. L’écran Runs s’ouvre sur les exécutions de mercredi. Les prix viennent de la table datée sur chaque span, et l’écran le précise.
Compare : où deux exécutions ont divergé
Section intitulée « Compare : où deux exécutions ont divergé »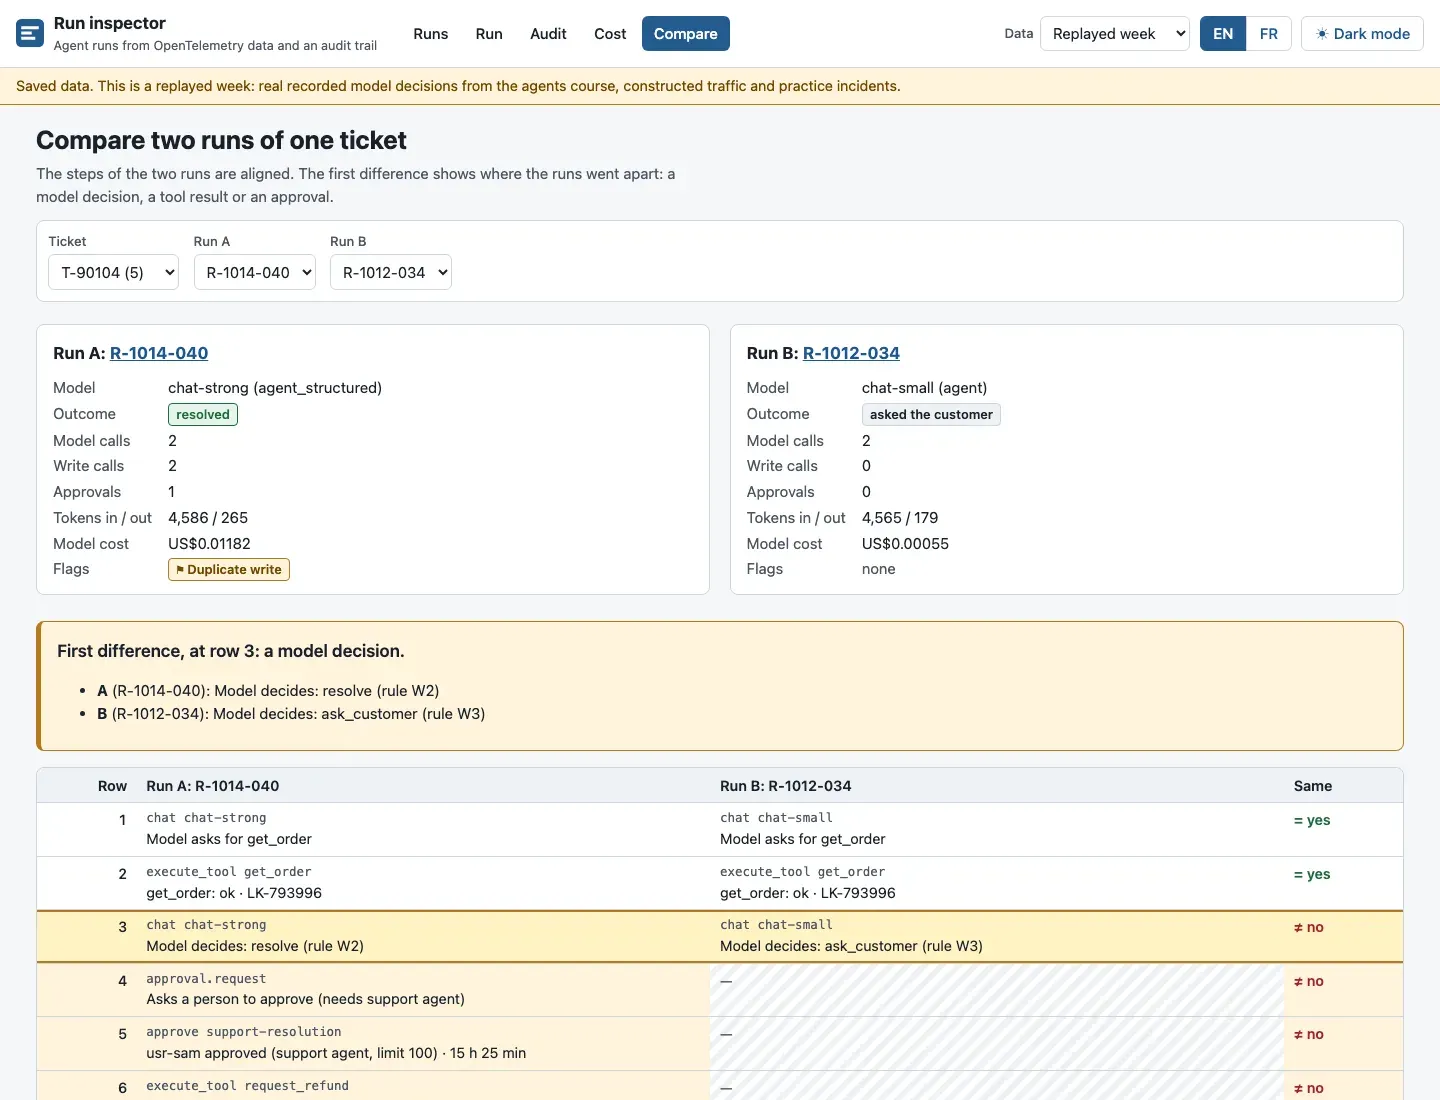
Le même billet a été exécuté cinq fois dans la semaine. Son équivalent avec chat-small, R-1012-034, a lu la même commande, puis posé une question au client. Le modèle fort a proposé le remboursement. Le double remboursement exigeait donc trois éléments ensemble. C’étaient la décision du modèle, l’approbation et la nouvelle tentative naïve. Compare trouve le premier dans un seul écran.
Comment un indicateur est calculé
Section intitulée « Comment un indicateur est calculé »Une vue qui dit « signalée » doit montrer pourquoi. Sinon, personne ne devrait lui faire confiance. Chaque indicateur correspond à une courte fonction dans obs/flags.py, copiée sans changement dans l’inspecteur. Voici la règle d’écriture en double, étape par étape, appliquée au double remboursement.
Un petit exemple détaillé
Section intitulée « Un petit exemple détaillé »La règle examine chaque span d’écriture d’une exécution. Elle pose deux questions pour chacun : a-t-il changé quelque chose? Une écriture précédente a-t-elle déjà fait le même changement? Exécutez les deux fonctions auxiliaires de la règle sur R-1014-040 dans le dossier de votre projet :
python -c "from obs.model import Telemetry; from obs.flags import _changed, _effect; r = Telemetry('data/telemetry/week').runs['R-1014-040']; [print(s.get('larkfield.idempotency_key'), s.get('larkfield.write.outcome'), _changed(r, s), _effect(s)) for s in r.writes]"797fbb5bbb9f8a7e timeout True ('request_refund', 'LK-793996', 9.95, None, None, 'RFD-LATE')797fbb5bbb9f8a7e-retry1 done True ('request_refund', 'LK-793996', 9.95, None, None, 'RFD-LATE')Lisez les deux lignes :
- La première écriture a dépassé le délai. A-t-elle changé quelque chose? Un span reconcile (vérification auprès du service de paiement) le dirait. Cette exécution n’en a aucun, car la nouvelle tentative naïve saute cette étape. La règle ne peut donc pas savoir. Elle répond
True(vrai) et compte l’écriture, par prudence. - La deuxième écriture est terminée, donc elle a changé quelque chose :
True. - L’effet comprend l’outil, la commande, le montant ou l’article, et le motif. Les deux lignes ont le même effet :
request_refund,LK-793996,9.95,RFD-LATE. - Les clés diffèrent, mais les effets sont identiques. La règle signale donc l’exécution et renvoie la phrase que vous avez vue sur l’écran Run.

Description textuelle du diagramme
La règle fait une seule supposition, dans l’encadré pointillé. Une écriture ayant dépassé le délai peut avoir eu lieu ou non, et la trace ne permet pas de savoir. La règle la compte, car un double paiement manqué coûte plus cher qu’une fausse alerte. Toutes les autres étapes lisent les attributs des spans : le résultat de l’écriture, sa clé et son effet.
Le faux positif de l’indicateur
Section intitulée « Le faux positif de l’indicateur »Exécutez maintenant la même ligne sur R-1014-024. Selon les faits du scénario, cette exécution ne compte pas comme une écriture en double :
python -c "from obs.model import Telemetry; from obs.flags import _changed, _effect; r = Telemetry('data/telemetry/week').runs['R-1014-024']; [print(s.get('larkfield.idempotency_key'), s.get('larkfield.write.outcome'), _changed(r, s), _effect(s)) for s in r.writes]"2ed3b2a93ab0f494 timeout True ('create_return_label', 'LK-645334', None, 'LADDER-3', None, 'change_of_mind')2ed3b2a93ab0f494-retry1 done True ('create_return_label', 'LK-645334', None, 'LADDER-3', None, 'change_of_mind')La trace ressemble au double remboursement : un dépassement de délai, puis le même effet avec une nouvelle clé. Mais ici, le service d’étiquettes a dépassé le délai avant de créer l’étiquette. La nouvelle tentative a donc créé la seule étiquette. La règle a supposé « changé » et s’est trompée.
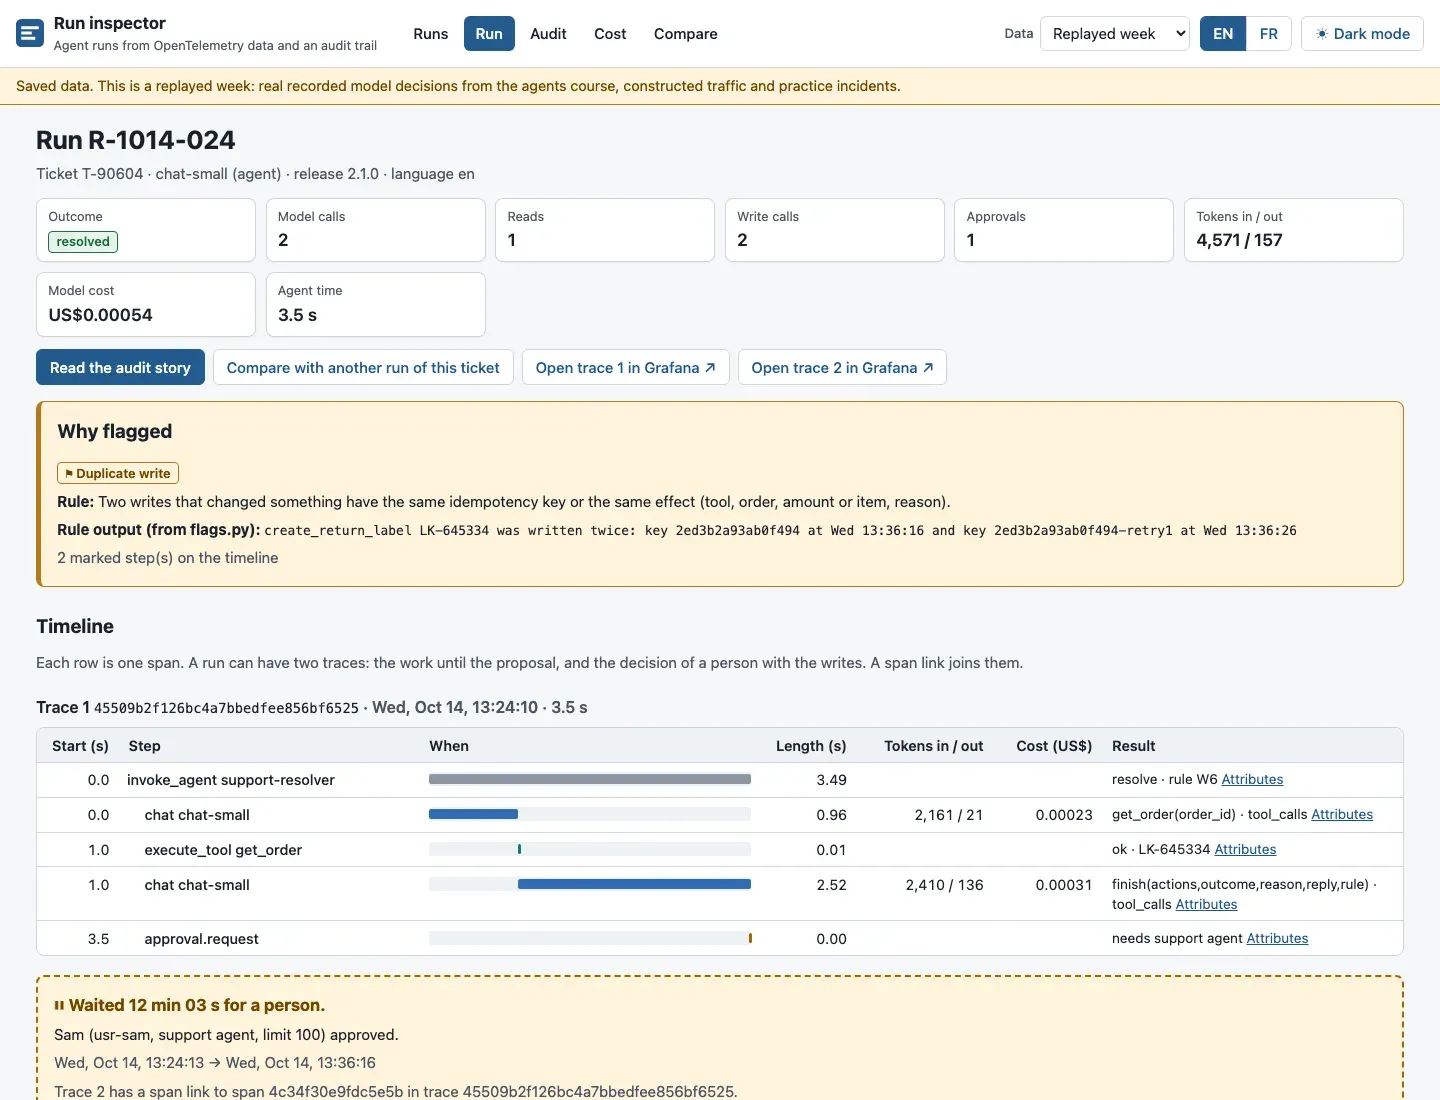
L’indicateur invite donc à examiner, sans rendre de verdict. Une trace ne peut pas dire si une écriture ayant dépassé le délai a eu lieu. La piste d’audit non plus : elle enregistre l’appel et son dépassement de délai. Seul le système de référence, le service qui a fait le changement, le sait. C’est pourquoi le récit d’audit dit « a peut-être eu lieu 2 fois ». C’est aussi pourquoi la nouvelle tentative sûre du module 3 interroge le service de paiement avant d’écrire à nouveau. C’est la leçon de Les modèles de défaillance des agents, vue depuis cet écran.
Sur la semaine, l’indicateur d’écriture en double a signalé 3 exécutions, dont 2 étaient de vrais cas. Sur la semaine sans incidents, python -m obs find all --data data/telemetry/healthy-week donne 0 match(es) in 316 run(s) (0 correspondance sur 316 exécutions). L’inspecteur affiche le même résultat pour le jeu de données Healthy week (semaine sans incidents).
De quelles vues votre équipe a-t-elle besoin?
Section intitulée « De quelles vues votre équipe a-t-elle besoin? »Chaque vue répond plus vite à certaines questions. Associez les questions de votre équipe aux vues avant de construire quoi que ce soit :

Description textuelle du diagramme
Grafana répond aux questions sur le système : y a-t-il un problème maintenant, et où? Langfuse répond aux questions sur le modèle : ce que chaque appel a fait et les scores attribués lors des révisions. L’inspecteur répond aux questions des personnes hors de l’équipe d’ingénierie. Il permet aussi les comparaisons pour lesquelles aucun outil général n’offre d’écran. Certaines questions ont deux bonnes réponses. Une question sans réponse rapide justifie la création d’une vue.
Quand une vue conçue pour les agents en vaut la peine, et ce qu’elle coûte
Section intitulée « Quand une vue conçue pour les agents en vaut la peine, et ce qu’elle coûte »Créez-en une quand des personnes qui ne peuvent pas utiliser les outils généraux posent la même question chaque semaine. C’est le cas des questions d’audit de Grace. N’en créez pas pour une question à laquelle un tableau de bord ou une requête enregistrée répond. Et n’y ajoutez jamais une fonction qu’un outil général offre déjà bien, comme les alertes.
Le coût, c’est la responsabilité de l’entretien. L’inspecteur est petit : la bibliothèque standard de Python et des pages Web préconstruites. Mais il lit les noms GenAI, qui sont encore en développement. Quand le cours fixe une nouvelle version des conventions, l’inspecteur doit s’adapter. Son code de signalement est une copie. Un test compare donc cette copie au projet : deux endroits appliquant la même règle ne doivent jamais se contredire. Quelqu’un chez Larkfield doit en être responsable, comme Kwame est responsable de la table des prix.
Erreur courante
L'inspecteur ne démarre pas : le port est utilisé
Symptôme : python -m larkfield_inspector s’arrête immédiatement avec ce message :
Cannot listen on 127.0.0.1:8318 (Address already in use). Another program uses the port? Try --port 8319, or set INSPECTOR_PORT.Cause : un autre programme écoute sur le port 8318. C’est souvent un deuxième inspecteur, démarré dans un autre terminal puis oublié.
Diagnostic : trouvez l’autre terminal et cherchez la ligne Run inspector 1.0.0 on http://127.0.0.1:8318/ (inspecteur d’exécutions 1.0.0 à cette adresse). Sur macOS et Linux, lsof -i :8318 indique le programme. Sur Windows, Get-NetTCPConnection -LocalPort 8318 affiche son identifiant de processus.
Rétablissement : arrêtez l’autre inspecteur avec Ctrl+C dans son terminal. Ou démarrez celui-ci sur un autre port : python -m larkfield_inspector --port 8319, puis ouvrez http://127.0.0.1:8319/.
À vous de jouer : une question, trois vues
Section intitulée « À vous de jouer : une question, trois vues »Prenez la question de Grace : « Avons-nous payé deux fois le client du billet T-90104, et qui a approuvé? »
- Grafana. Si vous avez chargé la semaine dans Grafana, utilisez la requête d’écritures en double de Chercher des exécutions avec TraceQL. Ouvrez la trace et trouvez la personne qui a approuvé. Sans Docker, utilisez
python -m obs find duplicate_write --data data/telemetry/weeketpython -m obs trace R-1014-040 --data data/telemetry/week. - Langfuse. Si vous avez envoyé la semaine, ouvrez la session
R-1014-040. Sans compte, lisez la réponse enregistrée dans Envoyer les mêmes traces à Langfuse. - L’inspecteur. Ouvrez l’écran Runs (exécutions), puis l’écran Audit (audit) de R-1014-040.
- Pour chaque vue, notez le nombre d’étapes nécessaires et la partie de la question à laquelle elle ne pouvait pas répondre.
- Écrivez trois phrases : quelle vue a répondu le plus vite, pourquoi, et quelle vue vous enverriez à Grace.
Il n’y a pas une seule bonne réponse. La troisième vérification des connaissances présente une comparaison détaillée.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
L'écran Run (exécution) signale R-1014-024 comme une écriture en double, mais la vérité du scénario indique une seule étiquette créée. La règle est-elle incorrecte? Qu'est-ce qui tranche, et pourquoi la règle fait-elle cette supposition?
Afficher la réponse
La règle a fait ce qu’elle annonce : deux écritures avec le même effet, dont la première a expiré sans vérification de concordance. Une trace ne peut pas dire si une écriture ayant expiré a eu lieu. La piste d’audit ne le peut pas non plus : les deux enregistrent l’appel et son expiration. Seul le système faisant autorité le sait, ici le service d’étiquettes. Ses propres enregistrements ou une vérification de concordance qui l’interroge permettent de le savoir. La règle compte une écriture au résultat inconnu comme un changement. Un paiement en double non détecté coûte plus cher qu’une fausse alerte. Le signalement signifie donc « regardez ici ». Une personne vérifie le système faisant autorité avant d’agir. Pour la semaine : 3 signalements, 2 cas réels.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Tomás dit : « L'inspecteur fait la même chose que Grafana. Ajoutons-y des alertes et des évaluations, puis on pourra abandonner Grafana et Langfuse. » Que répondez-vous?
Afficher la réponse
Non. L’inspecteur est utile parce qu’il est petit et répond à quelques questions pour quelques lecteurs. Il présente le récit d’audit, le coût par billet résolu, la comparaison d’exécutions et les signalements. Les alertes nécessitent un moteur de règles qui fonctionne en permanence, avise les personnes et conserve un historique. Grafana le fait bien. Les évaluations nécessitent des scores, des juges, des jeux de données et des files de révision : Langfuse offre cela. Chaque fonction ajoutée à l’inspecteur est du code dont Larkfield doit être responsable. Larkfield doit aussi l’adapter à chaque nouvelle version des conventions GenAI. Gardez les outils généraux pour les questions générales, et la vue pour celles auxquelles ils répondent lentement.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
À vous de jouer : quelle vue a répondu le plus vite à la question de Grace, et pourquoi?
Afficher la réponse
Voici une comparaison détaillée. Grafana : une requête TraceQL, puis la trace 2 pour les deux appels de remboursement. Ensuite, le lien du span (segment de trace) vers la trace 1 pour la proposition : environ quatre étapes. Cela exige TraceQL et ne dit rien sur l’intégrité de la piste d’audit. Langfuse : la session R-1014-040 montre les deux traces et les deux observations de remboursement : environ deux étapes. Mais la personne qui a approuvé est dans les métadonnées, et aucune vérification de la chaîne n’est offerte. L’inspecteur : l’écran Runs avec le filtre de signalements, puis l’écran Audit : deux étapes. Il répond en mots simples : Sam a approuvé une fois, le remboursement a peut-être eu lieu deux fois. Et il vérifie d’abord la piste. Envoyez à Grace le récit d’audit de l’inspecteur, ou son exportation Markdown. Pour la prochaine question d’Amira, « pourquoi le modèle l’a-t-il proposé? », Grafana ou Langfuse convient mieux.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une vue conçue pour les agents lit les mêmes données OpenTelemetry et la même piste d’audit que les outils généraux. Elle répond à quelques questions pour un type de lecteur.
- Les cinq écrans de l’inspecteur d’exécutions : Runs, Run (motif du signalement), Audit (le récit, avec vérification de la chaîne d’abord), Cost (coût par billet résolu, comparé au budget) et Compare (première différence). Cost signifie « coût » et Compare signifie « comparaison ».
- Chaque signalement repose sur une règle courte qui explique pourquoi. La règle d’écritures en double compte une écriture ayant expiré comme un changement. Elle produit donc un faux positif connu, et seul le système faisant autorité tranche.
- Associez les questions de votre équipe aux vues. Créez une vue seulement pour une question fréquente à laquelle tous les outils généraux répondent lentement. Désignez une personne responsable.
- Dans ce cours, vous avez enregistré une seule fois avec OpenTelemetry. Vous avez envoyé les mêmes données à trois destinations : Grafana, Langfuse et le stockage d’audit. N’importe quelle vue peut les lire.
Vous avez maintenant construit, lu et comparé toute l’observabilité d’un flux de travail d’agent. Mais c’était toujours notre propre flux de travail, avec nos propres noms. Ensuite, dans les études de cas, vous prenez des exécutions d’agents publiques enregistrées par quelqu’un d’autre. Vous les convertissez en OpenTelemetry et trouvez leurs défaillances.
Leçon suivante : Trouver des défaillances dans des exécutions d'agents publiques