
Chercher des exécutions avec TraceQL
- Leçon 13
- 40 min
- Module 4 : Trouver les défaillances des agents dans Grafana
Où nous en sommes
Dans la dernière leçon, nous avons lu la vue en cascade d'une exécution. Nous avons trouvé l'étape lente, l'étape coûteuse et celle qui a envoyé le deuxième remboursement. Mais la semaine enregistrée compte 316 exécutions dans 434 traces. Nous ne pouvons pas les ouvrir une à une. Dans cette leçon, nous cherchons des exécutions par leur structure : plusieurs appels au même outil, une écriture sans approbation préalable, une erreur suivie d'une résolution. Nous commençons par le champ de recherche d'une boîte de courriel.
Leçon 13 sur 28 · Observabilité des agents d'IA : traces, coûts et pistes d'auditChercher des exécutions avec TraceQL
1. Pourquoi les agents ont besoin de leur propre observabilité
2. OpenTelemetry pour les agents
3. Instrumenter le flux de travail
4. Trouver les défaillances des agents dans Grafana
5. Le coût
6. Pistes d'audit
7. Alertes, niveaux de service et qualité
8. Outils : Langfuse, les autres et l'inspecteur d'exécutions
Ce que vous saurez faire
Trouvez les exécutions importantes d’une semaine entière selon la structure de leurs spans (intervalles de trace). Utilisez TraceQL dans Grafana et obs find sur la télémétrie enregistrée. Lisez le résultat de chaque requête et vérifiez ce qu’elle peut manquer.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Comment lire une vue en cascade : lignes, parents, erreurs, nouvelles tentatives et intervalles, dans Lire une exécution.
- Les spans d’outils, d’écriture et d’approbation et leurs attributs (
gen_ai.tool.name,larkfield.tool.kind,larkfield.write.outcome), dans Appels d’outils, erreurs et nouvelles tentatives. - L’échantillonnage en fin de trace dans le Collector, dans Le Collector.
Ce qu’il vous faut sur votre ordinateur
- Le projet
~/projects/observable-workflowdans l’état laissé par la dernière leçon (l’instantanéend-of-m03, 86 tests réussis), et le dépôt des exercices dans~/projects/nextia-learning-labs. - Facultatif : Grafana avec la semaine rejouée envoyée, comme dans Lire une exécution. Toutes les étapes fonctionnent sans lui.
Testé sur macOS (Apple silicon) avec Python 3.12.13. Les commandes Windows (PowerShell) et Linux sont fournies, mais l’équipe du cours ne les a pas exécutées. L’équipe du cours a exécuté les requêtes TraceQL dans grafana/otel-lgtm 0.36.0.
Une recherche dans la boîte de courriel
Section intitulée « Une recherche dans la boîte de courriel »Votre boîte de courriel au travail contient 2 000 courriels. Grace demande : « Quels clients nous ont envoyé une photo la semaine dernière, sans recevoir de réponse? » Vous n’ouvrez pas 2 000 courriels. Vous saisissez une recherche : de clients, avec une pièce jointe, dans la dernière semaine, sans réponse. Chaque condition concerne une partie d’un courriel. Le résultat est une courte liste de courriels entiers. Vous ouvrez seulement ceux-là.
Une telle recherche comporte trois éléments. Des conditions sur les parties de chaque élément. Une façon de les combiner (« et », « sans »). Et un résultat qui liste les éléments, pas leurs parties.
Le problème : 316 exécutions, et une question sur leur structure
Section intitulée « Le problème : 316 exécutions, et une question sur leur structure »Voici la question de Grace pour l’agent : « Quelles exécutions ont eu une erreur, mais ont quand même été fermées comme résolues? » La liste des exécutions ne peut pas y répondre. obs runs affiche une ligne par exécution : le résultat, les nombres et le coût. Il affiche resolved (résolu) pour 203 exécutions. Il n’affiche aucune erreur, car les erreurs sont dans les spans.
Vous pourriez ouvrir chaque vue en cascade. À une minute par exécution, 316 exécutions prennent plus de cinq heures. Vous feriez aussi des erreurs dès la quarantième exécution. Pire, la question porte sur la structure d’une exécution : un span avec une erreur et un autre avec le résultat resolved. Un total ou une liste ne contient jamais la structure.
L’idée : des conditions sur les spans, un résultat composé de traces
Section intitulée « L’idée : des conditions sur les spans, un résultat composé de traces »TraceQL, le langage de requête de traces, est le langage de recherche de Tempo, le stockage de traces dans Grafana. Il fonctionne comme la recherche dans la boîte de courriel. Une requête pose des conditions sur les spans. Son résultat est une liste de traces contenant des spans qui correspondent.
Voici les éléments nécessaires :
- Un filtre sur un ensemble de spans, entre accolades :
{ span.gen_ai.tool.name = "get_order" }sélectionne les spans dont l’attributgen_ai.tool.namevautget_order.span.désigne un attribut du span. Quelques champs n’ont pas de préfixe :name(nom),status(état :ok, réussi, ouerror, erreur),duration(durée) etrootName(nom du span racine de la trace). - Des comparaisons :
=,!=,>et<, et=~pour un motif :=~ "done|timeout"signifie « terminé ou délai dépassé ».!~signifie « ne correspond pas ». &&dans les accolades signifie « le même span satisfait les deux conditions ».{ A } && { B }signifie « la trace contient un span pour A et un span pour B » : peut-être deux spans différents.- Un pipeline, après
|:| count() > 1conserve les traces contenant plus d’un span correspondant.
Retenez surtout ceci : TraceQL trouve des traces, pas des exécutions. Une exécution qui a attendu une personne possède deux traces. Une requête sur les écritures trouve la trace 2. Vous suivez ensuite son lien vers la trace 1 vous-même.
La fiche de requêtes du cours, grafana/traceql.md, contient une requête par question. obs find pose les mêmes questions à la télémétrie enregistrée, sans Grafana.
Exemple détaillé : construire la requête d’écriture en double
Section intitulée « Exemple détaillé : construire la requête d’écriture en double »Construisez une requête de la fiche par étapes et observez le résultat de chacune. La question : « Quelles traces contiennent plus d’un appel de remboursement qui a peut-être versé de l’argent? » Les nombres viennent de la semaine enregistrée. Le script du cours a appliqué les conditions de chaque étape aux 434 traces.

Description textuelle du diagramme
La semaine enregistrée contient 434 traces et 2 027 spans. L’étape 1 conserve les spans dont l’outil est request_refund : 45 spans dans 39 traces. L’étape 2 ajoute une deuxième condition sur le même span, un résultat done ou timeout : 41 spans dans 39 traces. Ce sont les appels de remboursement qui ont peut-être versé de l’argent. L’étape 3 compte ces spans dans chaque trace et conserve les traces qui en contiennent plus d’un. Il reste 2 traces : la trace 2 de R-1014-040 et la trace 2 de R-1014-051. L’étape 4 les ouvre : chacune contient deux remboursements de 9,95, le deuxième avec une nouvelle clé.
Lisez chaque étape :
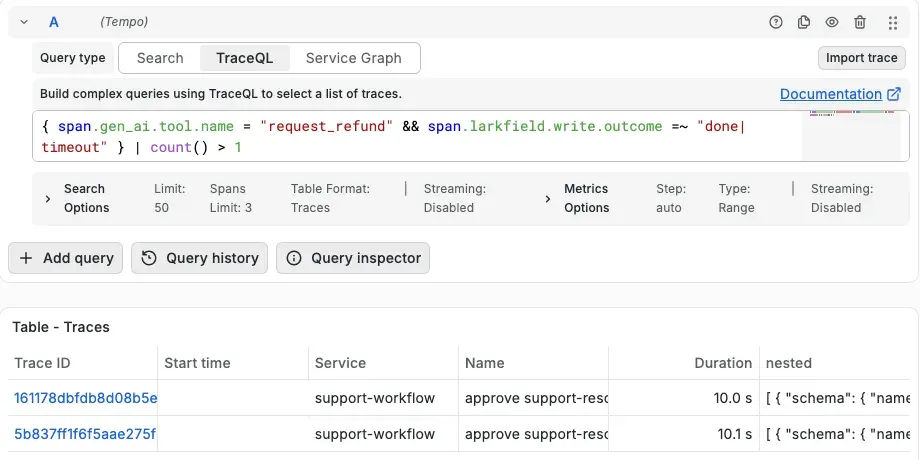
{ span.gen_ai.tool.name = "request_refund" }conserve tous les appels de remboursement : 45 spans dans 39 traces. Certaines traces contiennent plusieurs spans : un appel refusé et une nouvelle tentative, par exemple.{ span.gen_ai.tool.name = "request_refund" && span.larkfield.write.outcome =~ "done|timeout" }élimine les appels qui n’ont assurément rien changé, commeunavailable(indisponible, refusé immédiatement). Il reste 41 spans dans 39 traces. Untimeout(délai dépassé) reste, car l’appel a peut-être versé de l’argent.… | count() > 1conserve les traces contenant plus d’un tel span : 2 traces, les deuxièmes traces de R-1014-040 et de R-1014-051.
Pourquoi l’étape 3? Parce que 39 traces ont effectué un remboursement, et c’est du travail normal. La défaillance n’est pas « un remboursement ». C’est deux remboursements dans une trace : une structure. Seul le décompte transforme les deux premières étapes en recherche de cette structure.
L’étape 4 est à vous : ouvrez les deux traces. Chacune contient un remboursement de 9,95 dont le délai a expiré, puis un deuxième remboursement avec une nouvelle clé. Ce sont les deux remboursements en double de la semaine. Dans Grafana, l’équipe du cours a exécuté cette requête et obtenu les mêmes 2 traces.
Ajouter les fichiers de la leçon
Section intitulée « Ajouter les fichiers de la leçon »L’instantané end-of-m04 ajoute obs find et les cinq règles de défaillance (obs/flags.py, pour la prochaine leçon). Il ajoute aussi la fiche TraceQL et un tableau de bord Grafana avec un panneau par requête.
-
Copiez les fichiers. Dans
~/projects/observable-workflow:Fenêtre de terminal S=../nextia-learning-labs/C31/snapshots/end-of-m04cp $S/obs/flags.py $S/obs/model.py $S/obs/__main__.py obs/cp $S/grafana/traceql.md grafana/cp $S/grafana/dashboards/agent-traces.json grafana/dashboards/cp $S/tests/test_obs_cli.py tests/Fenêtre de terminal $S = "..\nextia-learning-labs\C31\snapshots\end-of-m04"Copy-Item $S\obs\flags.py, $S\obs\model.py, $S\obs\__main__.py obs\Copy-Item $S\grafana\traceql.md grafana\Copy-Item $S\grafana\dashboards\agent-traces.json grafana\dashboards\Copy-Item $S\tests\test_obs_cli.py tests\Fenêtre de terminal S=../nextia-learning-labs/C31/snapshots/end-of-m04cp $S/obs/flags.py $S/obs/model.py $S/obs/__main__.py obs/cp $S/grafana/traceql.md grafana/cp $S/grafana/dashboards/agent-traces.json grafana/dashboards/cp $S/tests/test_obs_cli.py tests/ -
Exécutez les tests :
Fenêtre de terminal python -m pytest -qLa dernière ligne indique
87 passed, 1 skipped, 1 deselected(87 réussis, 1 ignoré, 1 désélectionné). Le nouveau test exécuteobs findsur la semaine enregistrée.
Trois recherches par structure
Section intitulée « Trois recherches par structure »Chaque recherche ci-dessous comporte trois parties. D’abord, la requête TraceQL de la fiche, puis la même question avec obs find sur la semaine enregistrée. Enfin, ce que vous voyez en ouvrant les résultats.
Plus de N appels au même outil
Section intitulée « Plus de N appels au même outil »Un agent qui appelle sans cesse le même outil est peut-être bloqué. La requête de la fiche :
{ span.gen_ai.tool.name = "get_order" } | count() > 2Dans Tempo, elle a retourné 0 trace. obs find confirme :
python -m obs find --data data/telemetry/week --tool get_order --min-calls 30 match(es) in 316 run(s)Zéro est un résultat, mais le seuil est-il approprié? Abaissez-le à 2 :
python -m obs find --data data/telemetry/week --tool get_order --min-calls 2R-1012-004 T-90601 Mon 05:42 chat-small get_order called 2 timesR-1012-031 T-90201 Mon 15:07 chat-small get_order called 2 times…R-1017-026 T-90601 Sat 18:17 chat-strong get_order called 2 times13 match(es) in 316 run(s)Maintenant, 13 exécutions correspondent. Ouvrez la première :
python -m obs trace R-1012-004 --data data/telemetry/weekTrace 1 98cb994f5d69bd8964562841548f2855 Mon 12 Oct 05:42:07 13.2 s 0.0 s |========================| 13.17 s invoke_agent support-resolver reply_only rule W1 0.0 s |== | 0.92 s chat chat-small 2159 in / 21 out US$0.00023 tool_calls 0.9 s | =================== | 10.00 s execute_tool get_order ERROR service_timeout LK-645001 10.9 s | === | 0.89 s chat chat-small 2222 in / 21 out US$0.00023 tool_calls 11.8 s | = | 0.00 s execute_tool get_order ok LK-645001 11.8 s | ===| 1.35 s chat chat-small 2463 in / 77 out US$0.00028 tool_calls 13.2 s | =| 0.00 s execute_tool send_reply sent
Outcome: resolvedDeux appels, et le délai du premier a expiré. Le modèle a redemandé, le deuxième appel a fonctionné, puis le modèle a répondu. C’est une bonne récupération, pas une boucle. Le nombre N est donc un choix que vous faites à partir des données. Cette semaine, aucune exécution n’a appelé get_order trois fois. Toutes les exécutions à deux appels que vous ouvrez ressemblent à celle-ci. Ici, une boucle se manifeste autrement : les limites de boucle du cours sur les agents arrêtent l’exécution. La requête sur les boucles de la prochaine leçon cherche cet arrêt.
Une écriture sans approbation préalable
Section intitulée « Une écriture sans approbation préalable »La règle de Larkfield : aucun remboursement, aucune étiquette ni réexpédition sans la décision d’une personne. La requête de la fiche :
{ rootName !~ "approve.*" && span.larkfield.tool.kind = "write" && span.gen_ai.tool.name != "send_reply" }Elle cherche un span d’écriture (pas la réponse) dans une trace dont le span racine n’est pas une décision humaine. Dans Tempo, 0 trace. obs find confirme :
python -m obs find --data data/telemetry/week --write-without-approval0 match(es) in 316 run(s)Est-ce une bonne nouvelle, ou une requête qui ne peut rien trouver? Vérifiez. Retirez la condition rootName, et le script du cours trouve 118 traces avec une écriture dans la semaine enregistrée. Toutes ont la racine approve support-resolution (approuver la résolution du billet de soutien). La requête peut donc voir les écritures, et chaque écriture a suivi une décision. Dans ce flux de travail, une écriture ne peut survenir que dans la trace 2, qui commence par la décision humaine. C’est la conception du module 3. La requête vérifie qu’elle est respectée.
Une erreur suivie d’une résolution
Section intitulée « Une erreur suivie d’une résolution »Maintenant, la question de Grace. La requête de la fiche :
{ span.larkfield.tool.kind = "read" && status = error } && { span.larkfield.outcome = "resolved" }Deux ensembles de spans : une lecture qui a échoué et un span avec le résultat resolved, dans la même trace. Dans Tempo, 8 traces. obs find :
python -m obs find --data data/telemetry/week --error-then-resolvedR-1012-004 T-90601 Mon 05:42 chat-small a tool error, then resolvedR-1013-038 T-90601 Tue 15:57 chat-small a tool error, then resolvedR-1014-021 T-90601 Wed 12:41 chat-strong a tool error, then resolvedR-1016-040 T-80009 Fri 14:59 chat-strong a tool error, then resolvedR-1016-044 T-80009 Fri 15:35 chat-strong a tool error, then resolvedR-1017-026 T-90601 Sat 18:17 chat-strong a tool error, then resolvedR-1018-010 T-90602 Sun 11:15 gemma3:4b a tool error, then resolvedR-1018-022 T-90601 Sun 17:00 gemma3:4b a tool error, then resolved8 match(es) in 316 run(s)Comme la requête, obs find examine seulement les lectures qui ont échoué. Une écriture qui a échoué relève d’une autre question : l’écriture en double de la prochaine leçon.
Huit exécutions. Sont-elles huit défaillances? Ouvrez R-1014-021 :
python -m obs trace R-1014-021 --data data/telemetry/weekTrace 1 3492400f6a05ceaeac2f8fcf3013de34 Wed 14 Oct 12:41:26 16.1 s 0.0 s |========================| 16.15 s invoke_agent support-resolver reply_only rule W1 0.0 s |=== | 1.86 s chat chat-strong 2156 in / 49 out US$0.00480 stop 1.9 s | ================ | 10.00 s execute_tool get_order ERROR service_timeout LK-645001 11.9 s | === | 1.90 s chat chat-strong 2248 in / 58 out US$0.00508 stop 13.8 s | = | 0.00 s execute_tool get_order ok LK-645001 13.8 s | ====| 2.37 s chat chat-strong 2527 in / 107 out US$0.00612 stop 16.1 s | =| 0.00 s execute_tool send_reply sent
Outcome: resolvedL’erreur a été corrigée : un appel ultérieur à get_order a fonctionné. Six des huit exécutions ressemblent à celle-ci. Dans deux, R-1018-010 et R-1018-022, aucun appel ultérieur à l’outil défaillant n’a fonctionné. Pourtant, l’exécution a répondu et s’est fermée comme résolue. Ces deux-là sont dangereuses.
La requête a donc trouvé le bon endroit, mais elle est trop large. Elle a aussi une limite à connaître : && entre deux ensembles de spans signifie « les deux sont dans la trace », pas « l’un suit l’autre ». Ici, cela fonctionne, car le résultat est défini à la fermeture de l’exécution, après tous les appels d’outils. La requête ne peut pas non plus dire « aucun appel ultérieur au même outil n’a réussi ». Il faut une règle qui lit les spans dans l’ordre. La prochaine leçon l’écrit.
TraceQL dans Grafana
Section intitulée « TraceQL dans Grafana »Si Grafana contient la semaine rejouée, exécutez-y les requêtes de la fiche :
- Ouvrez Grafana à
http://localhost:3031, puis Explore (explorer). Choisissez la source de données Tempo et le type de requête TraceQL. - Réglez la plage de temps pour couvrir la relecture. La semaine a pris environ 10 minutes de temps réel. Choisissez une plage commençant avant l’envoi, par exemple Last 3 hours (3 dernières heures).
- Copiez une requête de
grafana/traceql.mddans l’éditeur et exécutez-la. Le résultat est un tableau de traces : identifiant de trace, heure de début, service, nom racine et durée. - Cliquez sur un identifiant de trace pour ouvrir sa vue en cascade, comme dans la dernière leçon.
Le tableau de bord Support workflow : failure patterns in traces (flux de soutien : modèles de défaillance dans les traces), dans grafana/dashboards/agent-traces.json, exécute sept requêtes de la fiche pour vous. Chaque requête a son panneau de tableau.
Tempo cherche seulement dans ce qui a été conservé
Section intitulée « Tempo cherche seulement dans ce qui a été conservé »Le Collector du module 2 échantillonne les traces à la fin. Il conserve chaque trace avec une approbation, une écriture, une erreur ou une entrée injectée, et 10 % des autres. Lors de la vérification du Collector, l’équipe du cours a conservé 275 des 434 traces de la semaine. Une recherche ne peut trouver que les traces conservées. Comparez les deux réponses pour chaque requête de la fiche :
Description textuelle du graphique
Une barre par requête qui correspond à au moins une trace enregistrée. loop: Tempo 3 of 3 saved traces; hidden tool error: Tempo 8 of 8 saved traces; duplicate write: Tempo 2 of 2 saved traces; no action: Tempo 4 of 4 saved traces; injected input: Tempo 20 of 20 saved traces; slow model calls: Tempo 14 of 17 saved traces; expensive runs: Tempo 23 of 39 saved traces; a model's runs: Tempo 15 of 16 saved traces. Les cinq requêtes de défaillance sont à 100 % : boucle, erreur d’outil cachée, écriture en double, aucune action et entrée injectée. Le Collector conserve chaque trace avec une erreur, une écriture, une approbation ou une entrée injectée. Les trois qui ne sont pas des défaillances perdent des traces : appels de modèle lents, exécutions gemma3:4b et exécutions coûtant plus de 1 cent.
Chaque requête de défaillance a trouvé toutes ses traces, car les règles d’échantillonnage conservent exactement ces traces. Les autres n’y sont pas arrivées. Tempo a retourné 14 des 17 traces avec un appel de modèle lent, et seulement 23 des 39 exécutions de plus de 1 cent. Une exécution de plus de 1 cent sans approbation, écriture ou erreur est conservée seulement si l’échantillon de 10 % la sélectionne. Ainsi, « combien d’exécutions coûteuses? » n’a pas de réponse dans Tempo. Les décomptes relèvent des métriques, qui ne sont jamais échantillonnées. La dernière leçon de ce module les utilise.
Erreur courante
La requête retourne No rows (aucune ligne), sans erreur
Symptôme : vous collez une requête dans Explore, et le tableau indique No rows (aucune ligne). Vous attendiez des traces.
Cause : l’une de ces trois possibilités. La plage de temps ne couvre pas la relecture. Un nom d’attribut contient une faute : TraceQL ne dit pas « attribut inconnu », il ne trouve simplement rien. Ou l’échantillonnage n’a pas conservé la trace.
Diagnostic : exécutez d’abord la requête la plus large, { span.larkfield.ticket.id = "T-90104" }. Si elle ne retourne rien, la plage de temps est incorrecte. Si elle fonctionne, comparez vos noms d’attributs aux attributs d’un span dans la vue en cascade, ou à grafana/traceql.md.
Correction : élargissez la plage de temps, copiez les noms de la fiche et rappelez-vous qu’une trace éliminée reste introuvable. obs find lit toutes les traces enregistrées.
Erreur courante
Une requête retourne exactement 50 traces
Symptôme : une requête retourne exactement 50 traces, et vous en attendiez davantage.
Cause : la recherche TraceQL de Grafana a une limite de 50 traces par défaut (Search Options → Limit, options de recherche → limite). Elle n’en affiche pas plus.
Correction : augmentez la limite dans Search Options pour cette requête. Ne considérez jamais un tableau TraceQL comme un décompte d’une semaine entière : utilisez obs find ou une métrique pour compter.
À vous : un autre outil, la même question
Section intitulée « À vous : un autre outil, la même question »Changez une condition : cherchez les exécutions qui ont appelé get_payments au moins deux fois.
-
Prédisez : le service de paiement a subi des défaillances d’exercice cette semaine. Attendez-vous des exécutions qui ont appelé
get_paymentsdeux fois? Le modèle aura-t-il récupéré, comme dans R-1012-004? -
Cherchez :
Fenêtre de terminal python -m obs find --data data/telemetry/week --tool get_payments --min-calls 2 -
Ouvrez le premier résultat avec
python -m obs trace RUN --data data/telemetry/week. Écrivez ensuite la requête TraceQL qui trouverait les mêmes traces dans Grafana.
Vérifiez votre prédiction
R-1013-025 T-90602 Tue 13:35 chat-small get_payments called 2 timesR-1014-034 T-90602 Wed 15:05 chat-small get_payments called 2 timesR-1016-003 T-90602 Fri 03:02 chat-small get_payments called 2 times3 match(es) in 316 run(s)Les trois concernent le billet T-90602, dont la défaillance d’exercice enregistrée est un service de paiement hors service. Ouvrez R-1013-025 :
     1.0 s |      ==                |   0.20 s    execute_tool get_payments  ERROR service_unavailable  LK-645112     1.2 s |       =======          |   0.97 s    chat chat-small  2530 in / 22 out  US$0.00026  tool_calls     2.2 s |              =         |   0.20 s    execute_tool get_payments  ERROR service_unavailable  LK-645112     2.4 s |               =========|   1.31 s    chat chat-small  2596 in / 105 out  US$0.00031  tool_calls
Outcome: handed_to_person
Les deux appels ont échoué, et chat-small a transmis le billet à une personne. C’est le bon résultat pour ce billet selon les étiquettes du cours. Comparez-le à R-1018-010 dans la dernière leçon : même billet et même outil défaillant. Mais gemma3:4b a répondu et l’a fermé comme résolu. La requête TraceQL : { span.gen_ai.tool.name = "get_payments" } | count() > 1.
Quand utiliser TraceQL, et ce qu’il coûte
Section intitulée « Quand utiliser TraceQL, et ce qu’il coûte »Utilisez TraceQL quand la question porte sur la structure d’une exécution : quels spans, avec quels attributs, combien, sous quelle racine. Il est rapide pour un ingénieur qui connaît les noms d’attributs. Chaque résultat est une trace que vous pouvez ouvrir.
Il a des limites. Il trouve des traces : une exécution avec deux traces nécessite donc deux étapes. Il vérifie « et » entre les ensembles de spans, pas « après ». Il cherche seulement les traces conservées par l’échantillonnage, et la limite de recherche coupe les longues listes. Chaque requête exige aussi un seuil réfléchi, comme N dans « plus de N appels ». Écrivez les requêtes une fois, dans une fiche partagée par votre équipe. Testez chacune sur une exécution qui devrait correspondre. La prochaine leçon transforme les requêtes en cinq modèles nommés, chacun avec une règle qui lit les spans dans l’ordre.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
La requête { span.gen_ai.tool.name = « request_refund » && span.larkfield.write.outcome =~ « done|timeout » } a trouvé 39 traces. Pourquoi n'est-ce pas une liste de 39 problèmes? Comment en faire une recherche de doubles remboursements?
Afficher la réponse
Chacune des 39 traces contient au moins un remboursement qui a peut-être été versé. Un seul remboursement fait partie du travail normal. La défaillance suit un schéma : deux appels de remboursement de ce type dans une même trace. Le pipeline | count() > 1 garde seulement les traces avec plus d’un span correspondant. Il reste alors 2 traces : les deuxièmes traces de R-1014-040 et de R-1014-051.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
obs find --error-then-resolved a trouvé 8 exécutions. Combien sont de vraies défaillances, et que ne vérifie pas la requête?
Afficher la réponse
Deux : R-1018-010 et R-1018-022. Aucun appel ultérieur de l’outil en échec n’a réussi, mais l’exécution s’est quand même terminée avec le statut résolu. Dans les six autres, un appel ultérieur du même outil a fonctionné. L’erreur a donc été corrigée. La requête vérifie seulement qu’une lecture en échec et un résultat résolu se trouvent dans la même trace. Elle ne vérifie ni l’ordre des spans ni si un appel ultérieur a corrigé l’erreur.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Exercice pratique : écrivez une requête TraceQL qui trouve les traces contenant une écriture sans décision humaine à la racine. Expliquez ensuite pourquoi 0 résultat est une bonne nouvelle ici, mais seulement après une vérification.
Afficher la réponse
{ rootName !~ "approve.*" && span.larkfield.tool.kind = "write" && span.gen_ai.tool.name != "send_reply" }. Zéro résultat peut aussi indiquer une requête qui ne trouve jamais de correspondance : une faute de frappe ou le mauvais attribut. Vérifiez qu’elle peut trouver des correspondances : retirez la condition rootName (nom de la racine). La semaine enregistrée contient alors 118 traces avec une écriture, toutes avec la racine approve support-resolution (approuver la résolution du soutien). La requête détecte donc les écritures, et chaque écriture a suivi une décision.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- TraceQL applique des conditions aux spans et renvoie des traces.
{ … && … }désigne un seul span.{ A } && { B }désigne deux ensembles de spans dans une même trace.| count() > Ncompte les spans correspondants de chaque trace. - Construite étape par étape, la requête de recherche d’écritures en double est passée de 45 spans de remboursement dans 39 traces à 2 traces : les deux doubles remboursements de la semaine.
- Plus de N appels : 0 avec N = 2, 13 avec N = 1. Les exécutions à deux appels avaient corrigé une erreur. Une écriture sans approbation : 0. Une vérification a montré que la requête détecte les 118 traces avec des écritures. Une erreur, puis un résultat résolu : 8 exécutions, dont 2 où l’erreur n’a pas été corrigée.
- Tempo cherche seulement dans les traces conservées. Chaque requête de défaillance a trouvé toutes les traces correspondantes. Toutefois, seules 23 des 39 exécutions coûtant plus de 1 cent ont été conservées.
Votre projet comprend maintenant obs find, la fiche TraceQL et le tableau de bord des traces : 87 tests réussissent. Vous pouvez maintenant chercher dans une semaine selon la structure de ses exécutions. Mais chaque requête reste un filtre approximatif : elle trouve aussi des erreurs corrigées et ne peut pas lire les spans dans l’ordre. Vous découvrirez ensuite les cinq modèles de défaillance des agents. Chacun a sa signature dans une trace et une règle pour le trouver.
Leçon suivante : Les modèles de défaillance des agents