
Découvrir le flux de travail en production
- Leçon 3
- 40 min
- Module 1 : Pourquoi les agents ont besoin de leur propre observabilité
Où nous en sommes
Nous savons maintenant quels signaux il nous faut et quelles données exclure. Jusqu'ici, ce ne sont que des noms sur une carte. Dans cette leçon, nous préparons le flux de travail sur notre ordinateur et provoquons nous-mêmes le double remboursement. Nous lisons aussi la télémétrie sauvegardée de la semaine de Larkfield avec l'outil obs. Ainsi, chaque leçon suivante modifiera quelque chose que nous avons vu fonctionner. Nous commençons dans un simulateur de vol.
Leçon 3 sur 28 · Observabilité des agents d'IA : traces, coûts et pistes d'auditDécouvrir le flux de travail en production
1. Pourquoi les agents ont besoin de leur propre observabilité
2. OpenTelemetry pour les agents
3. Instrumenter le flux de travail
4. Trouver les défaillances des agents dans Grafana
5. Le coût
6. Pistes d'audit
7. Alertes, niveaux de service et qualité
8. Outils : Langfuse, les autres et l'inspecteur d'exécutions
Ce que vous saurez faire
Préparez le flux de travail en production de Larkfield sur votre ordinateur et provoquez vous-même le double remboursement. Lisez la télémétrie sauvegardée de la semaine de Larkfield avec obs. Vous découvrez aussi quelles preuves du cours sont rejouées, simulées ou mesurées, et comment recommencer.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le double remboursement de l’exécution R-1014-040, présenté dans Un remboursement que personne ne peut expliquer.
- Les quatre signaux et les questions auxquelles chacun répond, présentés dans Ce qu’il faut enregistrer, et ce qu’il ne faut pas.
- Comment utiliser un terminal, un environnement virtuel et
pip. Le cours Agents d’IA et orchestration des flux de travail utilisait les mêmes étapes.
Ce qu’il vous faut sur votre ordinateur
- Le projet
~/projects/observable-workflowde la première leçon de ce module, et le dépôt des laboratoires dans~/projects/nextia-learning-labs. - Python 3.12 ou plus récent. Vérifiez avec
python3.12 --versionsur macOS et Linux, oupy -3.12 --versionsur Windows. - Une connexion Internet, une seule fois, pour
pip. L’environnement virtuel occupe environ 90 Mo.
Vous n’avez besoin d’aucun compte, d’aucune clé et d’aucun paiement. Docker est facultatif et n’est pas nécessaire dans ce module. Testé sur macOS (Apple silicon) avec Python 3.12.13. Les commandes Windows (PowerShell) et Linux sont fournies, mais l’équipe du cours ne les a pas exécutées.
Un simulateur de vol
Section intitulée « Un simulateur de vol »Les pilotes s’exercent à gérer une panne de moteur dans un simulateur de vol. Le simulateur reproduit le comportement réel de l’avion, mesuré lors de vols réels. L’instructrice provoque la panne du moteur, au moment qu’elle choisit. Personne n’est en danger, et chaque élève peut vivre la même panne, de la même façon.
Après l’exercice, l’instructrice et le pilote regardent ensemble l’enregistrement du vol. Ils voient chaque commande que le pilote a touchée, et à quel moment. L’enregistrement est le but de l’exercice : il transforme « Je pense avoir fait ce qu’il fallait » en preuve.
Ce cours fonctionne de la même façon. Le comportement du modèle est réel et enregistré. Les défaillances sont provoquées volontairement. Et la télémétrie est l’enregistrement que vous apprenez à lire.
Le problème : vous ne pouvez pas vous exercer sur un service de soutien en production
Section intitulée « Le problème : vous ne pouvez pas vous exercer sur un service de soutien en production »Amira ne peut pas apprendre à repérer les doubles remboursements en attendant que de vrais clients soient remboursés deux fois. Un modèle réel peut aussi répondre différemment demain. Une leçon ne pourrait donc pas montrer la sortie que vous verrez. Et une mauvaise semaine chez Larkfield représente des centaines d’exécutions : personne ne peut toutes les provoquer à la main.
Le cours fait donc comme le simulateur. Il rejoue des décisions réelles de modèles, provoque les défaillances et sauvegarde la télémétrie d’une semaine entière pour vous.
L’idée : rejoué, simulé et mesuré
Section intitulée « L’idée : rejoué, simulé et mesuré »Chaque preuve de ce cours porte une étiquette. Utilisez les mêmes étiquettes dans vos notes :
| Étiquette | Ce que c’est | Exemples |
|---|---|---|
| rejoué | une réponse réelle d’un modèle réel, enregistrée dans le cours sur les agents, puis rejouée | les décisions de chat-small, chat-strong et gemma3:4b, avec leurs jetons et leur latence |
| simulé | un comportement inventé pour le cours afin de pratiquer une situation | le trafic de la semaine, le service de paiement lent, le service de réponse en panne, les moments d’approbation |
| construit | un cas ou un bogue que l’auteur du cours a créé volontairement | une exécution où un modèle scripté obéit à une instruction injectée, dans le module 4 |
| mesuré | un nombre provenant d’une exécution du code du cours | vos propres exécutions et celles de l’équipe du cours sur un portable |
| hypothèse | une valeur déclarée, comme un budget ou une durée de conservation | les 7 ans de la piste d’audit; le budget d’Omar par billet résolu |

Description textuelle du diagramme
Deux sources alimentent le tout. Les enregistrements rejoués sont les réponses réelles des modèles du cours sur les agents, avec leurs jetons et leur latence. Les éléments simulés sont le trafic de la semaine, les défaillances et les moments où les personnes approuvent. Quand vous exécutez un billet, le fournisseur simulé répond à partir des enregistrements. Des options comme –fault et –naive-retry ajoutent une défaillance simulée. Votre exécution écrit dans le dossier work/ : une base de données d’exercice et un journal. L’équipe du cours a utilisé les deux mêmes sources pour créer la semaine rejouée, sauvegardée dans data/telemetry/week. Vous la lisez avec python -m obs.
Le fournisseur simulé rejoue les enregistrements du cours sur les agents. Quand le flux de travail envoie une requête à un modèle, ce fournisseur trouve la requête enregistrée et renvoie la réponse enregistrée. Votre exécution du billet T-90104 prend donc exactement la même décision que l’exécution R-1014-040 de la semaine sauvegardée.
Un détail découle de cette relecture. Les règles de date du flux de travail utilisent l’« aujourd’hui » du cours sur les agents : vendredi 9 octobre 2026. Ainsi, chaque enregistrement se rejoue exactement. C’est pourquoi la réponse indique que la commande a « 12 jours ouvrables de retard », peu importe la semaine. La semaine sauvegardée va du lundi 12 au dimanche 18 octobre, à l’heure de Toronto. Ne calculez jamais un retard à partir des horodatages de la semaine : utilisez les valeurs enregistrées par le flux de travail.
Préparer le projet
Section intitulée « Préparer le projet »-
Allez dans le projet :
Fenêtre de terminal cd ~/projects/observable-workflow -
Créez et activez un environnement virtuel avec Python 3.12 :
Fenêtre de terminal python3.12 -m venv .venvsource .venv/bin/activateFenêtre de terminal py -3.12 -m venv .venv.venv\Scripts\Activate.ps1Fenêtre de terminal python3.12 -m venv .venvsource .venv/bin/activateL’invite commence maintenant par
(.venv). À partir d’ici, tapezpythonsur tous les systèmes. Réactivez l’environnement dans chaque nouveau terminal. -
Installez les paquets aux versions fixées :
Fenêtre de terminal python -m pip install -r requirements-dev.txtCela prend moins d’une minute. Les dernières lignes peuvent suggérer une version plus récente de
pip. Vous pouvez ignorer cette suggestion. -
Exécutez les tests de l’instantané :
Fenêtre de terminal python -m pytest -qLa dernière ligne :
72 passed, 1 deselected in 3.26sVotre durée sera différente. Parmi les 72 tests, 69 proviennent du cours sur les agents et testent le flux de travail. Le test désélectionné appelle un fournisseur réel et ne s’exécute que si vous le demandez.
Exécuter un billet
Section intitulée « Exécuter un billet »Le billet de soutien T-80008 demande où se trouve une remise de jardin. Exécutez-le :
python -m resolver run T-80008La sortie, rejouée :
Run T-80008-agent-chat-small-1 | single agent with tool calling: the model chooses every step | chat-smallOutcome: reply_only (rule W1) | 2 model call(s), 1 tool call(s) | 4580 tokens in, 117 out | US$0.00052Reply draft: Your garden shed order LK-581106 shipped on Monday, October 5. Its expected delivery date is Tuesday, October 13. It is currently in transit, and there is no delivery date showing yet.Reply sent. Ticket: resolved.Les deux premières lignes sont le résumé de l’exécution fourni par le cours sur les agents. Elles donnent la conception, le modèle, le résultat et sa règle de politique, les appels, les jetons et le coût. Le flux de travail en production ajoute la dernière ligne : il a envoyé la réponse et fermé le billet. Ce billet ne nécessite aucun changement, donc aucune approbation.
Le flux de travail a aussi écrit son unique ligne de journal, dans work/logs/workflow.log :
…-04:00 INFO ticket=T-80008 run=T-80008-agent-chat-small-1 model=chat-small status=resolved writes=0 reply=sentVotre ligne commence par la date et l’heure de votre exécution. Le dossier work/ contient tout ce que vos exécutions créent : la base de données d’exercice, les états des exécutions et le journal. Git l’ignore.
Exemple détaillé : provoquer le double remboursement
Section intitulée « Exemple détaillé : provoquer le double remboursement »Reproduisez maintenant le double remboursement de la première leçon sur votre ordinateur. Il vous faut trois commandes : exécuter le billet, l’approuver avec la défaillance et la nouvelle tentative naïve, puis lister les changements.
-
Exécutez le billet T-90104 comme la version 2.1.0 le faisait, avec l’agent structuré sur chat-strong :
Fenêtre de terminal python -m resolver run T-90104 --variant agent_structured --model chat-strongLa sortie est longue. Voici ses deux premières lignes et sa dernière ligne :
Run T-90104-agent_structured-chat-strong-1 | single agent with one JSON step per call (for models without tool calling) | chat-strongOutcome: resolve (rule W2) | 2 model call(s), 1 tool call(s) | 4586 tokens in, 265 out | US$0.01182…Nothing has changed yet. Next: python -m resolver approve T-90104-agent_structured-chat-strong-1 --as agent (or: reject)Entre les deux, elle affiche la proposition :
request_refund LK-793996 9.95 CAD RFD-LATE. Elle indique aussi qui peut l’approuver, la raison, les preuves et le brouillon de réponse. Les jetons et le coût sont les mêmes que pour R-1014-040 : c’est la même décision enregistrée. -
Approuvez-la en tant que Sam, avec le service de paiement lent et la nouvelle tentative naïve :
Fenêtre de terminal python -m resolver approve T-90104-agent_structured-chat-strong-1 --as agent --name Sam --fault request_refund:timeout_after_write --naive-retryrequest_refund LK-793996: done (operation 797fbb5bbb9f8a7e, 2 call(s))Status: doneReply sent. Ticket: resolved.--fault request_refund:timeout_after_writeforce le service de paiement d’exercice à effectuer le remboursement, puis à répondre trop tard.--naive-retryest la nouvelle tentative de Tomás dans la version 2.1.0. Les deux sont simulés. Regardez la première ligne : une opération, terminée, « 2 appel(s) ». Le résumé du flux de travail lui-même cache le deuxième remboursement. -
Listez les changements dans la base de données d’exercice :
Fenêtre de terminal python -m resolver changes… T-90104 request_refund LK-793996 9.95 RFD-LATE (operation 797fbb5bbb9f8a7e)… T-90104 request_refund LK-793996 9.95 RFD-LATE (operation 797fbb5bbb9f8a7e-retry1)2 change(s) in the practice databaseDeux remboursements de 9,95, avec deux clés différentes. La base de données d’exercice est ici le « service de paiement » : le système d’enregistrement officiel. Vos lignes commencent par l’heure de votre exécution.
-
Lisez la dernière ligne de votre journal :
Fenêtre de terminal tail -1 work/logs/workflow.logFenêtre de terminal Get-Content work\logs\workflow.log -Tail 1Fenêtre de terminal tail -1 work/logs/workflow.log…-04:00 INFO ticket=T-90104 run=T-90104-agent_structured-chat-strong-1 model=chat-strong status=resolved writes=1 reply=sent
Vous avez vous-même produit la contradiction de la première leçon : deux changements dans le système d’enregistrement officiel, mais writes=1 dans le journal. Les clés montrent d’où vient le deuxième remboursement : 797fbb5bbb9f8a7e est l’opération prévue. -retry1 est la nouvelle tentative qui lui a donné une nouvelle clé.
La trace affichée du cours sur les agents
Section intitulée « La trace affichée du cours sur les agents »Le cours sur les agents avait une commande qui affiche les étapes d’une exécution. Essayez-la :
python -m resolver trace T-90104-agent_structured-chat-strong-1Run T-90104-agent_structured-chat-strong-1: agent_structured, chat-strong, ticket T-90104, status done2 model call(s), 4586 tokens in, 265 out, US$0.01182, 6.559 s waiting for the model
1 plan ["Check delivery status and lateness.", "Apply delivery policy and draft a reply."] 1 model chat-strong: get_order({"order_id": "LK-793996"}) (2160 in, 47 out, 2.388 s) 1 tool get_order({"order_id": "LK-793996"}) -> ok 2 plan [] 2 model chat-strong: finish({"outcome": "resolve", "rule": "W2", "a…) (2426 in, 218 out, 4.171 s) 2 proposal resolve (W2): request_refund LK-793996 2 stop finished 2 approval approved by usr-sam (agent) 2 write request_refund op 797fbb5bbb9f8a7e -> timeout 2 write request_refund op 797fbb5bbb9f8a7e-retry1 -> done 2 stop doneElle montre les deux écritures. Pourquoi cela ne suffit-il pas? Sam pose la même question. Amira répond : « Elle lit l’état sauvegardé de l’exécution dans work/runs.sqlite, sur l’ordinateur qui l’a exécutée. Personne d’autre ne peut le voir. Il n’y a pas d’heure pour chaque étape, ni d’attente. Elle ne peut pas chercher dans les 316 exécutions d’une semaine, et aucun tableau de bord ne peut les compter. » C’est un affichage de débogage pour une seule exécution. Le module 2 transforme les mêmes étapes en une trace qui sort du flux de travail.
Ajouter les fichiers de la leçon
Section intitulée « Ajouter les fichiers de la leçon »L’instantané end-of-m01 ajoute quatre éléments. obs est l’outil du cours qui lit la télémétrie sauvegardée. data/telemetry/ contient la télémétrie sauvegardée de la semaine de Larkfield. auditstore/ est le lecteur du stockage d’audit, et grafana/ contient les fichiers de Grafana. Votre propre flux de travail n’enregistre toujours aucune télémétrie : le module 2 ajoute cela.
-
Copiez les fichiers de l’instantané
end-of-m01. Dans~/projects/observable-workflow:Fenêtre de terminal S=../nextia-learning-labs/C31/snapshots/end-of-m01cp -R $S/obs $S/auditstore $S/grafana .cp -R $S/data/telemetry data/cp $S/tests/test_obs_cli.py tests/cp $S/README.md .Fenêtre de terminal $S = "..\nextia-learning-labs\C31\snapshots\end-of-m01"Copy-Item -Recurse $S\obs, $S\auditstore, $S\grafana .Copy-Item -Recurse $S\data\telemetry data\Copy-Item $S\tests\test_obs_cli.py tests\Copy-Item -Force $S\README.md .Fenêtre de terminal S=../nextia-learning-labs/C31/snapshots/end-of-m01cp -R $S/obs $S/auditstore $S/grafana .cp -R $S/data/telemetry data/cp $S/tests/test_obs_cli.py tests/cp $S/README.md . -
Exécutez les tests de nouveau :
Fenêtre de terminal python -m pytest -qLa dernière ligne indique maintenant
76 passed, 1 deselected(76 tests réussis, 1 désélectionné). Votre projet est maintenant identique à l’instantanéend-of-m01.
La télémétrie sauvegardée contient deux semaines. data/telemetry/week est la semaine de Larkfield, avec tous les incidents d’exercice : 316 exécutions, 434 traces, 2 027 spans (intervalles tracés), 503 événements et 1 331 enregistrements d’audit. data/telemetry/healthy-week contient les mêmes billets sur la version 2.0.0, sans incident, pour la comparaison du module 7. Chaque dossier contient les traces, les métriques et les journaux au format JSON d’OpenTelemetry (*.jsonl.gz), ainsi que la piste d’audit (audit.jsonl).
Lire la semaine rejouée avec obs
Section intitulée « Lire la semaine rejouée avec obs »obs lit la télémétrie sauvegardée. Avec --data, il lit une semaine sauvegardée; sans cette option, vos propres exécutions, à partir du module 2.
Les exécutions d’une journée
Section intitulée « Les exécutions d’une journée »python -m obs runs --data data/telemetry/week --day wed --limit 8run ticket started outcome model tools appr cost US$ secs model flagsR-1014-045 T-90304 Wed 18:27 handed_to_person 2 1 0 0.00052 2.8 chat-small -R-1014-046 T-80001 Wed 18:59 handed_to_person 1 0 0 0.00027 1.8 chat-small -R-1014-047 T-90406 Wed 19:07 resolved 2 1 0 0.01148 6.4 chat-strong -R-1014-048 T-90502 Wed 19:13 resolved 4 3 0 0.00111 5.4 chat-small -R-1014-049 T-90505 Wed 19:24 handed_to_person 1 0 0 0.00026 1.4 chat-small -R-1014-050 T-90303 Wed 19:24 handed_to_person 1 0 0 0.00027 1.6 chat-small -R-1014-051 T-90606 Wed 19:31 resolved 2 1 1 0.01181 6.1 chat-strong -R-1014-052 T-80004 Wed 19:45 handed_to_person 1 0 0 0.00027 1.8 chat-small -52 run(s), 0 flagged (last 8 shown)Une ligne par exécution, tirée de la télémétrie, pas du journal. Après le résultat viennent les appels de modèle (model), les appels d’outils (tools), les demandes d’approbation (appr) et le coût. secs est la durée du travail de l’agent, sans l’attente d’une personne. Ensuite vient le nom du modèle. La dernière colonne, flags (signalements), est vide pour l’instant. Dans le module 4, obs apprend à signaler les modèles de défaillance des agents, et cette colonne se remplit.
Regardez R-1014-051, pour le billet T-90606. Comme R-1014-040, elle a utilisé chat-strong, demandé une approbation et terminé avec le statut résolu. Gardez-la en tête pour votre exercice plus bas.
Le double remboursement, sous forme de trace
Section intitulée « Le double remboursement, sous forme de trace »python -m obs trace R-1014-040 --data data/telemetry/weekRun R-1014-040 | ticket T-90104 | chat-strong (agent_structured) | release 2.1.0 | language en2 model call(s), 1 read(s), 2 write call(s), 4586 tokens in, 265 out, US$0.01182
Trace 1 f0433c4403e2767e1d69ece18a947526 Wed 14 Oct 17:52:00 6.6 s 0.0 s |========================| 6.56 s invoke_agent support-resolver resolve rule W2 0.0 s |========= | 2.39 s chat chat-strong 2160 in / 47 out US$0.00479 stop 2.4 s | = | 0.00 s execute_tool get_order ok LK-793996 2.4 s | ================| 4.17 s chat chat-strong 2426 in / 218 out US$0.00703 stop 6.6 s | =| 0.00 s approval.request needs agent
... waited 15 h 25 min for a person (this trace has a link to 78d246ee22e5f5ef in trace f0433c44...)Trace 2 15ba0d9388d1b9e001af373f21c4b955 Thu 15 Oct 09:17:12 10.0 s 0.0 s |========================| 10.01 s approve support-resolution approved by usr-sam (agent, limit 100) 0.0 s |========================| 10.00 s execute_tool request_refund ERROR timeout LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e 10.0 s | =| 0.00 s execute_tool request_refund done LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e-retry1 10.0 s | =| 0.00 s execute_tool send_reply sent
Outcome: resolvedC’est une cascade : une ligne par span, dans l’ordre chronologique. Lisez-la à partir de la gauche :
- Le décalage (
0.0 s,2.4 s) : le début du span, compté depuis le début de sa trace. - La barre : la position du span dans la durée de la trace. Un span en retrait est un enfant du span au-dessus.
- La durée (
2.39 s) : combien de temps le span a duré. Les spans de modèle durent aussi longtemps que les appels enregistrés. - Le nom et les détails :
chat chat-strongest un appel de modèle, avec ses jetons, son coût et sa raison de fin.execute_tool get_orderest un appel d’outil.approval.requestest le moment où l’exécution a demandé l’intervention d’une personne.
Il y a deux traces. La trace 1 est celle du mercredi soir : deux appels de modèle, une lecture, puis la demande d’approbation. L’exécution a ensuite attendu 15 h 25 minutes, et rien ne s’est exécuté. La trace 2 est celle du jeudi matin : l’approbation de Sam, puis le remboursement dont le délai a expiré après 10 secondes. Viennent ensuite le même remboursement avec la clé -retry1, puis la réponse. La trace 2 porte un lien vers la demande d’approbation de la trace 1, pour qu’un outil puisse les relier. Le module 3 montre comment le flux de travail les crée.
Comparez-la à la trace affichée de votre propre exécution plus haut. Les étapes sont les mêmes, car les décisions viennent des mêmes enregistrements. La trace sauvegardée ajoute les heures, les durées, les coûts, la version, la limite de la personne et un format lisible par les outils.
Les événements et la piste d’audit
Section intitulée « Les événements et la piste d’audit »python -m obs events R-1014-040 --data data/telemetry/weekWed 14 Oct 17:52:06 larkfield.approval.waiting trace f0433c44 {"run.id": "R-1014-040", "ticket.id": "T-90104", "approval.needs_role": "agent"}Thu 15 Oct 09:17:22 larkfield.run.closed trace 15ba0d93 {"run.id": "R-1014-040", "ticket.id": "T-90104", "outcome": "resolved", "writes_done": 1, "reply": "sent", "helpdesk.status": "resolved"}Fri 16 Oct 09:17:12 gen_ai.evaluation.result trace f0433c44 {"gen_ai.evaluation.name": "sampled-review", "gen_ai.evaluation.score.value": 0.0, "gen_ai.evaluation.score.label": "fail", "run.id": "R-1014-040", "ticket.id": "T-90104", "reviewer": "usr-priya"}3 event(s)Trois événements aux noms fixes. Le deuxième, larkfield.run.closed, est la ligne du journal sous forme structurée, avec le même writes_done: 1. Le troisième est une révision par échantillonnage, un jour plus tard. Priya, responsable de la qualité, a marqué cette exécution fail (échec) : le client a reçu deux remboursements au lieu d’un. Les révisions sont simulées : les étiquettes du cours sur les agents remplacent le jugement de Priya.
Vérifiez ensuite la piste d’audit de toute la semaine :
python -m obs audit verify --data data/telemetry/weekThe audit trail is intact: 1331 records, the chain and the anchor match (head e378b7d00139f1c3).Chaque enregistrement d’audit contient l’empreinte de l’enregistrement précédent : les enregistrements forment donc une chaîne. verify (vérifier) recalcule chaque empreinte et compare la dernière à une ancre. Ce petit fichier conserve le nombre d’enregistrements et la dernière empreinte. Si quelqu’un modifie ou supprime un enregistrement, verify indique où. Le module 6 construit ce mécanisme, et vous le brisez volontairement dans ce module.
Grafana : facultatif, plus tard dans le cours
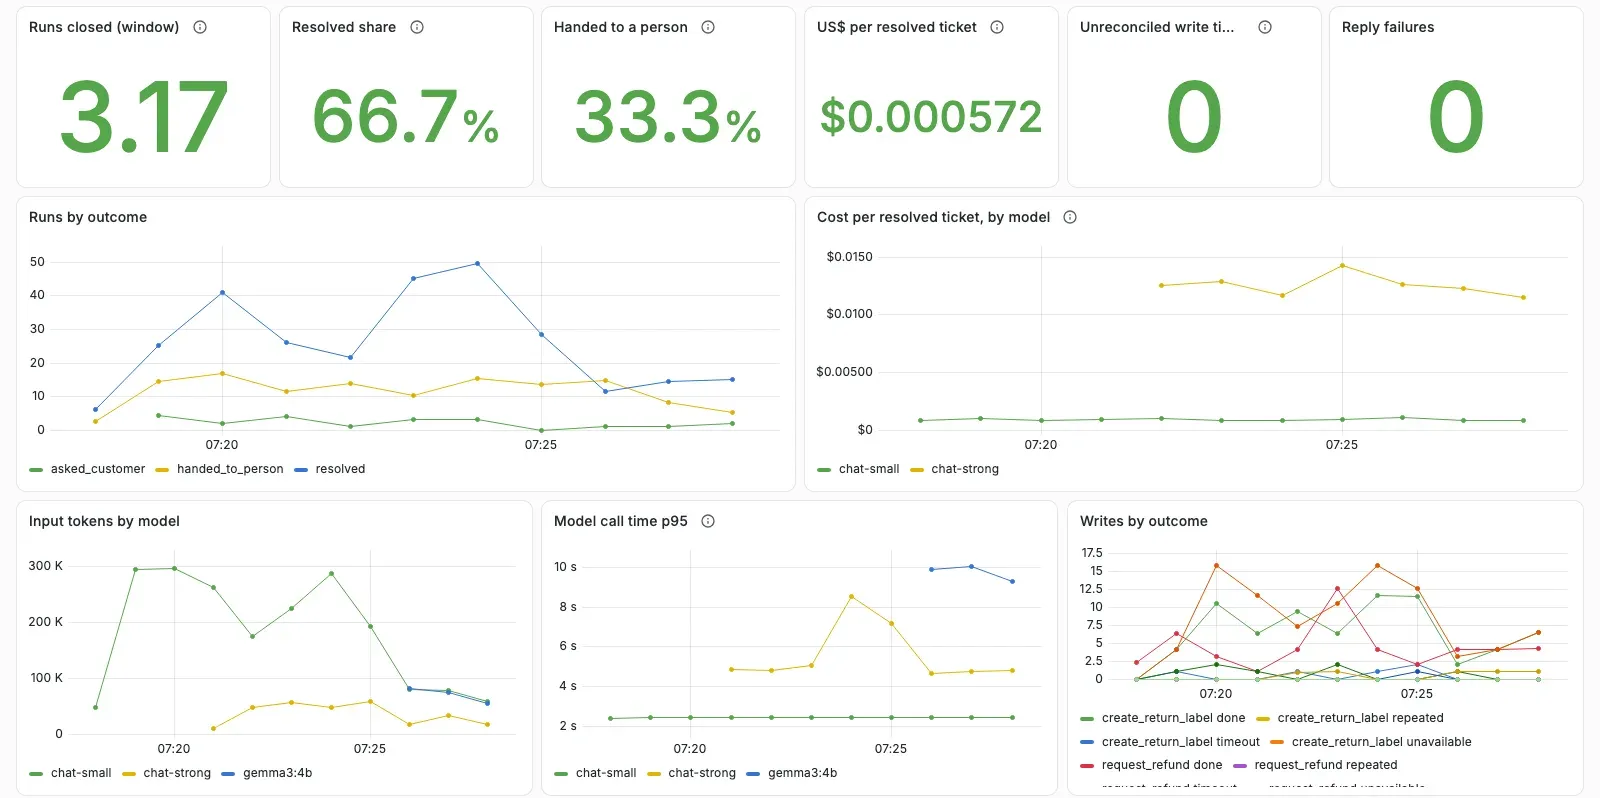
Section intitulée « Grafana : facultatif, plus tard dans le cours »Grafana est l’outil du cours pour chercher dans la télémétrie et la représenter graphiquement. Il fonctionne dans un seul conteneur Docker, grafana/otel-lgtm, qui contient Tempo, Prometheus et Loki. grafana/compose.yaml est maintenant dans votre projet.
Ne le démarrez pas encore. Grafana affiche la télémétrie que le flux de travail lui envoie, et votre flux n’en envoie aucune avant le module 2. Lire une exécution, dans le module 4, montre comment le démarrer et lui envoyer une semaine. Chaque leçon fonctionne aussi sans Grafana, avec obs et la télémétrie sauvegardée. Si vous comptez l’utiliser, vérifiez maintenant que Docker Compose est installé :
docker compose versionSi cette commande affiche une version, vous êtes prêt. Si elle indique que la commande est introuvable, le cours L’essentiel de Docker et du nuage pour les développeurs en IA montre comment installer Docker. Sur le portable de l’équipe du cours, le conteneur utilisait de 890 à 960 Mio de mémoire après avoir stocké la semaine rejouée.
Arrêter et réinitialiser
Section intitulée « Arrêter et réinitialiser »Vos exécutions ont laissé une base de données d’exercice avec deux remboursements, des états d’exécution et un journal. Pour recommencer, supprimez le dossier work/ :
-
Supprimez-le :
Fenêtre de terminal rm -rf workFenêtre de terminal Remove-Item -Recurse -Force workFenêtre de terminal rm -rf work -
Exécutez un billet de soutien et affichez les changements :
Fenêtre de terminal python -m resolver run T-80008python -m resolver changesL’exécution se termine par
Reply sent. Ticket: resolved.(réponse envoyée; billet résolu). Les changements indiquent0 change(s) in the practice database(aucun changement dans la base de données d’exercice). Le flux de travail a créé une nouvelle base de données d’exercice.
python -m resolver reset crée seulement une nouvelle base de données d’exercice : il conserve votre journal et vos états d’exécution. Supprimez work/ pour une réinitialisation complète. Les semaines enregistrées dans data/telemetry/ ne changent jamais. Vous n’avez donc jamais besoin de les réinitialiser.

Description textuelle du diagramme
Exécutez d’abord python -m pytest -q. Si la commande n’affiche pas 76 passed (76 tests réussis), vérifiez le dossier observable-workflow et l’invite (.venv). Copiez ensuite de nouveau les fichiers de cette leçon et relancez les tests. Exécutez ensuite le billet T-80008. Si l’exécution ne se termine pas par Reply sent. Ticket : resolved. (réponse envoyée; billet résolu), supprimez work/ et recommencez. Vérifiez ensuite la piste d’audit de la semaine enregistrée. Si elle indique intact avec 1 331 enregistrements, tout est prêt. Sinon, copiez de nouveau data/telemetry depuis l’instantané end-of-m01.
Erreur courante
obs indique qu'il n'y a pas de télémétrie
Symptôme : vous exécutez un billet, puis python -m obs runs, et la commande affiche :
No telemetry in /Users/you/projects/observable-workflow/work/telemetry. Run a ticket first (python -m resolver run T-80008), or read the replayed week: --data data/telemetry/weekCause : à cette étape, votre flux de travail n’enregistre aucune télémétrie. Il écrit seulement sa ligne de journal. Le conseil du message, qui suggère d’exécuter un billet, devient valable au module 2. Le flux de travail commence alors à enregistrer des traces.
Solution : ajoutez --data data/telemetry/week pour lire la semaine enregistrée. Lisez vos propres exécutions avec python -m resolver trace <run> jusqu’au module 2.
Erreur courante
Les tests indiquent 72, pas 76
Symptôme : après la copie des fichiers de la leçon, python -m pytest -q se termine encore par 72 passed (72 tests réussis).
Cause : le fichier de tests tests/test_obs_cli.py n’a pas été copié, ou vous avez lancé les tests dans un autre dossier.
Diagnostic : ls tests/test_obs_cli.py (Windows : dir tests\test_obs_cli.py). S’il manque, la copie a échoué. Sur Windows, vérifiez aussi que $S est défini dans le même terminal.
Solution : refaites l’étape 1 de Ajouter les fichiers de la leçon, puis lancez les tests.
À vous de jouer : l’autre exécution
Section intitulée « À vous de jouer : l’autre exécution »Changez une condition : lisez une autre exécution du même mercredi soir. Avant d’exécuter quoi que ce soit, faites une prédiction.
-
Faites une prédiction : l’exécution R-1014-051, pour le billet T-90606, a été proposée mercredi à 19 h 31, aussi sur chat-strong. Sa ligne de journal indique
status=resolved writes=1 reply=sent(état résolu, une écriture, réponse envoyée), comme celle de R-1014-040. Combien de temps a-t-elle attendu une personne? Combien d’appels de remboursement prévoyez-vous dans la trace 2, et avec quelles clés? -
Lisez sa trace :
Fenêtre de terminal python -m obs trace R-1014-051 --data data/telemetry/week -
Comparez-la à votre prédiction et à la trace de R-1014-040.
Vérifiez votre prédiction
Le résultat du cours (décisions rejouées, défaillances simulées) :
... waited 13 h 44 min for a person (this trace has a link to a186588bf9ac5a21 in trace 93c0fb55...)Trace 2 f346995f983d307ccc832d6df8228be8  Thu 15 Oct 09:16:27  10.0 s     0.0 s |========================|  10.00 s  approve support-resolution  approved by usr-sam (agent, limit 100)     0.0 s |=                       |   0.00 s    execute_tool request_refund  ERROR unavailable  LK-645556  9.95 RFD-LATE  key c18d8c3f31b823c4     0.0 s |========================|  10.00 s    execute_tool request_refund  ERROR timeout  LK-645556  9.95 RFD-LATE  key c18d8c3f31b823c4    10.0 s |                       =|   0.00 s    execute_tool request_refund  done  LK-645556  9.95 RFD-LATE  key c18d8c3f31b823c4-retry2    10.0 s |                       =|   0.00 s    execute_tool send_reply  sent
Outcome: resolved
L’exécution a attendu 13 h 44 minutes. Sam l’a approuvée 45 secondes avant R-1014-040. La trace 2 contient trois appels de remboursement. Le premier a été refusé immédiatement (unavailable : indisponible). Le service n’a fait aucun remboursement; c’est la défaillance d’exercice enregistrée pour ce billet. Le deuxième, avec la même clé, a dépassé le délai après le remboursement. Le troisième a utilisé une nouvelle clé, -retry2, et a fait un deuxième remboursement. R-1014-051 est donc le deuxième double remboursement de la semaine. Sa ligne de journal est l’une des 83 que vous avez comptées dans la première leçon. Elle est identique à celles des exécutions correctes. Le premier appel montre qu’une nouvelle tentative avec la même clé convient : le deuxième appel l’a réutilisée. La nouvelle clé a causé le problème.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Dans votre propre double remboursement, qu'est-ce qui a été rejoué, simulé et mesuré?
Afficher la réponse
Rejoué : les deux décisions de modèle de chat-strong, avec leurs jetons, leur latence et leur coût enregistrés. Il s’agit de la recherche de LK-793996 et du remboursement proposé de 9,95 selon la règle W2. Simulé : le service de paiement qui a fait le remboursement et répondu trop tard (–fault request_refund:timeout_after_write). La nouvelle tentative avec une nouvelle clé (–naive-retry) était aussi simulée. Mesuré : ce que votre propre ordinateur en a fait, soit les deux changements dans la base de données d’exercice et la ligne de journal.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification du module : expliquez pourquoi un journal de la réponse finale ne peut pas expliquer l'action d'un agent. Utilisez un exemple du flux de travail.
Afficher la réponse
La réponse finale contient les mots du modèle destinés au client, écrits avant l’action. L’action est une série d’étapes que d’autres parties du système exécutent ensuite. Dans l’exécution R-1014-040, la réponse disait : « Nous soumettrons un remboursement de vos frais de livraison de 9,95 $ CA ». C’est vrai pour l’unique proposition du modèle. Mais le deuxième remboursement venait du code de nouvelle tentative du flux de travail, après un dépassement de délai, le lendemain. Aucun modèle ni aucune personne ne l’a décidé. La réponse et la ligne de journal indiquant writes=1 (une écriture) ne peuvent pas le montrer. Les étapes le peuvent : la trace montre deux appels request_refund avec deux clés. La piste d’audit montre quelle approbation chaque écriture a utilisée.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
La commande python -m resolver trace du cours Agents d'IA et orchestration des flux de travail montrait les deux écritures de votre exécution. Pourquoi ne répond-elle pas aux questions de Grace sur la semaine?
Afficher la réponse
Elle affiche une seule exécution à partir de son état enregistré sur l’ordinateur qui l’a exécutée. Personne d’autre ne peut le lire. Il ne contient ni l’heure de chaque étape ni l’attente d’approbation. La commande ne peut pas chercher ni compter les 316 exécutions d’une semaine. C’est un affichage de débogage. Grace a besoin d’enregistrements qui quittent le flux de travail, sont conservés et peuvent être cherchés et reliés entre eux. Il lui faut des traces, des métriques, des événements et une piste d’audit.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Chaque élément de preuve a une étiquette : rejoué, simulé, construit, mesuré ou hypothèse. Les décisions du modèle sont rejouées; le trafic, les défaillances et les heures d’approbation de la semaine sont simulés.
- Vous avez causé vous-même le double remboursement : deux changements dans la base de données d’exercice et une ligne de journal indiquant
writes=1(une écriture). obs runs,obs trace,obs eventsetobs audit verifylisent la semaine enregistrée. L’exécution R-1014-040 comprend deux traces reliées par un lien, avec une attente de 15 h 25 minutes entre elles.- R-1014-051 est le deuxième double remboursement de la semaine. Sa ligne de journal ressemble à celles des remboursements corrects.
- Grafana est facultatif; le module 4 le démarre. Supprimez
work/pour recommencer.
Votre projet maintenant : ~/projects/observable-workflow, identique à l’instantané end-of-m01, avec obs, les semaines enregistrées et 76 tests réussis. Vous pouvez maintenant lire la télémétrie enregistrée de Larkfield. Mais votre propre flux de travail écrit encore une seule ligne de journal par billet. Au module 2, vous lui ferez enregistrer chaque exécution sous forme de trace avec OpenTelemetry.
Leçon suivante : Spans, traces et contexte