
Lire une exécution
- Leçon 12
- 35 min
- Module 4 : Trouver les défaillances des agents dans Grafana
Où nous en sommes
Au module 3, nous avons fait enregistrer chaque appel de modèle, appel d'outil, écriture et approbation comme un span. Nous avons aussi relié les deux traces d'une exécution par un lien. Mais avoir des traces ne signifie pas savoir les lire. Sam demande quelle étape a été lente et quelle étape a coûté de l'argent. Les totaux ne peuvent pas répondre. Dans cette leçon, nous lisons la cascade d'une exécution d'agent, étape par étape. Nous commençons par la page de suivi d'un colis.
Leçon 12 sur 28 · Observabilité des agents d'IA : traces, coûts et pistes d'auditLire une exécution
1. Pourquoi les agents ont besoin de leur propre observabilité
2. OpenTelemetry pour les agents
3. Instrumenter le flux de travail
4. Trouver les défaillances des agents dans Grafana
5. Le coût
6. Pistes d'audit
7. Alertes, niveaux de service et qualité
8. Outils : Langfuse, les autres et l'inspecteur d'exécutions
Ce que vous saurez faire
Lisez la cascade d’une exécution d’agent : le sens de chaque ligne, l’étape lente et l’étape coûteuse. Trouvez où l’exécution a attendu et quelle étape a fait un changement. Puis lisez votre propre exécution de la même façon.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les spans (intervalles d’exécution), les traces et le parent d’un span, présentés dans Spans, traces et contexte.
- Les spans de modèle, d’outil et d’écriture, et les deux traces liées d’une exécution qui attend une personne, présentés dans Approbations, personnes et temps d’attente.
Ce qu’il vous faut sur votre ordinateur
- Le projet
~/projects/observable-workflowdans son état à la fin du module 3 : identique à l’instantanéend-of-m03.python -m pytest -qse termine par86 passed, 1 skipped, 1 deselected. - Un terminal ouvert dans le projet, avec l’environnement virtuel actif.
Cette leçon n’ajoute aucun fichier. Vous n’avez besoin ni de compte ni de Docker. Grafana est facultatif. Testé sur macOS (Apple silicon) avec Python 3.12.13. Les commandes sont les mêmes sur Windows et Linux, mais l’équipe du cours ne les y a pas exécutées.
La page de suivi d’un colis
Section intitulée « La page de suivi d’un colis »Vous commandez une lampe. Le magasin vous donne une page de suivi. Elle contient une ligne par événement. « Ramassé, lundi à 14 h 02. » « Arrivé au dépôt, lundi à 18 h 40. » « En livraison, mercredi à 8 h 15. » « Livré, mercredi à 11 h 30. » Vous ne voyez jamais le camion, mais vous pouvez lire le trajet.
Vous la lisez toujours de la même façon. Les lignes suivent l’ordre chronologique. L’espace entre deux lignes vous indique où le colis a attendu : une journée entière au dépôt, sans aucun changement. Si le colis arrive en retard, vous ne blâmez pas « le trajet ». Vous trouvez la ligne où le temps a passé.
La trace d’une exécution d’agent ressemble à cette page, avec une différence : vous la voyez sous forme graphique. Chaque étape est une barre sur un axe du temps.
Le problème : les totaux cachent l’étape
Section intitulée « Le problème : les totaux cachent l’étape »Au module 3, l’exécution R-1014-040 est devenue une trace. C’est le double remboursement du billet de soutien T-90104. Ses premières lignes donnent les totaux :
Run R-1014-040 | ticket T-90104 | chat-strong (agent_structured) | release 2.1.0 | language en2 model call(s), 1 read(s), 2 write call(s), 4586 tokens in, 265 out, US$0.01182Sam, qui a approuvé le remboursement, pose trois questions. « Quelle étape a pris du temps? Quelle étape a coûté de l’argent? Et pourquoi le client a-t-il attendu jusqu’au lendemain matin? » Les totaux ne répondent à aucune de ces questions. Le montant de 0,01182 $ US est la somme de deux appels de modèle. « 2 write call(s) » (2 appels d’écriture) n’indique pas lequel a produit le deuxième remboursement. Et les totaux ne contiennent pas du tout le temps d’attente.
Un total ressemble à un colis qui « a pris trois jours ». Pour corriger quoi que ce soit, il faut trouver l’étape.
L’idée : une cascade
Section intitulée « L’idée : une cascade »Une cascade représente une trace : une ligne par span, dans l’ordre chronologique. Chaque ligne contient une barre sur un axe du temps commun. La barre commence au début du span, et sa longueur indique la durée du span. Le nom vient de son apparence : les barres descendent vers la droite, comme de l’eau qui descend un escalier.
Cinq éléments d’une cascade ont besoin d’un nom :
- Le décalage indique quand un span a commencé, à partir du début de sa trace.
2.4 ssignifie 2,4 secondes après le début de l’exécution. - La durée indique combien de temps le span a duré. Une longue barre représente une étape lente.
- Le retrait montre le parent. Une ligne décalée vers la droite est un enfant de la ligne au-dessus. La première ligne, sans parent, est le span racine : ici, l’exécution complète de l’agent.
- Une erreur est un span dont l’état est
ERROR(erreur). Le détail qui suit indique pourquoi, par exempletimeout(délai dépassé). - Un intervalle vide est une période sans span. Rien ne s’est exécuté. Dans une exécution d’agent, cet intervalle correspond souvent à une attente : d’une personne ou du prochain message.
Deux autres éléments sont propres aux exécutions d’agents. Une nouvelle tentative appelle de nouveau le même outil après une erreur. Sa clé d’idempotence indique s’il s’agit de la même opération ou d’une nouvelle. Et un lien relie la deuxième trace d’une exécution à la première, de part et d’autre d’un intervalle vide.

Description textuelle du diagramme
La trace 1 compte cinq lignes. La première est le span d’exécution, de 6,56 secondes, qui représente tout le travail de l’agent. Sous ce span se trouvent deux appels de modèle de 2,39 et 4,17 secondes. La recherche de commande se trouve entre eux, suivie de la demande d’approbation. Le deuxième appel de modèle a coûté 0,00703 $ US, plus que toute autre étape. Vient ensuite un cadre pointillé : 15 heures 25 minutes sans span, pendant que l’exécution attendait une personne. La trace 2 commence par l’approbation de Sam, reliée à la demande d’approbation. Son premier appel de remboursement est rouge : une erreur, un dépassement du délai après 10,00 secondes. La ligne suivante est le même remboursement avec une nouvelle clé, terminé. La dernière ligne est la réponse, envoyée. Chaque trace a son propre axe du temps.
Exemple détaillé : lire R-1014-040 ligne par ligne
Section intitulée « Exemple détaillé : lire R-1014-040 ligne par ligne »Affichez la cascade complète du double remboursement à partir de la semaine enregistrée :
python -m obs trace R-1014-040 --data data/telemetry/weekRun R-1014-040 | ticket T-90104 | chat-strong (agent_structured) | release 2.1.0 | language en2 model call(s), 1 read(s), 2 write call(s), 4586 tokens in, 265 out, US$0.01182
Trace 1 f0433c4403e2767e1d69ece18a947526 Wed 14 Oct 17:52:00 6.6 s 0.0 s |========================| 6.56 s invoke_agent support-resolver resolve rule W2 0.0 s |========= | 2.39 s chat chat-strong 2160 in / 47 out US$0.00479 stop 2.4 s | = | 0.00 s execute_tool get_order ok LK-793996 2.4 s | ================| 4.17 s chat chat-strong 2426 in / 218 out US$0.00703 stop 6.6 s | =| 0.00 s approval.request needs agent
... waited 15 h 25 min for a person (this trace has a link to 78d246ee22e5f5ef in trace f0433c44...)Trace 2 15ba0d9388d1b9e001af373f21c4b955 Thu 15 Oct 09:17:12 10.0 s 0.0 s |========================| 10.01 s approve support-resolution approved by usr-sam (agent, limit 100) 0.0 s |========================| 10.00 s execute_tool request_refund ERROR timeout LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e 10.0 s | =| 0.00 s execute_tool request_refund done LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e-retry1 10.0 s | =| 0.00 s execute_tool send_reply sent
Outcome: resolvedLisez-la en quatre passages, comme la page de suivi.
Passage 1 : la forme. Il y a deux traces séparées par un intervalle vide. La trace 1 se termine par approval.request, donc l’exécution a demandé l’aide d’une personne. La trace 2 commence par approve (approuver), donc une personne a pris une décision. Dans ce flux de travail, une deuxième trace signifie toujours qu’une personne a pris une décision.
Passage 2 : l’étape lente. Cherchez la plus longue barre sous la racine. Dans la trace 1, le deuxième appel de modèle a pris 4,17 secondes sur 6,56 secondes : 4,17 ÷ 6,56 = 64 %. Dans la trace 2, le premier appel de remboursement a pris 10,00 secondes, et il est rouge. C’est l’étape la plus lente de toute l’exécution, et c’est une erreur. Les spans de modèle durent aussi longtemps que les appels enregistrés (l’horloge d’exécution du module 2). Les 10 secondes correspondent au délai maximal du service de paiement simulé.
Passage 3 : l’étape coûteuse. Ici, seuls les appels de modèle coûtent de l’argent. Chaque coût correspond aux jetons (tokens) × le prix de chat-strong dans la grille tarifaire du cours Agents d’IA et orchestration des flux de travail. Ce prix est de 2,00 $ US par million de jetons en entrée et de 10,00 $ US par million en sortie.
| Appel de modèle | Jetons en entrée × prix | Jetons en sortie × prix | Coût |
|---|---|---|---|
| 1 | 2 160 × 2,00 ÷ 1 000 000 = 0,00432 | 47 × 10,00 ÷ 1 000 000 = 0,00047 | 0,00479 $ US |
| 2 | 2 426 × 2,00 ÷ 1 000 000 = 0,00485 | 218 × 10,00 ÷ 1 000 000 = 0,00218 | 0,00703 $ US |
Le deuxième appel est l’étape coûteuse : 0,00703 ÷ 0,01182 = 59 % du coût de l’exécution. Il a lu davantage (les détails de commande de get_order ont été ajoutés à la conversation). Il a aussi écrit davantage (la proposition et le brouillon de réponse). Les jetons de sortie coûtent cinq fois plus que les jetons d’entrée.
Passage 4 : les intervalles vides et les changements. La plus longue période de cette exécution n’est pas une barre. C’est l’intervalle vide : 15 h 25 minutes, du mercredi à 17 h 52 au jeudi à 9 h 17. Pour le client, c’était tout le délai. Un tableau de bord des durées des spans ne le montrerait jamais, car un intervalle vide n’est pas un span. Le flux de travail enregistre plutôt l’attente comme un attribut (larkfield.approval.wait_s, présenté au module 3).
Cherchez ensuite les écritures. La trace 2 contient deux lignes request_refund. La première a dépassé le délai. La deuxième a une nouvelle clé, 797fbb5bbb9f8a7e-retry1, et elle est terminée. Son parent est approve support-resolution, pas un appel de modèle. Aucun modèle n’a donc demandé le deuxième remboursement. Le code de nouvelle tentative du flux de travail l’a envoyé avec une nouvelle clé. Le service de paiement a alors effectué un deuxième remboursement.
Sam a maintenant les réponses. L’étape lente est l’appel de remboursement qui a dépassé le délai. L’étape coûteuse est le deuxième appel de modèle. L’attente d’une personne a duré 15 h 25 minutes. Et l’étape qui a causé le deuxième remboursement est la nouvelle tentative, pas le modèle.
Explorer la cascade
Section intitulée « Explorer la cascade »Explorer
Lire une exécution : l'étape lente, l'étape coûteuse et l'attente
Prédisez d’abord : Dans l'exécution R-1014-040, quelle étape a causé le deuxième remboursement : un appel de modèle, une personne ou une autre étape? Notez le nom du span.
- Exécution
- R-1014-040 · ticket T-90104 · chat-strong · version 2.1.0
- Preuve
- replayed decision; simulated timeout and naive retry
- Résultat
- resolved
- Étapes
- 2 appels au modèle, 4 appels d’outil
- Jetons en entrée / sortie · coût
- 4586 / 265 · US$0,01182
- Étape la plus lente
- execute_tool request_refund, 10,00 s (à Thu 09:17:12)
- Étape la plus coûteuse
- chat chat-strong, 0,00703 $ US (59 % de l’exécution)
- Attente d’une personne
- 15 h 25 min
- Signalements (obs)
- duplicate_write
Choisissez une exécution, puis ouvrez une ligne de la cascade pour lire ses attributs.
Ouvrez une ligne pour lire les attributs du span.
Trace 1 · Wed 14 Oct 17:52:00 · 6,6 s
invoke_agent support-resolver resolve · rule W26,56 s
- gen_ai.request.model
- chat-strong
- gen_ai.usage.input_tokens
- 4586
- gen_ai.usage.output_tokens
- 265
- larkfield.cost.usd
- 0.011822
- larkfield.proposal.outcome
- resolve
- larkfield.proposal.rule
- W2
- larkfield.stop_reason
- finished
- larkfield.release
- 2.1.0
chat chat-strong 2160 in / 47 out · US$0,004792,39 s
- gen_ai.request.model
- chat-strong
- gen_ai.response.model
- gpt-6.1-sol-2026-09-29
- gen_ai.usage.input_tokens
- 2160
- gen_ai.usage.output_tokens
- 47
- gen_ai.response.finish_reasons
- stop
- larkfield.cost.usd
- 0.00479
- larkfield.model.requested
- get_order(order_id)
execute_tool get_order ok0,00 s
- gen_ai.tool.name
- get_order
- larkfield.tool.kind
- read
- larkfield.tool.status
- ok
- larkfield.order.id
- LK-793996
chat chat-strong 2426 in / 218 out · US$0,007034,17 s
- gen_ai.request.model
- chat-strong
- gen_ai.response.model
- gpt-6.1-sol-2026-09-29
- gen_ai.usage.input_tokens
- 2426
- gen_ai.usage.output_tokens
- 218
- gen_ai.response.finish_reasons
- stop
- larkfield.cost.usd
- 0.007032
- larkfield.model.requested
- finish(-)
approval.request needs agent0,00 s
- larkfield.approval.needs_role
- agent
- larkfield.approval.limit
- 100
attente de 15 h 25 min pour une personne : une pause, pas un span. La trace 2 commence par un lien vers approval.request dans la trace 1.
Trace 2 · Thu 15 Oct 09:17:12 · 10,0 s
approve support-resolution approved by usr-sam (agent)10,01 s
- larkfield.approval.approver
- usr-sam
- larkfield.approval.role
- agent
- larkfield.approval.limit
- 100
- larkfield.approval.wait_s
- 55505.4
- larkfield.outcome
- resolved
- larkfield.writes_done
- 1
- larkfield.release
- 2.1.0
execute_tool request_refund ERREUR timeout · 9.95 RFD-LATE · key 797fbb5bbb9f8a7e10,00 s
- gen_ai.tool.name
- request_refund
- larkfield.tool.kind
- write
- larkfield.write.outcome
- timeout
- larkfield.idempotency_key
- 797fbb5bbb9f8a7e
- larkfield.operation.id
- 797fbb5bbb9f8a7e
- larkfield.order.id
- LK-793996
- larkfield.refund.amount
- 9.95
- larkfield.refund.reason
- RFD-LATE
- error.type
- timeout
execute_tool request_refund done · 9.95 RFD-LATE · key 797fbb5bbb9f8a7e-retry10,00 s
- gen_ai.tool.name
- request_refund
- larkfield.tool.kind
- write
- larkfield.write.outcome
- done
- larkfield.idempotency_key
- 797fbb5bbb9f8a7e-retry1
- larkfield.operation.id
- 797fbb5bbb9f8a7e
- larkfield.order.id
- LK-793996
- larkfield.refund.amount
- 9.95
- larkfield.refund.reason
- RFD-LATE
execute_tool send_reply sent0,01 s
- gen_ai.tool.name
- send_reply
- larkfield.tool.kind
- write
- larkfield.tool.status
- ok
- larkfield.reply.status
- sent
Chaque trace a sa propre échelle de temps.
Description textuelle de l’explorateur
Choisissez une des quatre exécutions de la semaine enregistrée. Le résumé indique l’exécution, comment ses éléments de preuve ont été produits et son résultat. Il indique aussi les étapes, les jetons et le coût, l’étape la plus lente, l’étape la plus coûteuse et l’attente d’une personne. La cascade se trouve en dessous, avec une ligne par span. Ouvrez une ligne pour lire ses attributs. R-1014-040, le double remboursement : l’étape la plus lente est execute_tool request_refund, 10,00 secondes, jeudi à 9 h 17 min 12 s. La plus coûteuse est chat chat-strong, 0,00703 $ US, soit 59 % du coût de l’exécution. L’attente dure 15 h 25 minutes. Sa deuxième ligne request_refund a la clé 797fbb5bbb9f8a7e-retry1 et son parent est l’approbation, pas un appel de modèle. R-1012-034, le même billet avec chat-small : une trace, 3,00 secondes, 0,00055 $ US, aucune attente; l’agent a posé une question au client. Pour R-1018-010, avec le modèle local gemma3:4b, le résumé montre 7 appels de modèle en 19,7 secondes. Son étape la plus lente est un appel de modèle de 6,22 secondes. Il contient une erreur sur get_payments et aucun coût, car le prix du modèle local est fixé à 0 $ US (une hypothèse). R-1018-022 : l’étape la plus lente est un appel get_order qui a échoué après avoir dépassé le délai de 10,00 secondes.
Ouvrez la deuxième ligne request_refund de R-1014-040 dans l’explorateur. Ses attributs montrent larkfield.write.outcome: done (résultat de l’écriture : terminé) et la nouvelle clé. Ouvrez ensuite la première : error.type: timeout (type d’erreur : délai dépassé). La réponse à la question de prédiction se trouve dans ces deux lignes.
Le même billet, une exécution moins coûteuse
Section intitulée « Le même billet, une exécution moins coûteuse »Lundi, avant qu’Omar passe à chat-strong pour les billets difficiles, le même billet a été traité avec chat-small. Lisez cette exécution :
python -m obs trace R-1012-034 --data data/telemetry/weekRun R-1012-034 | ticket T-90104 | chat-small (agent) | release 2.0.0 | language en2 model call(s), 1 read(s), 0 write call(s), 4565 tokens in, 179 out, US$0.00055
Trace 1 3a6cd2cce257c77ab2a0ae8dd9d5841d Mon 12 Oct 15:31:37 3.0 s 0.0 s |========================| 3.00 s invoke_agent support-resolver ask_customer rule W3 0.0 s |======== | 1.05 s chat chat-small 2163 in / 21 out US$0.00023 tool_calls 1.1 s | = | 0.01 s execute_tool get_order ok LK-793996 1.1 s | ================| 1.95 s chat chat-small 2402 in / 158 out US$0.00032 tool_calls 3.0 s | =| 0.00 s execute_tool send_reply sent
Outcome: asked_customerLa forme est presque la même : deux appels de modèle avec une recherche entre eux. Mais il y a une trace, pas deux. Le modèle a choisi la règle W3 et posé une question au client. Aucune approbation ni écriture n’était donc nécessaire. L’exécution a coûté 0,00055 $ US, environ 22 fois moins que R-1014-040.
Est-ce que moins coûteux signifie mieux ici? Non. Selon les étiquettes du cours, ce billet nécessitait un remboursement (règle W2). Pourtant, chat-small a plutôt posé une question au client. La cascade montre ce que l’exécution a fait et ce qu’elle a coûté. Elle ne montre pas si la décision était correcte. Il faut une révision ou une étiquette pour le savoir, comme le montre le module 7.
Le modèle local de Larkfield : lent et « gratuit »
Section intitulée « Le modèle local de Larkfield : lent et « gratuit » »Pendant la fin de semaine, Tomás a envoyé 30 % des billets au modèle local gemma3:4b. Lisez une de ses exécutions :
python -m obs trace R-1018-010 --data data/telemetry/weekRun R-1018-010 | ticket T-90602 | gemma3:4b (agent_structured) | release 2.1.1 | language en7 model call(s), 3 read(s), 0 write call(s), 17582 tokens in, 542 out, US$0.00000
Trace 1 bf5b941801388658eaa36cf0bba32133 Sun 18 Oct 11:15:00 19.7 s 0.0 s |========================| 19.72 s invoke_agent support-resolver reply_only rule double charge 0.0 s |== | 1.68 s chat gemma3:4b 1898 in / 45 out US$0.00000 stop 1.7 s | = | 0.00 s execute_tool get_order ok LK-645112 1.7 s | == | 1.99 s chat gemma3:4b 2231 in / 41 out US$0.00000 stop 3.7 s | = | 0.20 s execute_tool get_payments ERROR service_unavailable LK-645112 3.9 s | === | 1.50 s chat gemma3:4b 2322 in / 42 out US$0.00000 stop 5.4 s | === | 1.69 s chat gemma3:4b 2412 in / 47 out US$0.00000 stop 7.1 s | = | 0.00 s execute_tool search_policy ok 7.1 s | === | 2.08 s chat gemma3:4b 2768 in / 42 out US$0.00000 stop 9.1 s | ======== | 6.22 s chat gemma3:4b 2858 in / 195 out US$0.00000 stop 15.4 s | ======| 4.36 s chat gemma3:4b 3093 in / 130 out US$0.00000 stop 19.7 s | =| 0.00 s execute_tool send_reply sent
Outcome: resolvedCette exécution contient sept appels de modèle en 19,7 secondes. L’étape la plus lente est un appel de modèle de 6,22 secondes. Le coût est de 0 $ US à chaque ligne, car le cours fixe le prix du modèle local à zéro. C’est une hypothèse : l’ordinateur, son électricité et sa mémoire ne sont pas comptés. Pour cette exécution, « l’étape coûteuse » ne peut donc désigner que le temps. Avec un prix de zéro, un panneau des coûts présenterait le modèle le plus lent comme le moins coûteux.
Il y a aussi une ligne rouge : get_payments a échoué avec service_unavailable (service indisponible) à 3,7 secondes. Aucun appel get_payments ultérieur n’a réussi. Pourtant, l’exécution s’est terminée par une réponse et le résultat resolved (résolu). Gardez cette ligne en tête. Dans la troisième leçon de ce module, elle porte un nom.
Lire une exécution dans Grafana
Section intitulée « Lire une exécution dans Grafana »Cette partie est facultative et nécessite Docker. Grafana ne montre que ce que le flux de travail lui envoie. Envoyez-lui donc d’abord une semaine. Le programme de simulation de la semaine de Le Collector rejoue les 316 exécutions avec le code de votre projet, par le Collector dans le conteneur de Grafana :
- Démarrez Grafana depuis le dossier du projet :
docker compose -f grafana/compose.yaml up -d. Le premier démarrage télécharge aussi l’image : environ 0,9 Go, et 3,5 Go sur disque. Sur le portable de l’équipe du cours, l’ensemble des services était ensuite prêt en 4 à 52 secondes. Le délai était le plus long quand le portable était occupé. - Envoyez la semaine :
python -m scenarios week --otlp --out work/week. La commande rejoue la semaine à une vitesse multipliée par 1 000. Une journée d’exercice dure donc environ 86 secondes. Sur le portable de l’équipe du cours, cela a pris 638 à 639 secondes lors de deux exécutions. - Ouvrez Grafana à l’adresse
http://localhost:3031. - Quand vous n’en avez plus besoin, arrêtez-le et supprimez ses données :
docker compose -f grafana/compose.yaml down -v.
La même cascade se trouve dans la vue des traces de Grafana. Ouvrez Explore (explorer), choisissez la source de données Tempo et le type de requête TraceQL. Cherchez ensuite toutes les traces du billet :
{ span.larkfield.ticket.id = "T-90104" }Cliquez sur un identifiant de trace pour ouvrir sa cascade. Grafana dessine les mêmes lignes, barres et retraits, avec une ligne d’aperçu au-dessus. Il marque les spans d’erreur avec une icône rouge. Ses boutons de filtre Errors (erreurs) et High latency (latence élevée) font les passages 2 et 4 pour vous. Ils gardent seulement les lignes rouges ou seulement les longues lignes. Grafana montre une trace à la fois. Vous suivez donc vous-même le lien de la trace 2 vers la trace 1. Vos temps diffèrent de ceux de la semaine enregistrée : chaque reprise a sa propre horloge d’exécution.
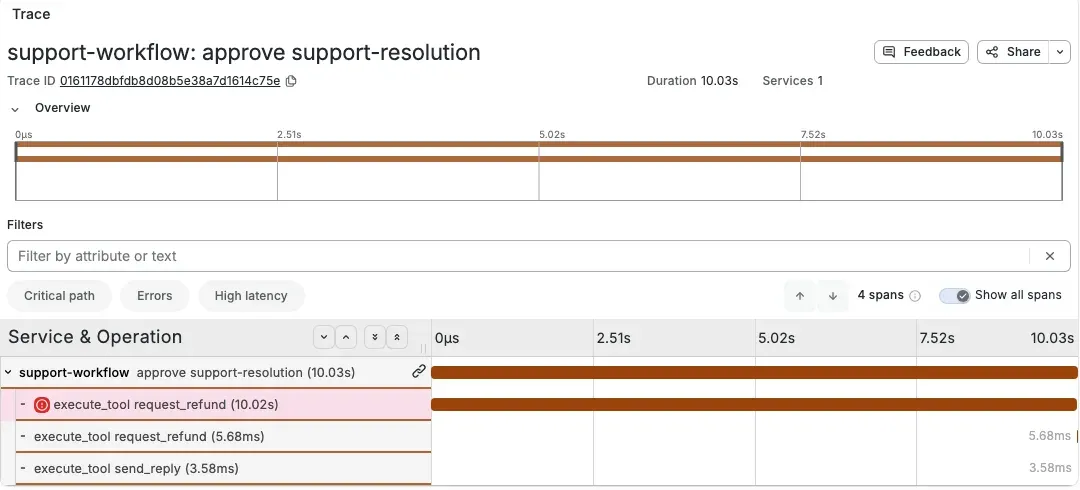
Exercice guidé : lire votre propre exécution
Section intitulée « Exercice guidé : lire votre propre exécution »Produisez maintenant le double remboursement vous-même. Lisez son diagramme en cascade avant et après l’approbation.
-
Exécutez le billet comme le faisait la version 2.1.0 :
Fenêtre de terminal python -m resolver run T-90104 --variant agent_structured --model chat-strongLa dernière ligne :
Nothing has changed yet. Next: python -m resolver approve T-90104-agent_structured-chat-strong-1 --as agent (or: reject) -
Lisez maintenant le diagramme en cascade de votre exécution, pendant qu’elle attend :
Fenêtre de terminal python -m obs trace T-90104Run T-90104-agent_structured-chat-strong-1 | ticket T-90104 | chat-strong (agent_structured) | release 2.0.0 | language en2 model call(s), 1 read(s), 0 write call(s), 4586 tokens in, 265 out, US$0.00000Trace 1 … 6.6 s0.0 s |========================| 6.56 s invoke_agent support-resolver resolve rule W20.0 s |========= | 2.39 s chat chat-strong 2160 in / 47 out - stop2.4 s | = | 0.00 s execute_tool get_order ok LK-7939962.4 s | ================| 4.17 s chat chat-strong 2426 in / 218 out - stop6.6 s | =| 0.00 s approval.request needs agentOutcome: waiting_approvalUne trace, avec le résultat
waiting_approval(en attente d’approbation). Votre identifiant de trace et votre heure diffèrent. Le coût affiche-: vos spans n’ont pas encore de coût, car le module 5 ajoute les coûts aux spans. La semaine sauvegardée a été enregistrée avec ces coûts. La version indique2.0.0, la valeur par défaut deOBS_RELEASE. -
Approuvez l’exécution en tant que Sam, avec le service de paiement lent et la nouvelle tentative naïve :
Fenêtre de terminal python -m resolver approve T-90104-agent_structured-chat-strong-1 --as agent --name Sam --fault request_refund:timeout_after_write --naive-retryrequest_refund LK-793996: done (operation 797fbb5bbb9f8a7e, 2 call(s))Status: doneReply sent. Ticket: resolved. -
Relisez le diagramme en cascade :
Fenêtre de terminal python -m obs trace T-90104La fin de la sortie :
... waited 0 min 00 s for a person (this trace has a link to … in trace …)Trace 2 … 10.0 s0.0 s |========================| 10.00 s approve support-resolution approved by usr-sam (agent, limit 100)0.0 s |========================| 10.00 s execute_tool request_refund ERROR timeout LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e10.0 s | =| 0.00 s execute_tool request_refund done LK-793996 9.95 RFD-LATE key 797fbb5bbb9f8a7e-retry110.0 s | =| 0.00 s execute_tool send_reply sentOutcome: resolved -
Faites les quatre lectures de votre propre sortie et vérifiez cinq points. La structure comprend deux traces. L’étape lente est le remboursement dont le délai a expiré. L’étape coûteuse est le deuxième appel de modèle (2 426 jetons en entrée, 218 en sortie). L’intervalle est presque nul, car vous avez approuvé tout de suite. Et la clé du deuxième remboursement se termine par
-retry1.
Les étapes sont les mêmes que celles de la semaine sauvegardée, car les décisions du modèle proviennent des mêmes enregistrements. Seules l’heure et l’attente diffèrent.
Erreur courante
Le diagramme en cascade ne contient qu'une trace, sans remboursement
Symptôme : python -m obs trace T-90104 affiche seulement la trace 1, avec Outcome: waiting_approval (résultat : en attente d’approbation). Il n’y a aucune ligne request_refund (demander un remboursement). Vous ne pouvez donc pas trouver le deuxième remboursement.
Cause : l’exécution attend encore une personne. La trace 2 n’existe pas avant que quelqu’un approuve ou rejette la proposition. C’est le diagramme en cascade d’une exécution qui n’est pas terminée.
Diagnostic : regardez la dernière ligne et le résultat. Une dernière ligne approval.request (demande d’approbation) et le résultat waiting_approval signifient « en attente ».
Correction : approuvez l’exécution (étape 3 ci-dessus), puis relisez la trace. En situation réelle, une exécution peut attendre des heures, comme R-1014-040. Ne confondez pas une exécution en attente avec une exécution qui a échoué.
Erreur courante
Une longue barre dans la trace 2 paraît plus courte qu'une courte barre dans la trace 1
Symptôme : dans une image d’une exécution à deux traces, une barre de 10 secondes semble aussi courte qu’une de 6 secondes.
Cause : chaque trace a sa propre échelle de temps. obs, Grafana et l’explorateur ajustent tous les barres à l’échelle de leur propre trace. Une échelle commune placerait un intervalle de 15 heures entre les traces. Chaque barre serait alors trop mince pour être visible.
Correction : entre les traces, comparez les durées à partir des nombres, pas des barres. Comparez les barres seulement à l’intérieur d’une même trace.
À vous de jouer : trouver l’étape lente d’une autre exécution
Section intitulée « À vous de jouer : trouver l’étape lente d’une autre exécution »Changez une condition : choisissez une exécution où l’étape lente est un appel d’outil, et non un appel de modèle.
-
Prédisez : l’exécution R-1018-022 utilise gemma3:4b pour le billet T-90601, le dimanche soir. Son span racine a duré 22,5 s. L’étape la plus lente sera-t-elle un appel de modèle ou un appel d’outil? Quelle part des 22,5 s prendra-t-elle?
-
Lisez-la :
Fenêtre de terminal python -m obs trace R-1018-022 --data data/telemetry/week -
Faites les quatre lectures et comparez avec votre prédiction.
Vérifiez votre prédiction
La sortie du cours (décisions rejouées, expiration du délai du service de commandes simulée) :
Trace 1 cec6ea30d7d9124ef43d05a927af8e14  Sun 18 Oct 17:00:31  22.5 s     0.0 s |========================|  22.51 s  invoke_agent support-resolver  reply_only  rule W1     0.0 s |==                      |   1.70 s    chat gemma3:4b  1894 in / 45 out  US$0.00000  stop     1.7 s | ===========            |  10.00 s    execute_tool get_order  ERROR service_timeout  LK-645001    11.7 s |            =======     |   6.43 s    chat gemma3:4b  1986 in / 202 out  US$0.00000  stop    18.1 s |                   =    |   0.00 s    execute_tool get_customer_orders  ok    18.1 s |                   =====|   4.38 s    chat gemma3:4b  2253 in / 130 out  US$0.00000  stop    22.5 s |                       =|   0.00 s    execute_tool send_reply  sent
Outcome: resolved
L’étape la plus lente est un appel d’outil : get_order (obtenir la commande) a attendu 10,00 s. Il a ensuite échoué avec service_timeout (délai du service expiré). Cela représente 10,00 ÷ 22,51 = 44 % de l’exécution. Le modèle a plutôt cherché les commandes du client, puis a répondu. Il y a une seule trace et aucun intervalle, car la réponse ne nécessitait pas d’approbation. Le coût est de 0 $ US (le prix supposé du modèle local). Dans cette exécution, l’étape lente est donc une erreur, et rien dans le résultat final ne l’indique.
Quand lire un diagramme en cascade, et ce que cela coûte
Section intitulée « Quand lire un diagramme en cascade, et ce que cela coûte »Lisez un diagramme en cascade quand vous avez une exécution et une question à son sujet. Pourquoi était-elle lente? Pourquoi a-t-elle coûté ce montant? Pourquoi a-t-elle fait ces changements? C’est l’enregistrement le plus détaillé dont vous disposez pour suivre le parcours d’une exécution.
Ce n’est pas le bon outil pour une semaine entière. Une lecture attentive prend quelques minutes. La semaine sauvegardée compte 316 exécutions réparties dans 434 traces. Un diagramme en cascade ne peut pas non plus vous dire si une décision était bonne. Il ne montre pas les mots du modèle, car la capture du contenu est désactivée. Une trace peut aussi manquer : l’échantillonnage en fin de trace du Collector ne conserve que certaines traces. La prochaine leçon cherche dans plusieurs exécutions à la fois.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Dans le diagramme en cascade de R-1014-040, quelle ligne est l'étape lente, quelle est l'étape coûteuse et où se trouve la longue attente du client? Donnez le nombre pour chacune.
Afficher la réponse
L’étape lente est la première ligne execute_tool request_refund de la trace 2 : 10,00 s, une erreur (délai expiré). L’étape coûteuse est la deuxième ligne chat chat-strong de la trace 1 : 0,00703 $ US sur 0,01182 $ US, soit 59 %. Elle comptait 2 426 jetons en entrée et 218 en sortie. La longue attente du client n’est pas une ligne. C’est l’intervalle de 15 h 25 min entre les deux traces, pendant que l’exécution attendait une personne.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Quel span a causé le deuxième remboursement de R-1014-040, et comment savez-vous qu'aucun modèle ne l'a demandé?
Afficher la réponse
Le deuxième span execute_tool request_refund de la trace 2, avec la clé 797fbb5bbb9f8a7e-retry1 et le résultat done (terminé). Son parent est approve support-resolution, la décision de la personne. Il commence juste après l’expiration du délai du premier appel de remboursement. Aucun span chat ne se trouve entre les deux. C’est donc le code de nouvelle tentative du flux de travail qui l’a envoyé, pas le modèle. Sa nouvelle clé a amené le service de paiement à le traiter comme un nouveau remboursement.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
L'exécution R-1018-010 a coûté 0,00000 $ US. Pourquoi ne pouvez-vous pas dire que c'est l'exécution la moins coûteuse de la fin de semaine?
Afficher la réponse
Son coût est nul seulement parce que le cours fixe le prix du modèle local gemma3:4b à 0 $ US. C’est une hypothèse. Le matériel, l’électricité et la mémoire ne sont pas comptés. En durée, c’était l’une des exécutions les plus lentes : sept appels de modèle en 19,7 s. Sans prix réel pour le modèle local, le coût d’une exécution sur ce modèle ne dit rien.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un diagramme en cascade contient une ligne par span, en ordre chronologique. Lisez le décalage, la durée, le retrait (le parent), les erreurs et les intervalles.
- Faites quatre lectures : la structure (une trace ou deux), l’étape lente, l’étape coûteuse, puis les intervalles et les écritures.
- Dans R-1014-040, l’étape lente est le remboursement dont le délai a expiré (10,00 s). L’étape coûteuse est le deuxième appel de modèle (0,00703 $ US, 59 %). L’attente est un intervalle de 15 h 25 min. La nouvelle tentative avec une nouvelle clé, et non le modèle, a causé le deuxième remboursement.
- Le coût du modèle local est nul par hypothèse. Son « étape coûteuse » ne peut donc se mesurer qu’en temps.
Votre projet n’a pas changé : il correspond toujours à l’instantané end-of-m03. Vous pouvez maintenant lire une exécution et trouver son étape lente, son étape coûteuse et ses changements. Mais la semaine sauvegardée compte 316 exécutions, et vous ne pouvez pas les ouvrir une par une. Ensuite, vous cherchez des exécutions selon leur structure avec TraceQL. Vous cherchez plusieurs appels au même outil, une écriture sans approbation et une erreur suivie d’un résultat résolu.
Leçon suivante : Chercher des exécutions avec TraceQL