
Saisie semi-automatique
- Leçon 23
- 35 min
- Module 7 : Les parties de la recherche que les gens voient
Où nous en sommes
Notre classement est maintenant mesuré et bien meilleur. Les gens voient la recherche avant de finir de taper. Dans cette leçon, nous créons la saisie semi-automatique à partir du journal des requêtes et du catalogue. Nous retirons aussi les suggestions qui mènent à des pages mauvaises ou vides.
Leçon 23 sur 30 · Recherche et classement : trouver la meilleure correspondanceSaisie semi-automatique
1. Le problème de la recherche
2. Mesurer la pertinence avant de changer quoi que ce soit
3. La recherche lexicale : la référence de base à battre
4. Comprendre la requête
5. La recherche dense et la recherche hybride
6. Reclasser les premiers résultats
7. Les parties de la recherche que les gens voient
8. Exploiter la recherche en production
Ce que vous saurez faire
Suggérez des requêtes complètes pendant la saisie, à partir de recherches qui ont fonctionné. Écartez les suggestions qui mènent à des pages vides ou mauvaises.
Carnet JupyterCréer la saisie semi-automatique dans un carnet
Le carnet (notebook) Jupyter crée des suggestions à partir du journal synthétique, avec une liste triée et une recherche binaire. Vous mesurez la fréquence à laquelle la bonne requête apparaît après trois lettres. Vous listez aussi les recherches à ne jamais suggérer. Ses cellules de préparation téléchargent les données, donc aucune préparation locale n’est nécessaire. Environ 35 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le journal synthétique des requêtes et ses clics, présentés dans Découvrir le catalogue et le journal des requêtes.
- Pourquoi les clics proviennent uniquement des produits affichés, expliqué dans Apprendre des clics.
Ce qu’il vous faut sur votre ordinateur
- Le projet
larkfield-searchavec son environnement virtuel actif, et le dépôt des laboratoires à côté, comme dans les modules précédents. - Le modèle de classement de Apprentissage du classement, entraîné avec
search ltr train. Si vous avez exécutésearch resetdepuis, entraînez-le à nouveau : cela prend quelques secondes. - Cette leçon copie les huit fichiers du module depuis l’instantané
end-of-m07. Ils ne nécessitent aucun nouveau paquet.
Les parties de la recherche que les gens voient
Section intitulée « Les parties de la recherche que les gens voient »Les modules 2 à 6 ont amélioré le classement. Les gens ne voient jamais une mesure de classement. Ils voient une page : une boîte de recherche, une liste de produits et des moyens de réduire cette liste. Ce module crée les parties de cette page, une par leçon.
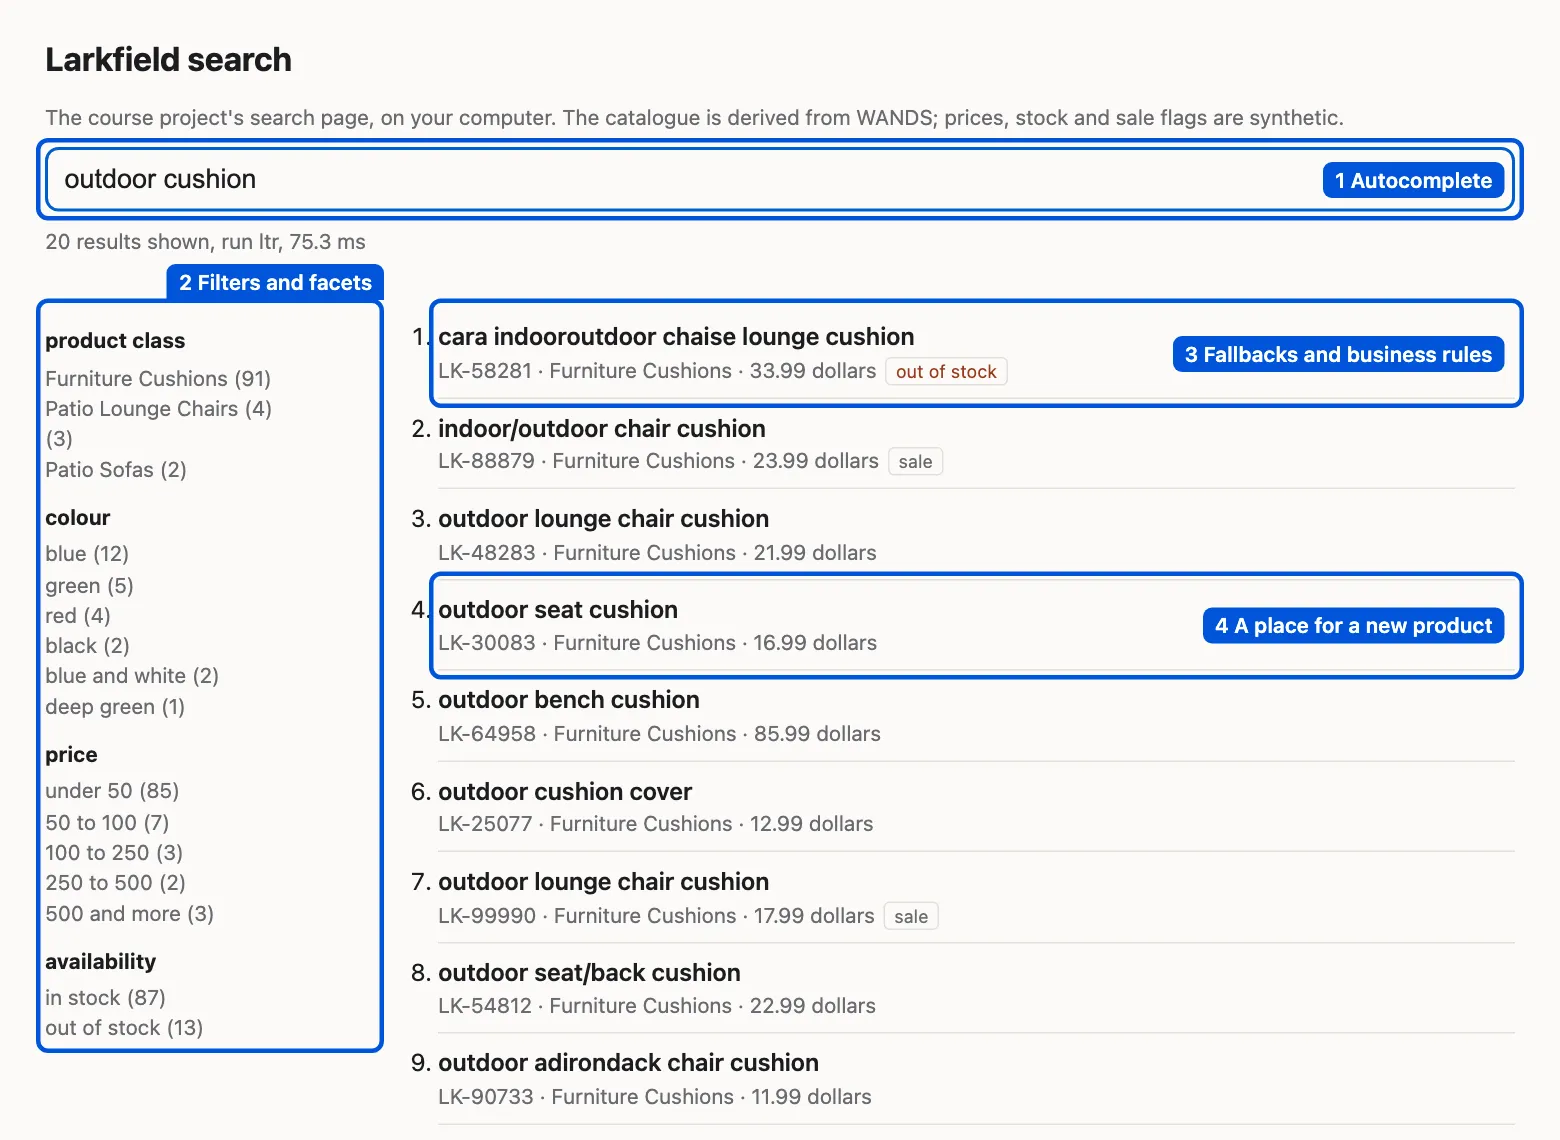
- Saisie semi-automatique, cette leçon : des suggestions pendant la saisie.
- Filtres et facettes : les nombres par couleur, prix et classe, et des filtres qui ne donnent jamais de page vide.
- Aucun résultat et règles d’affaires : quoi afficher sans correspondance, et le coût d’une règle comme « articles en solde d’abord ».
- Nouveaux produits et démarrage à froid : une place sur la page pour les produits qui n’ont pas encore de clics.
La page est volontairement petite et simple. C’est un outil pour voir vos changements, pas une boutique. Les prix, les stocks et les indicateurs de solde sont synthétiques : notre code les a créés.
Une vendeuse qui termine votre phrase
Section intitulée « Une vendeuse qui termine votre phrase »Un client arrive au comptoir et dit : « Je cherche un gar… ». Une bonne vendeuse n’attend pas. Elle dit : « Un garde-robe? Ou un support de rangement pour le garage? » Elle a souvent entendu ces demandes. Elle propose les plus courantes d’abord, et jamais un produit que la boutique ne vend pas.
La saisie semi-automatique fait le même travail dans une boîte de recherche. Elle devine la requête complète à partir des premières lettres.
Le problème : les gens tapent des requêtes qui échouent
Section intitulée « Le problème : les gens tapent des requêtes qui échouent »Dans le journal synthétique, 30,9 % des recherches n’ont rien trouvé avec la recherche actuelle de Larkfield. Beaucoup ont échoué à cause du texte saisi. « ligth bulb » a été recherché 139 fois sans jamais trouver de produit. « canapé » a été recherché 79 fois, avec le même résultat.
Une bonne suggestion évite ce problème dès le départ. Une personne qui tape « lig » et voit « light bulbs » choisira probablement la suggestion. Mais un système de suggestions mal conçu peut aussi aggraver la situation. Supposons que nous suggérons tous les textes du journal, selon leur fréquence de saisie. Alors « lig » suggérerait « ligth bulb » d’abord, et mènerait les gens directement à une page vide.
Il nous faut donc deux choses. D’abord, un moyen rapide de trouver les textes qui commencent par les lettres tapées. Ensuite, des règles pour choisir les textes qui peuvent devenir des suggestions.
L’idée : suggérer des requêtes qui ont fonctionné
Section intitulée « L’idée : suggérer des requêtes qui ont fonctionné »La saisie semi-automatique (aussi appelée suggestions de requêtes) affiche une courte liste de requêtes complètes pendant la saisie. Chaque suggestion vient d’une source :
- Le journal des requêtes. Des textes que d’autres personnes ont recherchés et qui ont mené à un clic. Un clic indique que la recherche a trouvé quelque chose que la personne voulait.
- Le catalogue. Les noms des classes de produits, comme « garden statues » ou « table lamps ». Ils trouvent toujours des produits.
Chaque suggestion a un poids : il représente sa qualité. Pour une requête du journal, le poids est le nombre de recherches qui ont obtenu un clic. Pour un nom de classe, c’est 1 par tranche de 20 produits de la classe (au moins 1).
Pour trouver rapidement des suggestions, nous utilisons un index de préfixes. Un préfixe est le début d’un mot ou d’un texte : « gar » est un préfixe de « garden statues ». L’index est simplement la liste des textes des suggestions, en ordre alphabétique. Dans une liste triée, tous les textes qui commencent par « gar » sont côte à côte. Il suffit donc de trouver le premier.
Un petit exemple détaillé
Section intitulée « Un petit exemple détaillé »Prenez cinq suggestions et leurs poids :
| Texte | Poids |
|---|---|
| game chairs | 2 |
| garage sports storage rack | 37 |
| garden accents | 4 |
| garden statues | 12 |
| gas detector | 13 |
Le tableau est déjà trié. Une personne tape « gar ». Nous cherchons le premier texte qui ne précède pas « gar » en ordre alphabétique. « game chairs » précède « gar », car « m » précède « r ». Ce n’est pas le cas de « garage sports storage rack ». Les correspondances commencent donc à la position 1 (Python compte à partir de 0).
Ensuite, nous continuons tant que le texte commence par « gar » : « garage sports storage rack », « garden accents », « garden statues ». « gas detector » ne commence pas par « gar », donc nous arrêtons. Enfin, nous trions les trois correspondances par poids : 37, 12, 4.
Voici la même chose en Python. Tapez les lignes après >>> dans python :
>>> import bisect>>> weights = {"game chairs": 2, "garage sports storage rack": 37, "garden statues": 12, "garden accents": 4, "gas detector": 13}>>> keys = sorted(weights)>>> keys['game chairs', 'garage sports storage rack', 'garden accents', 'garden statues', 'gas detector']>>> i = bisect.bisect_left(keys, "gar")>>> i1>>> found = []>>> while i < len(keys) and keys[i].startswith("gar"):... found.append(keys[i])... i += 1...>>> found['garage sports storage rack', 'garden accents', 'garden statues']>>> sorted(found, key=lambda t: -weights[t])['garage sports storage rack', 'garden statues', 'garden accents']bisect.bisect_left fait une recherche binaire. Elle examine le milieu de la liste, garde la moitié où « gar » doit se trouver, puis recommence. Chaque étape divise la liste par deux. Une liste de 1 000 textes demande donc seulement environ 10 étapes. Voilà pourquoi une liste triée suffit pour Larkfield : aucune structure de données spéciale n’est nécessaire.
L’index réel
Section intitulée « L’index réel »Le projet fait exactement cela avec 1 046 suggestions : 500 requêtes du journal avec un clic et 546 textes supplémentaires tirés des noms de classes de produits. Le schéma montre la vraie liste autour de « gar ».

Description textuelle du diagramme
À gauche, une partie de la liste triée de 1 046 suggestions, avec le poids de chaque texte. Les lignes 399 et 400 sont « game chairs » (2) et « game table accessories » (1). Les lignes 401 à 406 sont surlignées : garage sports storage (1), garage sports storage rack (37), garage storage cabinets (1), garden accents (4), garden statues (12), garlands & swag (1). Puis viennent « gas » (2) et « gas detector » (13). Une flèche part de « Recherche binaire de gar » vers la première ligne surlignée. Un second cadre liste les six correspondances triées par poids : garage sports storage rack (37), garden statues (12), garden accents (4), garage sports storage (1), garage storage cabinets (1), garlands & swag (1).
Écarter les mauvaises suggestions
Section intitulée « Écarter les mauvaises suggestions »Une suggestion promet que la recherche fonctionne. Une requête du journal doit donc réussir trois tests.
- Elle a mené à un clic au moins une fois. Un texte sans aucun clic n’est pas une requête éprouvée.
- Elle n’a jamais renvoyé de page vide. Si une seule recherche de ce texte n’a rien trouvé, le texte est exclu.
- Le correcteur orthographique ne changerait aucun de ses mots. « ligth » serait corrigé en « light », donc un texte contenant « ligth » est exclu.
Dans ce journal, la règle 1 fait déjà tout le travail. Une requête mal orthographiée n’a jamais rien trouvé avec la recherche actuelle, donc elle n’a jamais obtenu de clic. Les règles 2 et 3 ne retirent aucun texte supplémentaire ici. Nous les gardons comme protection. Quand vous ajoutez des suggestions d’une autre source, comme une liste de l’équipe de marchandisage, ces règles vérifient quand même chaque texte.
Les vraies boutiques ajoutent d’autres règles : aucun mot offensant, aucune marque d’autres boutiques, aucune donnée privée. Notre journal n’en contient pas, donc le projet ne les vérifie pas. Votre boutique doit le faire.
Exercice guidé : ajouter les fichiers de ce module
Section intitulée « Exercice guidé : ajouter les fichiers de ce module »Ce module ajoute huit fichiers au projet. Vous les copiez tous maintenant, depuis l’instantané end-of-m07. Cette leçon explique suggest.py et la page de recherche. Les prochaines leçons expliquent les autres fichiers.
-
Dans
larkfield-search, avec l’environnement virtuel actif, copiez les fichiers du module et le README. Il n’y a aucun nouveau paquet, doncrequirements.txtne change pas.Fenêtre de terminal S=../nextia-learning-labs/C38/snapshots/end-of-m07mkdir -p larkfield_search/staticfor f in larkfield_search/suggest.py larkfield_search/facets.py larkfield_search/business.py larkfield_search/runs/rules.py larkfield_search/app.py larkfield_search/static/search.html larkfield_search/commands/page.py tests/test_page.py README.md; docp "$S/$f" "$f"doneFenêtre de terminal $S = "..\nextia-learning-labs\C38\snapshots\end-of-m07"New-Item -ItemType Directory -Force larkfield_search\static | Out-Nullforeach ($f in 'larkfield_search\suggest.py', 'larkfield_search\facets.py', 'larkfield_search\business.py', 'larkfield_search\runs\rules.py', 'larkfield_search\app.py', 'larkfield_search\static\search.html', 'larkfield_search\commands\page.py', 'tests\test_page.py', 'README.md') { Copy-Item "$S\$f" $f } -
Exécutez les tests :
Fenêtre de terminal python -m pytest -q.................................... [100%]36 passed in 5.11sLe module 6 se terminait avec 31 tests. Les cinq nouveaux tests vérifient le code de ce module. Votre durée sera différente.
-
Demandez des suggestions. Le premier appel lit le journal et écrit les suggestions dans
outputs/suggestions.json, donc les appels suivants sont rapides :Fenêtre de terminal search suggest gar37 garage sports storage rack12 garden statues4 garden accents1 garage sports storage1 garage storage cabinets1 garlands & swagLe nombre est le poids. « garage sports storage rack » compte 37 recherches avec un clic dans le journal. « garden statues » est un nom de classe : elle contient 242 produits, et 242 ÷ 20 donne 12, arrondi vers le bas.
-
Essayez un préfixe partagé par beaucoup de requêtes du journal :
Fenêtre de terminal search suggest sof139 sofa24 sofa & console tables24 sofa with ottoman17 sofas1 soft seating -
Essayez maintenant « lamp » :
Fenêtre de terminal search suggest lampLa commande n’affiche rien. Larkfield vend beaucoup de lampes, alors pourquoi? L’index de préfixes cherche une correspondance au début du texte entier. Les classes de lampes sont « table lamps » et « floor lamps », qui commencent par « table » et « floor ». La seule requête du journal commençant par « lamp » est en français : « lampes solaires fantaisistes ». Elle n’a jamais rien trouvé. Aucune suggestion ne commence donc par « lamp ».
-
Lancez la page de recherche :
Fenêtre de terminal search serveLarkfield search page: http://127.0.0.1:8038/ (run ltr; stop with Ctrl+C)Le premier démarrage charge le modèle de classement et le bi-encodeur, donc il prend quelques secondes. Il peut aussi afficher des messages de PyTorch et Hugging Face. Ouvrez http://127.0.0.1:8038/ dans votre navigateur et tapez « gar ».
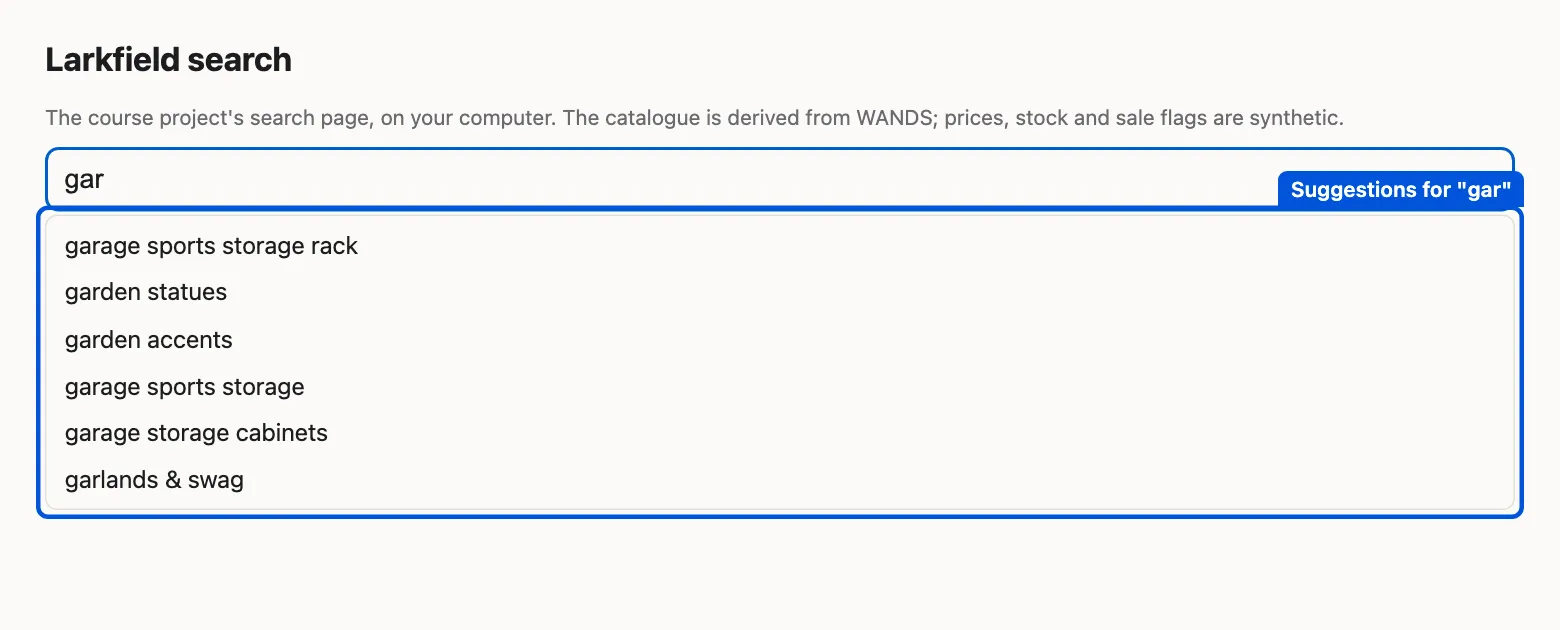
La page interroge /api/suggest après chaque pause de saisie et affiche les mêmes six suggestions que search suggest gar. Nous avons ajouté le cadre bleu. L’image est en anglais. -
Arrêtez le serveur avec Ctrl+C dans son terminal.
La page est un petit serveur Web de la bibliothèque standard de Python (app.py). Il répond à trois adresses : / fournit la page, /api/suggest?q=… les suggestions, et /api/search?q=… les résultats avec leurs facettes. Il écoute uniquement sur votre ordinateur (127.0.0.1). Si le port 8038 est utilisé, lancez-le avec search serve --port 8039.
Le code des suggestions
Section intitulée « Le code des suggestions »Ouvrez larkfield_search/suggest.py. La fonction suggestions() applique les trois règles ci-dessus, ajoute les noms de classes et trie la liste. La fonction suggest() est la recherche binaire de l’exemple détaillé :
def suggest(prefix, n=8): """The n best suggestions that start with the prefix: [(text, weight)].""" items = suggestions() keys = [t for t, _ in items] p = fold(prefix).lstrip() i = bisect.bisect_left(keys, p) found = [] while i < len(keys) and keys[i].startswith(p): found.append(items[i]) i += 1 return sorted(found, key=lambda x: (-x[1], x[0]))[:n]fold est le normaliseur de Normaliser le texte : minuscules, sans accents et unités écrites d’une seule façon. Ainsi, « Gar » et « gar » donnent les mêmes suggestions, et « canapé » correspondrait à « canape ». Quand deux suggestions ont le même poids, l’ordre alphabétique décide. La liste ne change donc jamais au hasard.
À quelle fréquence la bonne requête est-elle suggérée?
Section intitulée « À quelle fréquence la bonne requête est-elle suggérée? »Un système de suggestions est bon s’il propose la requête que la personne voulait. Nous pouvons mesurer cela avec le journal. Prenez les 120 requêtes de test en anglais. Pour chacune, tapez ses trois premières lettres et vérifiez si la requête complète figure parmi les 8 suggestions.
Le résultat : 60 % des 120 requêtes sont suggérées après 3 lettres. Après 5 ou 8 lettres, la proportion reste à 60 %. Plus de lettres n’aident pas. Pourquoi?
Description textuelle du graphique
Un graphique à trois barres. 72 des 120 requêtes de test en anglais figurent parmi les 8 suggestions après leurs 3 premières lettres. 47 ne sont jamais suggérées, car aucune recherche de ces textes n’a obtenu de clic dans le journal synthétique. Une requête, « outdoor light fixtures » (poids 4), est une suggestion. Mais plus de 8 suggestions de poids supérieur commencent par « outdoor ». Elle n’apparaît donc pas, même après 8 lettres.
Les 48 requêtes manquantes ne viennent pas d’un problème de l’index. 47 n’ont jamais obtenu de clic, donc elles ne sont pas du tout dans la liste. La dernière, « outdoor light fixtures », est dans la liste avec un poids de 4. Mais beaucoup de suggestions de poids supérieur commencent par « outdoor », donc elle reste hors des 8 premières.
C’est le biais de sélection de Apprendre des clics. Le journal connaît seulement ce que la recherche actuelle a affiché. Une requête qui échoue aujourd’hui n’obtient jamais de clic. Elle ne devient donc jamais une suggestion, même si le nouveau modèle de classement y répond bien. Tapez « cous » et vous n’obtenez rien. Chaque requête de coussin en français (« coussin zodiac », « coussin de chaise ») n’a rien trouvé avec la recherche actuelle. Nos requêtes françaises sont traduites automatiquement, mais de vrais clients francophones rencontreraient le même obstacle.
Il existe deux solutions. D’abord, reconstruisez les suggestions depuis le journal de la nouvelle recherche après une mise en production. Les requêtes qui fonctionnent maintenant pourront ainsi obtenir des clics. Ensuite, ajoutez des sources qui ne dépendent pas du journal. Les noms de classes de produits le font déjà, et vous pourriez aussi ajouter des noms de classes en français.
Quand utiliser la saisie semi-automatique et ce qu’elle coûte
Section intitulée « Quand utiliser la saisie semi-automatique et ce qu’elle coûte »Utilisez-la pour toute recherche de produits. Elle réduit la saisie, oriente les gens vers des requêtes qui fonctionnent et coûte très peu. La liste de Larkfield contient environ mille textes. Elle tient en mémoire, et une recherche binaire prend quelques microsecondes.
Faites attention à trois choses :
- Les suggestions s’alimentent elles-mêmes. Une requête suggérée est tapée plus souvent, obtient donc plus de clics et reste en tête. Une nouvelle bonne requête entre difficilement dans la liste. Recalculez les poids souvent, et ne laissez pas une semaine de trafic décider pour toujours.
- Un préfixe du texte entier manque les mots au milieu. « lamp » ne trouve rien, même si « table lamps » existe. Un second index de chaque début de mot résout cela : « lamp » trouve aussi « table lamps ». Le coût est un plus grand nombre de suggestions, dont davantage sont peu pertinentes.
- Les suggestions sont du contenu. Une suggestion offensante, privée ou incorrecte s’affiche pour tout le monde. Vérifiez les nouvelles suggestions avant leur mise en ligne, comme l’équipe de Hana vérifie une nouvelle bannière.
Erreur courante
Suggestions qui mènent à des pages vides
Symptôme : après une mise en production de la saisie semi-automatique, la proportion de pages vides augmente au lieu de diminuer. Les gens cliquent sur une suggestion et ne voient rien.
Cause : les suggestions ont été créées à partir de toutes les requêtes du journal, selon leur fréquence de saisie. Des échecs fréquents, comme « ligth bulb » (139 recherches, toutes vides), sont devenus des suggestions.
Diagnostic : prenez la première suggestion des 100 préfixes les plus courants, exécutez chacune et comptez les pages vides. Toute page vide est un bogue.
Correction : gardez seulement les textes qui ont mené à un clic et n’ont jamais renvoyé de page vide, comme le fait suggest.py. Ajoutez la vérification orthographique pour les textes provenant d’autres sources.
Conséquence pour le travail en IA : un système qui apprend de ses propres sorties répète ses propres erreurs. Il faut filtrer les données du passé selon ce qui a fonctionné, pas selon ce qui était fréquent.
À vous d’essayer
Section intitulée « À vous d’essayer »Avant d’exécuter quoi que ce soit, prédisez : qu’affiche search suggest "outdoor c"? Puis exécutez la commande :
search suggest "outdoor c"La sortie et ce qu’elle montre
20 outdoor conversation setsUne seule suggestion. Aucune requête du journal synthétique ne commence par « outdoor c », pas même « outdoor cushion ». La seule suggestion est un nom de classe. Cette classe contient 415 produits, donc son poids est 415 ÷ 20, arrondi vers le bas, soit 20.
Essayez ensuite search suggest can. La première suggestion, « canadian » (263), est une vraie requête WANDS que le journal synthétique répète souvent. Est-ce une bonne suggestion pour une personne qui tape « can » et veut « canapé »? C’est ici que des suggestions par langue seraient utiles.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
La liste triée contient 1 046 textes. Combien d'étapes environ faut-il à une recherche binaire pour trouver où commence « gar »? Et pourquoi une liste triée suffit-elle?
Afficher la réponse
Environ 10 étapes, car chaque étape divise la liste en deux : 1 046 → 523 → 262 → … → 1. Une liste triée suffit, car tous les textes qui commencent par « gar » se suivent. Quand la recherche binaire trouve le premier, nous continuons à lire jusqu’à un texte qui ne commence plus par « gar ».
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Tomás propose : « Suggérons les 1 000 textes les plus fréquents du journal. Si c'est fréquent, c'est bon. » Qu'est-ce qui ne va pas?
Afficher la réponse
Les échecs fréquents deviennent des suggestions. « hibou » (216 recherches), « ligth bulb » (139) et « ampoule » (119) figurent parmi les textes les plus fréquents. Aucun n’a donné de résultats. Une suggestion doit être une recherche qui a fonctionné. Le projet garde seulement les textes qui ont reçu un clic et n’ont jamais renvoyé de page vide.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Après 3, 5 et 8 lettres, 60 % des requêtes de test en anglais sont suggérées. Pourquoi taper plus de lettres n'aide-t-il pas ici?
Afficher la réponse
Presque toutes les requêtes manquantes ne font tout simplement pas partie des suggestions. Parmi les 48, 47 n’ont jamais reçu de clic dans le journal synthétique. Ajouter des lettres aide seulement si la bonne requête figure dans la liste, mais que des requêtes plus fortement pondérées la devancent. Cela arrive pour une seule requête ici, « outdoor light fixtures ».
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- La saisie semi-automatique suggère des requêtes complètes pendant qu’une personne tape. Les suggestions de Larkfield proviennent des requêtes du journal ayant reçu un clic et des noms de classes de produits. Leur poids correspond au nombre de recherches avec un clic.
- Un index de préfixes peut être une liste triée. Une recherche binaire trouve la première correspondance en environ 10 étapes, et les correspondances se suivent.
- Une suggestion promet que la recherche fonctionne. Gardez les textes qui ont mené à un clic et n’ont jamais renvoyé de page vide, et vérifiez l’orthographe.
- Parmi les requêtes de test en anglais, 60 % sont suggérées après 3 lettres. Presque toutes les autres n’ont jamais reçu de clic dans le journal. Les suggestions héritent des lacunes de la recherche qui a produit le journal.
- Le projet compte maintenant huit nouveaux fichiers, 36 tests et une page de recherche :
search serve.
La boîte de recherche aide maintenant les gens à taper une bonne requête. Ensuite, ils regardent les résultats et veulent les restreindre : seulement le bleu, les prix sous 50 $ ou les produits en stock. C’est le rôle des filtres et des facettes.
Leçon suivante : Filtres et facettes