
Aucun résultat et règles d'affaires
- Leçon 25
- 40 min
- Module 7 : Les parties de la recherche que les gens voient
Où nous en sommes
Les filtres aident les gens à réduire une bonne liste. Certaines requêtes ne donnent toujours rien, et Hana veut les articles en solde en premier. Dans cette leçon, nous ajoutons des solutions de repli et des règles d'affaires. Nous mesurons aussi leur coût en pertinence.
Leçon 25 sur 30 · Recherche et classement : trouver la meilleure correspondanceAucun résultat et règles d'affaires
1. Le problème de la recherche
2. Mesurer la pertinence avant de changer quoi que ce soit
3. La recherche lexicale : la référence de base à battre
4. Comprendre la requête
5. La recherche dense et la recherche hybride
6. Reclasser les premiers résultats
7. Les parties de la recherche que les gens voient
8. Exploiter la recherche en production
Ce que vous saurez faire
Ne montrez jamais une page vide sans bonne raison. Mesurez le coût de chaque règle d’affaires avant de l’accepter.
Carnet JupyterMesurer des règles d'affaires et une solution de repli dans un carnet Jupyter
Le carnet (notebook) Jupyter applique « soldes en premier » et un bonus plus modéré aux résultats hybrides enregistrés des requêtes de test. Il mesure le NDCG@10 et les premiers résultats en rupture de stock. Vous écrivez une règle de stock. Ensuite, vous créez un petit index de mots et trouvez les recherches enregistrées qui ont besoin d’une solution de repli. Ses cellules de préparation téléchargent les données. Aucune configuration locale n’est donc nécessaire. Environ 30 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les comparaisons appariées avec un intervalle (
search compare), dans Créer un jeu de test qui représente vos utilisateurs. - Le modèle de classement
ltr, dans Apprentissage du classement, et la recherche dense, dans Recherche par le sens.
Ce qu’il vous faut sur votre ordinateur
- Le projet avec les fichiers de ce module, copié dans Saisie semi-automatique. Cette leçon explique
business.pyetruns/rules.py.
Une vendeuse qui ne dit jamais seulement « non »
Section intitulée « Une vendeuse qui ne dit jamais seulement « non » »Un client demande un « hibou ». La vendeuse ne connaît pas le mot. Une mauvaise vendeuse dit « Nous n’avons pas ça » et se détourne. Une bonne vendeuse dit : « Je ne connais pas ce mot. Voulez-vous dire quelque chose comme ceci? » Elle montre quelques produits. Elle précise clairement qu’elle fait une supposition.
Le même magasin a un gestionnaire qui dit : « Mettez les articles en solde à l’avant de chaque tablette. » Cela semble bon pour les affaires. Mais si le présentoir des soldes est à moitié vide, les clients vont devant et ne trouvent rien à acheter.
Cette leçon traite des deux sujets : quoi montrer quand rien ne correspond, et ce que coûte une règle comme celle du gestionnaire.
Partie 1 : aucun résultat
Section intitulée « Partie 1 : aucun résultat »Le problème
Section intitulée « Le problème »Dans le journal synthétique, 30,9 % des recherches ne donnent rien avec la recherche actuelle de Larkfield, car chaque mot doit correspondre. Les recherches vides les plus fréquentes sont « hibou » (216 recherches), « ligth bulb » (139), « ampoule » (119) et « canapé » (79). Les requêtes françaises de nos données sont traduites automatiquement. Nous avons créé les fautes d’orthographe pour l’exercice. Mais les vrais magasins connaissent les mêmes types d’échecs.
Les meilleures exécutions des modules 3 à 6 règlent déjà la plupart de ces problèmes. Nous avons relancé chaque méthode de recherche sur toutes les recherches enregistrées. La recherche actuelle (current) ne trouve alors rien dans 30,7 % des cas, près des 30,9 % enregistrés dans le journal. Cette part tombe à 7,8 % (bm25), à 2,0 % (bm25-norm) et à 0,3 % (bm25-norm+spell). Mais toute recherche peut encore afficher une page vide, par exemple avec un nouveau nom de produit ou une faute inhabituelle. La page doit donc prévoir ce cas.
L’idée : une échelle de solutions de repli
Section intitulée « L’idée : une échelle de solutions de repli »Une solution de repli est ce que fait la recherche quand la recherche normale ne trouve rien. Les bonnes solutions de repli descendent une échelle, du plus strict au plus souple. Elles s’arrêtent à la première étape qui trouve quelque chose :
- Chaque mot doit correspondre. C’est la recherche normale.
- Assouplir la requête : n’importe quel mot peut correspondre. « ligth bulb » ne trouve aucun produit avec « ligth », mais plusieurs avec « bulb ».
- Montrer des correspondances proches : chercher par le sens. « hibou » ne correspond à aucun mot. La recherche dense du module 5 trouve donc des produits proches par le sens.
À chaque étape descendue, la page doit dire ce qu’elle a fait : « Aucun produit ne contient tous les mots de votre recherche. Ces produits contiennent certains des mots. » Les gens comprennent alors pourquoi les résultats sont différents, et peuvent essayer d’autres mots.

Description textuelle du diagramme
Trois cases de gauche à droite, reliées par des flèches portant la mention « rien trouvé ». Étape 1, chaque mot doit être dans le produit (bordure épaisse) : 69,2 % des 20 000 recherches enregistrées s’arrêtent ici; les 80 requêtes de test qui s’arrêtent ici obtiennent un NDCG@10 de 0,588. Étape 2, n’importe quel mot, et la page dit « Ces produits contiennent certains des mots » : 23,4 % des recherches; 132 requêtes de test, NDCG@10 de 0,348. Étape 3, par le sens, et la page dit « Ces produits sont proches par le sens » (bordure en tirets) : 7,4 % des recherches; 29 requêtes de test, NDCG@10 de 0,05.
Les trois parts totalisent 100 % : aucune recherche ne se termine sur une page vide. Mais regardez le NDCG@10 de chaque étape. Plus on descend, plus les résultats sont mauvais. L’étape 3 est atteinte par 29 requêtes de test, dont les résultats sont presque tous incorrects (0,05). Parmi ces 29 requêtes, 20 sont des codes de produit. La règle des codes de Correspondances exactes et règles y répond parfaitement; le sens ne le peut pas.
Larkfield : la solution de repli dans le projet
Section intitulée « Larkfield : la solution de repli dans le projet »L’exécution current+fallback est la recherche actuelle de Larkfield avec cette échelle. Le code se trouve dans business.py :
def fallback(query, query_id=None, k=100): """Never an empty page: every word must match; if nothing does, any word; if nothing does, by meaning.""" res = index.fts_search(query, k, "and") if res: return res, "all words" res = index.fts_search(query, k, "or") if res: return res, "any word" return dense.top(dense.scores(query, query_id), k), "by meaning"La fonction renvoie les résultats et l’étape, pour que la page puisse dire ce qu’elle a fait.
-
Lancez une requête mal orthographiée avec la recherche actuelle, puis avec la solution de repli :
Fenêtre de terminal search query "ligth bulb" --run current -k 3search query "ligth bulb" --run current+fallback -k 3current: "ligth bulb" -> 0 results (query W-305: judged results are marked)current+fallback: "ligth bulb" -> 3 results (query W-305: judged results are marked)1. LK-75018 4w e12/candelabra led light bulb Light Bulbs 333.99 [exact]2. LK-47333 60 watt equivalent a19 led dimmable light bulb , ( 2700 k ) Light Bulbs 233.99 [exact]3. LK-88046 60 watt equivalent , b13 led , dimmable light bulb , warm wh Light Bulbs 252.99 [partial]L’étape 2 sauve cette requête : « bulb » seul trouve des ampoules.
-
Essayez maintenant une requête sans mot connu :
Fenêtre de terminal search query "hibou" --run current+fallback -k 3current+fallback: "hibou" -> 3 results (query F-227: judged results are marked)1. LK-84055 fiji shower hooks Shower Curtain Hooks and 163.99 [not judged]2. LK-88452 hoaloha , god of the hawaiian isle tiki wall décor Wall Décor 63.99 [not judged]3. LK-71998 kohler toobi rite-temp valve trim with lever handle Fixture Parts And Compon 71.99 [not judged]« Hibou » signifie « owl » en anglais. La recherche par le sens renvoie des crochets de douche et une décoration murale tiki. La page n’est pas vide, mais elle n’est pas utile non plus.
-
Mesurez la solution de repli sur les requêtes de test :
Fenêtre de terminal search compare current current+fallback --by sourcecurrent+fallback minus current on 241 test queries: ndcg@10 +0.197 (95% interval +0.158 to +0.235); better on 105, worse on 0, the same on 136source queries current current+fallback difference low high worsecode 20 0.000 0.000 0.000 0.000 0.000 0planted 3 0.451 0.451 0.000 0.000 0.000 0translated 59 0.012 0.190 0.178 0.111 0.252 0typo 40 0.000 0.384 0.384 0.292 0.475 0wands 119 0.378 0.560 0.182 0.127 0.240 0Le NDCG@10 passe de 0,195 à 0,392 et aucune requête ne se dégrade. C’est le rôle d’une solution de repli : agir seulement quand la recherche normale ne trouve rien.
Démarrez la page avec search serve --run current+fallback et cherchez « hibou ». La note au-dessus des résultats indique à la personne ce qui s’est passé.
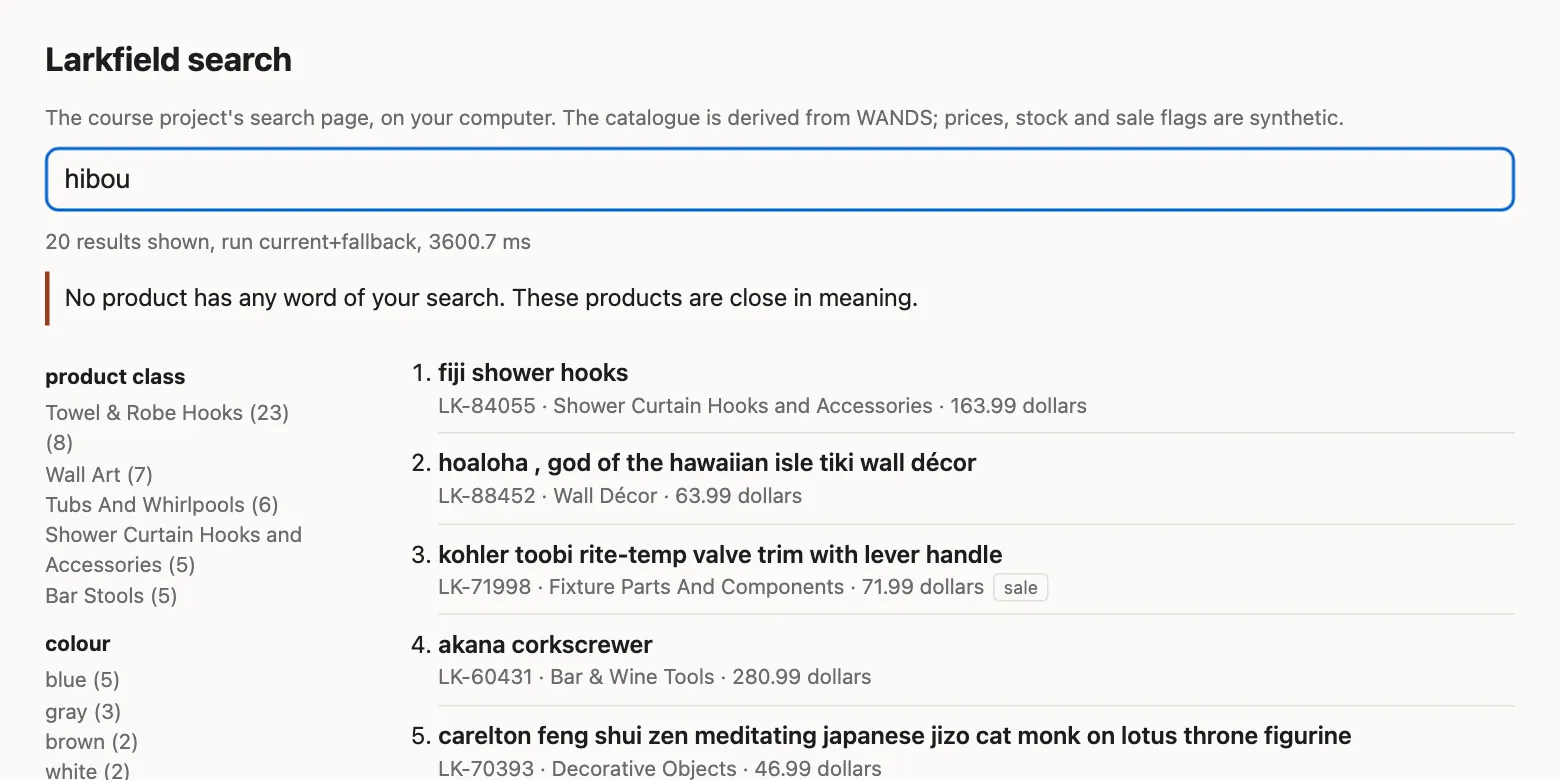
Une solution de repli ne remplace pas une meilleure recherche. Elle récupère ce que la recherche manque. Avec ltr, aucune requête de test n’a zéro résultat. L’échelle sert donc très rarement.
Partie 2 : règles d’affaires
Section intitulée « Partie 2 : règles d’affaires »La demande
Section intitulée « La demande »Hana, responsable du marchandisage chez Larkfield, demande une règle : « Montrez toujours les articles en solde en premier. » Les articles en solde rapportent de l’argent maintenant, et la saison finit bientôt. C’est une demande raisonnable. C’est aussi un changement au classement. Nous le mesurons donc comme tout autre changement.
Une règle d’affaires change l’ordre des résultats pour une raison d’affaires, et non pour leur pertinence. Il existe trois types courants :
- Une règle stricte déplace un groupe en bloc : tous les articles en solde avant les autres, ou tous les produits en rupture de stock en dernier.
- Un bonus modéré ajoute des points au score d’un groupe. Ses produits montent, mais ne dépassent pas ceux qui sont beaucoup meilleurs.
- Un résultat épinglé place un produit choisi à une position fixe pour une requête, par exemple une nouvelle collection au rang 1 pour « sofa ».
Le projet applique chaque règle aux 100 premiers résultats de ltr. Ainsi, search eval la mesure comme une exécution.
Un fait sur les données de Larkfield compte ici. Les articles en solde sont beaucoup plus souvent en rupture de stock : 39,6 % des articles en solde, contre 8,2 % des autres. Nous avons créé ce problème pour l’exercice; les indicateurs de stock et de solde sont synthétiques. Les vrais magasins le connaissent aussi : un produit est souvent en solde parce qu’il n’en reste que les dernières unités.
Une règle avant et après
Section intitulée « Une règle avant et après »Voici « soldes en premier » sur une requête de test, « clear shower curtain » :

Description textuelle du diagramme
Deux listes côte à côte. Avant, avec ltr (NDCG@10 de 0,675) : woolley vinyl single shower curtain (exact), siniard single shower curtain (exact, en solde, en rupture de stock), woolley vinyl solid color single shower curtain (exact), simmon vinyl single shower curtain liner (exact), vinyl 3 curtains single shower curtain (exact). Après, avec soldes en premier (NDCG@10 de 0,353) : siniard single shower curtain (exact, en solde, en rupture de stock), stainless steel shower curtain hooks (non pertinent, en solde, en rupture de stock), adriana shower curtain hooks (non pertinent, en solde), sunsetlife shower curtain (partiel, en solde, en rupture de stock), ruya single shower curtain (partiel, en solde, en rupture de stock).
La règle a fait ce que Hana demandait : les cinq premiers sont tous en solde. Mais elle a repoussé quatre rideaux exacts hors des cinq premiers. Elle a ajouté des crochets de rideau de douche, que les juges ont notés non pertinents. Et quatre des cinq sont en rupture de stock. Une personne qui veut un rideau de douche transparent voit des crochets et des produits qu’elle ne peut pas acheter.
Un bonus modéré, avec toutes les valeurs
Section intitulée « Un bonus modéré, avec toutes les valeurs »La règle plus souple sale_boost ajoute un bonus à chaque article en solde. Le bonus représente 20 % de l’étendue des scores de la liste. Il a donc le même sens pour chaque requête :
- Pour « clear shower curtain », le meilleur score
ltrest 3,099 et le plus bas des 100 premiers est −1,962. L’étendue est de 5,061. - Le bonus est de 0,2 × 5,061 = 1,012.
- « siniard single shower curtain » (en solde) : 3,026 + 1,012 = 4,038. Il passe du rang 2 au rang 1, devant « woolley vinyl single shower curtain » (3,099, pas en solde).
- « stainless steel shower curtain hooks » (en solde) : 0,387 + 1,012 = 1,399. Il passe du rang 9 au rang 5, devant « vinyl 3 curtains single shower curtain » (0,830).
Le bonus relève donc les articles en solde d’une valeur fixe. Un article en solde ne peut toujours pas dépasser un produit dont le score est supérieur de plus de 1,012. Les trois rideaux exacts entre eux restent en place.
Mesurer chaque règle
Section intitulée « Mesurer chaque règle »Chaque règle est une exécution. Nous la mesurons donc sur les 243 requêtes de test. Comme dans chaque module, la moyenne du NDCG@10 utilise les 241 requêtes ayant au moins un bon produit :
search eval --run ltr+sale-firstltr+sale-first on 243 test queries: NDCG@10 0.463 (95% interval 0.421 to 0.504)recall@100 0.540, MRR 0.487, zero results 0.0%, judged in the top 10 59.1%; 23.2 ms a query (p50), 41.7 ms (p95)Le graphique montre toutes les règles selon deux mesures : la pertinence (NDCG@10) et la part des requêtes dont le premier résultat est en rupture de stock.
Description textuelle du graphique
Deux panneaux. Pertinence, NDCG@10 avec intervalles à 95 % : ltr 0,668 (0,628 à 0,708); soldes en premier 0,463 (0,421 à 0,504); bonus de solde 0,662 (0,621 à 0,702); rupture de stock en dernier 0,66 (0,62 à 0,699). Premier résultat en rupture de stock : ltr 11,1 %; soldes en premier 37,9 %; bonus de solde 23,5 %; rupture de stock en dernier 0,0 %.
Lisez les deux panneaux ensemble :
- Soldes en premier coûte 0,205 de NDCG@10 (intervalle apparié de −0,241 à −0,170). La règle dégrade 171 requêtes de test. Le premier résultat est en rupture de stock pour 37,9 % des requêtes, contre 11,1 % avec
ltr. Les articles en solde occupent 98,8 % des dix premiers rangs. - Bonus de solde coûte 0,006 (intervalle de −0,012 à +0,001) : pas de différence claire avec l’absence de règle. Les articles en solde occupent 47,9 % des dix premiers rangs, contre 14,2 % avec
ltr. Mais un produit en rupture de stock arrive en premier pour 23,5 % des requêtes. - Rupture de stock en dernier coûte 0,008 (intervalle de −0,014 à −0,003) : un coût faible, mais clair. La règle ne montre jamais un produit en rupture de stock en premier.
Une règle peut briser d’autres règles
Section intitulée « Une règle peut briser d’autres règles »Regardez « soldes en premier » par source :
search compare ltr ltr+sale-first --by sourceltr+sale-first minus ltr on 241 test queries: ndcg@10 -0.205 (95% interval -0.241 to -0.170); better on 35, worse on 171, the same on 35
source queries ltr ltr+sale-first difference low high worse code 20 1.000 0.250 -0.750 -0.900 -0.550 15 planted 3 0.571 0.730 0.159 0.000 0.415 0translated 59 0.474 0.257 -0.216 -0.273 -0.158 44 typo 40 0.615 0.483 -0.132 -0.194 -0.070 28 wands 119 0.729 0.587 -0.142 -0.177 -0.110 84Les codes de produit passent de 1,000 à 0,250. Une personne qui saisit un code de produit veut ce produit précis. La règle des codes l’a placé en premier. « Soldes en premier » a ensuite déplacé tous les articles en solde devant lui, sauf si le produit était lui-même en solde. Deux règles, chacune raisonnable seule, entrent en conflit. La dernière règle gagne, et personne ne l’avait prévu.
Résultats épinglés
Section intitulée « Résultats épinglés »Un résultat épinglé est la règle la plus forte : un produit à une position pour une requête. Le projet en a déjà un type : la règle des codes de Correspondances exactes et règles épingle le produit dont la personne a saisi le code. Les résultats épinglés pour le marchandisage fonctionnent de la même façon, à partir d’une liste (requête, produit, position).
Mesurez un résultat épinglé comme toute règle, mais seulement sur sa requête et les requêtes qui partagent ses mots. Donnez aussi une date de fin à chaque résultat épinglé. Un résultat reste épinglé au-delà de sa raison d’être plus souvent que vous le pensez : la saison finit, le produit tombe en rupture de stock, et il reste épinglé.
À vous : une règle de stock souple et une solution de repli
Section intitulée « À vous : une règle de stock souple et une solution de repli »Écrivez votre propre règle, mesurez-la et comparez-la aux règles ci-dessus.
- Créez un fichier
larkfield_search/runs/mine.py. Écrivez une exécutionltr+stock-boostqui fait descendre les produits en rupture de stock de 20 % de l’étendue des scores. Partez debusiness.sale_boostet deruns/rules.py. Ajoutez à votre fonction la ligne@register("ltr+stock-boost", "…"), comme les exécutions dansrules.py. Le projet charge chaque fichier delarkfield_search/runs/au démarrage. Ainsi,search eval --run ltr+stock-boosttrouve votre exécution sans autre changement. - Mesurez-la avec
search evaletsearch compare ltr ltr+stock-boost. Mesurez ensuite la fréquence d’un premier résultat en rupture de stock. - Pour la solution de repli : lancez
search eval --run currentetsearch eval --run current+fallback. Comparez le taux de recherches sans résultat et le NDCG@10.
Une solution et nos résultats
"""My Module 7 run: a soft stock rule."""
from .. import businessfrom . import registerfrom .rules import _ltr

def stock_boost(results, boost=0.2):    """Out-of-stock products move down by `boost` of the score range of the list."""    if not results:        return results    stock = business._col("in_stock")    lo, hi = min(s for _, s in results), max(s for _, s in results)    penalty = boost * (hi - lo)    return sorted(((p, s - penalty * (not stock[p])) for p, s in results), key=lambda x: (-x[1], x[0]))

@register("ltr+stock-boost", "ltr, out-of-stock products moved down by 20% of the score range", "mine")def ltr_stock_boost(query, query_id=None, k=100):    return stock_boost(_ltr(query, query_id))[:k]
ltr+stock-boost on 243 test queries: NDCG@10 0.667 (95% interval 0.627 to 0.707)recall@100 0.540, MRR 0.702, zero results 0.0%, judged in the top 10 73.7%; 25.5 ms a query (p50), 57.5 ms (p95)ltr+stock-boost minus ltr on 241 test queries: ndcg@10 -0.001 (95% interval -0.005 to +0.004); better on 42, worse on 56, the same on 143Pour compter les premiers résultats en rupture de stock, nous avons utilisé ceci dans python :
>>> from larkfield_search import business, data, engine>>> qs = data.split("test")>>> for run in ("ltr", "ltr+stock-last", "ltr+stock-boost"):... ranked, _ = engine.run_queries(run, qs, 100)... lists = [r for r in ranked.values() if r]... first_out = sum(not business._col("in_stock")[r[0]] for r in lists) / len(lists)... print(run, round(first_out, 3))...ltr 0.111ltr+stock-last 0.0ltr+stock-boost 0.016La règle souple ne coûte rien de mesurable (−0,001, intervalle de −0,005 à +0,004). Le premier résultat est en rupture de stock pour seulement 1,6 % des requêtes. Par rapport à ltr+stock-last, elle est meilleure de +0,007 (+0,004 à +0,011). Un produit exact en rupture de stock peut rester près du sommet. Il ne tombe pas derrière tous les produits en stock.
Pour la solution de repli, search eval donne 66,7 % de recherches sans résultat et un NDCG@10 de 0,195 pour current. Pour current+fallback, ces valeurs sont de 0,0 % et de 0,392.
Erreur courante
Une règle d'affaires qui brise discrètement les codes de produit
Symptôme : après la mise en service de « soldes en premier », le service à la clientèle reçoit des appels : « J’ai saisi le code du produit de votre catalogue, et votre recherche montre d’autres produits. »
Cause : la règle des soldes s’exécute après celle des codes et déplace tous les articles en solde devant le produit demandé. Les 20 requêtes de codes passent d’un NDCG@10 de 1,000 à 0,250.
Diagnostic : search compare ltr ltr+sale-first --by source. Une tranche qui descend de 1,000 indique un conflit de règles, pas un problème de classement.
Correction : donnez aux règles un ordre et des exceptions. Une correspondance exacte de code passe avant toute règle de marchandisage. Mieux encore, utilisez un bonus modéré, qui ne peut pas dépasser un produit beaucoup meilleur.
Conséquence pour le travail en IA : les règles ajoutées après un modèle modifient sa sortie sans que le test du modèle le voie. Mesurez tout le pipeline, par tranche, après chaque règle.
Vérification de fin de leçon : la règle de Hana
Section intitulée « Vérification de fin de leçon : la règle de Hana »Écrivez à Omar et Hana une courte réponse à « montrez toujours les articles en solde en premier », avec les mesures. Comparez ensuite votre réponse à la nôtre.
Notre réponse
Nous avons mesuré « soldes en premier » sur les requêtes de test (241 des 243 ont un NDCG). La règle fait passer le NDCG@10 de 0,668 à 0,463 : −0,205, avec un intervalle à 95 % de −0,241 à −0,170. Elle dégrade 171 requêtes et en améliore 35. Elle brise les codes de produit : le bon produit n’est plus premier, et ces requêtes passent de 1,000 à 0,250. Les articles en solde sont quatre à cinq fois plus souvent en rupture de stock. Le premier résultat est donc en rupture de stock pour 37,9 % des requêtes, contre 11,1 % aujourd’hui. Les gens verraient davantage de produits qu’ils ne peuvent pas acheter.
Nous déconseillons la règle stricte. Nous proposons plutôt un bonus de solde. Les articles en solde montent de 20 % de l’étendue des scores. Cela coûte 0,006 de NDCG@10, ce qui reste dans le bruit. Le bonus montre plus de trois fois autant d’articles en solde parmi les dix premiers (47,9 % contre 14,2 %). Combinez-le avec une règle de stock pour éviter que les articles en solde en rupture de stock arrivent en premier. Les règles de stock seules coûtent de 0,001 à 0,008. Testez ensuite le résultat en ligne, avec le taux d’ajout au panier comme mesure principale. Tester les changements en ligne montre comment faire.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Avec current+fallback, aucune requête de test ne donne zéro résultat. Tomás dit : « Donc, le problème des recherches sans résultat est réglé. » Que répondez-vous?
Afficher la réponse
Le problème des pages vides est réglé, mais pas celui de la pertinence. Les 29 requêtes de test qui atteignent la dernière étape, la recherche par le sens, obtiennent un NDCG@10 de 0,050. Presque tous les résultats sont faux. « hibou » affiche des crochets de douche. Une solution de repli doit indiquer ce qu’elle a fait. La vraie solution est une meilleure recherche, avec la correction orthographique, la règle des codes et les titres en français.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Pourquoi « soldes en premier » place-t-elle si souvent un produit en rupture de stock au premier rang (37,9 %)? Seulement 12,9 % des produits sont en rupture de stock.
Afficher la réponse
Les articles en solde sont beaucoup plus souvent en rupture de stock : 39,6 %, contre 8,2 % pour les autres. Nous avons inséré ce problème exprès pour l’exercice, mais les vrais magasins le rencontrent aussi. « Soldes en premier » place un article en solde au premier rang pour presque toutes les requêtes. Le premier résultat hérite donc du problème de stock des articles en solde.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Le bonus de solde coûte 0,006 de NDCG@10, avec un intervalle de −0,012 à +0,001. Est-ce sans coût?
Afficher la réponse
Il n’y a pas de coût en pertinence, selon ce que le test peut montrer, car l’intervalle comprend 0. Mais il y a un coût sur la page. Un produit en rupture de stock arrive en premier pour 23,5 % des requêtes, contre 11,1 % sans la règle. Une règle peut avoir un coût que le NDCG ne mesure pas. C’est pourquoi nous comptons aussi les premiers résultats en rupture de stock.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une échelle de solutions de repli passe de critères stricts à des critères souples : tous les mots, puis n’importe quel mot, puis le sens. Elle n’affiche jamais de page vide et doit indiquer ce qu’elle a fait.
- La solution de repli fait passer le NDCG@10 de la recherche actuelle de Larkfield de 0,195 à 0,392. Elle ne dégrade aucune requête. Sa dernière étape est faible (0,050) : une solution de repli récupère les échecs; elle ne remplace pas une meilleure recherche.
- Une règle d’affaires réorganise les résultats pour une raison d’affaires. Mesurez-la comme une exécution : NDCG@10 avec son intervalle, par tranche, et effets sur la page. Comptez, par exemple, les premiers résultats en rupture de stock.
- « Soldes en premier » coûte 0,205 de NDCG@10 et nuit aux recherches par codes de produit. Elle place un produit en rupture de stock en premier pour 37,9 % des requêtes. La raison : les articles en solde sont plus souvent en rupture de stock (un problème inséré pour l’exercice). Un bonus de solde modéré coûte 0,006, ce qui reste dans le bruit.
- Les règles entrent en conflit. Donnez-leur un ordre et mesurez tout le pipeline après chaque nouvelle règle.
Nos règles déplacent des produits qui ont déjà un bon score. Un nouveau produit n’a aucun clic, donc le modèle de classement ne lui donne jamais un bon score. Ensuite, vous découvrirez le problème du démarrage à froid et donnerez aux nouveaux produits une place sur la page.
Leçon suivante : Nouveaux produits et démarrage à froid