
Nouveaux produits et démarrage à froid
- Leçon 26
- 30 min
- Module 7 : Les parties de la recherche que les gens voient
Où nous en sommes
Nos règles pour favoriser des produits et nos variables de clics aident les produits populaires. Un nouveau produit n'a aucun clic, alors il ne remonte jamais. Dans cette leçon, nous examinons le problème du démarrage à froid. Nous utilisons des variables de contenu et des emplacements d'exploration pour donner une chance aux nouveaux produits.
Leçon 26 sur 30 · Recherche et classement : trouver la meilleure correspondanceNouveaux produits et démarrage à froid
1. Le problème de la recherche
2. Mesurer la pertinence avant de changer quoi que ce soit
3. La recherche lexicale : la référence de base à battre
4. Comprendre la requête
5. La recherche dense et la recherche hybride
6. Reclasser les premiers résultats
7. Les parties de la recherche que les gens voient
8. Exploiter la recherche en production
Ce que vous saurez faire
Donnez aux produits sans historique une chance équitable d’être vus, et mesurez le coût de cette chance.
Carnet JupyterCréer un emplacement d'exploration dans un carnet Jupyter
Le carnet (notebook) Jupyter compte les nouveaux produits affichés ou cliqués dans le journal synthétique. Il trouve ensuite le rang des nouveaux produits pertinents dans les résultats hybrides enregistrés. Vous créez un emplacement d’exploration et mesurez son coût sur les requêtes de test. Ses cellules de préparation téléchargent les données, donc aucune préparation locale n’est nécessaire. Environ 25 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les variables du modèle de classement, dont les clics et l’âge, dans Apprentissage du classement.
- Pourquoi seuls les produits affichés reçoivent des clics, dans Apprendre des clics.
Ce qu’il vous faut sur votre ordinateur
- Le projet avec les fichiers de ce module, copié dans Saisie semi-automatique, et le modèle de classement entraîné. Cette leçon explique la fin de
business.py; elle n’ajoute aucun fichier.
Un nouveau livre sur une étagère au fond
Section intitulée « Un nouveau livre sur une étagère au fond »Une librairie reçoit un nouveau livre. Le personnel le place sur une étagère au fond. Personne ne passe devant cette étagère, donc personne n’achète le livre. Après un mois, le gestionnaire examine les ventes et dit : « Personne ne veut ce livre. Ne le commandez plus. »
Le livre n’a jamais eu sa chance. Les bonnes librairies le savent, alors elles ont une table à l’entrée : « Nouveautés ». Chaque nouveau livre y passe un certain temps. Si les gens l’achètent, il mérite sa place. Sinon, il retourne au fond.
Le problème : pas de clics, mauvais rang, pas de clics
Section intitulée « Le problème : pas de clics, mauvais rang, pas de clics »Larkfield a ajouté 600 produits dans les deux dernières semaines du journal synthétique. Leurs dates d’ajout sont synthétiques, créées par notre code. À quelle fréquence le journal les a-t-il affichés? Seulement 35 des 600 ont déjà figuré sur une page de résultats, et seulement 13 ont reçu un clic. Dans tout le catalogue, 1 678 produits ont reçu un clic.
Le modèle de classement du module 6 utilise les clics et les ajouts au panier du journal comme variables. Vous avez vu cette boucle de rétroaction dans Apprendre des clics : le journal contient seulement des clics sur les produits affichés. Un nouveau produit est le cas extrême. Il n’a aucun clic, alors le modèle le classe bas, et peu de gens le voient. Pour les nouveaux articles, cette boucle porte le nom de problème du démarrage à froid. Le système ne sait rien d’un nouvel article et ne provoque pas le comportement dont il a besoin.

Description textuelle du diagramme
Quatre cases forment une boucle. « Un nouveau produit : 600 ajoutés dans les deux dernières semaines » mène à « Pas encore de clics : 13 sur 600 en ont un ». Puis viennent « Le modèle le classe bas (variables de popularité) » et « Peu de gens le voient : 35 sur 600 ont été affichés ». Cette dernière case revient à « Pas encore de clics ». Une cinquième case à bordure épaisse indique « Emplacement d’exploration : position 4 pour le meilleur nouveau produit ». Une flèche pointillée mène à « Peu de gens le voient » et porte l’étiquette « brise la boucle ».
Un produit, mesuré
Section intitulée « Un produit, mesuré »Prenez la requête de test « kids chair ». Les juges ont donné au nouveau produit « flint hills club kids chair » (LK-68994) la note « exact ». Il a été ajouté le 20 octobre 2025. Le modèle de classement ltr le place au rang 65. Pourquoi? Comparez ses variables à celles des trois premiers produits. Tapez les lignes après >>> dans python, dans le dossier du projet. ltr.candidates fournit les candidats d’une requête (les 100 premiers résultats hybrides) avec leurs 19 variables. ltr.booster("judgments") charge le modèle de classement que vous avez entraîné sur les jugements au module 6 :
>>> from larkfield_search import ltr>>> f = ltr.candidates("kids chair", "W-131")>>> f["score"] = ltr.booster("judgments").predict(f[ltr.FEATURES])>>> f = f.sort_values("score", ascending=False).reset_index(drop=True)>>> f["rank"] = f.index + 1>>> cols = ["product_id", "rank", "bm25_title", "dense", "clicks_log", "age_days", "score"]>>> f.loc[(f["rank"] <= 3) | (f["product_id"] == "LK-68994"), cols].round(2) product_id rank bm25_title dense clicks_log age_days score0 LK-17212 1 4.04 0.93 2.56 208 3.731 LK-32609 2 4.04 0.91 2.48 587 3.052 LK-75196 3 4.04 0.91 2.94 187 3.0064 LK-68994 65 3.77 0.92 0.00 6 -0.32Les variables de contenu sont presque identiques. Elles décrivent le texte du produit lui-même. Le score BM25 du titre est de 3,77, contre 4,04 pour les trois premiers. La similarité dense est de 0,92, contre 0,91 à 0,93. La différence vient des clics. clicks_log correspond à log(1 + clics) : 2,56 signifie 12 clics, et 0,00 signifie aucun. Et le produit a 6 jours, contre 187 à 587 jours.
Et si le nouveau produit avait les clics d’un produit typique parmi les 10 premiers? Nous pouvons essayer. Copiez les médianes de clicks_log et de carts_log des 10 premiers dans sa ligne, puis recalculez son score.
>>> row = f[f["product_id"] == "LK-68994"].copy()>>> row[["clicks_log", "carts_log"]] = f.loc[f["rank"] <= 10, ["clicks_log", "carts_log"]].median().to_numpy()>>> new_score = ltr.booster("judgments").predict(row[ltr.FEATURES])[0]>>> round(new_score, 2), int((f["score"] > new_score).sum()) + 1(np.float64(1.49), 7)Avec environ 7 clics, le même produit serait au rang 7 plutôt que 65. Son texte est aussi bon que celui des autres. Il lui manque seulement un historique.
Deux idées
Section intitulée « Deux idées »Idée 1 : une valeur a priori équitable à partir du contenu
Section intitulée « Idée 1 : une valeur a priori équitable à partir du contenu »Une valeur a priori est une valeur que vous supposez avant d’avoir des données. Un nouveau produit n’a pas encore de clics. Zéro est une mauvaise estimation : elle dit « personne n’en veut », alors que la vérité est « personne ne l’a vu ». Une estimation plus équitable correspond à ce qu’obtient un produit typique de la même classe.
Nous avons testé cette idée pour la mesurer. Chaque nouveau produit reçoit les médianes des clics et des ajouts au panier des produits affichés de sa classe. Le modèle de classement reste le même. Nous avons exécuté ce test une fois pour cette leçon. Il ne fait pas partie du projet, alors vous voyez seulement nos résultats ci-dessous.
Idée 2 : un emplacement d’exploration
Section intitulée « Idée 2 : un emplacement d’exploration »Un emplacement d’exploration est une place fixe sur la page de résultats pour un élément dont le système n’est pas sûr. Ici, le meilleur nouveau produit parmi les 100 candidats passe à la position 4. C’est la table « Nouveautés » de la librairie. Les gens voient le nouveau produit; certains cliquent; le journal enregistre ces clics; le prochain modèle de classement en apprend.
Le mot « exploration » vient d’un compromis général. L’exploitation affiche ce qui fonctionne déjà, selon vos connaissances. L’exploration affiche un élément incertain pour en apprendre davantage. Un système qui ne fait qu’exploiter n’apprend jamais rien sur les nouveaux articles.
Un petit exemple détaillé
Section intitulée « Un petit exemple détaillé »Voici explore sur une liste de six produits, de A à F. Seul E est nouveau. L’emplacement est à la position 4.
| Position | Avant | Après |
|---|---|---|
| 1 | A | A |
| 2 | B | B |
| 3 | C | C |
| 4 | D | E (nouveau) |
| 5 | E (nouveau) | D |
| 6 | F | F |
La règle prend le meilleur nouveau produit, E. Si E est déjà à la position 4 ou plus haut, rien ne change. Ici, il est à la position 5, alors il monte à 4, et D descend d’une place. Rien d’autre ne change. Si la liste ne contient aucun nouveau produit, rien ne change non plus.
Le code du projet fait exactement cela :
def explore(results, slot=4): """An exploration slot: the best new product (added in the last two weeks) among the candidates goes to position `slot`, so new products get seen and can earn clicks.""" added = _col("added") new = [r for r in results if added[r[0]] >= NEW_FROM] if not new or new[0] in results[:slot]: return results rest = [r for r in results if r[0] != new[0][0]] return rest[: slot - 1] + [new[0]] + rest[slot - 1:]NEW_FROM correspond au 13 octobre 2025, deux semaines avant la fin du journal.
Larkfield : mesurer les deux idées
Section intitulée « Larkfield : mesurer les deux idées »D’abord, l’emplacement pour « kids chair » :
search query "kids chair" --run ltr+explore -k 5ltr+explore: "kids chair" -> 5 results (query W-131: judged results are marked) 1. LK-17212 gearld modern kids chair Kids Chairs 412.99 [exact] 2. LK-32609 raziel kids club chair Kids Chairs 500.99 [exact] 3. LK-75196 pamrapo kids cotton chair Kids Chairs 513.99 [exact] 4. LK-68994 flint hills club kids chair Kids Chairs 586.99 [exact] 5. LK-58375 little modern kids chair 78.99 [exact]
Description textuelle du diagramme
Deux listes de cinq produits. À gauche, ltr, où le nouveau produit est au rang 65 : gearld modern kids chair, raziel kids club chair, pamrapo kids cotton chair, little modern kids chair, ruckus kids chair, tous exacts. À droite, ltr avec l’emplacement d’exploration : les trois premiers sont identiques, puis flint hills club kids chair (exact, nouveau produit ajouté le 20 octobre 2025) au rang 4, puis little modern kids chair. Les deux listes obtiennent un NDCG@10 de 1,000.
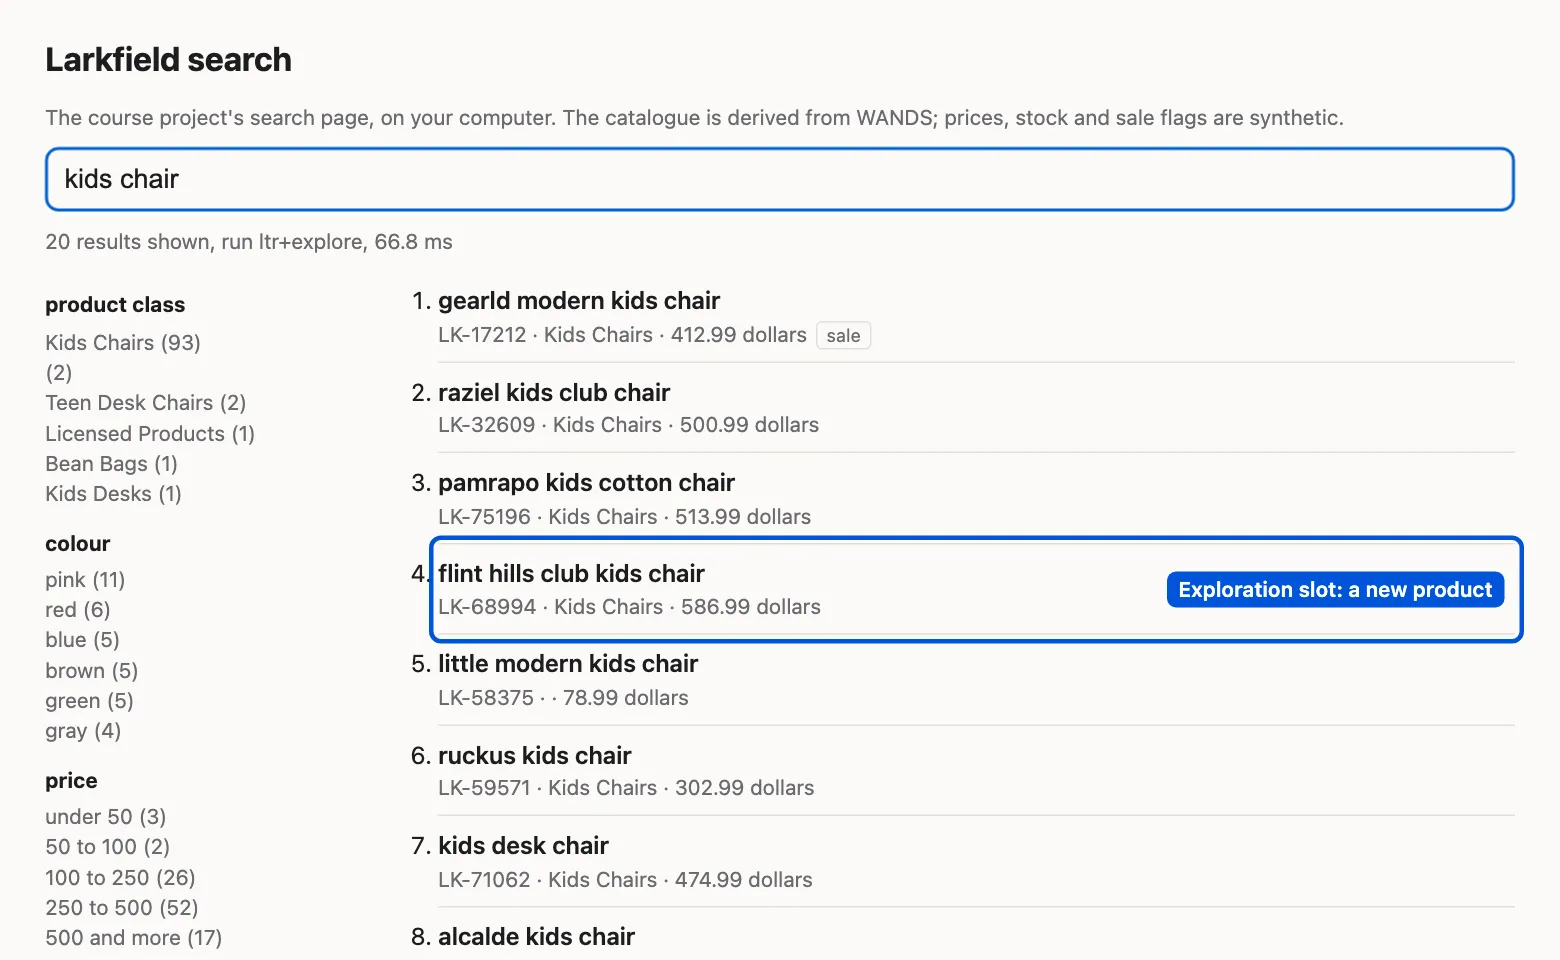
Pour cette requête, l’emplacement ne coûte rien : le nouveau produit est exact. Ce n’est pas le cas pour l’ensemble des requêtes de test :
search compare ltr ltr+explore --by sourceltr+explore minus ltr on 241 test queries: ndcg@10 -0.016 (95% interval -0.020 to -0.012); better on 27, worse on 98, the same on 116
source queries ltr ltr+explore difference low high worse code 20 1.000 1.000 0.000 0.000 0.000 0 planted 3 0.571 0.550 -0.021 -0.073 0.010 1translated 59 0.474 0.454 -0.020 -0.028 -0.013 30 typo 40 0.615 0.604 -0.011 -0.022 -0.001 20 wands 119 0.729 0.711 -0.018 -0.025 -0.012 47L’emplacement place un nouveau produit à la position 4, même quand aucun nouveau produit ne convient à la requête. Sur 98 requêtes, cela fait descendre un meilleur produit. Le coût est de 0,016 de NDCG@10, une perte claire. Les requêtes de codes conservent 1,000. La règle des codes place le produit portant le code en premier, et l’emplacement touche seulement la position 4.
Comparons maintenant les deux idées. À quels rangs se trouvent les nouveaux produits exacts parmi les candidats de test? Et pour combien de requêtes de test un nouveau produit atteint-il les 10 premiers rangs?
Description textuelle du graphique
Un graphique à quatre barres : le rang médian des 54 nouveaux produits exacts parmi les candidats des requêtes de test. hybrid-rrf 30,5; ltr 35,5; ltr avec la valeur a priori de la classe 34; ltr avec l’emplacement d’exploration 4.
| Approche | Rang médian des nouveaux produits exacts | Requêtes de test avec un nouveau produit parmi les 10 premiers | NDCG@10 par rapport à ltr |
|---|---|---|---|
hybrid-rrf (sans variables de clics) |
30,5 | 41 | (un autre modèle de classement) |
ltr |
35,5 | 23 | 0 |
ltr + valeur a priori de la classe |
34 | 32 | 0,000 (−0,001 à +0,001) |
ltr+explore (emplacement à 4) |
4 | 193 | −0,016 (−0,020 à −0,012) |
Lisez le tableau de haut en bas :
- La recherche hybride n’a pas de variables de clics, donc elle ne pénalise pas les nouveaux produits : rang médian 30,5. Le modèle
ltrles fait descendre à 35,5. Il affiche un nouveau produit parmi les 10 premiers pour seulement 23 requêtes au lieu de 41. Voilà le démarrage à froid, mesuré. - La valeur a priori de la classe est équitable et gratuite : aucun changement du NDCG@10, et 9 requêtes supplémentaires affichent un nouveau produit. Mais elle fait passer le rang médian seulement de 35,5 à 34. Pourquoi si peu? Le produit affiché médian d’une classe reçoit peu de clics. Les 10 premiers d’une requête sont les produits populaires : pour « kids chair », leur médiane est d’environ 7 clics. Une valeur a priori équitable n’est pas un bonus.
- L’emplacement ramène la médiane à 4 et affiche un nouveau produit pour 193 requêtes. Il coûte 0,016 de NDCG@10.
La valeur a priori retire donc une pénalité injuste, et l’emplacement achète de la visibilité. Ils résolvent deux parties du problème, et vous pouvez utiliser les deux.
Une limite de nos données, en toute honnêteté : les nouveaux produits conservent leurs notes WANDS et leurs nombres d’avis, car WANDS n’a pas de dates. Dans une vraie boutique, un nouveau produit n’a pas non plus d’avis, ce qui aggrave encore son démarrage à froid.
Quand utiliser un emplacement d’exploration, et à quel coût
Section intitulée « Quand utiliser un emplacement d’exploration, et à quel coût »Utilisez-le quand de nouveaux produits arrivent souvent et qu’un modèle de classement entraîné utilise la popularité : boutiques, actualités, musique, offres d’emploi. Sans lui, la nouvelle partie du catalogue reste invisible.
Limitez-le. L’emplacement coûte de la pertinence sur chaque page où le meilleur nouveau produit ne convient pas. Trois limites courantes :
- Seulement pour de bonnes correspondances. Utilisez l’emplacement seulement si le nouveau produit figure déjà parmi les 20 premiers de l’étape un, par exemple. Nous n’avons pas mesuré cette version : essayez-la vous-même.
- Seulement pour un temps. Un produit quitte le groupe des « nouveaux » après deux semaines, ou après un certain nombre d’affichages.
- Seulement pour une partie du trafic. Affichez l’emplacement pour une partie des recherches, puis comparez les clics et les ajouts au panier avec le reste. Tester les changements en ligne montre comment faire.
Mesurez la bonne chose. Le NDCG@10 hors ligne peut seulement montrer le coût de l’emplacement. Le gain vient plus tard : les clics renseignent le modèle de classement sur les nouveaux produits. Seul un test en ligne peut montrer ce gain.
Erreur courante
Nouveaux produits qui ne remontent jamais
Symptôme : mois après mois, les mêmes produits occupent le haut de chaque page. Les nouveaux produits se vendent mal, et les acheteurs cessent de commander de nouvelles gammes.
Cause : la boucle de rétroaction des clics de Apprendre des clics, sans rien pour l’arrêter. Avec ltr, un nouveau produit exact se trouve au rang médian 35,5.
Diagnostic : comparez le rang médian des nouveaux produits exacts sans variables de clics (hybrid-rrf, 30,5) et avec elles (ltr, 35,5). Comptez les nouveaux produits affichés au moins une fois dans le journal : ici, 35 sur 600.
Correction : donnez aux nouveaux produits une valeur a priori équitable pour leur historique manquant, et un emplacement d’exploration aux limites claires. Vérifiez ensuite que les clics obtenus servent au prochain entraînement.
Conséquence pour le travail en IA : un système qui apprend de ses propres sorties doit avoir un moyen prévu pour essayer de nouveaux articles. L’exploration est ce moyen, et son prix doit être mesuré comme celui de tout autre changement.
Essayez vous-même
Section intitulée « Essayez vous-même »L’emplacement est à la position 4. Avant toute exécution, faites une prédiction : la position 2 coûte-t-elle plus ou moins? Dans business.py, changez l’emplacement (la valeur par défaut slot=4) à 2, puis exécutez :
search compare ltr ltr+exploreRemettez ensuite l’emplacement à 4.
Notre résultat, et ce qu’il montre
ltr+explore minus ltr on 241 test queries: ndcg@10 -0.026 (95% interval -0.033 to -0.021); better on 26, worse on 103, the same on 112La position 2 coûte 0,026, contre 0,016 à la position 4. Un emplacement plus haut fait descendre un meilleur produit d’une place plus importante. Le NDCG accorde le plus grand poids aux premières places. Cet emplacement donne aussi plus d’attention au nouveau produit. Dans le modèle de clics du cours, un produit à la position 2 est regardé deux fois plus souvent qu’à la position 4. La bonne place est un choix d’affaires : combien de pertinence vous payez pour combien de visibilité.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Omar dit : « Les nouveaux produits ne reçoivent aucun clic, donc les gens n'en veulent pas. Retirons-les de la recherche. » Que dit vraiment le journal?
Afficher la réponse
Il dit que les gens ne les ont pas vus. Seulement 35 des 600 nouveaux produits ont déjà été affichés dans le journal synthétique. Un produit jamais affiché ne peut pas recevoir de clic. Le modèle de classement a placé un nouveau produit exact, flint hills club kids chair, au rang 65. La raison était son manque de clics, pas son texte. Aucun clic signifie aucune donnée, pas un mauvais produit.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
L'emplacement d'exploration coûte 0,016 de NDCG@10 sur les requêtes de test. Pourquoi un test hors ligne ne peut-il pas montrer son avantage?
Afficher la réponse
L’avantage est l’apprentissage futur. Les nouveaux produits sont affichés et reçoivent des clics, puis le prochain modèle de classement apprend lesquels sont bons. Le test hors ligne utilise des jugements fixes et un modèle de classement fixe. Il voit donc seulement le coût du déplacement d’un produit à la position 4. Pour voir le gain, il faut un test en ligne sur plusieurs semaines qui réentraîne le modèle de classement.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Pourquoi donner aux nouveaux produits les clics médians de leur classe a-t-il changé si peu de choses?
Afficher la réponse
La plupart des produits d’une classe reçoivent peu de clics, donc la médiane est faible. Les 10 premiers d’une requête sont les produits populaires : pour « kids chair », leur médiane est d’environ 7 clics. Une valeur a priori équitable retire la pénalité de « zéro clic ». Mais elle ne donne pas à un nouveau produit la popularité apparente des meilleures ventes. C’est pourquoi l’emplacement reste nécessaire pour la visibilité.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Le démarrage à froid : un nouveau produit n’a aucun clic, alors un modèle utilisant les clics le classe bas. Il ne reçoit donc aucun clic. Dans le journal synthétique, seulement 35 des 600 nouveaux produits ont déjà été affichés.
- Les variables de contenu (BM25, dense) traitent un nouveau produit équitablement. Les variables de clics ne le font pas. Une nouvelle chaise pour enfants notée exacte est au rang 65 avec
ltr, et au rang 7 avec des clics typiques. - Une valeur a priori de la classe pour l’historique manquant est équitable et gratuite (variation du NDCG@10 de 0,000). Mais elle déplace peu les nouveaux produits.
- Un emplacement d’exploration à la position 4 fait passer les nouveaux produits exacts d’un rang médian de 35,5 à 4. Il coûte 0,016 de NDCG@10. Limitez-le, et mesurez son avantage en ligne.
- La page de recherche a maintenant la saisie semi-automatique, des facettes, une solution de repli, des règles d’affaires et un emplacement pour les nouveaux produits.
Chaque partie de ce module ajoute du travail à chaque recherche : suggestions, décomptes, règles. Dans le prochain module, vous mesurez le coût en temps et en argent de chaque étape d’une recherche. Vous décidez ensuite ce qui tient dans le budget de 200 ms d’Amira.
Leçon suivante : Budgets de latence et de coût