
Une rétroaction digne de confiance
- Leçon 13
- 50 min
- Module 4 : États d'interaction propres à l'IA
Où nous en sommes
Dans les deux dernières leçons, le bureau a suivi un brouillon en flux continu et une tâche en arrière-plan jusqu'à la fin. Mais un brouillon terminé n'est pas toujours fiable, et chaque brouillon semble aussi sûr que les autres. Dans cette leçon, nous montrons les sources du brouillon, son incertitude, quand une personne doit traiter le billet, et des erreurs qui disent quoi faire, comme les notes qu'une bonne collègue ajoute à une lettre.
Leçon 13 sur 19 · Architecture frontend et performance des applications d'IAUne rétroaction digne de confiance
1. Premiers pas avec le Web
2. Composants et structure de l'application
3. Récupération des données et gestion de l'état
4. États d'interaction propres à l'IA
5. Performance et capacité de croissance
6. Sécurité, accessibilité et remise du travail
Ce que vous saurez faire
Aidez l’agent à décider rapidement jusqu’où faire confiance à un brouillon d’IA. Montrez d’où viennent les faits, quand l’assistant hésite, quand une personne doit traiter le billet et quoi faire en cas d’échec.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les états du brouillon et la vérification finale, dans Interfaces en flux continu.
- Les états de la tâche et pourquoi seule une tâche en échec définitif propose Try again (réessayer), dans Traitement en arrière-plan.
- La structure des erreurs de l’API (
code,message,request_id,fields) etRetry-After, dans Validation et réponses d’erreur du cours Créer et déployer votre première API.
Ce qu’il vous faut sur votre ordinateur
- Votre projet
ticket-deskaprès Traitement en arrière-plan :npm testse termine parTests 38 passed (38). - L’instantané
end-of-m04, pour copier les fichiers de cette leçon.
Testé avec Node.js 24.18 sur macOS (Apple silicon), dans Chromium. Les commandes Windows (PowerShell) et Linux sont fournies, mais n’ont pas été testées.
Une lettre rédigée par une nouvelle collègue
Section intitulée « Une lettre rédigée par une nouvelle collègue »Une nouvelle collègue rédige une lettre que vous devez signer. Une bonne collègue ne vous remet pas seulement la lettre. Elle ajoute de petites notes dans la marge. « Les délais de remboursement viennent de la politique de remboursement, section 4 : voici la phrase. » « Je n’étais pas certaine pour la garantie du cabanon; veuillez vérifier. » « N’envoyez pas cette lettre vous-même : le client menace de poursuivre en justice, alors la responsable d’équipe doit répondre. » Vous lisez les notes d’abord. En quelques secondes, vous savez où regarder et quoi faire.
Une collègue moins rigoureuse vous remet la même lettre sans notes. Elle se lit tout aussi bien. Vous vérifiez chaque phrase vous-même, ou vous faites confiance à tout le contenu. Les deux options sont mauvaises.
Le brouillon d’IA sur le bureau des billets est la lettre de cette nouvelle collègue. Cette leçon ajoute les notes.
Le problème : tous les brouillons semblent aussi certains
Section intitulée « Le problème : tous les brouillons semblent aussi certains »Les brouillons enregistrés contiennent plus que la réponse. Chacun contient un reason, une confidence, un indicateur needs_human et, pour les questions de politique, les passages qui appuient ses affirmations. Un bureau qui affiche seulement la réponse élimine tout cela. Regardez deux vrais brouillons enregistrés.
T-80007 : « Vous avez débité ma carte deux fois pour la commande LK-350972 (deux débits de 74,50 le 29 septembre). J’ai déjà fait deux demandes. Si les deux débits ne sont pas corrigés d’ici vendredi, je porterai l’affaire aux petites créances. » Le brouillon enregistré dit :
I'm sorry you've had to follow up about the two charges. A member of our team will contact you to review this and discuss the next steps.Il est poli et correct. Mais le modèle a aussi défini needs_human: true, avec la raison « la menace de recours aux petites créances exige un traitement humain ». Sans cet indicateur à l’écran, un agent pourrait envoyer la réponse et fermer le billet. Une menace de poursuite attend alors dans un billet fermé.
T-64979 : une cliente demande quand le remboursement de ses housses de coussin retournées arrivera sur sa carte. Le brouillon dit « dans un délai de 5 à 10 jours ouvrables ». Il contient trois sources, qui ne concordent pas. La politique de remboursement indique 5 à 10 jours ouvrables, mais la FAQ du centre d’aide indique 3 jours ouvrables. Sans les sources, l’agent ne peut pas voir cette contradiction.
Les erreurs posent le même problème. À la fin du module 3, le bureau affichait le message de l’API et proposait toujours Try again (réessayer). Ouvrez un billet inexistant, T-99999, et le bureau disait « Il n’existe aucun billet T-99999. », avec un bouton Try again. Le billet n’existera pas davantage au deuxième essai.
L’idée : quatre types de notes
Section intitulée « L’idée : quatre types de notes »Un écran digne de confiance ajoute quatre types de notes à un résultat d’IA. Chacun répond à une question de l’agent :
- Sources (citations) : « D’où vient ce fait? » Une citation relie une affirmation du brouillon au passage d’un document qui l’appuie. Elle indique le nom, la version et la section du document. L’agent peut vérifier une affirmation sans chercher.
- Incertitude : « L’assistant est-il certain? » Le bureau l’indique quand l’assistant n’est pas certain, avec des mots, jamais avec un nombre faussement précis.
- Actions de révision : « Que dois-je en faire? » Un brouillon ne va jamais au client de lui-même. Use this draft (utiliser ce brouillon) le copie dans le formulaire de réponse, où l’agent le lit, le modifie et l’envoie. Quand le modèle définit
needs_human, le bureau indique clairement qu’une personne doit traiter le billet. - Erreurs récupérables : « Qu’est-ce qui a échoué, et que puis-je faire? » Les erreurs utilisent les mots de l’agent. Try again apparaît seulement si réessayer peut aider.
Ces notes ne rendent pas le modèle plus exact. Elles rendent ses erreurs plus faciles à repérer.
Un petit exemple : ce que contiennent les 69 brouillons enregistrés
Section intitulée « Un petit exemple : ce que contiennent les 69 brouillons enregistrés »L’API simulée rejoue 69 vrais brouillons de chat-small du cours Créer des applications fiables avec les API de LLM. Certains contiennent aussi les réponses avec citations du cours RAG : créer une IA qui utilise vos données. Avant de concevoir l’écran, comptez ce que les notes indiqueraient :
| Note | Brouillons enregistrés | Ce que le bureau affiche |
|---|---|---|
needs_human: true |
11 sur 69 | « Une personne doit traiter ce billet. » et la raison, dans un encadré jaune |
| Sources | 8 sur 69 | la liste des affirmations, chacune avec son passage cité |
| Les documents ne répondent pas | 1 sur 69 | « Les documents de politique ne répondent pas à… » dans un encadré jaune |
| Aucune question de politique | 60 sur 69 | « Ce brouillon n’a aucune source. Vérifiez vous-même chaque fait qu’il contient. » |
Confiance high (élevée) |
65 sur 69 | rien de plus |
Confiance medium (moyenne) ou low (faible) |
3 et 1 sur 69 | « L’assistant n’est pas certain de ce brouillon (confiance : …). » |
Deux nombres ressortent. La plupart des brouillons, 60 sur 69, n’ont aucune source. Le bureau doit donc indiquer clairement « aucune source », sinon l’agent suppose qu’un brouillon sans notes est fiable. Et 65 brouillons sur 69 indiquent high. La confiance est une étiquette que le modèle s’est donnée, pas une probabilité mesurée. Une mention verte « élevée » sur presque tous les brouillons apprendrait aux agents à l’ignorer. Le bureau ne dit donc rien pour high, et s’exprime seulement pour medium et low.
Montrer les sources
Section intitulée « Montrer les sources »Citations.tsx affiche les sources du brouillon. Il prévoit trois cas, et les deux premiers sont des avertissements en mots :
const policy = draft.policy_answer;if (!policy) return <p className="muted">This draft has no sources. Check every fact in it yourself.</p>;if (!policy.answerable || draft.citations.length === 0) { return ( <p className="notice"> The policy documents do not answer “{policy.question}”. Do not promise anything about it without checking. </p> );}return ( <section className="citations" aria-label="Sources"> <h4>Sources (policy question: {policy.question})</h4> <ol> {draft.citations.map((c, i) => ( <li key={`${c.id}-${i}`}> <p>{c.claim}</p> <blockquote cite={`#passage-${c.id}`}> {c.quote} <footer>{c.document}, section “{c.section}” ({c.version})</footer> </blockquote> </li> ))} </ol> </section>);Chaque source affiche d’abord l’affirmation, puis la citation exacte, puis son origine : le document, la section et la version. La version compte, car les politiques changent; les documents du cours RAG : créer une IA qui utilise vos données ont des dates d’entrée en vigueur. L’élément <blockquote> indique aux navigateurs et aux lecteurs d’écran qu’il s’agit de texte cité.
Voici T-64979 sur le bureau :
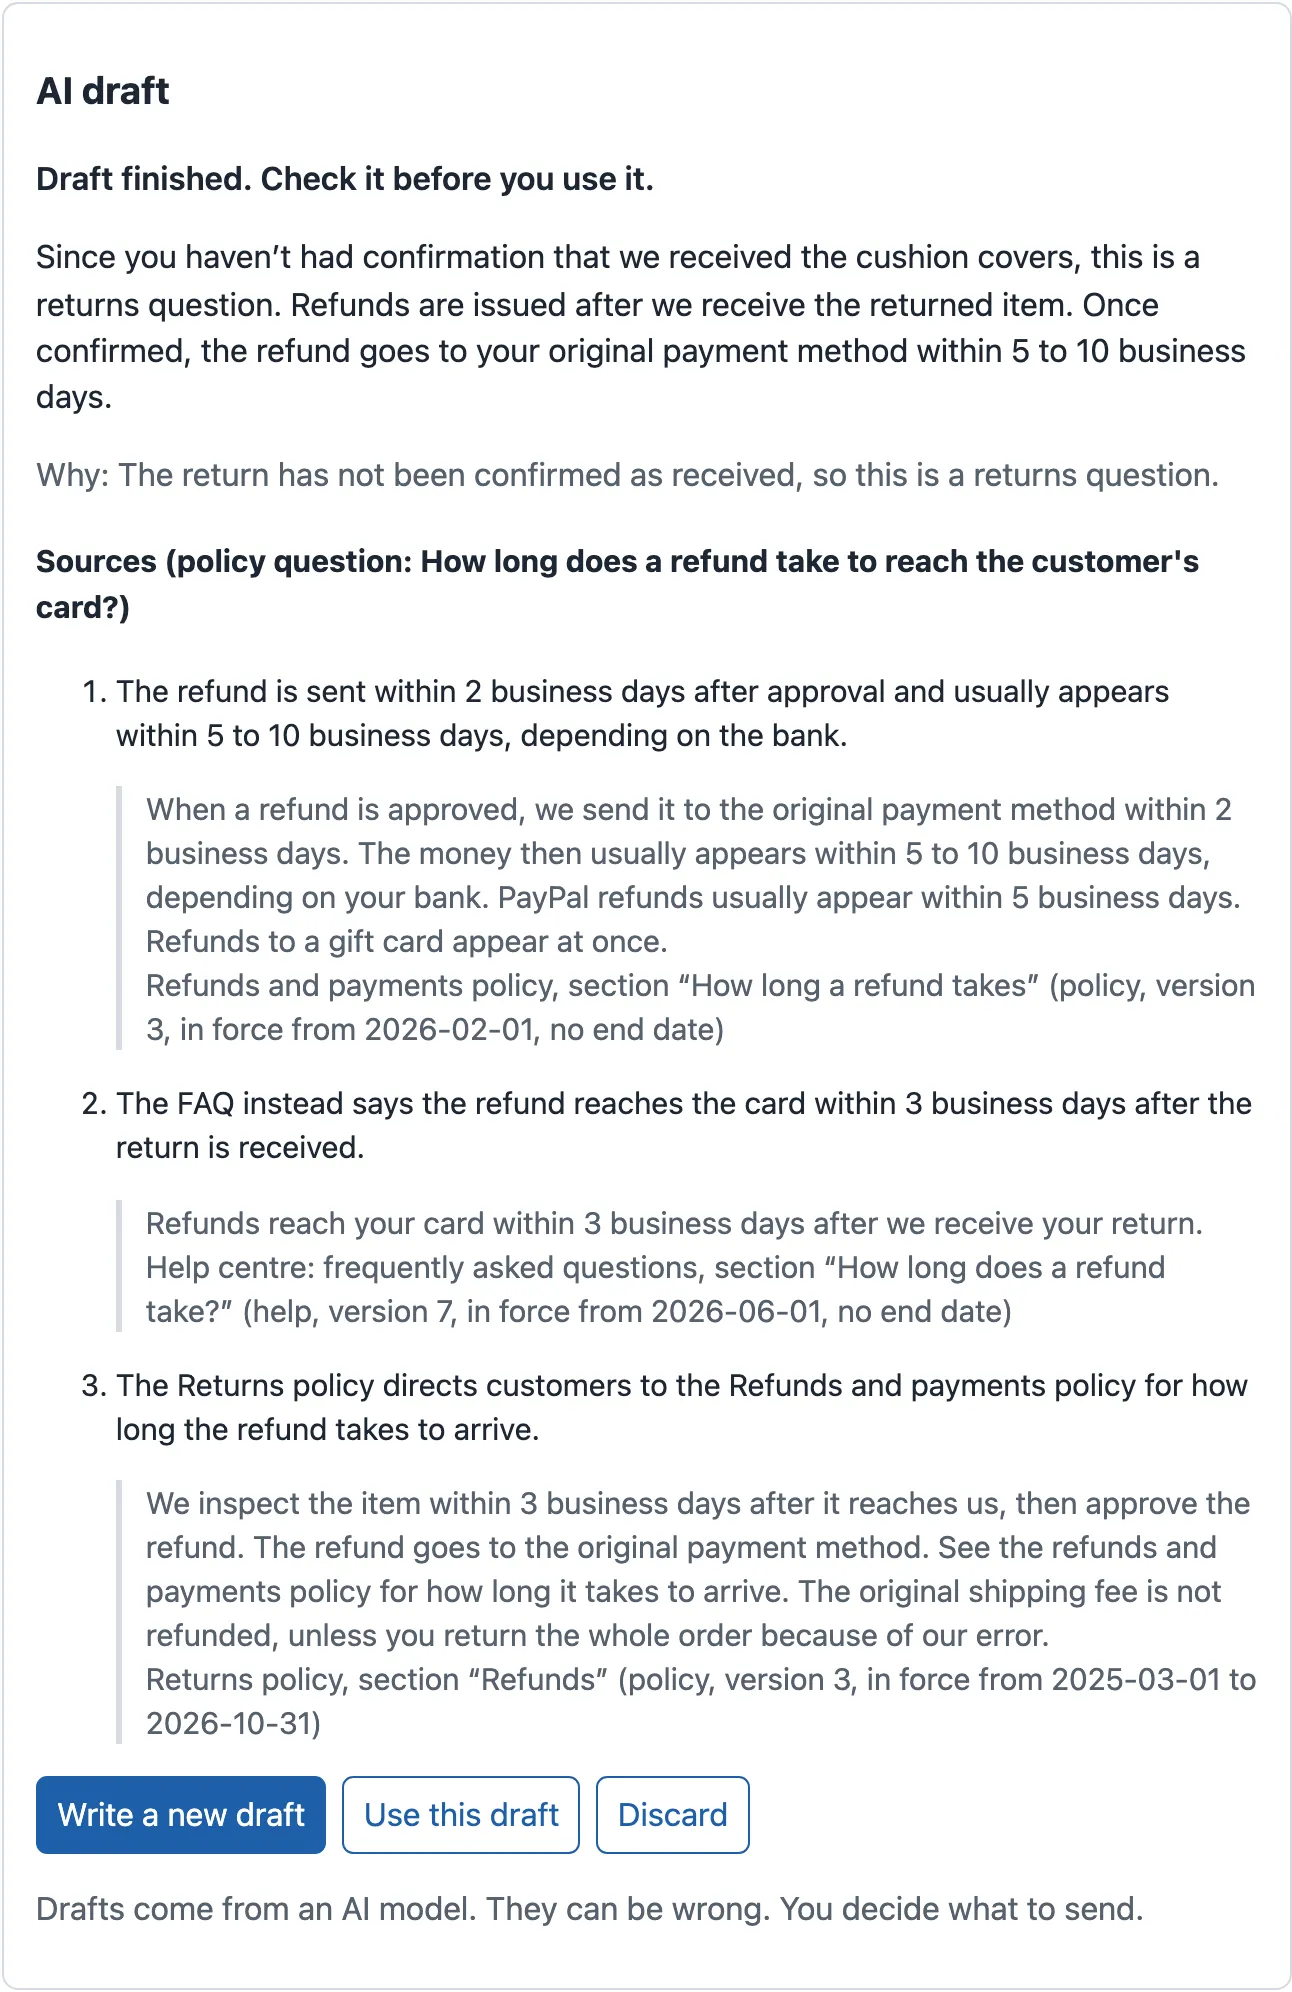
La deuxième source dit « 3 jours ouvrables », la première dit « 5 à 10 ». La réponse a choisi la politique. L’agent peut maintenant décider de mentionner la FAQ ou de demander à l’équipe de la corriger. Répondre et citer, dans le cours RAG : créer une IA qui utilise vos données, montre comment ces affirmations et passages sont produits et vérifiés.
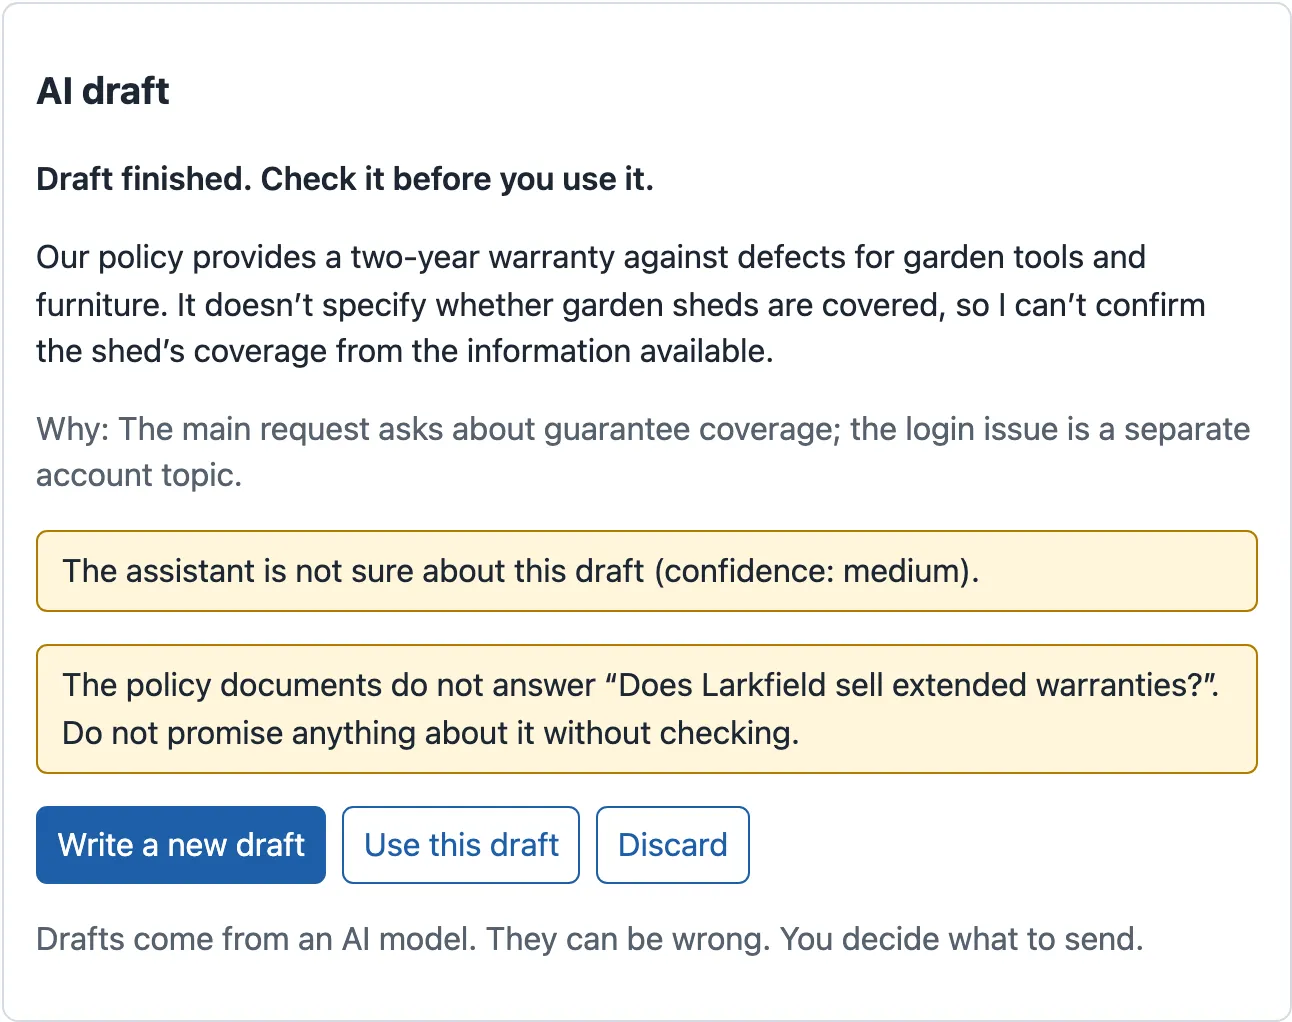
Quand les documents ne répondent pas, le bureau le dit. T-64702 demande ce que couvre la garantie d’un cabanon de jardin. L’assistant chargé des politiques n’a trouvé aucune réponse à sa question, et la confiance du modèle était medium :
Dire quand une personne doit décider
Section intitulée « Dire quand une personne doit décider »Le panneau du brouillon place needs_human en premier, dans un encadré jaune avec la raison du modèle :
{state.draft.needs_human ? ( <p className="notice"> <strong>A person must handle this ticket.</strong> {state.draft.reason} </p>) : ( <p className="muted">Why: {state.draft.reason}</p>)}{state.draft.confidence !== 'high' && ( <p className="notice">The assistant is not sure about this draft (confidence: {state.draft.confidence}).</p>)}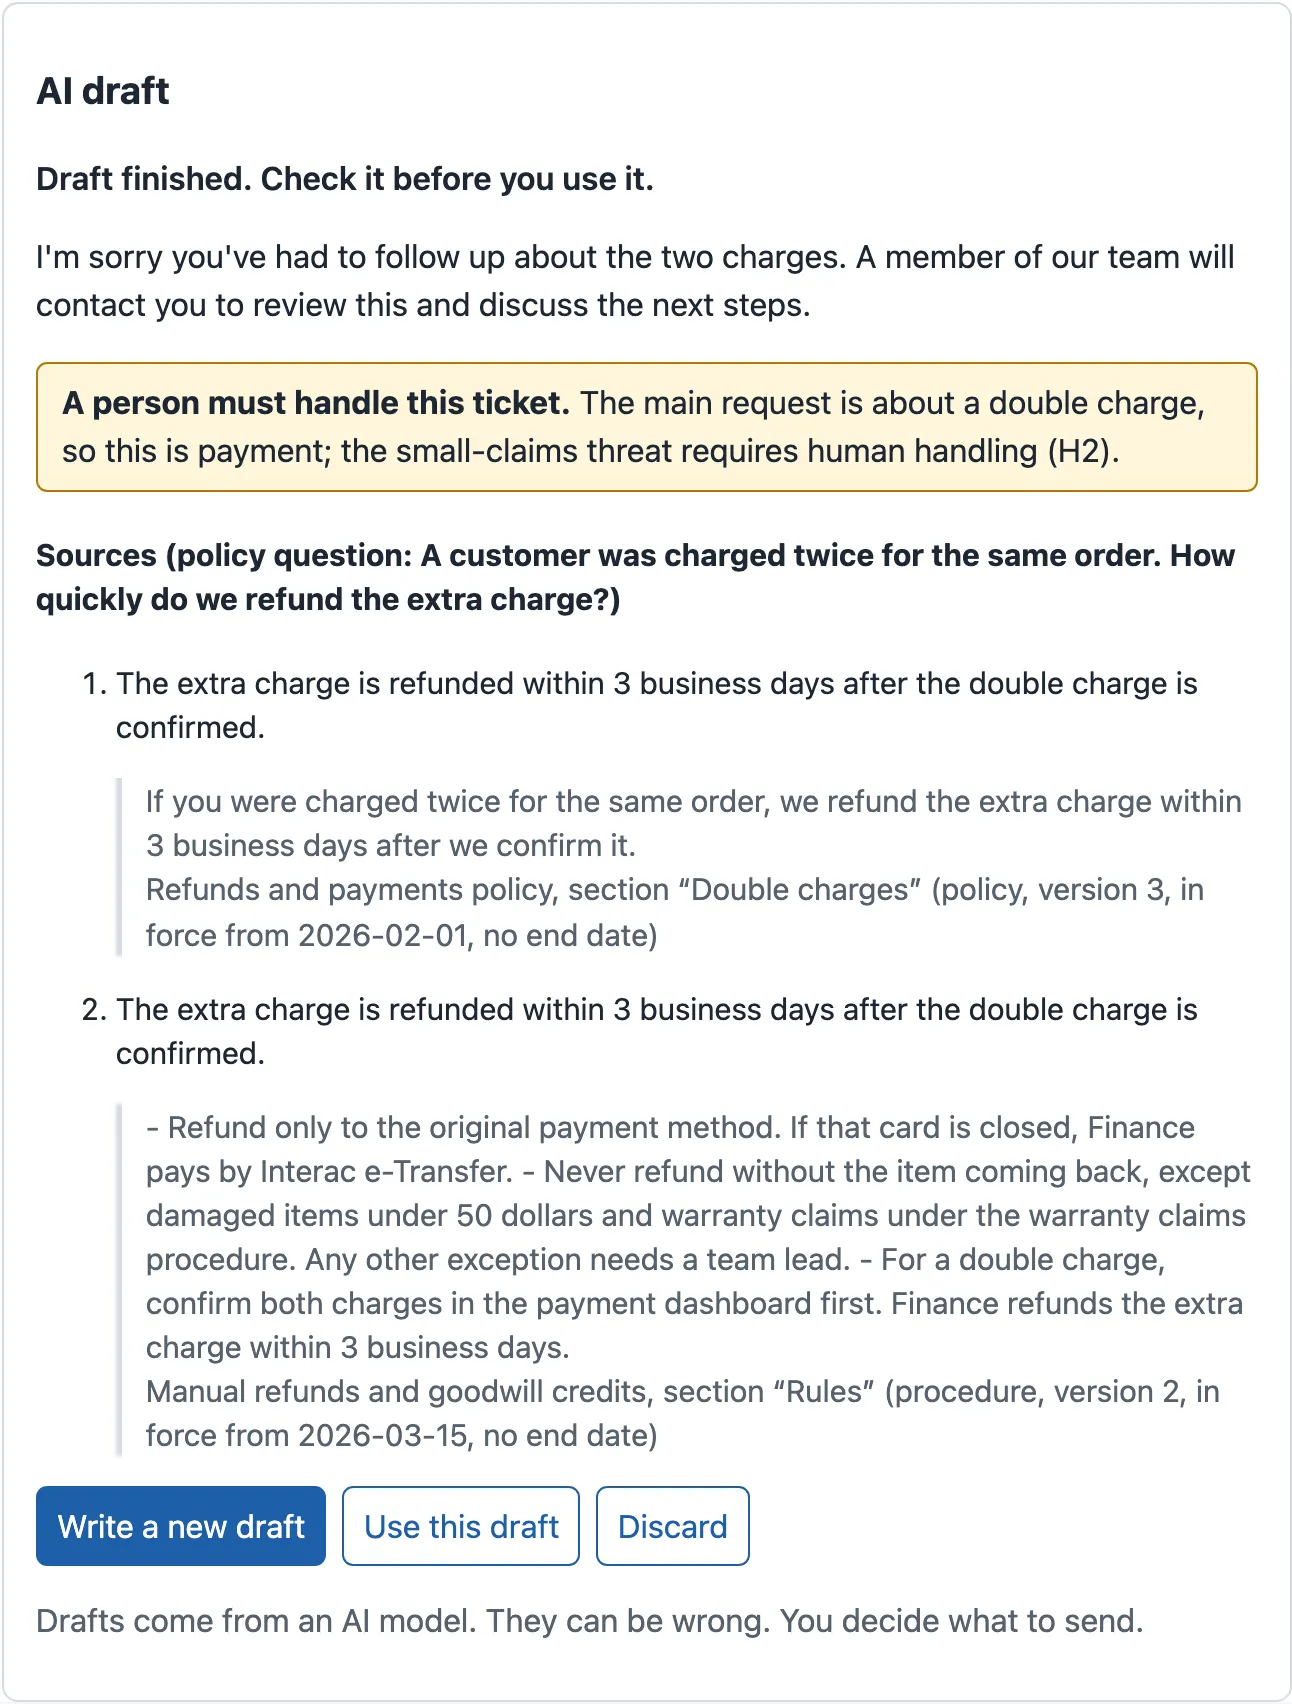
Le brouillon de T-80006 est le seul brouillon enregistré dont la confiance est low. Le client a envoyé seulement une pièce jointe, sans texte. Le modèle n’avait donc rien à lire :
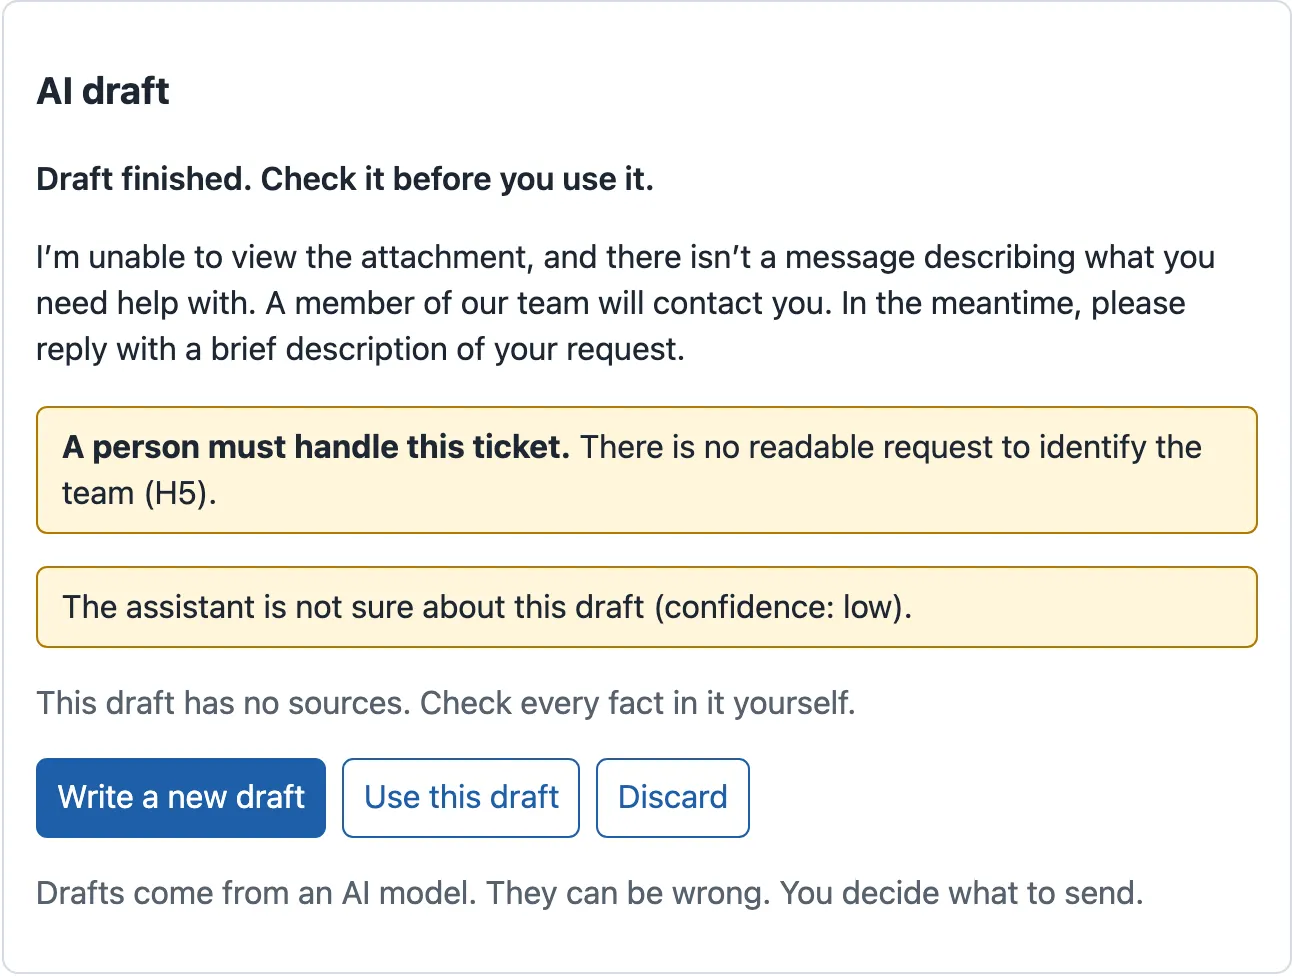
Regardez ce que le bureau ne fait pas. Il ne masque pas Use this draft pour ces billets. L’agent est la personne qui les traite, et le brouillon peut quand même constituer un bon point de départ. Et le bureau n’envoie jamais rien. Use this draft copie la réponse dans le formulaire de réponse :
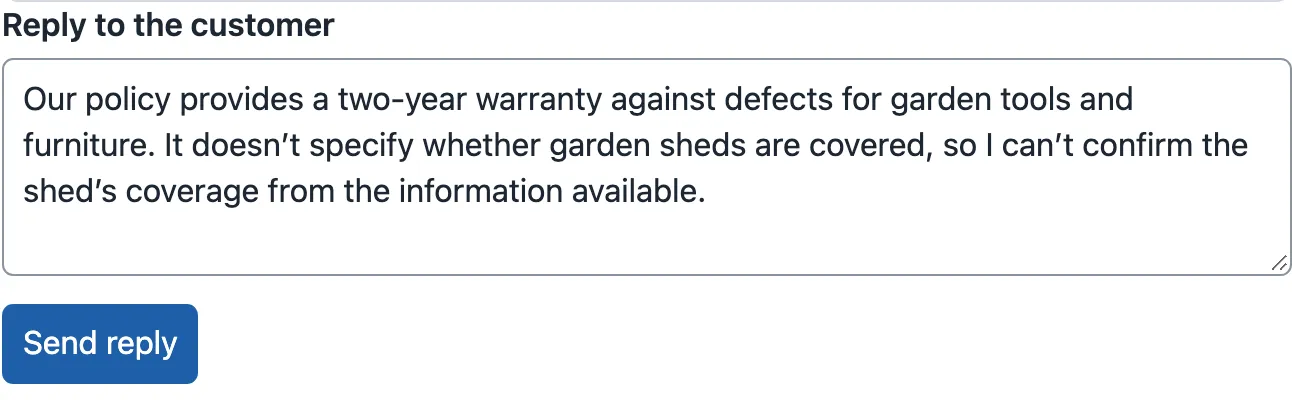
C’est l’action de révision : l’étape où une personne accepte, modifie ou refuse un résultat d’IA. La conception place la décision devant l’agent, avec les notes à côté.
Des erreurs qui indiquent quoi faire
Section intitulée « Des erreurs qui indiquent quoi faire »Le dernier type de notes concerne les échecs. Jusqu’ici, le bureau affichait le message de l’API, rédigé pour les développeurs. Maintenant, src/lib/errors.ts transforme chaque code d’erreur en une phrase pour l’agent et indique si réessayer peut aider :
const BY_CODE: Record<string, Described> = {  network_error: { text: 'The ticket service did not answer. Check your connection, then try again.', canRetry: true },  unavailable: { text: 'The ticket service is busy. Try again in a few seconds.', canRetry: true },  ai_unavailable: { text: 'The AI service stopped answering. Your work is safe. Try again.', canRetry: true },  no_draft: { text: 'No AI draft exists for this ticket. Write the reply yourself.', canRetry: false },  not_found: { text: 'This item does not exist. It may have been removed.', canRetry: false },  invalid_request: { text: 'Some information is not valid. Check the marked fields.', canRetry: false },  conflict: { text: 'Someone or something changed this item first. Look at its new state.', canRetry: false },  idempotency_key_reused: { text: 'This form was already sent with other content. Reload the page.', canRetry: false },};
export function describeError(error: Error): Described {  if (error instanceof ApiError) {    const known = BY_CODE[error.code];    if (known) {      if (error.retryAfter) return { ...known, text: known.text.replace('a few seconds', `${error.retryAfter} seconds`) };      return known;    }    return { text: error.message, canRetry: error.status >= 500 };  }  return { text: 'Something went wrong in this page. Reload it to try again.', canRetry: false };}
Le bureau utilise le code, pas le message. Le contrat de l’API garantit des codes stables, alors que le message peut changer. Chaque phrase suit la même structure : ce qui s’est passé, puis ce que l’agent peut faire. Quand le serveur envoie Retry-After: 2, « quelques secondes » devient « 2 secondes ». ErrorMessage.tsx affiche maintenant la phrase et propose Try again seulement quand canRetry est vrai. Le diagramme montre la décision :

Description textuelle du diagramme
Une erreur arrive à l’écran. Si c’est une ApiError avec un code connu, le bureau utilise les mots de l’agent tirés du tableau. Il ajoute le délai Retry-After quand il y en a un. Si c’est une ApiError avec un code inconnu, le bureau affiche le message de l’API. Si ce n’est pas du tout une ApiError, il s’agit d’un bogue dans la page. Le bureau dit alors « Un problème est survenu dans cette page. Rechargez-la pour réessayer. » Ensuite, le bureau décide s’il affiche le bouton. Pour un code connu, le tableau indique si réessayer peut aider. Pour un code inconnu, un statut de 500 ou plus indique un problème de serveur qui pourrait disparaître. Le bureau propose donc Try again. Sinon, il n’y a aucun bouton, et le texte indique plutôt quoi faire.
Ajouter les notes et les messages au bureau des billets
Section intitulée « Ajouter les notes et les messages au bureau des billets »-
Dans
~/projects/ticket-desk, copiez les derniers fichiers de ce module à partir de l’instantané.ErrorMessage.tsxchange,errors.test.tsest nouveau, et le test de la liste attend les nouveaux messages.package.json, le fichier de verrouillage et le README passent à la version 0.4.0.Fenêtre de terminal S=../nextia-learning-labs/C22/snapshots/end-of-m04for f in src/ui/ErrorMessage.tsx src/lib/errors.test.ts src/features/tickets/TicketList.test.tsx \package.json package-lock.json README.md; docp "$S/$f" "$f"doneFenêtre de terminal $S = "..\nextia-learning-labs\C22\snapshots\end-of-m04"$files = 'src\ui\ErrorMessage.tsx', 'src\lib\errors.test.ts', 'src\features\tickets\TicketList.test.tsx','package.json', 'package-lock.json', 'README.md'foreach ($f in $files) { Copy-Item "$S\$f" $f }Votre projet contient maintenant les mêmes fichiers que l’instantané
end-of-m04. -
Exécutez les tests :
Fenêtre de terminal npm testLa partie de l’API simulée se termine par
ℹ tests 21etℹ pass 21. La partie de l’interface se termine par :Test Files 15 passed (15)Tests 40 passed (40)Cela fait 61 vérifications en tout. Un test de la liste a changé : « affiche un serveur occupé en mots simples et permet de réessayer » attend maintenant « Le service de billets est occupé. ».
-
Générez les fichiers de production, comme à la fin de chaque module :
Fenêtre de terminal npm run buildLa fin de la sortie affiche un fichier JavaScript d’environ 281 ko, soit 86,55 ko avec gzip. Votre temps de construction sera différent.
-
Démarrez l’API simulée (
npm run api) et le bureau (npm run dev). Ouvrez http://localhost:5173/#/tickets/T-64979, puis cliquez sur Write a draft (rédiger un brouillon). Lisez les trois sources et trouvez celle qui contredit les autres. -
Ouvrez T-80007, T-80006 et T-64702 de la même façon. Pour chacun, dites ce que les encadrés jaunes vous indiquent avant de lire la réponse.
-
Cliquez sur Use this draft dans T-64702. Le formulaire de réponse contient maintenant le texte, et rien n’a été envoyé.
-
Ouvrez http://localhost:5173/#/tickets/T-99999. Le bureau dit « Cet élément n’existe pas. Il a peut-être été supprimé. », sans Try again.
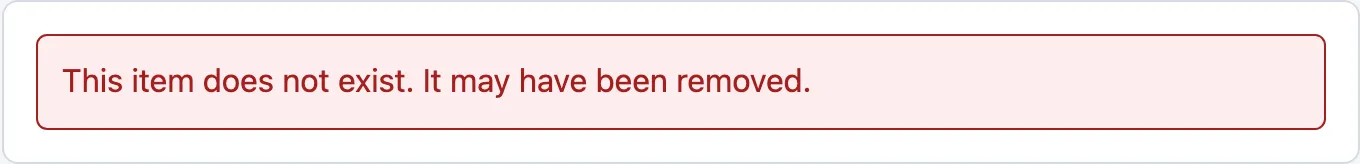
Un billet inexistant : des mots pour l'agent, sans bouton inutile. L’image est en anglais. -
Arrêtez l’API simulée, puis démarrez-la avec
node mock-api/server.mjs --list fail. Cet échec est simulé : chaque requête de liste reçoit503avecRetry-After: 2. Ouvrez http://localhost:5173/#/tickets. TanStack Query réessaie deux fois de plus, puis la liste affiche l’erreur.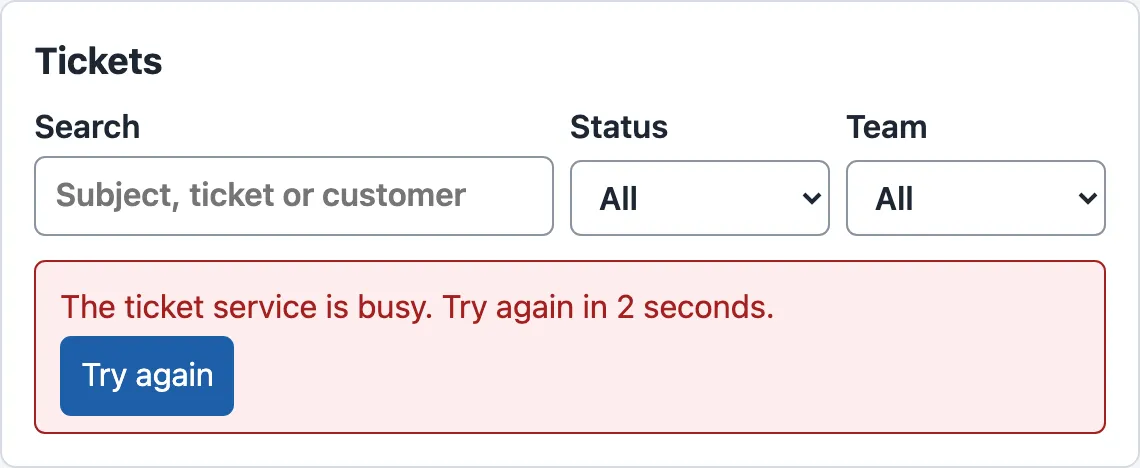
Un serveur occupé : le délai de Retry-After, en mots, et un bouton Try again, car cette erreur est temporaire. L’image est en anglais. -
Arrêtez l’API simulée, puis redémarrez-la avec
npm run api. Cliquez sur Try again. La liste apparaît.
Quand ajouter ces notes, et ce qu’elles coûtent
Section intitulée « Quand ajouter ces notes, et ce qu’elles coûtent »Ajoutez ces notes partout où une personne agit sur un résultat d’IA : un brouillon, un résumé, une classification qui oriente le travail. Elles coûtent peu en code : Citations.tsx compte 32 lignes, et errors.ts en compte 30. Le vrai coût est ailleurs :
- Le serveur doit envoyer les faits. Le bureau peut afficher seulement ce que l’API retourne : les sources, l’indicateur et la raison. Si l’API envoie seulement du texte, demandez d’abord les champs. Les cours Créer des applications fiables avec les API de LLM et RAG : créer une IA qui utilise vos données les ont construits.
- Espace et attention. Chaque note prend de l’espace et un moment de lecture. Le bureau s’exprime donc seulement quand il a quelque chose à dire : aucun encadré pour une confiance
high. Quand aucune personne n’est requise, il affiche un discret « Pourquoi » en gris. - Messages à maintenir. Chaque code d’erreur exige une phrase et un test. Un code inconnu utilise le message de l’API, donc un nouveau code affiche quand même quelque chose.
N’inventez pas de précision. La confiance du modèle est un mot qu’il a choisi, pas une probabilité que quelqu’un a mesurée. Afficher « certain à 92 % » prétendrait qu’une mesure inexistante a été faite. Seuils et calibration, dans le cours Apprentissage automatique : du problème à un modèle fiable, montre comment vérifier une vraie probabilité.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Réessayer après une erreur qui ne peut pas changer
Symptôme : un billet n’a pas de brouillon d’IA, ou il n’existe pas. Le bureau affiche Try again (réessayer). L’agent clique dessus, attend et obtient la même erreur.
Cause : l’ancien ErrorMessage affichait le bouton dès que la page lui passait une fonction onRetry. Il ne vérifiait pas si l’erreur pouvait disparaître.
Solution : décidez selon le code d’erreur. describeError() renvoie canRetry, et ErrorMessage affiche le bouton seulement si cette valeur est vraie. errors.test.ts vérifie que no_draft donne canRetry: false, avec « Rédigez la réponse vous-même. » comme prochaine étape.
Erreur courante
Afficher la confiance sous forme de score coloré sur chaque brouillon
Symptôme (construit) : Tomás affiche une pastille verte « Confiance : élevée » sur chaque brouillon. Après une semaine, les agents cessent de la regarder.
Cause : 65 des 69 brouillons enregistrés indiquent high (élevée), même ceux qui nécessitent une personne, comme T-80007. Une pastille qui ne change presque jamais donne très peu d’information.
Solution : affichez l’incertitude seulement lorsqu’elle est présente (medium (moyenne), low (faible)), avec des mots. Placez needs_human et les sources en premier. Ces notes changent ce que l’agent fait.
À vous de jouer : des mots pour une requête trop volumineuse
Section intitulée « À vous de jouer : des mots pour une requête trop volumineuse »Changez une condition : un nouveau code d’erreur. L’API simulée répond 413 avec le code too_large quand le corps d’une requête dépasse 16 Ko. Aujourd’hui, le bureau affiche le message de l’API, « Le corps de la requête dépasse 16 Ko. », sans Try again. Rédigez le message destiné à l’agent pour cette erreur. Ajoutez d’abord une vérification à errors.test.ts et exécutez-la : elle doit échouer. Ajoutez ensuite le code à BY_CODE, décidez si réessayer peut aider, puis relancez le test. Avant de commencer, faites une prédiction : canRetry change-t-il par rapport au comportement actuel du bureau?
Afficher la réponse
Dans src/lib/errors.test.ts, ajoutez ces lignes au premier test :
expect(describeError(new ApiError(413, 'too_large', 'x'))).toEqual({ text: 'This text is too long to send. Make it shorter, then send it again.', canRetry: false,});npx vitest run src/lib/errors.test.ts échoue, car le bureau affiche encore le message de l’API (ici, le 'x' du test). La sortie, abrégée :
× known codes become plain words, with whether to try again- "text": "This text is too long to send. Make it shorter, then send it again.",+ "text": "x", Tests 1 failed | 1 passed (2)Ajoutez ensuite une entrée à BY_CODE dans src/lib/errors.ts :
too_large: { text: 'This text is too long to send. Make it shorter, then send it again.', canRetry: false },Le test réussit : Tests 2 passed (2). canRetry ne change pas. Sans cette entrée, le statut 413 est inférieur à 500, donc le bureau ne proposait déjà aucun bouton. C’est la phrase qui change : elle indique maintenant quoi faire, dans les mots de l’agent. Envoyer le même texte de nouveau ne peut pas aider, donc il n’y a toujours pas de bouton Try again. L’instantané ne contient pas ce changement.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Le brouillon de T-80007 est poli et correct. Pourquoi le bureau doit-il afficher needs_human et sa raison au-dessus de la réponse? Que se passerait-il sans ces notes?
Afficher la réponse
Le client menace d’aller à la cour des petites créances. Le modèle a défini needs_human: true, car cette menace nécessite une personne. La réponse seule, « Un membre de notre équipe vous contactera… », semble terminée. Un agent pourrait l’envoyer et fermer le billet. La menace juridique resterait alors dans un billet fermé. L’encadré jaune « Une personne doit traiter ce billet. » et la raison indiquent quoi faire avant de lire la réponse. Le bureau propose encore Use this draft (utiliser ce brouillon), car l’agent est cette personne; il n’envoie jamais rien lui-même.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Faites une prédiction : l'API répond 503 avec le code unavailable et Retry-After : 2 pour la liste, et 404 avec le code no_draft pour un brouillon. Que voit l'agent dans chaque cas, et lequel propose un bouton Try again?
Afficher la réponse
Pour la liste : « Le service de billets est occupé. Réessayez dans 2 secondes. » avec Try again, car un serveur occupé peut redevenir disponible. La valeur de Retry-After remplace « quelques secondes ». Pour le brouillon : « Aucun brouillon d’IA n’existe pour ce billet. Rédigez la réponse vous-même. », sans bouton. Le brouillon n’existera pas à la prochaine tentative; le message indique plutôt la prochaine étape.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
65 des 69 brouillons enregistrés ont une confiance high. Omar veut une grosse pastille verte « confiance élevée » sur chacun. Que recommandez-vous, et pourquoi?
Afficher la réponse
N’affichez rien de plus pour high, et affichez une phrase pour medium et low. La confiance est une étiquette que le modèle s’attribue, pas une probabilité mesurée. Elle vaut high sur presque tous les brouillons, même T-80007, qui nécessite une personne. Une pastille qui ne change presque jamais apprend aux agents à l’ignorer. Les notes qui changent ce que fait un agent sont needs_human et sa raison, les sources et l’avertissement quand les documents ne répondent pas.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Exercice du module : un flux simulé et l’état d’un document
Section intitulée « Exercice du module : un flux simulé et l’état d’un document »L’exercice de ce module comporte deux parties. D’abord, un exemple détaillé où chaque étape est visible. Ensuite, une tâche à réaliser vous-même, dans le même projet.
Exercice guidé : tester une fin de flux simulé
Section intitulée « Exercice guidé : tester une fin de flux simulé »Un flux simulé est une fausse réponse construite par un test pour tester le panneau sans l’API simulée. src/test/stream.ts contient deux fonctions utilitaires : sseResponse(events) envoie une liste d’événements, puis ferme le flux. openStream(events, signal) envoie des événements, puis attend l’arrêt de la requête. Écrivez un test qui vérifie le brouillon terminé, avec chaque valeur visible.
-
Créez
src/features/draft/DraftEndings.test.tsxavec ce contenu :src/features/draft/DraftEndings.test.tsx // Module 4's practice: the endings of a mock streamed draft must look different.import { render, screen } from '@testing-library/react';import userEvent from '@testing-library/user-event';import { expect, test } from 'vitest';import { installFakeApi } from '../../test/fakeApi';import { fullDraft, openStream, sseResponse } from '../../test/stream';import { DraftPanel } from './DraftPanel';const pieces: [string, unknown][] = [['start', { model: 'chat-small' }],['token', { text: 'Your refund' }],['token', { text: ' is on its way.' }],];async function startDraft() {render(<DraftPanel ticketId="T-64979" onUse={() => {}} />);await userEvent.click(screen.getByRole('button', { name: 'Write a draft' }));}test('completion: black text, Use this draft, no alert', async () => {installFakeApi(() => sseResponse([...pieces, ['done', fullDraft]]));await startDraft();expect(await screen.findByText('Draft finished. Check it before you use it.')).toBeInTheDocument();expect(screen.getByText('Your refund is on its way.')).not.toHaveClass('muted');expect(screen.getByRole('button', { name: 'Use this draft' })).toBeInTheDocument();expect(screen.queryByRole('alert')).not.toBeInTheDocument();});Le flux simulé envoie
start, deux morceaux (« Votre remboursement », « est en route. »), puisdoneavecfullDraft. Sa valeurreplyest exactement « Votre remboursement est en route. ». La vérification finale réussit donc. -
Exécutez seulement ce fichier :
Fenêtre de terminal npx vitest run src/features/draft/DraftEndings.test.tsxLa sortie se termine par :
Test Files 1 passed (1)Tests 1 passed (1) -
Vérifiez que le test peut échouer. Dans le test, remplacez
' is on its way.'par' is on the way.', puis relancez-le. La réponse finale ne correspond plus au texte reçu en flux continu, donc le panneau afficheinvalid(invalide). La sortie montre le test qui échoue et le HTML du panneau (abrégé) :× completion: black text, Use this draft, no alertTestingLibraryElementError: Unable to find an element with the text: Draft finished. Check it before you use it..data-status="invalid"The draft did not pass the checks. Do not use it.C’est la vérification finale d’Interfaces en flux continu en action. Remettez le texte d’origine.
Tâche autonome
Section intitulée « Tâche autonome »Faites deux choses vous-même, avec des tests :
- Annulation et échec. Ajoutez deux tests à
DraftEndings.test.tsx: un où l’agent appuie sur Stop (arrêter), avecopenStream, et un où le flux envoie un événementerror. Chaque test doit montrer que sa fin se distingue du brouillon terminé. Vérifiez les mots, la couleur du texte (la classemuted), le bouton Use this draft et l’alerte. - Une vue de l’état d’un document. Larkfield permettra aux clients de joindre une facture PDF. Le serveur la lit en arrière-plan, comme une tâche avec les mêmes six états. Créez
src/features/documents/DocumentStatus.tsx. Ce composant reçoit unjobIdet unfileName, et suit la tâche avecuseJobPolling. Il décrit chaque état avec des mots qui concernent le document. Il propose Cancel the reading (annuler la lecture) pendant l’attente, et Try again seulement pour une tâche définitivement abandonnée. Testez-le avec l’API simulée : un test qui suitqueued → running → succeeded, et un qui distingue une lecture annulée d’une lecture échouée.
Afficher une solution détaillée
Les deux nouveaux tests pour le brouillon :
test('cancellation: grey text, no Use this draft, no alert', async () => {  installFakeApi((_url, init) => openStream(pieces, init.signal));  await startDraft();  await screen.findByText('Your refund is on its way.');  await userEvent.click(screen.getByRole('button', { name: 'Stop' }));  expect(screen.getByText(/You stopped the draft/)).toBeInTheDocument();  expect(screen.getByText('Your refund is on its way.')).toHaveClass('muted');  expect(screen.queryByRole('button', { name: 'Use this draft' })).not.toBeInTheDocument();  expect(screen.queryByRole('alert')).not.toBeInTheDocument();});
test('failure: an alert in words, no Use this draft', async () => {  installFakeApi(() => sseResponse([...pieces.slice(0, 2), ['error', { error: { code: 'ai_unavailable', message: 'x' } }]]));  await startDraft();  expect(await screen.findByRole('alert')).toHaveTextContent('The AI service stopped answering');  expect(screen.getByText('No draft.')).toBeInTheDocument();  expect(screen.queryByRole('button', { name: 'Use this draft' })).not.toBeInTheDocument();});
L’état du document réutilise les fonctions de la tâche et change seulement les mots :
import type { JobState } from '../../api/jobs';import { ErrorMessage } from '../../ui/ErrorMessage';import { useJobActions, useJobPolling } from '../jobs/useJob';
// The same six job states, in the words of a document that the server reads in the background.const TEXT: Record<JobState, string> = {  queued: 'The document waits to be read.',  running: 'Reading the document…',  succeeded: 'The document is read.',  failed: 'This document cannot be read. Ask the customer for another copy.',  cancelled: 'You cancelled the reading. The document is saved without it.',  dead_letter: 'Reading failed several times and stopped. You can try again later.',};
/** The background reading of one attached document: polled every second until it is final. */export function DocumentStatus({ jobId, fileName }: { jobId: number; fileName: string }) {  const job = useJobPolling(jobId);  const { cancel, retry } = useJobActions(jobId);
if (job.isPending) return <p className="muted">Checking the document…</p>; if (job.isError) return <ErrorMessage error={job.error} onRetry={() => job.refetch()} />; const j = job.data; const bad = j.state === 'failed' || j.state === 'dead_letter'; return ( <section aria-label={`Document ${fileName}`} data-state={j.state}> <p role="status" className={bad ? 'error' : j.state === 'succeeded' ? 'success' : undefined}> {fileName}: {TEXT[j.state]} </p> {j.state === 'queued' && ( <button type="button" className="secondary" onClick={() => cancel.mutate()}> Cancel the reading </button> )} {j.state === 'dead_letter' && ( <button type="button" onClick={() => retry.mutate()}> Try again </button> )} </section> );}import { screen } from '@testing-library/react';import userEvent from '@testing-library/user-event';import { expect, test } from 'vitest';import type { Job } from '../../api/jobs';import { installFakeApi, json } from '../../test/fakeApi';import { renderWithCache } from '../../test/render';import { DocumentStatus } from './DocumentStatus';
const job = (state: Job['state']): Job => ({ job_id: 7, ticket_id: 'T-500001', state, attempts: 1, max_attempts: 5, created_at: '', started_at: null, finished_at: null, last_error: null, result: null,});
test('follows the reading until it is done', async () => { const states = [job('queued'), job('running'), job('succeeded')]; installFakeApi(() => json(200, states.length > 1 ? states.shift() : states[0])); renderWithCache(<DocumentStatus jobId={7} fileName="invoice.pdf" />); expect(await screen.findByText('invoice.pdf: The document waits to be read.')).toBeInTheDocument(); expect(await screen.findByText('invoice.pdf: The document is read.', {}, { timeout: 4000 })).toBeInTheDocument();});
test('cancelled, done and failed look different', async () => { installFakeApi((url) => json(200, url.pathname.endsWith('/cancel') ? job('cancelled') : job('queued'))); const first = renderWithCache(<DocumentStatus jobId={7} fileName="invoice.pdf" />); await userEvent.click(await screen.findByRole('button', { name: 'Cancel the reading' })); const cancelled = await screen.findByRole('status'); expect(cancelled).toHaveTextContent('You cancelled the reading'); expect(cancelled).not.toHaveClass('error'); expect(cancelled).not.toHaveClass('success'); first.unmount();
installFakeApi(() => json(200, job('failed'))); renderWithCache(<DocumentStatus jobId={7} fileName="invoice.pdf" />); const failed = await screen.findByText(/cannot be read/); expect(failed).toHaveClass('error'); expect(screen.queryByRole('button')).not.toBeInTheDocument();});npx tsc --noEmit n’affiche rien, puis npm test se termine par Test Files 17 passed (17) et Tests 45 passed (45). Le premier test de document prend environ 2 secondes, car il interroge le serveur une fois par seconde. L’instantané end-of-m04 ne contient pas ces fichiers.
Pourquoi cette conception : la lecture du document est le même type de tâche. Elle réutilise donc useJobPolling et useJobActions, et seuls les mots changent. Une lecture annulée n’a pas de couleur (l’agent l’a choisi), une lecture échouée est rouge, et une lecture terminée est verte. Les tests vérifient les mots, la classe et les boutons, pas seulement le texte.
Vérifiez votre compréhension
Vérification de fin de module : montrez comment le bureau des billets distingue visuellement l'annulation, la fin et l'échec, pour le brouillon en flux continu et la tâche en arrière-plan. Nommez les différences à l'écran et le test qui les vérifie.
Afficher la réponse
Le brouillon. Fin (done) : « Brouillon terminé. Vérifiez-le avant de l’utiliser. », le texte en noir, la raison et les sources, et Use this draft. Annulation (stopped) : « Vous avez arrêté le brouillon. Le texte ci-dessous est incomplet. », le texte en gris (muted), seulement Write a new draft (rédiger un nouveau brouillon) et Discard (supprimer), sans alerte. Un flux interrompu ressemble à une annulation, avec sa propre phrase. Échec (failed) : « Aucun brouillon. » et une alerte rouge avec des mots, sans Use this draft. DraftPanel.test.tsx contient un test pour chaque fin, et DraftEndings.test.tsx, dans l’exercice du module, vérifie la classe, le bouton et l’alerte.
La tâche. Terminée : « Le travail de l’IA est terminé. » en vert, avec l’équipe. Annulée : « Vous avez annulé le travail de l’IA. Le billet est enregistré sans ce travail. », sans couleur. Échouée : en rouge, « Réessayer ne sera pas utile », sans bouton. Définitivement abandonnée : en rouge, avec Try again. JobStatus.test.tsx vérifie que l’échec et l’abandon définitif se distinguent, et qu’une tâche en attente peut être annulée. Dans les deux vues, chaque fin a ses propres mots, sa propre apparence et seulement les boutons utiles.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un écran digne de confiance ajoute quatre notes à un résultat d’IA : sources, incertitude, actions de révision et erreurs récupérables. Elles n’améliorent pas le modèle; elles facilitent la détection de ses erreurs.
- Parmi les 69 brouillons enregistrés, 11 nécessitent une personne, 8 ont des sources, 1 n’a trouvé aucune réponse dans les documents, et 65 indiquent
high. Le bureau indique donc clairement « aucune source », placeneeds_humanen premier et parle de confiance seulement si elle n’est pashigh. - Use this draft remplit le formulaire de réponse. L’agent décide, modifie et envoie; l’IA n’envoie jamais rien.
- Les erreurs utilisent le code, avec des mots destinés à l’agent : ce qui s’est passé et quoi faire. Try again apparaît seulement quand réessayer peut aider, avec le délai de
Retry-After.
Le module 4 en un paragraphe. Le bureau des billets montre maintenant le travail de l’IA pendant son déroulement et à sa fin. Le brouillon arrive par morceaux, avec un bouton Stop. Une machine à états distingue huit états. Un brouillon arrêté, interrompu, échoué ou invalide ne semble donc jamais terminé. Le bureau suit la tâche en arrière-plan d’un nouveau billet en interrogeant le serveur chaque seconde. Le laboratoire des tâches a mesuré l’autre option : une connexion d’événements envoyés par le serveur plutôt que 5 requêtes. La fin apparaît à l’écran après 29 ms plutôt que 403 ms. Chaque résultat terminé porte ses notes : sources, needs_human, incertitude honnête et erreurs décrites avec la bonne prochaine étape. npm test réussit 61 vérifications, comme dans l’instantané end-of-m04.
Ensuite, le module 5 mesure le bureau dans le navigateur : la taille de son code et le temps d’affichage de la grande liste. Il vérifie aussi quels conseils habituels pour accélérer l’application sont vraiment utiles.
Leçon suivante : Mesurer dans le navigateur