
Règles et histogrammes de couleurs
- Leçon 5
- 40 min
- Module 2 : Références de base et classificateurs préentraînés
Où nous en sommes
Nous avons les images, les partitions et un tableau comparatif vide. Il est tentant de commencer avec un gros modèle. Dans cette leçon, nous commençons plutôt par les méthodes les plus simples : des règles de couleur et de taille, puis un histogramme de couleurs avec les plus proches voisins. D'abord, une employée de l'entrepôt des retours trie les colis à l'œil.
Leçon 5 sur 30 · IA de vision : voir, compter et inspecterRègles et histogrammes de couleurs
1. Voir est un problème d'affaires
2. Références de base et classificateurs préentraînés
3. Plongements, CLIP et peu d'étiquettes
4. Détecter et compter
5. Segmenter
6. Inspecter pour trouver les défauts
7. Apparier, chercher et décrire
8. Exploiter la vision en production
Ce que vous saurez faire
Construisez les deux classificateurs d’images les plus simples : une règle écrite à la main et un histogramme de couleurs avec les plus proches voisins. Mesurez leurs résultats sur le catalogue. Chaque méthode suivante doit les dépasser, et vous devez savoir où ils suffisent.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter contient toutes les cellules de code, tâches et vérifications de cette leçon. Ses cellules de préparation installent les paquets et téléchargent les photos du catalogue (environ 9 Mo, en fichiers zip). Aucun compte ni aucune clé ne sont nécessaires. Environ 25 minutes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les pixels, les canaux et l’espace colorimétrique HSV, présentés dans Les images sont des nombres.
- Le catalogue, ses partitions et le tableau comparatif, présentés dans Découvrir les images de Larkfield.
- L’exactitude et le rappel, présentés dans Les métriques de classification du cours Apprentissage automatique : du problème à un modèle fiable.
Ce qu’il vous faut sur votre ordinateur
- Parcours avec le carnet : un navigateur, et Colab ou Kaggle. Rien à installer.
- Parcours avec le projet : le dossier
larkvisionde la dernière leçon, à côté denextia-learning-labs, avec son environnement virtuel. Il correspond actuellement à l’instantanéstart(début). Dans cette leçon, il passe àend-of-m02(fin du module 2).
Testé avec Python 3.12.13 sur macOS. Les commandes Windows n’ont pas été testées.
Une employée trie les colis à l’œil
Section intitulée « Une employée trie les colis à l’œil »Une nouvelle employée commence à l’entrepôt des retours de Larkfield. Le premier jour, elle trie les colis retournés dans des bacs : bougies, pots de fleurs, coussins et le reste. Personne ne lui donne de liste de règles. Après une heure, elle a les siennes : « Petit et blanc, c’est une bougie. Des feuilles vertes au-dessus, c’est un pot de fleurs. Souple et clair, c’est un coussin. »
Ses règles fonctionnent dans son entrepôt, sous ses lampes, sur sa table. Dans un autre entrepôt, avec une lumière jaune et une table foncée, certaines règles ne fonctionnent plus. Le « blanc » semble maintenant crème. Cette leçon transforme ses deux raccourcis en code. Le premier est une règle qu’une personne écrit. Le deuxième est un histogramme de couleurs, qui compare les couleurs avec celles de photos connues.
Une règle qu’une personne écrit
Section intitulée « Une règle qu’une personne écrit »Priya a regardé 20 photos du catalogue et écrit quatre règles en Python. Chaque règle lit des nombres simples dans la photo, réduite à 64 × 64 pixels :
- Un centre lumineux entouré d’une bordure sombre indique une bougie (une flamme dans une pièce sombre).
- Plus de 12 % de pixels verts indique un pot de fleurs (des feuilles).
- Une photo très claire (luminosité moyenne supérieure à 170 sur 255) indique un coussin.
- Tout le reste est une chaise, la classe la plus nombreuse.
La section 2 du carnet applique cette règle aux 160 photos de test :
pred = [rule("data/" + f) for f in test["file"]]s = cp.classification_scores(list(test["label"]), pred, CLASSES)print("accuracy", s["accuracy"], "| worst class", s["worst_class"], s["worst_recall"])accuracy 0.269 | worst class bowl 0.0{'bowl': 0.0, 'candle': 0.3, 'chair': 0.8, 'cushion': 0.4, 'lamp': 0.0, 'mug': 0.0, 'plant_pot': 0.65, 'vase': 0.0}La règle donne la bonne réponse pour 26,9 % des photos. Un choix au hasard parmi huit classes donne la bonne réponse dans 12,5 % des cas. La règle a donc appris quelque chose. Le graphique montre où :
Description textuelle du graphique
Un diagramme avec huit colonnes, une par catégorie, sur un axe de 0 à 1. Bol : 0, bougie : 0,30, chaise : 0,80, coussin : 0,40, lampe : 0, tasse : 0, pot de fleurs : 0,65 et vase : 0. Les quatre catégories sans règle ne sont jamais reconnues.
Le rappel est la proportion des photos d’une catégorie que la méthode trouve. La chaise a un rappel élevé (0,80) uniquement parce que « tout le reste » devient une chaise. Le bol, la lampe, la tasse et le vase n’ont aucune règle. Ils ne sont donc jamais reconnus.
Les règles échouent aussi là où elles s’appliquent. La plupart des bougies du catalogue sont sur une table blanche, à la lumière du jour, pas dans une pièce sombre. La règle des bougies n’en trouve donc que 6 parmi les 20 bougies de test. Pour la corriger, Priya ajouterait une cinquième règle, puis une sixième. Chaque nouvelle règle empêche une ancienne de fonctionner dans certains cas. C’est le principal problème des règles : une personne doit penser à tous les cas, et les photos en présentent trop.
Un histogramme de couleurs
Section intitulée « Un histogramme de couleurs »L’employée a un deuxième raccourci. Elle ne décrit pas une bougie avec des mots. Elle se souvient de l’apparence des bougies et compare. Un ordinateur peut faire une version simple de cette opération : il compare les couleurs de deux photos.
Une photo de 256 × 256 contient 65 536 pixels. Les comparer un à un ne fonctionne pas : déplacez légèrement le produit, et chaque pixel change. Nous comptons donc les pixels à la place. Un histogramme de couleurs compte combien de pixels ont chaque couleur. Le mot « histogramme » désigne un décompte de valeurs réparties dans des groupes, appelés classes. Ces décomptes ne dépendent pas de la position du produit dans la photo.
Un petit exemple détaillé
Section intitulée « Un petit exemple détaillé »L’image ci-dessous est une petite image de 4 × 4 = 16 pixels, créée à la main pour cet exemple. V désigne le vert, B le blanc et M le brun (M pour « marron », car B est déjà pris).
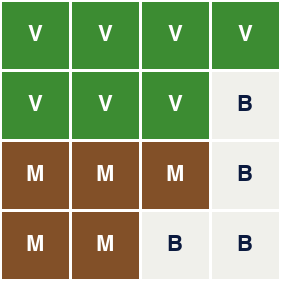
Description textuelle du diagramme
La grille compte quatre rangées de quatre carrés. La première contient quatre carrés verts. La deuxième contient trois carrés verts et un blanc. La troisième contient trois carrés bruns et un blanc. La quatrième contient deux carrés bruns et deux blancs. Au total, 7 pixels verts, 5 bruns et 4 blancs.
Comptez chaque couleur, puis divisez par 16 pour comparer équitablement les photos de toutes tailles :
| Classe | Pixels | Proportion |
|---|---|---|
| Vert | 7 | 7 / 16 = 0,44 |
| Brun | 5 | 5 / 16 = 0,31 |
| Blanc | 4 | 4 / 16 = 0,25 |
Les trois proportions forment l’histogramme de cette petite image : (0,44, 0,31, 0,25). Échangez deux pixels, et l’histogramme reste identique.
Deux vrais produits
Section intitulée « Deux vrais produits »Les vraies photos contiennent des milliers de couleurs. Les classes sont donc des plages de couleurs. L’illustration ci-dessous utilise neuf classes. Huit classes sont des plages de teinte, la position de la couleur sur le cercle chromatique, pour les couleurs nettes. Une classe contient les pixels gris, blancs et noirs.

Description textuelle du diagramme
Deux photos, chacune accompagnée d’un diagramme à neuf colonnes. La photo de bougie montre une flamme sur fond noir. Son histogramme : 16 % de rouge-orange, 3 % de rose et 80 % de gris, blanc ou noir; les autres colonnes sont à 0. La photo de pot de fleurs montre des feuilles vertes. Son histogramme : 7 % de rouge-orange, 20 % de jaune, 25 % de vert et 48 % de gris, blanc ou noir. Les deux histogrammes sont très différents. Un ordinateur peut donc distinguer ces deux photos par la couleur seule.
L’illustration simplifie les choses. La méthode du cours utilise 128 classes : 8 plages de teinte × 4 de saturation × 4 de valeur. La saturation indique la force de la couleur, et la valeur indique sa luminosité. Ce sont les trois composantes de l’espace colorimétrique HSV. Le code prend la racine carrée de chaque proportion. Cela rend les distances entre histogrammes plus équitables (le carnet l’explique en une ligne).
Les plus proches voisins : comparer avec des photos connues
Section intitulée « Les plus proches voisins : comparer avec des photos connues »Nous avons maintenant un histogramme par photo. Comment le transformer en étiquette? L’employée compare un nouveau colis avec des colis dont elle se souvient. La méthode fait la même chose. Elle trouve les photos d’entraînement dont les histogrammes sont les plus proches de celui de la nouvelle photo. Elle prend ensuite leur étiquette. C’est la méthode des k plus proches voisins, ou k-NN : k est le nombre de photos proches qui votent.
« Proche » signifie une courte distance. Calculez les différences entre deux histogrammes, classe par classe. Élevez-les au carré, additionnez-les, puis prenez la racine carrée. Voici la petite image comparée à trois images d’entraînement avec trois classes. Les nombres sont inventés pour l’exemple :
| Image d’entraînement | Vert | Brun | Blanc | Distance par rapport à (0,44, 0,31, 0,25) |
|---|---|---|---|---|
| Pot de fleurs | 0,50 | 0,30 | 0,20 | √(0,06² + 0,01² + 0,05²) = 0,08 |
| Bol | 0,10 | 0,60 | 0,30 | √(0,34² + 0,29² + 0,05²) = 0,45 |
| Coussin | 0,05 | 0,05 | 0,90 | √(0,39² + 0,26² + 0,65²) = 0,80 |
Avec k = 1, l’image la plus proche vote seule : la petite image est un pot de fleurs. Avec k = 3, les trois votent, avec une voix chacune. Il n’y a alors aucune majorité, et la méthode départage les votes avec une règle fixe. Un k plus grand est plus stable, car un seul voisin inhabituel ne décide pas. Mais une petite classe a moins de photos pour voter. Gardez cela en tête pour la bougie.
L’histogramme sur le catalogue de Larkfield
Section intitulée « L’histogramme sur le catalogue de Larkfield »Les sections 3 et 4 du carnet calculent l’histogramme de chaque photo et entraînent k-NN avec k = 5 :
knn = KNeighborsClassifier(5, n_jobs=1).fit(Xtr, train["label"])for name, X, y in (("catalogue test", Xte, test["label"]), ("new studio", Xst, studio["label"])): s = cp.classification_scores(list(y), list(knn.predict(X)), CLASSES) print(f"{name:15s} accuracy {s['accuracy']} worst {s['worst_class']} {s['worst_recall']}")catalogue test accuracy 0.263 worst vase 0.05new studio accuracy 0.225 worst cushion 0.0L’histogramme atteint une exactitude de 0,263, à peu près comme la règle. Il ne trouve qu’un vase de test sur 20. Regardez un vase et les cinq photos d’entraînement que la méthode a trouvées les plus proches :

Description textuelle du diagramme
Six photos sur une rangée. La première est la photo de test : un vase brun rond avec des fleurs séchées. Les cinq suivantes sont ses photos d’entraînement les plus proches selon l’histogramme de couleurs, chacune avec son étiquette et sa distance : une chaise en bois à 0,48, un fauteuil en cuir brun à 0,56, un pot de fleurs rouges à 0,57, un bol blanc sur une table en bois brun à 0,60 et une tasse de thé sur une table brune à 0,62. Les six photos sont surtout brunes et blanches. Aucune des cinq n’est un vase, donc la méthode répond « chaise ».
Chaque voisin est brun et blanc, comme le vase. La méthode a fait exactement ce qu’elle promettait : elle a trouvé les mêmes couleurs. Mais la couleur ne distingue pas un vase d’une chaise. Le vase d’entraînement le plus proche est à une distance de 0,691, loin derrière le cinquième voisin. Dans le catalogue, les produits de chaque catégorie existent dans toutes les couleurs.
Combien de voisins?
Section intitulée « Combien de voisins? »L’exercice du carnet (section 5) vous fait essayer k = 1 et k = 15. Voici les résultats de l’équipe du cours :
| k | Exactitude (test) | Rappel des bougies | Exactitude (nouveau studio) |
|---|---|---|---|
| 1 | 0,275 | 0,15 | 0,269 |
| 5 | 0,263 | 0,1 | 0,225 |
| 15 | 0,325 | 0 | 0,275 |
Avec k = 15, l’exactitude monte à 0,325, mais le rappel des bougies tombe à 0. La classe des bougies n’a que 15 photos d’entraînement (un problème que nous avons inséré). Avec 15 votants, les grandes classes gagnent presque toujours le vote. Un meilleur résultat global peut cacher un moins bon résultat pour la classe qui compte. C’est pourquoi le tableau comparatif contient une colonne worst (pire résultat).
Ajouter la référence de base à votre projet
Section intitulée « Ajouter la référence de base à votre projet »Le projet reçoit les deux mêmes méthodes sous forme de commande, vision baseline. Vous copiez les nouveaux fichiers depuis l’instantané end-of-m02. Avant de les copier, vérifiez votre emplacement : vous devez être dans votre dossier larkvision, avec l’environnement virtuel actif.
-
Ouvrez un terminal et allez dans votre dossier
larkvision. Activez l’environnement virtuel :source .venv/bin/activatesur macOS et Linux,.venv\Scripts\Activate.ps1sur Windows. -
Si c’est un nouveau terminal, définissez de nouveau
LARKVISION_DATA. Cette variable existe seulement dans le terminal où vous la définissez. La commande est à l’étape 5 de Le projet sur votre ordinateur. -
Copiez les fichiers de ce module depuis l’instantané :
Fenêtre de terminal S=../nextia-learning-labs/C42/snapshots/end-of-m02for f in larkvision/features.py larkvision/commands/baseline.py tests/test_baseline.py requirements.txt README.md; do cp "$S/$f" "$f"; doneFenêtre de terminal $S = "..\nextia-learning-labs\C42\snapshots\end-of-m02"foreach ($f in 'larkvision\features.py', 'larkvision\commands\baseline.py', 'tests\test_baseline.py', 'requirements.txt', 'README.md') { Copy-Item "$S\$f" $f } -
Installez les nouveaux paquets.
requirements.txtajoute maintenant SciPy, scikit-learn et scikit-image :Fenêtre de terminal pip install -r requirements.txt -
Exécutez les tests. Vous voyez
11 passed(11 tests réussis). Les deux nouveaux tests entraînent les deux méthodes sur un petit dossier de données fictives :Fenêtre de terminal python -m pytest -q -
Exécutez l’histogramme de couleurs sur le catalogue. Cela prend environ 2 secondes :
Fenêtre de terminal vision baseline --method histogram
La sortie de l’étape 6 :
colour histogram + 5-NN, catalogue test: accuracy 0.263; worst class vase (recall 0.05); 1.0 ms per photocolour histogram + 5-NN, new studio: accuracy 0.225; worst class cushion (recall 0.00); 0.9 ms per photoAdded to outputs/table.json. See it with: vision compare --task catalogueLes exactitudes sont celles du carnet. Vos millisecondes diffèrent : elles dépendent de votre ordinateur. larkvision/features.py contient la fonction colour_histogram, avec le même code que dans le carnet. vision baseline --k 15 essaie un autre k. Votre projet correspond maintenant à l’instantané end-of-m02, sauf pour votre propre dossier outputs (sorties).
Où une règle de couleur gagne
Section intitulée « Où une règle de couleur gagne »Jusqu’ici, la couleur a perdu. Mais le catalogue est le cas difficile pour la couleur. Ses photos proviennent de milliers de caméras, de pièces et d’éclairages. Prenons maintenant le cas opposé : une caméra, un éclairage, une table, un produit.
Les photos de retours de Hamid sont comme cela. Chaque lampion (bougie chauffe-plat) est photographié du dessus, sur le même fond, sous le même éclairage. Dans ce cas, une règle de couleur a une vraie chance. L’équipe du cours en a écrit une : compter les pixels sur la cire beaucoup plus sombres ou colorés que la cire autour. Beaucoup de pixels inhabituels indiquent une bougie endommagée. Le nombre de pixels inhabituels est le score de la photo. Deux seuils sur ce score déterminent la décision. Au seuil de vérification ou au-dessus, une personne regarde. Au seuil de rejet ou au-dessus, l’article va au magasin de liquidation. Les deux seuils ont été choisis sur les photos de validation, puis évalués une fois sur les photos de test. Fixer les seuils avec l’entrepôt montre comment les choisir.
- Référence
- La règle de couleur
- Le minimum
Description textuelle du graphique
Un diagramme à quatre colonnes, en dollars par jour pour 600 retours. Aucune vérification : 2 229,4. Une personne vérifie 100 retours au hasard : 1 907,8. La règle de couleur : 1 779,4. Un inspecteur parfait : 24,8. La règle de couleur est la moins chère des trois premières options, et loin d’être parfaite.
La règle coûte 1 779 $ US par jour. C’est moins que remettre tous les retours en vente (2 229), et moins que 100 vérifications au hasard (1 908). Elle envoie environ 91 retours par jour à une personne, dans le budget de 100 de Hamid. Elle ne marque aucune bonne bougie comme endommagée. Elle ne nécessite aucune photo étiquetée, aucun fichier de modèle, et prend 2,09 ms par photo.
Mais il faut aussi montrer le reste honnêtement. La règle n’a trouvé que 4 des 18 bougies de test endommagées. Elle ne détecte pas un morceau de cire manquant, car le trou a la même couleur que la cire. Environ 39 articles endommagés par jour seraient encore remis en vente. Les modules suivants atteignent 369 $ US par jour avec des modèles qui comparent de petites parties de chaque photo.
Quand utiliser les règles et les histogrammes
Section intitulée « Quand utiliser les règles et les histogrammes »- Utilisez-les quand la caméra, l’éclairage et le fond sont fixes, et que les classes diffèrent par couleur ou luminosité. Une ligne de tri avec un produit de chaque couleur est un bon cas. Utilisez-les aussi comme première ligne d’un tableau comparatif. Leur construction prend quelques minutes, et leur exécution environ 1 ms sur n’importe quel ordinateur.
- Ne les utilisez pas quand les photos proviennent de nombreuses caméras ou de nombreux éclairages, comme dans le catalogue. Évitez-les aussi quand deux classes partagent des couleurs (vases bruns et chaises brunes).
- Leur coût : presque rien à l’exécution. Le vrai coût est le temps d’une personne pour écrire et corriger les règles. Et si l’éclairage change, chaque règle et chaque histogramme changent aussi.
Erreur courante
L'éclairage change, et l'histogramme échoue
Symptôme : les mêmes produits, photographiés dans le nouveau studio de Larkfield avec un éclairage plus chaud, perdent en exactitude. L’histogramme passe de 0,263 à 0,225. Le rappel des coussins tombe à 0,00 : aucun coussin n’est trouvé.
Cause : le nouveau studio est un problème que nous avons inséré : les mêmes 160 photos de test, réchauffées par code. Une lumière chaude déplace les pixels blancs et gris vers le jaune et l’orange. Les classes de couleurs de l’histogramme changent, mais pas les produits.
Correction : gardez l’éclairage fixe quand vous le pouvez. Une caméra avec une balance des blancs fixe et une lampe stable constituent une vraie correction. Si l’éclairage doit changer, mesurez de nouveau les résultats sur des photos sous le nouvel éclairage avant de faire confiance à la méthode. Le module 8 essaie une correction de couleur simple et mesure ses résultats.
Conséquence pour le travail en IA : une méthode qui lit la couleur dépend de l’éclairage. Elle peut réussir tous les tests dans une pièce et échouer dans la suivante, sans message d’erreur.
À vous de jouer : combien de voisins?
Section intitulée « À vous de jouer : combien de voisins? »La section 5 du carnet Jupyter propose une tâche avec deux cellules de vérification.
- Entraînez le classificateur des plus proches voisins avec
k = 1, sur les mêmes histogrammes. - Placez son exactitude sur les données de test dans
acc_k1, telle quecp.classification_scoresla donne. - Faites la même chose avec
k = 15, et placez le résultat dansacc_k15. - Exécutez les deux cellules de vérification. Chacune affiche
Check passed(vérification réussie) quand votre nombre est correct. - Regardez le rappel des bougies avec k = 15. Écrivez une phrase expliquant pourquoi il vaut 0.
Afficher la réponse
acc_k1 = cp.classification_scores(list(test["label"]), list(KNeighborsClassifier(1, n_jobs=1).fit(Xtr, train["label"]).predict(Xte)))["accuracy"]acc_k15 = cp.classification_scores(list(test["label"]), list(KNeighborsClassifier(15, n_jobs=1).fit(Xtr, train["label"]).predict(Xte)))["accuracy"]print(acc_k1, acc_k15)0.275 0.325Avec k = 15, une bougie de test doit obtenir 8 votes pour la classe bougie parmi ses 15 voisins. Mais toutes les photos d’entraînement ne contiennent que 15 bougies. Les grandes classes remportent presque tous les votes, donc la méthode ne trouve aucune bougie.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
La règle de Priya obtient 0,269 et l'histogramme de couleurs, 0,263 sur le catalogue. Pourquoi une règle écrite à la main est-elle difficile à améliorer, même pour une personne qui regarde beaucoup de photos?
Afficher la réponse
Une personne doit penser à tous les cas, et les photos présentent trop de cas différents. La règle pour les bougies suppose une pièce sombre. Pourtant, la plupart des bougies du catalogue sont sur une table blanche, à la lumière du jour. Chaque nouvelle règle corrige certaines photos et crée des erreurs sur d’autres. Quatre classes (bol, lampe, tasse, vase) n’ont aucune règle, donc leur rappel vaut 0.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Un vase de test est brun et blanc. Selon l'histogramme de couleurs, ses cinq photos d'entraînement les plus proches montrent deux chaises, un pot de fleurs, un bol et une tasse. La méthode fonctionne-t-elle mal? Qu'est-ce que cela vous apprend?
Afficher la réponse
La méthode fonctionne bien : elle a trouvé les photos aux couleurs les plus proches, comme prévu. Le problème vient de la caractéristique. Dans le catalogue, chaque catégorie existe en plusieurs couleurs, et beaucoup de produits sont bruns, blancs ou gris. La couleur seule ne permet pas de distinguer un vase d’une chaise. Il faut une caractéristique qui décrit la forme, ce que présente la prochaine leçon.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Hamid demande : « Devrait-on utiliser une règle de couleur pour les retours? » Répondez avec les nombres de cette leçon et dites ce que vous surveilleriez.
Afficher la réponse
C’est une première étape peu coûteuse, et c’est mieux que de ne rien vérifier. Sur les photos de test, la règle coûte environ 1 779 $ US par jour. Sans vérification, le coût est de 2 229 $ US, contre 1 908 $ US pour 100 vérifications au hasard. Elle envoie environ 91 retours par jour à une personne, ce qui respecte le budget de 100. Elle ne nécessite aucune étiquette et prend environ 2 ms par photo. Elle fonctionne seulement parce que la caméra, la lumière et l’arrière-plan restent fixes. Elle ne trouve aussi que 4 bougies endommagées sur 18, donc ne vous arrêtez pas là. Surveillez la lumière : si la caméra ou la lampe change, mesurez de nouveau avant de vous fier à la règle.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une règle écrite par une personne atteint 0,269 sur le catalogue. Elle ne peut jamais reconnaître un bol, une lampe, une tasse ou un vase, car ces classes n’ont aucune règle.
- Un histogramme de couleurs compte les pixels par classes de couleurs. k-NN donne à une photo l’étiquette de ses photos d’entraînement les plus proches. Il atteint 0,263, et 0,225 sous la lumière plus chaude du studio.
- Une valeur de k plus grande a donné 0,325, mais aucune bougie : un meilleur résultat global peut cacher la pire classe.
- Votre projet comprend maintenant
vision baseline --method histogramet 11 tests, comme dans l’instantanéend-of-m02. - La couleur donne de bons résultats avec une caméra fixe et une lumière fixe. Une règle de couleur sur les retours coûte 1 779 $ US par jour, contre 2 229 $ US sans vérification.
Vous pouvez maintenant construire et mesurer une méthode basée sur la couleur. Mais l’histogramme ne sait rien des formes : pour lui, un vase brun et une chaise brune se ressemblent. Ensuite, vous décrivez les formes avec des caractéristiques de contours faites à la main, et vous voyez ce qu’elles ajoutent.
Leçon suivante : Caractéristiques faites à la main