
Segmentation sémantique et segmentation d'instances
- Leçon 17
- 30 min
- Module 5 : Segmenter
Où nous en sommes
Les boîtes englobantes nous ont indiqué où sont les objets et combien il y en a. Une boîte englobante ne précise pas quels pixels appartiennent à un objet. Dans cette leçon, nous découvrons la segmentation sémantique et la segmentation d'instances. Nous voyons aussi quand un masque vaut son coût supplémentaire.
Leçon 17 sur 30 · IA de vision : voir, compter et inspecterSegmentation sémantique et segmentation d'instances
1. Voir est un problème d'affaires
2. Références de base et classificateurs préentraînés
3. Plongements, CLIP et peu d'étiquettes
4. Détecter et compter
5. Segmenter
6. Inspecter pour trouver les défauts
7. Apparier, chercher et décrire
8. Exploiter la vision en production
Ce que vous saurez faire
Voyez la différence entre une boîte englobante, un masque sémantique et des masques d’instances. Découvrez à quelle question chacun répond, et pourquoi un masque sémantique ne peut pas compter les objets qui se touchent. Décidez ensuite quand Larkfield devrait payer pour des masques plutôt que des boîtes englobantes.
Carnet JupyterFaites cette leçon dans un carnet Jupyter
Le carnet (notebook) Jupyter transforme les contours des cartons sur palette en masques. Il construit un masque sémantique et des masques d’instances pour une palette, puis compte les régions séparées du masque sémantique. Ses cellules de préparation téléchargent les photos des palettes (environ 3 Mo, sans modèle ni clé). Aucune préparation locale n’est donc nécessaire. Prévoyez environ 30 minutes; les cellules s’exécutent en quelques secondes.
Le carnet est en anglais. Colab et Kaggle ouvrent votre propre copie. Il faut un compte Google ou Kaggle gratuit. Vous êtes bloqué ? Consultez le carnet de solution.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les pixels et les canaux, vus dans Les images sont des nombres.
- Les boîtes englobantes et l’IoU, vus dans Les boîtes englobantes et l’IoU.
Ce qu’il vous faut sur votre ordinateur
- Pour le carnet Jupyter : rien. Il fonctionne dans Colab ou Kaggle.
- Cette leçon n’ajoute rien au projet
larkvision. Le projet reçoit une commande de masque à la fin de ce module.
Testé avec Python 3.12 sur macOS.
Deux façons de colorier un plan
Section intitulée « Deux façons de colorier un plan »Hamid prépare un nouvel aménagement pour l’entrepôt des retours. Il imprime le plan et prend deux surligneurs.
D’abord, il colorie chaque étagère en jaune. Il voit maintenant quelle part du sol les étagères couvrent. Mais là où deux étagères se touchent, les zones jaunes se rejoignent. Il ne peut pas compter les étagères à partir du jaune.
Ensuite, il prend une nouvelle copie et donne à chaque étagère sa propre couleur : étagère 1 rouge, étagère 2 bleue, étagère 3 verte. Il peut maintenant les compter et mesurer chacune.
Les ordinateurs colorient les photos de ces deux mêmes façons. Cette leçon donne un nom à chaque façon.
Le problème : une boîte englobante est une forme approximative
Section intitulée « Le problème : une boîte englobante est une forme approximative »Dans Détecter et compter, chaque objet recevait une boîte englobante : un rectangle autour de lui. Une boîte englobante coûte peu et convient au comptage. Mais une boîte englobante n’est pas l’objet. Elle contient aussi les pixels autour de l’objet.
Pour un carton sur une palette, cela importe peu : l’objet est presque rectangulaire. Pour un dommage sur une bougie, cela importe beaucoup. Regardez un lampion endommagé parmi les retours :

Description textuelle du diagramme
Deux vues du même coin d’un lampion, agrandies pour que chaque pixel soit un petit carré. Le dommage est une mince bande courbe le long du bord inférieur de la bougie. À gauche : un rectangle bleu tracé autour de la bande. Il couvre aussi la cire au-dessus et le fond sombre en dessous : 1 012 pixels. À droite : seule la bande est rouge : 408 pixels.
Le dommage est une mince bande courbe. Sa boîte englobante contient 1 012 pixels, mais seuls 408 correspondent au dommage. Supposons que la règle de Hamid soit « plus de 500 pixels endommagés : envoyer la bougie au magasin de liquidation ». La boîte englobante fait envoyer cette bougie au magasin de liquidation. Le vrai contour ne le fait pas.
Une boîte englobante répond à « où, approximativement? ». Certaines questions demandent « quels pixels, exactement? ».
L’idée : un masque
Section intitulée « L’idée : un masque »Un masque est une grille de valeurs oui ou non, une pour chaque pixel de la photo. « Oui » signifie que le pixel appartient à l’objet. « Non » signifie qu’il n’y appartient pas. Vous pouvez représenter un masque par une image en noir et blanc de la même taille que la photo.
Attribuer des masques aux objets d’une photo s’appelle la segmentation : nous découpons la photo en segments. Il existe deux types principaux.
- La segmentation sémantique indique la classe de chaque pixel : « carton », « bougie », « sol ». Elle ne sépare pas deux objets de la même classe. C’est le surligneur jaune de Hamid.
- La segmentation d’instances donne à chaque objet son propre masque : carton 1, carton 2, carton 3. Deux cartons qui se touchent restent séparés. C’est le surligneur qui change de couleur pour chaque étagère.
Vous pourriez aussi rencontrer un troisième nom : la segmentation panoptique, qui combine les deux. Chaque pixel reçoit une classe, et chaque objet dénombrable reçoit aussi son propre numéro.
Un tout petit exemple
Section intitulée « Un tout petit exemple »Une photo construite de 6 × 10 = 60 pixels contient deux cartons qui se touchent. Le carton A a 16 pixels; le carton B en a 12.

Description textuelle du diagramme
Trois grilles de 6 lignes et 10 colonnes. Grille 1, la photo : le carton A couvre les lignes 2 à 5 et les colonnes 2 à 5 (16 pixels). Le carton B couvre les lignes 3 à 5 et les colonnes 6 à 9 (12 pixels). B touche A sur son côté droit. Grille 2, le masque sémantique : les 28 pixels de carton contiennent 1, et les 32 autres pixels contiennent 0. Les valeurs de 1 forment une seule région. Grille 3, les masques d’instances : les pixels du carton A contiennent 1, ceux du carton B contiennent 2, les autres 0.
| Question | Grille sémantique | Grille d’instances |
|---|---|---|
| Combien de pixels sont du « carton »? | 28 | 16 + 12 = 28 |
| Combien de cartons? | Une région : on dirait 1 carton | 2 |
| Quelle est la taille du carton B? | Elle ne peut pas le dire | 12 pixels |
Les deux grilles donnent la même aire de « carton ». Seule la grille d’instances peut compter, et seule la grille d’instances peut mesurer un objet.
Trois réponses sur une même palette
Section intitulée « Trois réponses sur une même palette »Notre code dessine les photos des palettes de Larkfield. Nous connaissons donc le contour exact de chaque carton. Le contour est un polygone : la liste des coins des faces visibles. Un polygone devient un masque quand nous le remplissons.
Voici la même palette moyennement encombrée, S-062, avec les trois types de réponse :

Description textuelle du diagramme
Trois copies d’une photo synthétique de palette avec 24 cartons répartis en 6 colonnes et 4 étages. Panneau 1 : un mince rectangle bleu autour de chaque carton. Panneau 2 : chaque pixel de chaque carton a le même bleu, sur un fond plus sombre. Dans une colonne, on ne voit pas où un carton finit et où le suivant commence. Panneau 3 : chaque carton a sa propre couleur. Chacun des 24 cartons se distingue donc de ses voisins.
Sur cette palette, 52 % des pixels sont du « carton ».
Pourquoi un masque sémantique ne peut pas compter
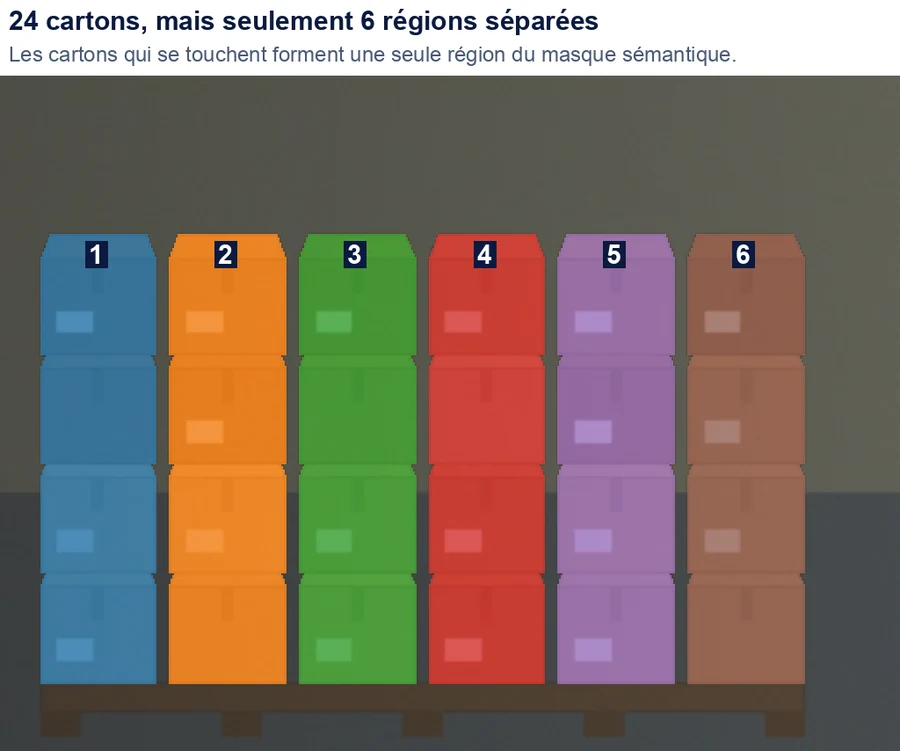
Section intitulée « Pourquoi un masque sémantique ne peut pas compter »Les cartons de chaque colonne de S-062 sont posés les uns sur les autres. Il n’y a aucun espace entre eux. Peut-on quand même compter les cartons dans le masque sémantique? Une méthode simple trouve les régions connectées : des groupes de pixels « oui » qui se touchent.
Description textuelle du diagramme
La palette synthétique S-062 avec son masque sémantique. Le masque se divise en six régions colorées, numérotées de 1 à 6 de gauche à droite. Chaque région est une colonne de quatre cartons empilés. Les espaces entre les colonnes séparent les régions. Les cartons d’une même colonne se touchent, donc ils se rejoignent.
Le masque sémantique n’a que 6 régions pour 24 cartons. Les espaces de 8 pixels entre les colonnes les gardent séparées. Les cartons d’une même colonne se touchent, donc ils se rejoignent. Sur une palette serrée, chaque carton touche ses voisins, et toute la palette peut devenir une seule région.
Erreur courante
Compter les régions d'un masque sémantique
Symptôme : une équipe compte les cartons en comptant les régions connectées d’un masque sémantique. Sur les palettes espacées, le décompte est correct. Sur S-062, il indique 6 pour 24 cartons.
Cause : un masque sémantique ne connaît pas la notion d’« un objet ». Deux objets de la même classe qui se touchent deviennent une seule région.
Correction : comptez à partir des masques d’instances ou des boîtes englobantes, comme dans Détecter et compter. Utilisez un masque sémantique pour les aires, pas pour les décomptes.
Conséquence pour le travail en IA : un masque peut être correct pour chaque pixel et donner quand même une mauvaise réponse à votre question. Choisissez le type de réponse selon la question.
Quand un masque vaut-il son coût?
Section intitulée « Quand un masque vaut-il son coût? »Les masques coûtent plus cher que les boîtes englobantes, de trois façons :
- Étiquettes : une personne dessine une boîte englobante en deux clics, mais un contour en demande beaucoup. Supposons 5 secondes pour une boîte englobante, comme dans Détecter et compter, et 30 secondes pour un contour. Ce sont deux hypothèses : chronométrez votre propre outil. Les 817 cartons des 40 palettes d’entraînement demandent alors environ 68 minutes pour des boîtes englobantes et 6,8 heures pour des contours. À 30 $ US l’heure, cela représente environ 34 $ US contre environ 204 $ US.
- Modèles : un modèle qui dessine des masques est plus gros et plus lent qu’un détecteur de la même famille.
- Vérifications : une personne vérifie une boîte englobante d’un coup d’œil. Vérifier un contour prend plus de temps.
Payez donc pour un masque seulement quand la boîte englobante donne une réponse différente. À quel point une boîte englobante diffère-t-elle du vrai contour? Traitez la boîte englobante comme un masque et calculez son IoU avec le vrai masque : les pixels communs divisés par les pixels présents dans l’un ou l’autre.
Description textuelle du graphique
Un diagramme à quatre barres, de 0 à 1. Cartons sur palette : espacés 0,97, moyens 0,96, serrés 0,95. Dommages aux bougies : 0,56, la médiane de 18 photos.
Pour les cartons sur palette, la boîte englobante et le contour partagent de 95 % à 97 % de leurs pixels. Un masque n’ajoute presque rien. Pour un dommage sur une bougie, l’IoU médiane est 0,56 : la boîte englobante contient environ deux fois plus de pixels que le dommage. Les dommages sont minces, courbes ou répartis en plusieurs petits morceaux.
Quand utiliser des masques, et quand ne pas le faire
Section intitulée « Quand utiliser des masques, et quand ne pas le faire »Utilisez des boîtes englobantes quand la question est « combien? » ou « où, approximativement? », et que les objets sont à peu près rectangulaires. Le comptage des cartons sur une palette en est un exemple.
Utilisez des masques d’instances quand la question porte sur les pixels exacts de chaque objet :
- Quelle est sa taille? L’aire d’un dommage sur une bougie, pour que Hamid puisse établir une règle selon sa taille. C’est la dernière leçon de ce module.
- Détourez-le. L’équipe du catalogue veut chaque produit sur un fond uni. C’est la prochaine leçon.
- Qu’est-ce qui touche quoi? Par exemple, savoir si une tache dépasse le bord d’une étiquette.
Utilisez un masque sémantique quand vous avez besoin de l’aire d’une classe, et non des objets. Exemples : quelle part d’une étagère est vide, ou quelle part d’une housse de coussin est tachée. Un masque sémantique ne peut pas compter les objets qui se touchent.
Larkfield : où les masques valent leur coût
Section intitulée « Larkfield : où les masques valent leur coût »Priya examine les trois équipes et leurs questions :
| Équipe | Question | Type de réponse |
|---|---|---|
| Entrepôt (palettes) | Combien de cartons? | Les boîtes englobantes suffisent : l’IoU entre la boîte englobante et le contour atteint 0,95 ou plus |
| Retours (Hamid) | Quelle part de la bougie est endommagée? | Un masque d’instance pour chaque dommage |
| Catalogue (Omar) | Le produit sans son fond | Un masque d’instance pour chaque produit |
Les photos des retours ont déjà des masques de dommages : des personnes les ont dessinés pour le jeu d’images VisA. Les photos du catalogue n’ont que des boîtes englobantes. Dessiner des milliers de contours de produits à la main demanderait de nombreuses heures. Dans la prochaine leçon, un modèle les dessine à partir d’une seule boîte englobante ou d’un seul clic.
Exercice guidé : des masques à partir des contours
Section intitulée « Exercice guidé : des masques à partir des contours »- Ouvrez le carnet Jupyter dans l’encadré Faites cette leçon dans un carnet Jupyter en haut de cette page.
- Exécutez les cellules de préparation. Elles téléchargent les photos des palettes et leurs contours.
- Dans la section 1, exécutez la cellule. Elle remplit chaque polygone pour créer un masque. S-062 a 24 masques de 512 × 384 pixels.
- Dans la section 2, exécutez la cellule. Elle dessine côte à côte la photo, le masque sémantique et les masques d’instances.
- Prédisez : combien de régions séparées le masque sémantique contient-il? Exécutez ensuite la cellule suivante. Vous voyez
boxes: 24 | separate regions in the semantic mask: 6(24 cartons, 6 régions séparées dans le masque sémantique). - Allez à la section 3 pour votre tâche.
À vous : quelle part d’une palette serrée est du carton?
Section intitulée « À vous : quelle part d’une palette serrée est du carton? »La section 3 du carnet Jupyter contient une tâche. Pour chacune des 10 palettes serrées de test, calculez la proportion de pixels à l’intérieur d’un carton. Cette proportion est la moyenne du masque sémantique de la photo. Placez la moyenne des 10 proportions dans tight_share. La cellule de vérification affiche Check passed (vérification réussie) quand votre réponse est correcte.
Avant de l’exécuter, prédisez : la proportion est-elle supérieure ou inférieure à celle de S-062 (52 %)?
Afficher la réponse
shares = []for im in pallets["images"]: if im["crowding"] == "tight": ms = [mask(a["segmentation"][0], im["width"], im["height"]) for a in pallets["annotations"] if a["image_id"] == im["id"]] shares.append(np.any(ms, axis=0).mean())tight_share = float(np.mean(shares))La réponse est 0,377 : en moyenne, 38 % d’une photo de palette serrée est du carton. C’est moins que sur S-062, même si les cartons se touchent. « Serré » décrit les espaces entre les cartons, pas la part de la photo occupée par la palette. C’est une question sémantique : vous n’avez pas besoin de masques d’instances pour y répondre.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Une photo montre trois tasses. Deux se touchent. Un masque sémantique marque chaque pixel de tasse. Combien de régions connectées prévoyez-vous, et pourquoi le masque peut-il quand même être utile?
Afficher la réponse
Deux régions : les deux tasses qui se touchent se rejoignent, et la troisième forme sa propre région. Vous ne pouvez donc pas compter les tasses à partir de ce masque. Il reste utile pour les questions sur la classe dans son ensemble. Par exemple : combien de pixels sont de la « tasse »?
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Sur les palettes, une boîte englobante et le vrai contour partagent de 95 % à 97 % de leurs pixels. Pour les dommages aux bougies, la médiane est 0,56. Qu'est-ce que cela indique sur les cas où Larkfield devrait payer pour des masques?
Afficher la réponse
Sur les palettes, une boîte englobante correspond presque au contour. Les masques ajoutent donc peu au comptage et ne valent pas leur coût d’étiquetage. Sur les bougies, la boîte englobante contient environ deux fois les pixels du dommage. Une aire calculée à partir d’une boîte englobante serait donc environ deux fois trop grande. Larkfield devrait payer pour des masques quand la taille ou la forme de l’objet guide la décision, comme l’aire des dommages. Elle devrait garder les boîtes englobantes pour le comptage.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Omar veut chaque produit du catalogue sur un fond blanc. Hamid veut la proportion endommagée du dessus de chaque bougie retournée. De quel type de segmentation chacun a-t-il besoin : sémantique ou d'instances? Donnez une raison pour chacun.
Afficher la réponse
Omar a besoin d’un masque d’instance pour chaque produit, car il doit détourer un objet à la fois. Un masque de classe suffirait seulement si chaque photo contenait un produit. Il ne conviendrait plus dès que deux produits se toucheraient. Hamid a besoin d’un masque d’instance pour chaque bougie. Il doit savoir quelle bougie est endommagée et connaître la taille de son dessus. Avec un masque de dommage pour cette bougie, il divise les pixels du dommage par ceux de la bougie.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un masque indique oui ou non pour chaque pixel. La segmentation sémantique donne une classe à chaque pixel; la segmentation d’instances donne son propre masque à chaque objet. La segmentation panoptique fait les deux.
- Un masque sémantique ne peut pas compter les objets qui se touchent : la palette moyenne S-062 contient 24 cartons et seulement 6 régions.
- Les masques coûtent plus que les boîtes englobantes : en étiquettes (une estimation de 6,8 heures contre 68 minutes pour 817 cartons), en modèles et en vérifications.
- Payez pour des masques quand les pixels exacts guident la décision. Pour un carton sur palette, la boîte englobante correspond presque au contour (IoU de 0,95 à 0,97). Pour un dommage sur une bougie, la boîte englobante est environ deux fois trop grande (médiane de 0,56).
Vous pouvez maintenant dire de quel type de masque une question a besoin. Mais les masques coûtent cher à dessiner à la main. Ensuite, un modèle dessine un masque à partir d’un clic ou d’une boîte englobante, sans entraînement. Nous vérifions à quelle fréquence il donne un résultat correct.
Leçon suivante : La segmentation guidée par requête avec SAM 2