
Barrière d'évaluation de l'IA
- Leçon 10
- 45 min
- Module 4 : Mettre en production les changements d'IA et de base de données
Leçon 10 sur 15 · CI/CD, tests et mises en production sûresBarrière d'évaluation de l'IA
1. Comprendre le chemin de livraison
2. Créer un pipeline CI reproductible
3. Gérer les environnements et les secrets
4. Mettre en production les changements d'IA et de base de données
5. Rétablir et maintenir le processus de mise en production
Ce que vous saurez faire
Un test unitaire prouve que le code fait ce qu’il annonce. Il ne prouve pas qu’un nouveau modèle est meilleur pour les personnes qui l’utilisent. Cette leçon ajoute une vérification qui le peut. Elle évalue un ensemble fixe de billets de soutien étiquetés à chaque demande de tirage. Elle bloque tout changement de modèle qui dégrade les cas importants.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Le flux CI, sa tâche « Lint, test, audit » (vérifier le style, tester, auditer), et sa copie locale,
scripts/check.sh. Ils viennent de Construire et tester : des vérifications qui ont du sens et Les mêmes vérifications sur votre ordinateur. - L’artefact
reportset l’ensemble de règles avec ses vérifications obligatoires, présentés dans Publier les preuves : le rapport de tests, même quand les tests échouent et Protéger main avec un ensemble de règles. - Une image avec des paramètres différents par environnement, présentée dans Séparer la configuration : où se trouvent les paramètres. Votre
deploy/local/staging.envcontient déjàCLASSIFIER_VERSION=1.1. La version 1.1.0 l’ignore. Après cette leçon, le code le lit. - L’exactitude et le rappel, pour une explication plus longue que celle ci-dessous : Les métriques de classification : la précision et le rappel. Des données de test utilisées une seule fois : Données d’entraînement, de validation et de test.
Ce qu’il vous faut sur votre ordinateur
- Votre dépôt
github.com/<you>/ticket-api-cià la version 1.1.0, avec.github/workflows/ci.yml,scripts/check.shet l’environnement virtuel issu derequirements-lock.txt. Ils viennent de Construire et tester : exercice guidé : ajouter les vérifications et la tâche d’image. L’étiquettev1.1.0vient de Promouvoir en préproduction : exercice guidé : promouvoir votre propre empreinte. - L’ensemble de règles sur
mainavec les vérifications obligatoires « Lint, test, audit » et « Build, smoke-test and push the image » (construire, tester sommairement et pousser l’image). Il vient de Publier les preuves : protéger main avec un ensemble de règles. - Si votre projet manque ou ne fonctionne plus, copiez l’instantané
end-of-m03, comme dans Utiliser un instantané. Un instantané contient des fichiers, pas les paramètres GitHub : recréez l’ensemble de règles si votre dépôt est nouveau.
Exécuté avec GitHub Actions (exécuteurs ubuntu-24.04, Python 3.14.8) dans le dépôt public Nextia-Intelligence/ticket-api-ci. Aussi exécuté sur macOS (Apple silicon) avec Python 3.14.6. Les étapes Windows et Linux ne sont pas testées.
Un test n’est pas une évaluation
Section intitulée « Un test n’est pas une évaluation »La responsable du soutien veut un meilleur classificateur. Amira en a un : keywords-1.1, la même méthode que keywords-1.0, avec plus de mots pour chaque catégorie. Avant de le proposer aux utilisateurs, elle doit répondre à une question : est-il meilleur, surtout pour les billets les plus importants?
Les 25 tests ne peuvent pas répondre. Un test vérifie une entrée et une sortie attendue choisies par le développeur : « Refund » (remboursement) donne billing. Un classificateur se trompe sur certains billets, par nature. La question est de savoir à quelle fréquence et sur quels billets. Amira a donc besoin d’une autre vérification, une évaluation. Elle exécute le classificateur sur plusieurs billets dont une personne a noté la bonne réponse, puis compte.
Trois billets illustrent l’idée :
| Billet | Bonne réponse (notée par une personne) | Réponse de keywords-1.0 | Réponse de keywords-1.1 |
|---|---|---|---|
| « Package not delivered » (colis non livré) | shipping | other | shipping |
| « Charged twice » (facturé deux fois) | billing, priorité 1 | billing, priorité 1 | billing, priorité 1 |
| « Two more seats » (deux places de plus) | account | other | other |
Sur ces trois billets, 1.0 répond correctement une fois, et 1.1 deux fois. Chaque mot de cette phrase doit être défini :
- Un billet étiqueté est un billet accompagné de la bonne réponse : la catégorie et la priorité.
- Le jeu d’évaluation est la liste des billets étiquetés. Ici, c’est
evaluation/tickets.jsonl, soit 51 billets. - L’exactitude est la proportion de billets ayant la bonne catégorie : 2 sur 3 donne 0,667.
- Le rappel d’une catégorie est la proportion des billets de cette catégorie que le classificateur trouve. S’il trouve 6 des 7 billets account, le rappel de account est de 0,857. L’exactitude peut sembler bonne même si une petite catégorie n’est presque jamais trouvée. Le rappel par catégorie le révèle.
- Un billet obligatoire doit toujours recevoir la bonne réponse et la bonne priorité, peu importe les moyennes. « Charged twice » en est un : un client qui a perdu de l’argent doit joindre une personne en premier. La sortie de la barrière les appelle « must-pass cases » (cas obligatoires).
Développement et réserve : pourquoi certains billets restent inconnus
Section intitulée « Développement et réserve : pourquoi certains billets restent inconnus »Amira a choisi les nouveaux mots de keywords-1.1 en lisant des billets. Si elle évalue 1.1 sur ces mêmes billets, il paraît meilleur qu’il ne l’est : elle l’a adapté à ceux-ci. Le jeu comporte donc deux parties :
- 18 billets de développement (« dev ») : elle les a lus pour choisir les mots.
- 33 billets de réserve (« holdout ») : personne ne les a utilisés pour faire des choix. Ils représentent les billets du mois prochain.
L’écart est grand. Sur les billets de développement, keywords-1.1 a une exactitude de 1,0. Il répond correctement à chaque billet ayant servi au choix des mots. Sur les billets de réserve, elle est de 0,909. Le deuxième nombre est honnête, donc la barrière utilise seulement les billets de réserve. Si vous modifiez les mots-clés à cause d’un billet de réserve, ce billet n’est plus inconnu. Déplacez-le vers les données de développement et ajoutez de nouveaux billets de réserve.
La barrière : trois questions
Section intitulée « La barrière : trois questions »Une barrière est une vérification qui arrête le pipeline lorsque sa réponse est non. La barrière d’évaluation pose trois questions. Les trois réponses doivent être oui.

Description textuelle du diagramme
La barrière exécute le classificateur sur les 33 billets de réserve et vérifie trois points. Minimums : aucune mise en production ne peut descendre sous une exactitude de 0,6 ou un rappel de 0,5 par catégorie. Aucune régression : la nouvelle version ne doit pas être moins bonne que la version en production, la référence de base (keywords-1.0, exactitude de 0,636). L’exactitude peut baisser d’au plus 0,02, et le rappel de chaque catégorie d’au plus 0,1. Billets obligatoires : les trois billets obligatoires doivent avoir la bonne catégorie et la bonne priorité. Dans la demande de tirage nº 4, les parties 1 et 2 ont réussi, mais la partie 3 a échoué sur E033. La barrière a donc échoué.
Les paramètres sont dans evaluation/thresholds.json :
{ "split": "holdout", "baseline": "evaluation/baseline.json", "min_accuracy": 0.6, "min_recall_per_category": 0.5, "max_accuracy_drop": 0.02, "max_recall_drop": 0.1, "must_pass_all": true}baseline.json contient les résultats de keywords-1.0, le classificateur en production. Les seuils sont propres à la tâche : ils viennent de cette tâche et de cette équipe, pas d’un manuel. Le soutien peut accepter un classificateur qui se trompe sur un billet sur trois (le minimum). Il ne peut pas accepter une mise en production moins bonne qu’aujourd’hui (aucune régression). Il ne peut pas accepter un colis perdu dans la file normale (billet obligatoire).
Exemple détaillé : keywords-1.1 derrière un indicateur
Section intitulée « Exemple détaillé : keywords-1.1 derrière un indicateur »Amira travaille sur une branche, feature/classifier-1.1, créée à partir de main. Son changement comporte trois parties.
1. Le classificateur. keywords-1.1 est une sous-classe avec plus de mots. La version 1.0 reste identique, donc la production ne change pas :
# keywords-1.1: more words for each category, found in the evaluation set's# development cases. Login words are checked before "account", so "I cannot# log in to my account" is a login ticket.KEYWORDS_1_1 = {    "billing": KEYWORDS["billing"] + ("bill", "overcharged", "receipt", "subscription"),    "login": KEYWORDS["login"] + ("reset link", "verification code", "2fa", "can't sign"),    "shipping": KEYWORDS["shipping"] + ("package", "arrived", "delivered", "shipment"),    "account": KEYWORDS["account"] + ("email address", "profile", "delete my"),}URGENT_WORDS_1_1 = URGENT_WORDS + ("can't sign", "never arrived", "urgent")

class KeywordClassifier11(KeywordClassifier):    """keywords-1.1: the same method with more words."""
    version = "keywords-1.1"    keywords = KEYWORDS_1_1    urgent_words = URGENT_WORDS_1_1
make_classifier("keywords", version) renvoie la classe pour "1.0" ou "1.1". Pour toute autre valeur, il s’arrête avec unknown CLASSIFIER_VERSION (version CLASSIFIER_VERSION inconnue). Le fichier complet est ticket_api/classifier.py à 19d172b.
2. L’indicateur. Un indicateur de fonctionnalité est un paramètre qui active ou désactive une fonctionnalité sans nouvelle construction. Ici, c’est CLASSIFIER_VERSION, lu dans config.py, avec 1.0 comme valeur par défaut :
classifier_version=os.environ.get("CLASSIFIER_VERSION", "1.0"),main.py le transmet : make_classifier(settings.classifier_mode, settings.classifier_version). Deux nouveaux tests vérifient que 1.1 donne keywords-1.1 et que la valeur par défaut donne keywords-1.0. Le nouveau code peut aller en production avec l’indicateur désactivé. La leçon Mise en production progressive l’active étape par étape.
3. L’évaluation. Amira ajoute le dossier evaluation/ fourni et lance l’évaluation pour les deux versions. D’abord, la version en production :
python -m evaluation.run --classifier 1.0La sortie (simulée) :
keywords-1.0 on 33 holdout tickets (baseline keywords-1.0)accuracy 0.636recall account 0.571recall billing 0.625recall login 0.625recall other 1.0recall shipping 0.571must-pass failures: 0Gate passed.La version en production réussit sa propre barrière : elle est la référence de base. Maintenant, la version candidate :
python -m evaluation.run --classifier 1.1La sortie (simulée; les mêmes lignes que dans la CI) :
keywords-1.1 on 33 holdout tickets (baseline keywords-1.0)accuracy 0.909recall account 0.857recall billing 0.875recall login 0.875recall other 1.0recall shipping 1.0must-pass failures: 0Gate passed.L’exactitude passe de 0,636 à 0,909 : 30 bonnes réponses sur 33 billets, au lieu de 21. Tous les rappels augmentent. Les trois billets sur lesquels 1.1 se trompe encore sont difficiles exprès. Par exemple, E051 « Two more seats » (account) ne contient aucun des mots de account. Le code de sortie est 0 quand la barrière réussit et 1 quand elle échoue. Une étape du pipeline peut donc l’utiliser directement.
La commande écrit aussi reports/evaluation.json, la preuve pour la révision :
{ "classifier": "keywords-1.1", "split": "holdout", "cases": 33, "accuracy": 0.909, "must_pass_failures": [], "baseline": "keywords-1.0", "problems": [], "passed": true}La tâche CI téléverse déjà reports/ comme artefact reports. Le rapport d’évaluation se retrouve donc à côté du rapport JUnit, sans nouvelle étape.
La barrière dans la CI
Section intitulée « La barrière dans la CI »Amira ajoute une étape à la tâche de vérifications, après la vérification de sécurité. Elle ajoute la même ligne à scripts/check.sh :
checks: name: Lint, test, audit, evaluate # ... - name: AI evaluation gate run: python -m evaluation.run --classifier 1.1Ces lignes contiennent deux décisions :
- La barrière teste 1.1, la version candidate, même si la production utilise encore 1.0. Sa question est « ce changement peut-il atteindre les utilisateurs? ». Elle teste donc ce que le changement apporte. Quand 1.1 deviendra la référence de base,
baseline.jsonchangera dans sa propre demande de tirage. - La tâche est renommée « Lint, test, audit, evaluate » (vérifier le style, tester, auditer, évaluer). C’est ce nom que les gens lisent dans la liste des vérifications. Ce changement de nom a un coût, comme le montre l’erreur courante à la fin de la leçon.
Elle pousse et ouvre la demande de tirage nº 3, de feature/classifier-1.1 vers main. Son exécution CI, l’exécution 37666141730, a réussi : la tâche de vérifications a pris 25 secondes, barrière comprise. Le fichier complet est ci.yml à 19d172b.
Exemple détaillé : le changement que les tests ont aimé
Section intitulée « Exemple détaillé : le changement que les tests ont aimé »Après la fusion, Sam essaie keywords-1.1 en préproduction. Son signalement dans Définir les vérifications : 25 tests ont réussi, et le billet urgent ne l’était pas reste vrai avec le nouveau classificateur. « I lost my password » (j’ai perdu mon mot de passe) reçoit la priorité 1. Sam a raison. C’est un billet de connexion normal, et la priorité 1 est réservée à la file urgente. Le mot « lost » fait partie des mots urgents.
Amira ouvre la demande de tirage nº 4, de feature/fewer-urgent-tickets vers main. Elle retire "lost" des mots urgents de keywords-1.1. « Tous les tests réussissent », écrit-elle. Avant de poursuivre, faites une prédiction : quelles parties de la barrière réussiront?
La première exécution, l’exécution 37666448935, a échoué sur un détail plus simple. Sa liste sur une ligne était trop longue pour le vérificateur de style :
E501 Line too long (101 > 100) --> ticket_api/classifier.py:22:101...Found 1 error.Elle a réparti la liste sur plusieurs lignes, un mot par ligne, puis poussé de nouveau. La deuxième exécution, l’exécution 37666571062, a échoué à la barrière :
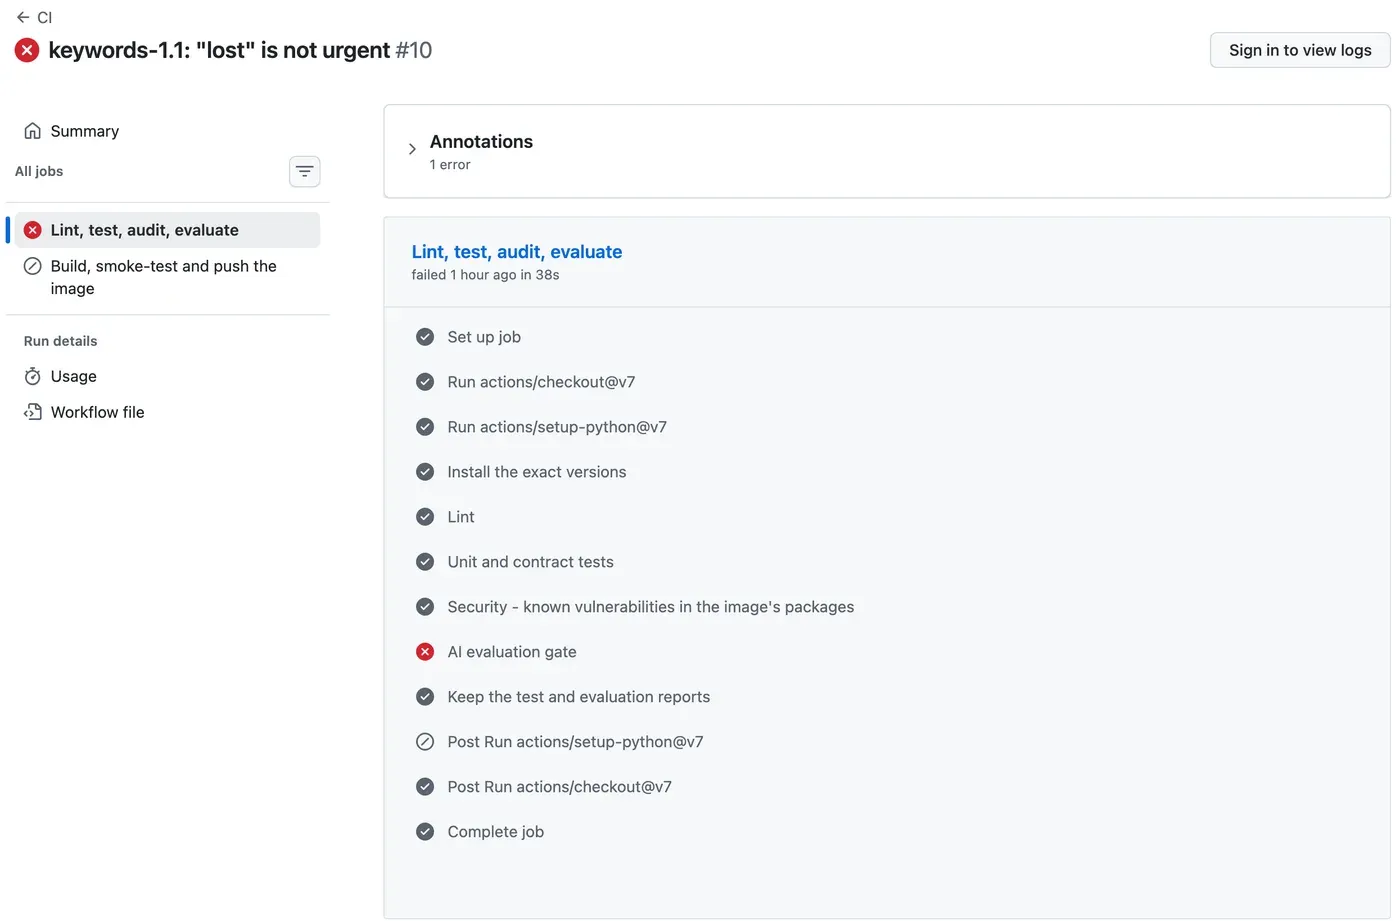
Le journal de cette étape (réel, tiré de l’exécution; sa lecture sur la page exige une connexion à GitHub) :
keywords-1.1 on 33 holdout tickets (baseline keywords-1.0)accuracy 0.909recall account 0.857recall billing 0.875recall login 0.875recall other 1.0recall shipping 1.0must-pass failures: 1FAIL: must-pass cases failed: E033Gate failed.##[error]Process completed with exit code 1.Tous les nombres sont identiques à ceux d’avant le changement. Les moyennes n’ont rien détecté. Mais E033, « Parcel lost in transit : The tracking stopped and the parcel is lost » (colis perdu en transit : le suivi s’est arrêté et le colis est perdu), reçoit maintenant la priorité 2. Sans le mot « lost », rien dans ce billet n’est urgent. Un client dont le colis est perdu attend dans la file normale.
| keywords-1.1 sur les 33 billets de réserve | Exactitude | account | billing | login | other | shipping | Échecs des billets obligatoires | Barrière |
|---|---|---|---|---|---|---|---|---|
| keywords-1.0 (référence de base) | 0,636 | 0,571 | 0,625 | 0,625 | 1,0 | 0,571 | 0 | réussite |
| keywords-1.1 (demande de tirage nº 3) | 0,909 | 0,857 | 0,875 | 0,875 | 1,0 | 1,0 | 0 | réussite |
| keywords-1.1 sans « lost » (demande de tirage nº 4) | 0,909 | 0,857 | 0,875 | 0,875 | 1,0 | 1,0 | 1 (E033) | échec |
Voilà le rôle de la partie sur les billets obligatoires. Le changement a corrigé le billet de Sam, absent du jeu, et dégradé le billet le plus important du jeu. L’exactitude compte les catégories, pas les priorités, donc elle n’a pas changé. Seule une vérification qui désigne le billet a détecté le problème. Amira a fermé la demande de tirage en donnant cette raison :
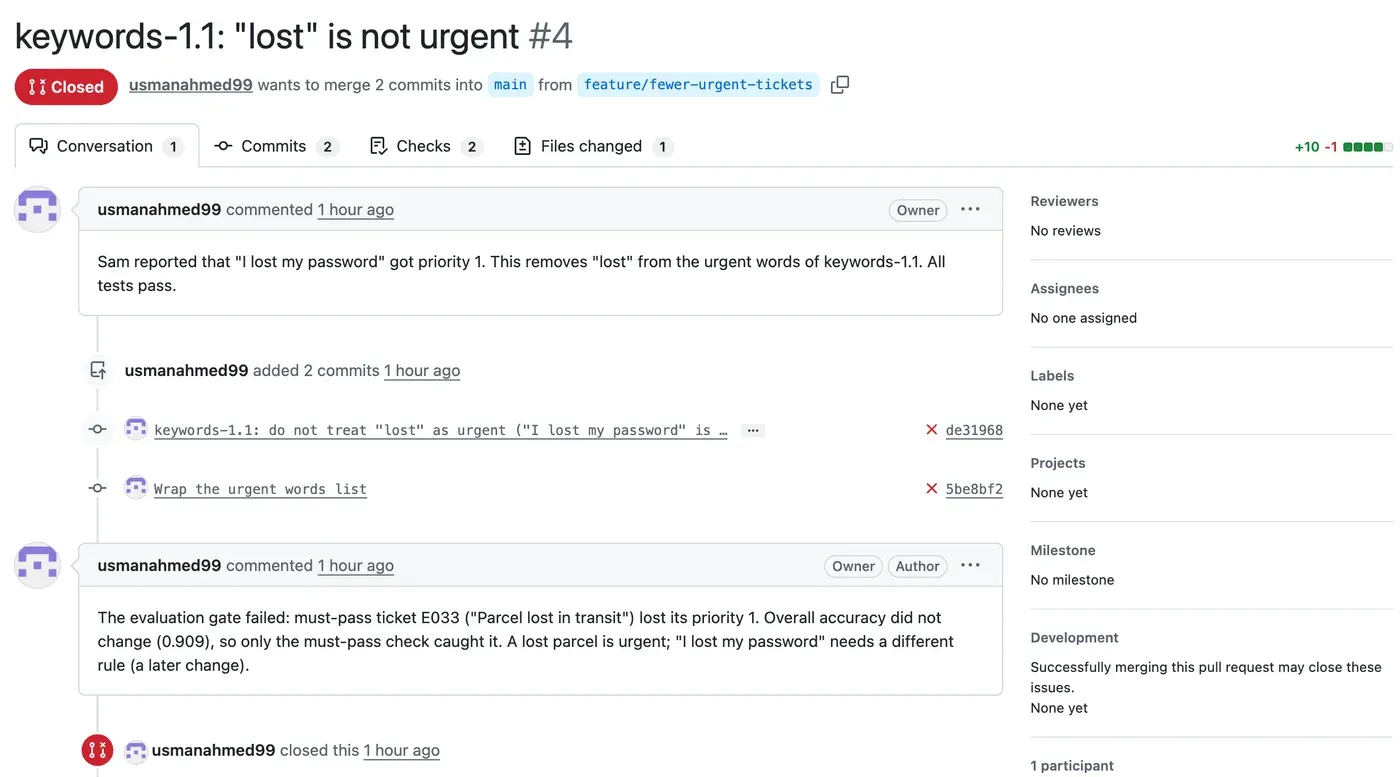
La barrière n’a pas décidé quoi faire du billet de Sam. Elle a empêché la fusion accidentelle d’une mauvaise solution. La bonne correction, une règle qui distingue un colis perdu d’un mot de passe perdu, sera un nouveau changement avec sa propre évaluation.
Exercice guidé : ajouter la barrière à votre dépôt
Section intitulée « Exercice guidé : ajouter la barrière à votre dépôt »Faites cet exercice dans votre propre dépôt. Chaque étape indique la branche.
- Sur
main, récupérez les derniers changements. Puis créez la branche :git switch -c feature/classifier-1.1. - Copiez les fichiers d’évaluation fournis dans un nouveau dossier
evaluation/. Les commandes suivent les étapes. Vérifiez que vous avez cinq fichiers :__init__.py,run.py,thresholds.json,baseline.json,tickets.jsonl(51 lignes). - Ajoutez keywords-1.1 et le drapeau : modifiez
ticket_api/classifier.py,ticket_api/config.pyetticket_api/main.pycomme dans l’exemple détaillé. Copiez-les depuis le commit 19d172b si vous préférez. - Ajoutez les deux tests du drapeau à
tests/test_classify.py(depuis le même commit). Exécutezpython -m pytest -q. Le résultat attendu est 27 tests réussis. - Exécutez
python -m evaluation.run --classifier 1.0, puis--classifier 1.1. Comparez les résultats aux sorties de l’exemple détaillé. - Ajoutez l’étape « AI evaluation gate » (barrière d’évaluation de l’IA) à
ci.yml. Renommez la tâche de vérification « Lint, test, audit, evaluate » (vérifier le style, tester, auditer, évaluer). Ajoutez l’étape àscripts/check.sh. - Exécutez
scripts/check.sh. Le résultat attendu est « Gate passed. » (barrière franchie) à l’étape de la barrière, puis « All checks passed. » (toutes les vérifications réussies). - Créez un commit (enregistrement des changements), poussez la branche et ouvrez une demande de tirage :
feature/classifier-1.1versmain. - Attendez les vérifications. Les deux réussissent. Regardez la zone de fusion : elle indique encore qu’une vérification obligatoire manque. Corrigez ce problème comme dans l’erreur courante, puis fusionnez.
Les commandes de l’étape 2 téléchargent les fichiers depuis le dépôt de référence, au commit qui les a ajoutés :
mkdir -p evaluationbase=https://raw.githubusercontent.com/Nextia-Intelligence/ticket-api-ci/19d172b/evaluationfor f in __init__.py run.py thresholds.json baseline.json tickets.jsonl; do curl -fsSL -o "evaluation/$f" "$base/$f"donewc -l evaluation/tickets.jsonlNew-Item -ItemType Directory -Force evaluation | Out-Null$base = "https://raw.githubusercontent.com/Nextia-Intelligence/ticket-api-ci/19d172b/evaluation"foreach ($f in "__init__.py", "run.py", "thresholds.json", "baseline.json", "tickets.jsonl") { Invoke-WebRequest -Uri "$base/$f" -OutFile "evaluation/$f"}(Get-Content evaluation/tickets.jsonl).CountAfficher le résultat attendu
wc -l indique 51 evaluation/tickets.jsonl. Les deux exécutions d’évaluation donnent les deux sorties de l’exemple détaillé, avec le code de sortie 0 (vérifiez avec echo $?). pytest -q indique 27 passed (27 tests réussis) : les 25 tests du cours L’essentiel de Docker et du nuage pour les développeurs en IA et les deux nouveaux. Dans votre demande de tirage, la vérification « Lint, test, audit, evaluate » réussit. Son journal se termine par Gate passed. (barrière franchie). L’artefact reports de l’exécution contient maintenant evaluation.json à côté de junit.xml. Avant la modification de l’ensemble de règles, la zone de fusion attend « Lint, test, audit » (vérifier le style, tester, auditer). Aucun flux de travail n’exécute plus cette vérification.
À vous de jouer : rendre la réussite du billet de Sam obligatoire
Section intitulée « À vous de jouer : rendre la réussite du billet de Sam obligatoire »Le billet de Sam compte aussi. Essayez d’en faire un quatrième billet à réussite obligatoire, sans modifier le classificateur. Cette expérience est temporaire : ajoutez la ligne sur votre ordinateur, mais ne créez pas de commit. Ajoutez-la à la fin du fichier :
{"id": "E052", "split": "holdout", "subject": "I lost my password", "body": "", "category": "login", "priority": 2, "must_pass": true}Prédisez d’abord : que dit la barrière pour keywords-1.1? Et pour keywords-1.0, la version en production? Exécutez ensuite les deux.
Afficher la réponse
Les deux échouent (simulation) :
keywords-1.0 on 34 holdout tickets (baseline keywords-1.0)accuracy 0.647...must-pass failures: 1FAIL: must-pass cases failed: E052Gate failed.keywords-1.1 on 34 holdout tickets (baseline keywords-1.0)accuracy 0.912...must-pass failures: 1FAIL: must-pass cases failed: E052Gate failed.Les deux versions placent « lost » (perdu) parmi les mots urgents. Elles attribuent donc toutes deux la priorité 1 à E052. Un billet à réussite obligatoire est une exigence. Si vous en ajoutez un que la production traite déjà mal, toutes les demandes de tirage échouent, même celles sans lien. Ajoutez donc un nouveau billet à réussite obligatoire dans la même demande de tirage que le correctif qui le fait réussir. La barrière prouve alors que le correctif fonctionne. Ici, ce correctif doit aussi garder E033 urgent. Par exemple, traitez « lost » comme urgent seulement en présence d’un mot lié à l’expédition.
Annulez l’expérience avant de continuer : git restore evaluation/tickets.jsonl. Ensuite, wc -l evaluation/tickets.jsonl indique de nouveau 51, et git status ne montre aucun changement. Le reste du cours et les instantanés utilisent ces 51 billets. Le Travail final : Partie 1 : exigences et vérifications part de ces billets. Il ajoute le billet de Sam pour de bon, avec le correctif.
Une vérification renommée
Section intitulée « Une vérification renommée »Un autre événement s’est produit dans la demande de tirage nº 3, avant la fusion.
Erreur courante
La vérification a été renommée et la demande de tirage ne peut pas être fusionnée
Symptôme (observé en direct) : dans la demande de tirage nº 3, les deux vérifications étaient vertes : « Lint, test, audit, evaluate » et « Build, smoke-test and push the image » (construire, tester sommairement et pousser l’image). Mais le bouton de fusion restait désactivé. gh pr view 3 --json mergeStateStatus indiquait BLOCKED (bloqué). Rien sur la page n’était rouge.
Cause : l’ensemble de règles sur main exige les vérifications par leur nom. Il attendait « Lint, test, audit », l’ancien nom de la tâche. Aucun flux de travail n’exécute plus de tâche portant ce nom. La vérification obligatoire reste donc indéfiniment à l’état « expected » (attendue). Renommer semble être un changement purement visuel. Mais pour l’ensemble de règles, cela supprime une vérification et en ajoute une nouvelle que personne n’exige.
Correctif :
- Ouvrez Settings → Rules → Rulesets (paramètres → règles → ensembles de règles) dans le dépôt. Ouvrez l’ensemble de règles de
main(« Protect main », protéger main, dans le dépôt de référence). - Sous Require status checks to pass (exiger la réussite des vérifications d’état), retirez « Lint, test, audit ».
- Ajoutez « Lint, test, audit, evaluate ». La liste propose les noms des vérifications exécutées récemment. Ce nom apparaît donc après la première exécution sous le nouveau nom.
- Enregistrez. Le bouton de fusion de la demande de tirage devient immédiatement actif, car la nouvelle vérification obligatoire a déjà réussi.
Ne corrigez pas le problème en retirant la vérification obligatoire ou en désactivant l’ensemble de règles « seulement pour cette fusion ». Cela laisse main sans protection pour toutes les fusions suivantes.
Pour un vrai service d’IA : la barrière n’en est une que si l’ensemble de règles l’exige. Un pipeline peut exécuter l’évaluation, afficher une croix rouge et quand même permettre la fusion si la vérification n’est pas obligatoire. Après avoir ajouté ou renommé une vérification, ouvrez une demande de tirage et regardez la zone de fusion. Elle doit indiquer que le nouveau nom est obligatoire.
Vérifiez votre compréhension
La demande de tirage nº 4 n'a changé ni l'exactitude (0,909) ni aucun rappel. Pourquoi la barrière a-t-elle quand même échoué, et pourquoi les moyennes ne détectaient-elles pas le problème?
Afficher la réponse
La partie des billets à réussite obligatoire a échoué. E033, « Parcel lost in transit » (colis perdu en transit), a reçu la priorité 2 plutôt que 1. Son seul mot urgent était « lost ». L’exactitude et le rappel comptent seulement la catégorie, et E033 restait shipping (expédition). Une erreur de priorité sur un billet parmi 33 change aussi très peu les moyennes. Un billet à réussite obligatoire désigne le billet et vérifie sa catégorie et sa priorité. Un seul billet important mal traité suffit donc à provoquer l’échec.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Amira veut choisir de nouveaux mots-clés en lisant les billets que keywords-1.1 traite mal dans les données réservées. Quel est le problème, et que devrait-elle faire?
Afficher la réponse
Les billets réservés serviraient alors à choisir les mots. Ils ne seraient donc plus inconnus du classificateur. La barrière mesurerait le classificateur sur des billets auxquels il a été ajusté. Le score semblerait meilleur que celui des billets du mois prochain, comme sur les données de développement (1,0 plutôt que 0,909). Elle peut déplacer les billets qu’elle lit vers les données de développement. Elle ajoute ensuite de nouveaux billets réservés étiquetés que personne n’a lus. La barrière conserve ainsi un test honnête.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : Amira remplace la commande de la barrière dans ci.yml par python -m evaluation.run --classifier 1.0. La production exécute 1.0. La barrière est-elle maintenant plus sûre?
Afficher la réponse
Non. La barrière testerait toujours le classificateur déjà en production. Elle réussirait donc pour chaque demande de tirage, quels que soient les changements apportés à keywords-1.1. La demande de tirage nº 4 aurait été fusionnée. La barrière doit tester la version qu’apporte le changement (ici 1.1, la version candidate). Elle doit la comparer à la version en production (la référence de base).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Un test vérifie une réponse choisie. Une évaluation mesure un classificateur sur un ensemble fixe de billets étiquetés : exactitude, rappel par catégorie et billets à réussite obligatoire.
- La barrière utilise les billets réservés : personne ne les a utilisés pour construire le classificateur. Sur les billets de développement, 1.1 semblait parfait (1,0). Sur les billets réservés, il obtenait 0,909.
- La barrière comporte trois parties : des minimums, aucune régression par rapport à la référence de base en production, et des billets à réussite obligatoire avec la bonne priorité. Un seuil élevé fixe faisait échouer la version en production elle-même.
- La demande de tirage nº 4 a réussi la vérification de style (après un correctif), tous les tests et la vérification de sécurité. L’exactitude est restée à 0,909. Elle a quand même échoué : E033 a perdu sa priorité 1.
- Une vérification obligatoire est exigée par son nom. Après l’avoir renommée, mettez à jour l’ensemble de règles. Sinon, une demande de tirage verte reste BLOCKED (bloquée).
Leçon suivante : Migrations sûres