
Définir les vérifications
- Leçon 3
- 50 min
- Module 1 : Comprendre le chemin de livraison
Leçon 3 sur 15 · CI/CD, tests et mises en production sûresDéfinir les vérifications
1. Comprendre le chemin de livraison
2. Créer un pipeline CI reproductible
3. Gérer les environnements et les secrets
4. Mettre en production les changements d'IA et de base de données
5. Rétablir et maintenir le processus de mise en production
Ce que vous saurez faire
« Tous les tests ont réussi » ne dit rien sur les erreurs qu’aucun test ne cherche. Donnez un rôle clair à chaque vérification. Ensemble, elles pourront détecter les erreurs importantes, et les plus rapides échoueront en premier.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- pytest et
TestClient, vus dans Tests automatisés des points de terminaison : testClient : des requêtes sans serveur du cours Créer et déployer votre première API. - Le test de contrat, vu dans Garder la documentation exacte : détecter un changement accidentel du cours sur les API.
- Les vérifications de fumée, vues dans Vérifier et nettoyer : une vérification rapide du cours sur les API et Vérifier et supprimer : tests de bon fonctionnement : ce que ce déploiement doit prouver du cours L’essentiel de Docker et du nuage pour les développeurs en IA.
- Le pipeline et ses barrières, vus dans Du commit à la mise en production : le pipeline et ses barrières.
- Le flux de branches, vu dans Choisir un flux de branches : écrire la source et la cible.
Ce qu’il vous faut sur votre ordinateur
- Votre API de billets de soutien du cours Docker, dans
~/projects/ticket-api(Windows :$HOME\projects\ticket-api). Elle doit être dans un dépôt Git, avec tous les changements enregistrés par un commit (enregistrement des changements). Elle doit avoir son environnement virtuel.venvet 25 tests qui réussissent. L’exercice guidé modifie deux fichiers, puis les restaure. L’exercice du module copie le projet dans le dossier du cours,~/projects/ticket-api-ci, et y ajoutedocs/release-process.md. - Si le projet manque ou ne fonctionne plus, copiez l’instantané
end-of-m05du cours Docker, comme dans Utiliser un instantané. Ensuite, recréez l’environnement virtuel et installezrequirements-lock.txt, comme dans le cours sur les API. - Un navigateur et, au besoin,
curlet Python 3, comme dans la leçon 1.
Exécuté avec GitHub Actions (exécuteurs ubuntu-24.04) dans le dépôt public Nextia-Intelligence/ticket-api-ci. Les commandes locales ont été exécutées avec Python 3.14.6 et pytest 9.1.1 sur macOS (puce Apple). Les étapes Windows ne sont pas testées.
25 tests ont réussi, et le billet urgent ne l’était pas
Section intitulée « 25 tests ont réussi, et le billet urgent ne l’était pas »Sam a signalé que « J’ai perdu mon mot de passe » reçoit la priorité 1. Le service de soutien traite la priorité 1 comme urgente, mais un mot de passe perdu ne l’est pas. Le classificateur marque un billet comme urgent s’il contient un mot d’une courte liste :
URGENT_WORDS = ("cannot", "locked out", "charged twice", "lost")La correction rapide consiste à retirer "lost" (perdu). Amira l’essaie sur son ordinateur et lance les tests :
python -m pytest -qLa sortie :
......................... [100%]25 passed in 0.36sTous les tests réussissent. Ensuite, elle interroge le classificateur sur deux billets, avant et après le changement :
python -c "from ticket_api.classifier import KeywordClassifier; print(KeywordClassifier().predict('I lost my password'))"python -c "from ticket_api.classifier import KeywordClassifier; print(KeywordClassifier().predict('Parcel lost in transit'))"La sortie, avant le changement :
Prediction(category='login', priority=1, confidence=0.7)Prediction(category='shipping', priority=1, confidence=0.7)Après le changement :
Prediction(category='login', priority=2, confidence=0.7)Prediction(category='shipping', priority=2, confidence=0.7)Le billet de Sam est corrigé. Mais un colis perdu est urgent, et il a aussi perdu sa priorité. Aucun test ne l’a remarqué, car aucun test ne porte sur un colis perdu. Les tests vérifient le fonctionnement de l’API : codes d’état, validation, contrat. Ils ne vérifient pas la qualité du classificateur.
Amira essaie une deuxième erreur : elle ajoute import os en haut de ticket_api/routes.py. Le code n’utilise jamais cette ligne. Le résultat :
25 passed in 0.21sEncore une fois, tous les tests réussissent. Les tests exécutent le code. Ils ne le lisent pas. Chaque type d’erreur exige donc une vérification qui la cherche. C’est la règle de cette leçon : nommez d’abord l’erreur, puis choisissez la vérification.
Huit vérifications, huit objectifs
Section intitulée « Huit vérifications, huit objectifs »Une vérification est une étape automatique qui réussit ou échoue, et qui arrête le pipeline en cas d’échec. Le pipeline de l’API de billets en compte huit. La dernière colonne donne leur durée dans la dernière exécution CI du dépôt de référence (exécution 37672744134) :
| Vérification | Commande | Ce qu’elle détecte | Ce qu’elle ne peut pas détecter | Durée |
|---|---|---|---|---|
| Analyse statique | ruff check . |
Des erreurs visibles sans exécuter le code : importation inutilisée, nom inexistant, absence de from après raise, ligne trop longue |
Le comportement incorrect d’un code écrit correctement | moins de 1 s |
| Tests unitaires | pytest |
Une fonction ou un point de terminaison qui ne répond pas aux attentes du test : mauvais code d’état, champ manquant, règle de validation | Un cas absent des tests; une vraie base de données | environ 2 s pour tous les tests pytest |
| Test de contrat | pytest (tests/test_contract.py) |
Un changement d’API que personne n’a révisé, comme un champ renommé | Un changement qui respecte le contrat, mais modifie les réponses | (avec les tests unitaires) |
| Tests d’intégration (base de données) | pytest, avec une base de données PostgreSQL |
Du code qui échoue avec une vraie base de données : migration, requête, type | Une autre version de la base de données en production; des données absentes des tests | (avec les tests unitaires) |
| Vérification de sécurité | pip-audit -r requirements-run.txt |
Un paquet avec une vulnérabilité connue et publiée | Une vulnérabilité non encore publiée; une erreur dans votre propre code | 9 s |
| Évaluation de l’IA | python -m evaluation.run |
Un classificateur moins bon que celui en production, ou qui se trompe sur un billet à réussite obligatoire | Un type de billet absent du jeu étiqueté | moins de 1 s |
| Vérification de fumée de l’image | scripts/smoke.sh sur la nouvelle image, dans l’exécuteur CI |
Une image qui ne démarre pas ou qui répond incorrectement | Les paramètres, les secrets et le réseau d’un environnement réel | 2 s (construction : 9 s) |
| Vérification de fumée du déploiement | scripts/smoke.sh sur l’adresse de l’environnement |
Un déploiement qui ne fonctionne pas avec ces paramètres, ce secret, cette adresse | Des chemins rares que la vérification de fumée n’appelle pas | une partie de chaque tâche de déploiement (environ 55 s) |
Les termes, définis une seule fois :
- L’analyse statique utilise un analyseur qui lit le code sans l’exécuter. Il signale des motifs qui sont presque toujours des erreurs. Le projet utilise ruff avec les groupes de règles E, F, I et B.
- Un test unitaire exécute une partie du code, comme un point de terminaison avec
TestClient, et compare le résultat au résultat attendu. Il n’a besoin ni de réseau ni de base de données. - Un test de contrat compare le document OpenAPI de l’API à la copie révisée dans
contract/openapi.json. Le cours sur les API l’a créé. - Un test d’intégration exécute le code avec une vraie dépendance. Ici, CI démarre une base de données PostgreSQL pour la tâche.
- Une vérification de sécurité compare les versions exactes des paquets à une liste publique de vulnérabilités connues.
- Une évaluation de l’IA exécute le classificateur sur des billets étiquetés jamais vus pendant sa création. Elle compare les scores à des règles fixes. Un billet à réussite obligatoire est un billet étiqueté que le classificateur doit toujours classer correctement, avec la bonne priorité. Le module 4 construit l’évaluation.
- Une vérification de fumée envoie quelques requêtes réelles à une copie en cours d’exécution et vérifie les réponses. Celle de l’image s’exécute sur l’exécuteur CI. Celle du déploiement vise la préproduction et la production. (On l’appelle aussi test de fumée. Les cours sur les API et Docker l’appelaient une vérification de fumée, et ce cours aussi.)
Aujourd’hui, votre projet contient les tests unitaires et le test de contrat (25 tests). Le module 2 ajoute l’analyse statique, la vérification de sécurité et la vérification de fumée de l’image. Le module 3 ajoute la vérification de fumée du déploiement. Le module 4 ajoute les tests de base de données et l’évaluation de l’IA.
Quelle vérification détecte quelle erreur
Section intitulée « Quelle vérification détecte quelle erreur »Voici des erreurs réelles du dépôt de référence et des cours précédents. Chacune s’est arrêtée à la première vérification qui la cherche :

Description textuelle du diagramme
Six erreurs traversent les vérifications de gauche à droite. Deux problèmes d’analyse statique de la première exécution CI, et une ligne trop longue dans la demande de tirage no 4, s’arrêtent à l’analyse statique. Un champ renommé du cours sur les API s’arrête au test de contrat. Le mot urgent retiré dans la demande de tirage no 4 passe l’analyse statique et les tests. Il s’arrête à l’évaluation de l’IA, car le billet à réussite obligatoire E033 a perdu sa priorité. Un mauvais paramètre de connexion Azure passe toutes les vérifications CI et s’arrête en préproduction, avant la production. Le billet de Sam, « J’ai perdu mon mot de passe » avec la priorité 1, passe toutes les vérifications. Il est en production, car aucune vérification ne contient ce billet.
Lisez les lignes à partir du haut :
-
La première exécution CI du dépôt a échoué à l’analyse statique. Le code du cours Docker avait un
raisesansfrom(B904,config.py:28) et des importations non triées (I001,routes.py:1). Ses 25 tests réussissaient sur tous les ordinateurs. Seul l’analyseur statique lit le code. Le module 2 reproduit cette exécution et corrige les erreurs. -
La première exécution de la demande de tirage no 4 a échoué à l’analyse statique, avec
E501 Line too long (101 > 100)(ligne trop longue) : une vraie erreur, corrigée dans le deuxième commit. -
Le test de contrat détecte un champ renommé. Le cours sur les API l’a montré avec
model_version→version. -
La deuxième exécution de la demande de tirage no 4 a passé l’analyse statique, les tests et la vérification de sécurité. Elle a échoué à l’évaluation de l’IA. C’est le changement d’Amira du début de la leçon, dans le vrai dépôt :
accuracy 0.909must-pass failures: 1FAIL: must-pass cases failed: E033Gate failed.E033 est « Colis perdu en transit ». L’exactitude globale n’a pas changé. Seule la vérification à réussite obligatoire a détecté le problème. Le module 4 construit cette barrière.
-
Le premier déploiement a échoué en préproduction, à la connexion Azure. Aucune vérification CI ne peut tester une connexion au nuage. La préproduction le peut, et la production n’a pas démarré (leçon 1, K2). Le module 3 explique l’erreur.
-
Le billet de Sam est encore en production. Aucune vérification ne contient « J’ai perdu mon mot de passe ». Une vérification ne détecte que les erreurs qu’elle cherche.
Les vérifications rapides en premier
Section intitulée « Les vérifications rapides en premier »Quand une vérification échoue, le pipeline s’arrête, et les vérifications suivantes ne s’exécutent pas. Placez donc les vérifications rapides et peu coûteuses en premier. Une erreur d’analyse statique échoue alors en moins d’une seconde, sans attendre la construction d’une image. La page d’exécution de la demande de tirage no 4 le montre :
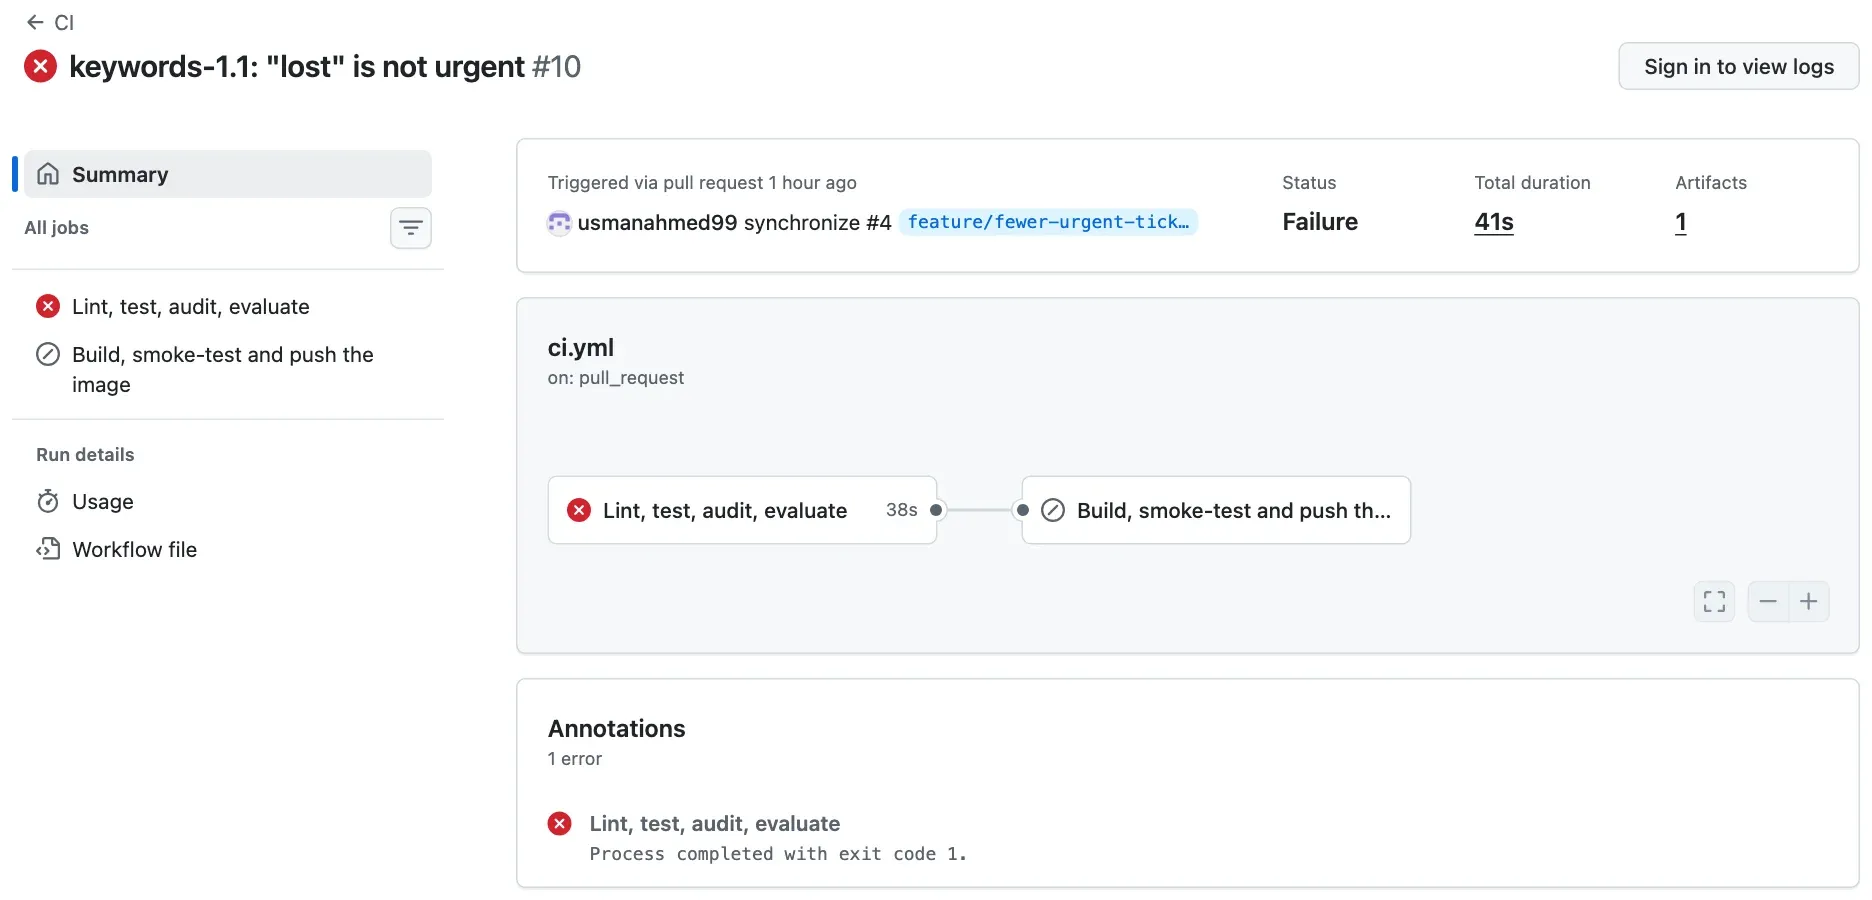
La page n’indique pas quelle étape a échoué : il faut se connecter pour consulter les journaux (logs). L’API publique donne la liste des étapes :
curl -s https://api.github.com/repos/Nextia-Intelligence/ticket-api-ci/actions/runs/37666571062/jobs \ | python3 -c "import json,sys; [print(s['name'], '|', s['conclusion']) for j in json.load(sys.stdin)['jobs'] for s in j['steps']]"curl.exe -s https://api.github.com/repos/Nextia-Intelligence/ticket-api-ci/actions/runs/37666571062/jobs | python -c "import json,sys; [print(s['name'], '|', s['conclusion']) for j in json.load(sys.stdin)['jobs'] for s in j['steps']]"La sortie :
Set up job | successRun actions/checkout@v7 | successRun actions/setup-python@v7 | successInstall the exact versions | successLint | successUnit and contract tests | successSecurity - known vulnerabilities in the image's packages | successAI evaluation gate | failureKeep the test and evaluation reports | successPost Run actions/setup-python@v7 | skippedPost Run actions/checkout@v7 | successComplete job | successLa tâche d’image n’a aucune étape dans la liste : elle a été ignorée. L’étape « Conserver les rapports de test et d’évaluation » s’est exécutée après l’échec, volontairement (if: always(), module 2). La preuve de l’échec est donc conservée.
L’ordre dans le dépôt de référence :
- Dans une seule tâche, les vérifications qui ont seulement besoin du code : analyse statique, puis tests, vérification de sécurité et évaluation de l’IA. Elles partagent un exécuteur et une installation.
- Dans une deuxième tâche, seulement si la première a réussi : construire l’image, puis effectuer son test de fumée. Une construction prend plus de temps et ne sert à rien si le code a déjà échoué.
- Après le déploiement, dans chaque environnement : la vérification de fumée du déploiement.
Placer les vérifications rapides en premier ne justifie pas d’omettre une vérification lente. La vérification de sécurité prend 9 secondes sur 50. C’est la seule qui détecte un paquet vulnérable.
Exercice guidé : voir ce que les tests ne peuvent pas voir
Section intitulée « Exercice guidé : voir ce que les tests ne peuvent pas voir »- Ouvrez un terminal dans
~/projects/ticket-api. Activez l’environnement virtuel :source .venv/bin/activate(Windows :.venv\Scripts\Activate.ps1). - Exécutez
git status. Vérifiez que la sortie indiquenothing to commit, working tree clean(rien à enregistrer, arborescence de travail propre). - Exécutez
python -m pytest -q. Vérifiez la dernière ligne :25 passed(25 tests réussis). - Interrogez le classificateur sur « Colis perdu en transit », avec la commande
python -cde l’exemple détaillé. Notez la priorité. - Dans
ticket_api/classifier.py, retirez, "lost"deURGENT_WORDS. Enregistrez le fichier. - Prédisez : combien de tests réussiront maintenant? Quelle priorité recevra « Colis perdu en transit »?
- Exécutez
python -m pytest -q, puis la commandepython -cde nouveau. - Ajoutez
import oscomme première ligne deticket_api/routes.py. Enregistrez et exécutez de nouveaupython -m pytest -q. - Restaurez les deux fichiers :
git restore ticket_api/classifier.py ticket_api/routes.py. - Exécutez de nouveau
git status. Vérifiez que le projet est propre.
Afficher les résultats attendus
25 passed in 0.53s(25 tests réussis en 0,53 s; votre durée sera différente).Prediction(category='shipping', priority=1, confidence=0.7)(prédiction : catégorie expédition, priorité 1, confiance 0,7).- Les 25 tests réussissent encore, et le billet reçoit la priorité 2.
25 passed, etPrediction(category='shipping', priority=2, confidence=0.7)(prédiction : catégorie expédition, priorité 2, confiance 0,7).25 passed. Les tests exécutent le code; ils ne le lisent pas.nothing to commit, working tree clean.
Deux erreurs différentes, et aucun test en échec. La première exige une évaluation de l’IA avec un billet à réussite obligatoire. La deuxième exige un analyseur statique. Sur Windows, si PowerShell refuse d’exécuter le script d’activation, exécutez Set-ExecutionPolicy -Scope CurrentUser RemoteSigned une fois.
À vous de jouer : choisir la vérification
Section intitulée « À vous de jouer : choisir la vérification »Pour chaque erreur, nommez la première vérification du pipeline qui la détecte. Si aucune des huit ne la détecte, indiquez la vérification manquante.
requirements-run.txtfixe une version d’un paquet qui présente une vulnérabilité publiée.- Une nouvelle ligne du
Dockerfilecopie le code dans le mauvais dossier. L’image se construit, mais l’application ne démarre pas. - Le secret
api-keyde l’application en production est vide. Celui de la préproduction est correct. - Une requête dans
ticket_api/history.pyutilise un nom de colonne qui existe seulement dans SQLite, pas dans PostgreSQL. - Un billet de soutien ayant pour objet « Facturé deux fois » et pour corps « Ma carte a été débitée deux fois pour une commande. » reçoit la catégorie
billing, mais la priorité 2.
Afficher les réponses
- La vérification de sécurité (
pip-audit). Les tests ne peuvent pas la détecter : le code vulnérable fonctionne. - La vérification sommaire de l’image.
/healthne répond pas. La tâche échoue donc avant l’envoi de l’image. Les tests unitaires exécutent le code depuis le dossier, pas depuis l’image. Ils réussissent donc. - La tâche de déploiement en production. Soit la nouvelle révision n’est pas prête, soit la vérification sommaire
classify with the key(classifier avec la clé) échoue. Toutes les vérifications CI et la préproduction réussissent, car elles utilisent d’autres clés. Seules la tâche de déploiement et la vérification sommaire propres à la production testent ses paramètres. Après l’échec, l’équipe déploie la dernière empreinte valide (module 5). - Les tests d’intégration (base de données), s’ils utilisent PostgreSQL, comme dans le dépôt de référence. Un test unitaire sans base de données, ou avec une autre base, ne peut pas détecter cette erreur.
- L’évaluation de l’IA, car il s’agit du billet E019, qui doit absolument réussir et recevoir la priorité 1. Si ce billet ne figurait pas dans le jeu étiqueté, aucune vérification ne détecterait l’erreur, comme pour le billet de Sam. La vérification manquante serait alors un nouveau billet étiqueté.
Erreur courante
Toutes les vérifications ont réussi, mais le bogue reste en production
Symptôme : le billet de Sam « J’ai perdu mon mot de passe » reçoit la priorité 1 en production. Toutes les exécutions du pipeline du dépôt de référence ont réussi avec ce code, de la première à la dernière.
Cause : une vérification détecte seulement les erreurs qu’elle cherche. Cherchez le billet dans le jeu d’évaluation étiqueté (un clone de la leçon 2, dans ~/projects/c19-reference) :
grep -i "lost" evaluation/tickets.jsonlLa sortie :
{"id": "E011", "split": "dev", "subject": "Parcel lost", "body": "The courier says the parcel is lost.", "category": "shipping", "priority": 1, "must_pass": false}{"id": "E030", "split": "holdout", "subject": "Two-factor reset", "body": "I lost the phone with my two-factor app.", "category": "login", "priority": 2, "must_pass": false}{"id": "E033", "split": "holdout", "subject": "Parcel lost in transit", "body": "The tracking stopped and the parcel is lost.", "category": "shipping", "priority": 1, "must_pass": true}Aucun billet ne dit « J’ai perdu mon mot de passe ». E030 s’en rapproche, mais ce n’est pas un billet qui doit absolument réussir. De plus, l’exactitude tient compte de la catégorie, pas de la priorité. Toutes les vérifications réussissent donc.
Correction :
- Transformez l’erreur en vérification avant de la corriger : ajoutez le billet au jeu étiqueté, avec la priorité voulue par le service de soutien.
- Exécutez la vérification. Elle doit échouer avec le code actuel. Une vérification qui réussit avant la correction ne prouve rien.
- Corrigez ensuite le code et gardez la vérification. Elle protège maintenant chaque changement futur.
- Corrigez l’erreur sans faire échouer E033. La demande de tirage (pull request) no 4 a supprimé « lost » (perdu) pour tous les cas. La barrière l’a bloquée (module 4). La vraie correction exige une règle qui distingue un mot de passe perdu d’un colis perdu. Le travail final de ce cours la crée.
Pour un vrai service d’IA : un modèle peut réussir tous les tests du code et se tromper sur les cas les plus importants pour les utilisateurs. Un pipeline vert signifie « aucune erreur connue ». Les signalements comme celui de Sam allongent la liste des erreurs connues. Transformez chaque signalement en cas étiqueté.
Vérifiez votre compréhension
Votre projet compte 25 tests qui réussissent. Nommez deux types d'erreurs de cette leçon qu'ils ne détectent pas, et la vérification qui détecte chacun.
Afficher la réponse
Une importation inutilisée, un from manquant après raise ou une ligne trop longue : les tests exécutent le code sans le lire. L’analyse statique (lint) détecte donc ces erreurs. Un changement du classificateur peut faire échouer un billet important, comme « Colis perdu en transit », qui perd sa priorité 1. Les tests vérifient que l’API fonctionne, pas que le classificateur donne la bonne réponse. L’évaluation de l’IA, avec un billet qui doit absolument réussir, détecte donc cette erreur. Autres bonnes réponses : un paquet vulnérable (vérification de sécurité), une image qui ne démarre pas (vérification sommaire de l’image), un mauvais secret dans un environnement (vérification sommaire du déploiement dans cet environnement).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Pourquoi le pipeline exécute-t-il l'analyse statique et les tests avant de construire l'image, plutôt que l'inverse?
Afficher la réponse
L’analyse statique prend moins d’une seconde et les tests environ une seconde. Ils échouent pour la plupart des erreurs de code. La construction et la vérification sommaire de l’image prennent plus de temps. Si une vérification peu coûteuse échoue d’abord, le pipeline s’arrête immédiatement. Personne n’attend la construction d’un code déjà incorrect. Lors de la première exécution du dépôt de référence, la tâche de vérification a échoué à l’analyse statique après 25 secondes. Le pipeline a ignoré la tâche de l’image. L’ordre change le délai avant la première réponse. Chaque vérification s’exécute quand même pour chaque changement qui atteint cette étape.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Exercice du module
Section intitulée « Exercice du module »Exercice guidé → tâche autonome. Vous avez suivi un changement dans le pipeline (leçon 1), placé des changements dans le flux de branches (leçon 2) et choisi des vérifications (cette leçon). Rédigez maintenant les règles du projet et utilisez-les.
Partie 1 : rédiger docs/release-process.md. D’abord, créez un dossier de projet propre au cours, ~/projects/ticket-api-ci. Le module 2 place ce dossier sur GitHub dans votre dépôt ticket-api-ci. Clonez-y votre projet du cours sur Docker. Un clone copie les commits (enregistrements des changements) et leurs fichiers. Il exclut les fichiers ignorés par Git, comme .venv, .env et secrets/. Aucun secret ne peut donc entrer par accident dans le nouveau dépôt :
git clone ticket-api ticket-api-cicd ticket-api-cigit remote remove origingit log --oneline -1git remote remove origin supprime le lien vers le dossier du cours sur Docker. Le module 2 pourra ainsi ajouter GitHub comme dépôt distant. git log affiche le dernier commit de votre projet du cours sur Docker. Ce dossier ne change pas. Dans ~/projects/ticket-api-ci, créez le dossier docs et le fichier docs/release-process.md. Il doit contenir trois sections :
- Branches : chaque branche, sa branche de départ, sa destination de fusion et son rôle. Donnez un exemple de demande de tirage avec sa source et sa cible.
- Vérifications : chaque vérification, ce qu’elle prouve et quand elle s’exécute.
- Du commit à la production : les étapes numérotées et ce qui ne se répète jamais après la construction.
Créez ensuite un commit sur main. Le dossier n’a pas encore de dépôt distant. Le module 2 crée le dépôt GitHub et y pousse ce commit.
git add docs/release-process.mdgit commit -m "Describe the delivery path: branches, checks and promotion"Partie 2 : tracer le parcours de deux changements dans votre processus. Pour chacun, écrivez toutes les étapes dans l’ordre : la branche et son point de départ, chaque demande de tirage sous la forme « source vers cible », les exécutions des flux de travail et leurs déclencheurs, chaque barrière, les environnements, l’approbation et l’étiquette.
- Une fonctionnalité : le classificateur
keywords-1.1, désactivé par défaut. - Un correctif urgent : la production utilise
v1.2.0,GET /v1/historyéchoue pour les anciennes lignes etmaincontient déjà un changement non publié.
Comparez ensuite votre réponse au parcours réel dans le dépôt de référence.
Afficher une réponse modèle
Partie 1. Le fichier du dépôt de référence, tel qu’il était à la fin de ce module (da4e3f3) :
# How a change reaches production
## Branches
We use **mainline development**: `main` is always releasable, and every change reaches it through a pull request.
| Branch | Made from | Merges into | Used for ||---|---|---|---|| `main` | | | The current code. Every commit on `main` is built once, and the image can go to production. || `feature/<short-name>` | `main` | `main`, by pull request | Every normal change. Short-lived: one change, merged within a few days. || `hotfix/<version>` | the release tag, for example `v1.2.0` | `main`, by pull request, after the release | An urgent fix to the version in production, when `main` already has changes that are not ready. |
A pull request names its source and target: for example, `feature/eval-gate` into `main`, or `hotfix/1.2.1` into `main`.
Releases are Git tags on `main` (or on a hotfix branch): `v1.1.0`, `v1.2.0`, `v1.2.1`. The version follows semantic versioning: the last number for a fix, the middle one for a new feature that does not break clients, the first one for a breaking change.
## Checks
| Check | What it proves | When ||---|---|---|| Lint (`ruff check .`) | The code has no simple mistakes, such as an unused import or a name that does not exist | Every pull request and every push || Unit and contract tests (`pytest`) | Each part does what it must; the API contract has not changed by accident | Every pull request and every push || Database tests (`pytest`, with PostgreSQL) | The migrations apply, and the history works with a real database | Every pull request and every push || Security (`pip-audit`) | No package in the image has a known vulnerability | Every pull request and every push || AI evaluation gate (`python -m evaluation.run`) | The classifier is not worse than the one in production, and every must-pass ticket is right | Every pull request and every push || Image smoke check (`scripts/smoke.sh`) | The built image starts and answers, before it leaves the CI runner | Every pull request and every push || Deployment smoke check | This deployment, with these settings, works | After each deployment, in each environment |
`scripts/check.sh` runs the same checks on your computer.
## From commit to production
1. A pull request runs every check. It can merge only when they pass.2. A push to `main` runs the checks again, builds the image once, smoke-checks it, and pushes it to `ghcr.io/usmanahmed99/ticket-api-ci` with the tag `sha-<commit>`. `build-info.json` records the digest, the commit and the run.3. The Deploy workflow deploys that digest to **staging** and smoke-checks it.4. A reviewer approves the **production** deployment in GitHub. The same digest goes to production and is smoke-checked again.
Nothing is built again after step 2. Staging and production run the same image; only their settings differ.
Il décrit des vérifications qui n’existent pas encore, comme scripts/check.sh et les tests de base de données. C’est volontaire : le fichier est le plan, et les modules 2 à 4 le réalisent. Votre fichier peut utiliser d’autres mots. La personne qui le révise indique démontré s’il nomme la source et la cible de chaque type de branche. Il doit aussi donner un objectif à chaque vérification et préciser que l’image est construite une seule fois, puis promue par son empreinte.
Partie 2, la fonctionnalité (demande de tirage no 3, réelle) :
feature/classifier-1.1à partir demain; commit19d172b; le classificateur est désactivé par défaut (CLASSIFIER_VERSION=1.0).- Demande de tirage de
feature/classifier-1.1versmain. La CI s’exécute avec le déclencheurpull_request(exécution 37666141730) : toutes les vérifications et une construction de test, sans envoi. - Barrière : l’ensemble de règles exige deux vérifications vertes et une branche à jour. Fusion :
7324d7b. - CI avec le déclencheur
pushversmain(exécution 37666387332) : les vérifications à nouveau, puis l’imagesha-7324d7b. Elle est construite une seule fois, soumise à une vérification sommaire et poussée. Empreintesha256:e5157802…. - Déploiement avec le déclencheur
workflow_run(exécution 37666627403) : préproduction avec cette empreinte, vérification sommaire; la production attend la personne responsable de la révision. Approbation avec un commentaire; même empreinte en production, vérification sommaire. - Aucune étiquette pour l’instant. Le changement a été mis en production plus tard dans
v1.2.0, avec la demande de tirage no 5.
Partie 2, le correctif urgent (1.2.1, réel) :
hotfix/1.2.1à partir de l’étiquettev1.2.0, pas demain, carmaincontient la demande de tirage no 6, non publiée. Commitfc9005a: un test qui échoue sans la correction, la correction, une vérification sommaire de/v1/history, la version1.2.1et ses notes.- Poussez la branche. La CI s’exécute sur
pushvershotfix/**(exécution 37669759163) avec toutes les vérifications, puis pousse l’imagesha-fc9005a. Aucune vérification n’est omise pour un correctif urgent. - Ajoutez l’étiquette
v1.2.1surfc9005aet poussez-la. Le flux de travail Release (exécution 37669994015) donne l’étiquette de version à cette image, sans nouvelle construction. - Déployez manuellement, avec Run workflow (exécuter le flux de travail) et l’empreinte (exécution 37670050850, déclencheur
workflow_dispatch) : préproduction, vérification sommaire, approbation, production, vérification sommaire. Le flux Deploy automatique s’exécute seulement pourmain. - Demande de tirage de
hotfix/1.2.1versmain(demande de tirage no 7). Elle était en retard surmain. Update branch (mettre à jour la branche) a donc fusionnémaindans la branche du correctif urgent (543b003). Les vérifications ont été exécutées à nouveau. Fusion :3464f2c. - CI et Deploy s’exécutent pour
main, comme pour chaque changement. La prochaine mise en production depuismainconserve la correction.
La personne qui révise indique démontré pour la partie 2 si les deux parcours nomment chaque branche avec son point de départ. Ils doivent aussi nommer chaque demande de tirage sous la forme source vers cible, les vérifications avant chaque fusion et chaque déploiement, l’approbation et la fusion du correctif urgent dans la branche principale. Le module 5 exécute la procédure de correctif urgent au complet.
Vérification du module
Section intitulée « Vérification du module »Vérifiez votre compréhension
Rappel : nommez les éléments d'un pipeline GitHub Actions — déclencheur, flux de travail, tâche, étape, exécuteur, artefact, environnement — avec un exemple de chacun tiré de l'API de billets.
Afficher la réponse
Déclencheur : l’événement qui lance un flux de travail, comme une poussée vers main, une demande de tirage, une poussée d’étiquette ou « flux de travail CI terminé ». Flux de travail : un processus automatisé dans un fichier YAML, comme ci.yml. Tâche : un groupe d’étapes sur une machine, comme « Analyser, tester, auditer, évaluer ». Étape : une commande ou une action, comme ruff check .. Exécuteur : la machine d’une tâche, comme une nouvelle machine virtuelle ubuntu-24.04. Artefact : un fichier conservé par l’exécution, comme build-info avec l’empreinte; l’image est la principale sortie de construction. Environnement : un endroit où l’application s’exécute avec ses propres paramètres et règles, comme staging (préproduction) et production.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédiction : avant l'ensemble de règles, Amira a poussé directement vers main un commit avec deux erreurs d'analyse statique. Qu'a fait le pipeline, et qu'est-ce qui a atteint la production?
Afficher la réponse
La CI s’est exécutée après la poussée vers main, et l’étape Lint a échoué : « 2 erreurs trouvées. » Les tests et la vérification de sécurité de la même tâche ont été ignorés, ainsi que la tâche de l’image. Aucune image n’a donc été poussée. Rien n’a atteint la production : Deploy démarre seulement quand la CI réussit sur main, et aucune empreinte n’était disponible à déployer. Il s’agissait de l’exécution 37663263329. Le pipeline a protégé la production, mais le mauvais commit restait sur main. C’est pourquoi le module 2 ajoute l’ensemble de règles : une demande de tirage avec des vérifications vertes avant d’atteindre main.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification finale : expliquez ce qui empêche un commit non validé d'atteindre la production dans le pipeline de l'API de billets. Nommez chaque contrôle et ce qu'il bloque.
Afficher la réponse
Quatre contrôles, l’un après l’autre :
- L’ensemble de règles sur
mainbloque une poussée directe versmainet exige une demande de tirage. Ses vérifications obligatoires (« Analyser, tester, auditer, évaluer » et « Construire, vérifier sommairement et pousser l’image ») doivent être vertes. La branche doit être à jour avecmain. Aucun commit n’atteint doncmainsans les vérifications. - La CI sur
mainexécute à nouveau chaque vérification et construit l’image seulement si elles réussissent. Une vérification rouge signifie aucune image. - Deploy utilise seulement l’empreinte de la CI. Il démarre quand la CI réussit sur
mainet lit l’empreinte dans lebuild-infode la CI. Il ne construit jamais d’image. La préproduction et la production exécutent exactement l’image vérifiée. Un échec en préproduction arrête l’exécution avant la production. - L’environnement de production exige une personne responsable de la révision et accepte seulement les déploiements depuis
main. Un déploiement manuel (workflow_dispatch, pour un correctif urgent ou un retour en arrière) passe aussi par la préproduction et cette approbation.
Nommez aussi les lacunes. Une vérification détecte seulement ce qu’elle cherche (le billet de Sam). Les personnes ayant des droits d’administration peuvent modifier ou contourner les règles. Dans le dépôt de référence, le propriétaire est administrateur. L’environnement de production permet aux administrateurs de contourner sa règle (can_admins_bypass: true dans l’API). Une équipe retire cette permission et active Prevent self-review (empêcher l’autorévision), pour que la personne responsable de la révision ne soit pas l’auteur (module 3).
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Chaque vérification a un rôle. L’analyse statique lit le code; les tests unitaires et de contrat l’exécutent; les tests d’intégration l’exécutent avec une vraie base de données. La vérification de sécurité compare les paquets aux vulnérabilités connues. L’évaluation de l’IA mesure les résultats du classificateur sur des billets étiquetés. Les vérifications sommaires appellent une image en cours d’exécution et chaque déploiement.
- Nommez d’abord l’erreur, puis choisissez la vérification. Une vérification qui réussit avant une correction ne prouve rien.
- Placez les vérifications rapides en premier. Quand une vérification échoue, les étapes et les tâches suivantes ne s’exécutent pas.
- Chaque vérification peut manquer quelque chose. Un pipeline vert signifie « aucune erreur connue », et les signalements des utilisateurs ajoutent de nouvelles erreurs connues.
docs/release-process.mdcontient les règles du projet : branches, vérifications et parcours vers la production.
Le module. Vous pouvez maintenant suivre un changement du commit à la production et lire chaque barrière et sa sortie. Vous pouvez choisir une branche pour un changement et écrire sa demande de tirage sous la forme source vers cible. Vous pouvez aussi dire quelle vérification protège la production contre quelle erreur.
Réinitialisation. Pour annuler l’exercice guidé, exécutez git restore ticket_api/classifier.py ticket_api/routes.py dans votre projet. Pour recommencer l’exercice du module, supprimez le dossier ~/projects/ticket-api-ci et clonez-le à nouveau. Pour retirer le clone d’exercice, supprimez ~/projects/c19-reference. Si votre projet ne fonctionne plus, copiez l’instantané end-of-m01 de ce cours dans ~/projects/ticket-api-ci, comme dans Utiliser un instantané. Il contient docs/release-process.md. Le module 2 part de cet instantané.
Leçon suivante : Configurer l'exécuteur