
Gérer les défaillances
- Leçon 12
- 100 min
- Module 4 : Ajouter la fiabilité et le contrôle d'accès
Où nous en sommes
Dans la leçon précédente, nous avons exigé que chaque requête prouve qui appelle et ce qu'il peut faire. Mais une requête autorisée peut quand même échouer : un mauvais fichier, le même fichier deux fois, ou un fournisseur de modèle qui ne répond pas. Dans cette leçon, nous rendons chaque défaillance claire, limitée et sûre, et nous disons à l'utilisateur ce qui s'est passé. Nous commençons par une personne qui téléphone à un fournisseur pour un client.
Leçon 12 sur 22 · Projet intégrateur : créer, évaluer et livrer un produit d'IAGérer les défaillances
1. Choisir et délimiter le projet
2. Préparer les données et l'architecture
3. Créer un parcours utilisateur complet
4. Ajouter la fiabilité et le contrôle d'accès
5. Évaluer et améliorer
6. Déployer et exploiter
7. Préparer la présentation du portfolio
Ce que vous saurez faire
Rendez chaque défaillance claire, limitée et sûre. Refusez immédiatement un mauvais fichier, stockez le même fichier une seule fois et cessez d’attendre un modèle qui ne répond pas. Dites ensuite à l’utilisateur ce qui s’est passé.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les quatre vérifications et les jetons d’exercice, dans Appliquer les autorisations.
- L’ingestion sous forme de tâches avec des états (
uploaded → parsing → indexed | failed), dans Fondations du backend. - Les états d’erreur sur la page, dans Fondations du frontend.
- Les éléments que cette leçon réutilise :
- délais d’expiration, nouvelles tentatives et délai d’attente croissant : Gérer les limites du fournisseur, dans Créer des applications fiables avec les API de LLM;
- messages pour les personnes : Communiquer un échec, dans le même cours;
- états des tâches et baux : Cycle de vie d’une tâche, dans Mettre à l’échelle les API et les charges de travail d’IA;
- livraisons en double : Livraison et nouvelles tentatives, dans le même cours;
- un format d’erreur unique : Validation et réponses d’erreur, dans Créer et déployer votre première API.
Votre projet
~/projects/doc-assistantà l’instantanéend-of-m04, de la dernière leçon :python -m pytestse termine par95 passed. PostgreSQL fonctionne et l’ensemble est chargé (python -m scripts.load_pack).- Pour l’exécution manuelle : quatre terminaux avec l’environnement virtuel activé. Le fournisseur d’identité d’exercice fonctionne dans le premier (
python -m idp).
Aucun nouveau fichier à copier : la dernière leçon a copié tout le module. Testé avec Python 3.12 sur macOS. Les commandes PowerShell sont écrites, mais n’ont pas été exécutées.
Appeler un fournisseur pour un client
Section intitulée « Appeler un fournisseur pour un client »Une personne qui travaille dans un magasin téléphone à un fournisseur pour un client au comptoir. Personne ne répond. Combien de temps faut-il laisser sonner?
Une bonne personne au service a une règle. Laisser sonner pendant 30 secondes, raccrocher, attendre un moment et rappeler. Après le troisième appel, arrêter et dire la vérité au client : « Le fournisseur ne répond pas. Je n’ai passé aucune commande, donc rien n’est facturé. Veuillez réessayer plus tard. »
Une mauvaise personne au service laisse sonner sans fin, pendant que le client attend au comptoir. Ou elle appelle 50 fois de suite, ce qui occupe encore plus un fournisseur déjà occupé.
Le même magasin a un comptoir de colis. On refuse immédiatement au comptoir un colis trop gros pour les étagères. On accepte d’abord un colis qui semble en bon état, mais dont le contenu est brisé. Dans l’arrière-boutique, il reçoit une étiquette : « endommagé : la boîte a été écrasée ». Et un colis qui arrive deux fois n’est rangé qu’une fois.
L’assistant documentaire a maintenant besoin de toutes ces règles.
Le problème : ce que fait le module 3 quand quelque chose va mal
Section intitulée « Le problème : ce que fait le module 3 quand quelque chose va mal »Deux défaillances montrent le problème dans le projet du module 3. La première est un fichier téléversé deux fois. Avant ce module, un deuxième téléversement de la même version est refusé avec 409. Mais les mêmes octets sous un autre nom ne le sont pas. Ici, Sam ajoute une deuxième fois la FAQ de Bramble sous le nom faq-copy. Le module 3 n’a pas de connexion, donc chaque requête vient de Sam :
{"code":"conflict","message":"Version 4 of faq already exists. Upload it with a new version number, or delete the old one first.", ...} 409{"document":{"document_id":"fb88a033-…","doc_key":"faq-copy","version":"4","title":"Frequently asked questions", ... "sha256":"61d4344ea4a2db57…","status":"uploaded", ...},"duplicate":false} 202Après l’indexation, Bramble a 16 documents au lieu de 15 :
{'indexed': 16} [('faq', '4', 'indexed', '61d4344ea4a2'), ('faq-copy', '4', 'indexed', '61d4344ea4a2')]Deux documents ont maintenant la même empreinte, 61d4344ea4a2. Cela arrive dans la réalité. Une personne téléverse le même fichier sous un nouveau nom, ou le navigateur répète un téléversement après une connexion lente. Chaque copie a ses propres passages, et les deux copies se disputent les cinq places d’une recherche :
python -m scripts.ask "How long do special orders take to arrive?" --tenant bramblePassages found: 7035d9d70022 faq-copy v4, 57b00765f51c special-orders v2, 311c86d6f6b4 special-orders v2, 7c37a489a316 special-orders v2Seulement quatre passages. La recherche a trouvé les deux copies de la réponse de la FAQ. L’étape de contexte (context.py) en a retiré une comme quasi-doublon. La copie a donc coûté au modèle un passage servant de preuve. Pire encore, une personne qui supprime « la FAQ » supprime une seule copie, et l’assistant continue de répondre avec l’autre.
La deuxième défaillance concerne le fournisseur du modèle. Dans le module 3, le fournisseur réel fait un seul appel, avec un délai d’expiration. Un fournisseur occupé pendant une seconde renvoie une erreur à l’utilisateur, même si une deuxième tentative fonctionnerait. Les réponses enregistrées n’échouent jamais, donc vous ne voyez jamais cela sur votre ordinateur.
Le module doit gérer quatre défaillances : le mauvais locataire, une source manquante, un fichier invalide et un délai d’expiration du fournisseur. Vous avez géré la première dans la dernière leçon. Cette leçon ajoute les autres, ainsi qu’un script qui exécute réellement les quatre cas.

Description textuelle du diagramme
Le schéma a deux colonnes. La colonne de gauche représente une question : Ines pose une question chez Bramble Books. Elle passe cinq étapes jusqu’à une réponse stockée avec citations, 200. Les sorties se trouvent à droite des étapes. Sans jeton ni témoin, 401 unauthenticated (non authentifié), « Se connecter d’abord. ». Pour un non-membre ou un magasin inexistant, 404 not_found (introuvable), « Introuvable. ». Si aucun passage ne répond, un 200 avec abstention : « Les documents ne disent pas si nous vendons des livres numériques. ». Si le modèle ne répond pas à temps, 504 provider_timeout (délai d’expiration du fournisseur) : « Le modèle n’a pas répondu à temps. Votre question n’a pas été enregistrée; réessayez. ». Cela arrive après 3 appels en environ 9 secondes, avec un délai d’expiration de 2 secondes. La colonne de droite représente un téléversement par Grace. Un membre avec accès en lecture seule, comme Omar, sort à la vérification du rôle avec 403 forbidden (interdit). Un fichier de plus de 5 000 000 octets sort avec 413, un fichier Word avec 415. Le même fichier téléversé à nouveau renvoie le document existant, 200, "duplicate": true. Un fichier accepté, mais impossible à analyser, termine avec l’état failed (échec) et une raison : « Ce fichier n’est pas un PDF lisible (PdfStreamError). ». Le PDF tronqué, le fichier Word, le gros fichier et le fournisseur lent sont construits pour le test.
Refuser un mauvais fichier au comptoir
Section intitulée « Refuser un mauvais fichier au comptoir »Certains problèmes sont visibles dans la requête elle-même. L’API les refuse donc avant de stocker quoi que ce soit. create_document() dans ingest.py les vérifie dans cet ordre, du moins coûteux au plus coûteux :
- un fichier vide : 422
empty_file(fichier vide); - la taille : 413
file_too_large(fichier trop gros); - le type, selon le nom du fichier : 415
unsupported_file(fichier non pris en charge); - les métadonnées : 422
validation_error(erreur de validation), avec le champ et le problème.
Chaque réponse utilise le format d’erreur unique du projet : code pour les programmes, message pour les personnes et request_id pour trouver la ligne du journal.
D’autres problèmes apparaissent seulement quand le processus ouvre le fichier. Un PDF tronqué pendant le téléversement semble correct de l’extérieur. L’API l’accepte avec 202, puis le processus tente de l’analyser. Une erreur d’analyse est définitive, donc le processus ne réessaie pas. Le document passe à failed, avec une raison qui permet à une personne d’agir. Toute autre erreur, par exemple une connexion perdue à la base de données, ramène le document à uploaded (téléversé). Il y a au plus 3 tentatives en tout. Un processus qui plante laisse un bail derrière lui; à son expiration, un autre processus prend la tâche.
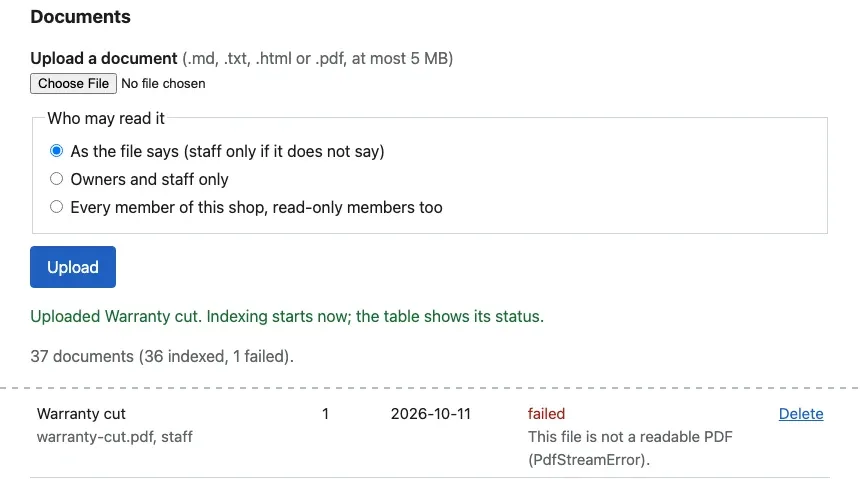
Pourquoi accepter un fichier qui échoue une seconde plus tard? L’analyse d’un gros PDF peut prendre plusieurs secondes, et la requête ne devrait pas attendre. La ligne en échec conserve sa raison jusqu’à ce que quelqu’un la supprime.
Stocker le même fichier une seule fois
Section intitulée « Stocker le même fichier une seule fois »Comment savoir si deux fichiers sont identiques? Vous comparez une empreinte : le hachage SHA-256 des octets. Les mêmes octets donnent toujours les mêmes 64 caractères. Un seul caractère modifié donne une empreinte complètement différente. Essayez avec la FAQ de Bramble et une copie où un mot a changé. Copiez data/bramble/documents/faq.md vers faq-2.md dans le dossier du projet. Dans la copie, remplacez « 5 business days » (5 jours ouvrables) par « 6 business days » (6 jours ouvrables) :
shasum -a 256 data/bramble/documents/faq.md faq-2.md61d4344ea4a2db573f8ce15d43908fe004cd2564dfba0eeca72294e1ad8be9ea data/bramble/documents/faq.md9687554465bf65b818eea6da20c079823bbfa0eed39cf8fa3480482cbf819d54 faq-2.mdSur Linux, la commande est sha256sum; dans PowerShell, Get-FileHash faq-2.md. L’API stocke ce hachage avec chaque document. Avant d’en insérer un nouveau, elle cherche un document du même magasin avec le même hachage. Si elle en trouve un, elle renvoie ce document avec 200 et "duplicate": true, sans rien stocker. C’est une ingestion sans doublons : un téléversement répété donne le même résultat qu’un seul téléversement. Le nom général de cette propriété est idempotente.
Essayez trois téléversements avec le jeton d’Ines, créé comme dans Des jetons pour les scripts et curl. D’abord, la FAQ à nouveau. Puis une copie exacte sous un autre nom et une autre clé, comme dans le problème du module 3. Enfin, la même copie avec une ligne ajoutée :
INES=$(python -m idp token usr-ines)U=http://127.0.0.1:8000/v1/tenants/bramble/documentscurl -s -F file=@data/bramble/documents/faq.md $U -H "Authorization: Bearer $INES"cp data/bramble/documents/faq.md faq-copy.mdcurl -s -F file=@faq-copy.md -F doc_key=faq-copy $U -H "Authorization: Bearer $INES"printf '\n## New\n\nA change.\n' >> faq-copy.mdcurl -s -F file=@faq-copy.md $U -H "Authorization: Bearer $INES"Les trois réponses, avec leurs codes d’état :
faq.md again: 200 {"document":{"document_id":"a8162929-…","doc_key":"faq","version":"4", … "status":"indexed", …}, "duplicate": true}the same bytes as faq-copy: 200 {"document":{"document_id":"a8162929-…","doc_key":"faq","version":"4", … "status":"indexed", …}, "duplicate": true}one line added, version 4: 409 {"code":"conflict","message":"Version 4 of faq already exists. Upload it with a new version number, or delete the old one first.", …}La deuxième ligne montre le problème du module 3, corrigé : la copie sous un nouveau nom renvoie le document existant et son identifiant. La troisième ligne est un fichier différent qui revendique une version existante. C’est donc un vrai conflit, et le message indique quoi faire. Deux magasins peuvent téléverser le même fichier : chacun obtient sa propre copie, car la vérification et la contrainte incluent tenant_id.
Une lacune reste. Deux téléversements simultanés du même fichier peuvent chercher, ne rien trouver et insérer tous les deux. La migration 003_duplicate_safe_ingestion.sql ajoute donc un deuxième verrou dans la base de données :
ALTER TABLE documents ADD CONSTRAINT documents_same_file_once UNIQUE (tenant_id, sha256);La deuxième insertion échoue alors avec une UniqueViolation, et create_document() renvoie plutôt le premier document. Le test test_the_same_file_twice_is_one_document vérifie le cas normal. La commande python -m scripts.load_pack utilise la même fonction, donc charger deux fois est sûr :
larkfield: 0 documents uploaded, 36 already therebramble: 0 documents uploaded, 15 already thereCesser d’attendre : délais d’expiration et nouvelles tentatives limitées
Section intitulée « Cesser d’attendre : délais d’expiration et nouvelles tentatives limitées »Revenons à l’appel téléphonique. Un délai d’expiration est le temps maximal d’attente pour une réponse. Une nouvelle tentative est un essai de plus après un échec. Limité signifie qu’il y a un maximum fixe, donc l’attente totale a aussi une limite. Entre les tentatives, l’attente augmente (délai d’attente croissant), avec un peu de hasard (gigue). Ainsi, plusieurs clients ne rappellent pas tous à la même seconde.
Le fournisseur réel dans providers.py suit ces règles :
for attempt in range(1, self.retries + 2): try: ... # one call, with the timeout except ProviderError as e: if e.kind not in ("timeout", "rate_limited", "unavailable") or attempt > self.retries: raise wait = min(e.retry_after or 2 ** (attempt - 1), 10) * random.uniform(0.8, 1.2) self.sleep(wait)Seuls trois types d’erreurs entraînent une nouvelle tentative : un délai d’expiration, HTTP 429 (occupé) et un 5xx (échec du fournisseur). Un 400 n’est jamais retenté, car la même requête échouerait de la même façon. Les nouvelles tentatives du client OpenAI sont désactivées (max_retries=0). Cette boucle est donc la seule, et sa limite est la limite réelle.
Un petit exemple avec tous les nombres
Section intitulée « Un petit exemple avec tous les nombres »Prenez les réglages du script de défaillance : un délai d’expiration de 2 secondes et 2 nouvelles tentatives. Le fournisseur d’exercice ne répond jamais à temps. Prédisez le temps total avant de continuer la lecture.
- Appel 1 : attend 2 secondes, puis le délai expire.
- Attente d’environ 1 seconde (2⁰ = 1, multiplié par 0,8 à 1,2).
- Appel 2 : attend 2 secondes, puis le délai expire.
- Attente d’environ 2 secondes (2¹ = 2, multiplié par 0,8 à 1,2).
- Appel 3 : attend 2 secondes, puis le délai expire. Il ne reste aucune nouvelle tentative, donc l’API répond 504.
Cela donne 2 + 1 + 2 + 2 + 2 = 9 secondes, à la gigue près. L’équipe du cours a mesuré trois exécutions : 10,6 secondes, 9,1 secondes et 8,7 secondes. La première inclut environ une seconde pour démarrer le client HTTP.

Description textuelle du diagramme
La chronologie va de 0 à 10 secondes. Dans la ligne de l’API, l’appel 1 dure de 0 à 2 secondes et ne reçoit aucune réponse. Une attente de 1,1 seconde suit. L’appel 2 dure de 3,1 à 5,1 secondes, puis vient une attente de 2,0 secondes. L’appel 3 dure de 7,1 à 9,1 secondes. À 9,1 secondes, l’API abandonne et répond 504. Dans la ligne du fournisseur d’exercice, chaque appel attend encore quand l’API raccroche. Le fournisseur ne répond qu’après 30 secondes.
Que reçoit l’utilisateur? Le pipeline transforme chaque erreur définitive du fournisseur en une réponse claire. Un délai d’expiration donne 504 provider_timeout : « Le modèle n’a pas répondu à temps. Votre question n’a pas été enregistrée; réessayez. » Un fournisseur occupé donne 503 provider_busy (fournisseur occupé) avec Retry-After: 30. « Pas enregistrée » est vrai : la réponse est stockée seulement à la fin du pipeline. Une question en échec ne laisse donc rien d’inachevé. C’est le critère B7 de Grace.
Mais pourquoi ne pas attendre plus longtemps, pour être sûr? Parce que l’attente se multiplie. Avec les valeurs par défaut de .env (PROVIDER_TIMEOUT_S=20, PROVIDER_RETRIES=2), le pire cas est 3 × 20 secondes plus les attentes : environ 63 secondes. Dans l’évaluation du cours, un appel au modèle réel prenait environ 1,3 seconde à la médiane. Un client au téléphone n’attendra pas une minute. Un délai d’expiration plus court coupe des réponses lentes, mais bonnes. Plus de nouvelles tentatives allongent le pire cas. Notez votre choix et son pire cas dans votre revue des menaces.
Exécuter les quatre cas de défaillance
Section intitulée « Exécuter les quatre cas de défaillance »Le script scripts/failure_cases.py exécute réellement les quatre cas, avec votre base de données et des jetons d’exercice. Il lance l’API dans son propre processus, donc aucun serveur n’a besoin de fonctionner. Il annule ses modifications à la fin : la politique supprimée est téléversée et indexée à nouveau, les mauvais téléversements sont supprimés.
python -m scripts.failure_casesLes premières lignes montrent le chargement du modèle de plongement (embedding) (Loading weights: …, chargement des poids). Le résumé suit :
wrong shop: Ines asks at Larkfield -> 404 in 0.04 s: {"code": "not_found", "message": "Not found."}wrong shop: a shop that does not exist -> 404 in 0.0 s: {"code": "not_found", "message": "Not found."}missing source: no document answers -> 200 in 3.2 s: {"answerable": false, "answer": "The documents do not say whether we sell e-books.", "provider": "recorded"}missing source: delete the gift card policy -> 200 in 0.01 s: {}missing source: ask about gift cards again -> 200 in 0.02 s: {"answerable": false, "answer": "The documents do not say how long a gift card is valid.", "provider": "recorded"}invalid file: a PDF cut during the upload (accepted, then indexed) -> uploaded in 0.04 s: {}invalid file: its status after indexing -> failed in 0.0 s: {"error": "This file is not a readable PDF (PdfStreamError)."}invalid file: a Word file -> 415 in 0.0 s: {"code": "unsupported_file", "message": "Upload a .md, .txt, .html or .pdf file."}invalid file: 6 MB -> 413 in 0.01 s: {"code": "file_too_large", "message": "The file is 5,000,001 bytes; the limit is 5,000,000 bytes."}provider timeout: 2 s timeout, 2 retries -> 504 in 8.9 s: {"code": "provider_timeout", "message": "The model did not answer in time. Your question was not saved; try again.", "provider_calls": 3}Vos temps diffèrent; la première question charge le modèle de plongement. Lisez attentivement la ligne 413. L’API lit en mémoire au plus un octet de plus que la limite. Elle signale donc un fichier de 6 Mo comme ayant 5 000 001 octets. Le cas de la source manquante est le sujet de la prochaine leçon. Le PDF tronqué, le fichier Word, le gros fichier et le fournisseur lent sont construits pour le test.
Le fournisseur lent, manuellement
Section intitulée « Le fournisseur lent, manuellement »Le script masque les différents éléments. Exécutez donc une fois le cas du délai d’expiration manuellement. Le fournisseur d’identité d’exercice continue de fonctionner dans le premier terminal. Arrêtez l’API de la dernière leçon.
-
Dans le deuxième terminal, démarrez le fournisseur de modèle d’exercice en mode
slow(lent). Il répond à chaque requête après 30 secondes :Fenêtre de terminal python -m scripts.fake_provider --mode slowFake provider (slow) on http://127.0.0.1:8401/v1. Ctrl+C stops it. -
Dans le troisième terminal, démarrez l’API avec le fournisseur réel dirigé vers lui et un délai d’expiration de 2 secondes :
Fenêtre de terminal ANSWER_PROVIDER=live LLM_BASE_URL=http://127.0.0.1:8401/v1 PROVIDER_TIMEOUT_S=2 fastapi run doc_assistant/main.pyFenêtre de terminal $env:ANSWER_PROVIDER="live"; $env:LLM_BASE_URL="http://127.0.0.1:8401/v1"; $env:PROVIDER_TIMEOUT_S="2"fastapi run doc_assistant/main.py -
Dans un quatrième terminal, créez un jeton pour Ines et posez une question :
Fenêtre de terminal INES=$(python -m idp token usr-ines)curl -s -w '\n%{http_code} in %{time_total} s\n' -X POST http://127.0.0.1:8000/v1/tenants/bramble/answers \-H "Authorization: Bearer $INES" -H 'content-type: application/json' \-d '{"question": "How long does delivery to Ontario take?"}'{"code":"provider_timeout","message":"The model did not answer in time. Your question was not saved; try again.","request_id":"7e46c0b6e5344e72"}504 in 9.200686 sLa première requête après un démarrage a pris 12,5 secondes, car elle charge aussi le modèle de plongement.
-
Arrêtez le faux fournisseur et redémarrez-le avec
--mode busy. Il répond à chaque appel avec 429 etRetry-After: 1. Posez à nouveau la question aveccurl -ipour voir les en-têtes :HTTP/1.1 503 Service Unavailableretry-after: 30...{"code":"provider_busy","message":"The model provider is busy. Try again in a minute.","request_id":"2563d8e1a9c147de"}Cela a pris 5,5 secondes : trois appels, avec des attentes d’environ 1 seconde, comme le demandait le fournisseur.
-
Arrêtez l’API et le faux fournisseur avec Ctrl+C. Redémarrez l’API sans les trois réglages pour retrouver les réponses enregistrées.
Sur Windows, les trois réglages $env: restent dans ce terminal. Fermez-le ou retirez-les avec Remove-Item Env:ANSWER_PROVIDER, Env:LLM_BASE_URL, Env:PROVIDER_TIMEOUT_S.
Quand l’utiliser et à quel coût
Section intitulée « Quand l’utiliser et à quel coût »Fixez toujours un délai maximal pour chaque appel à un service que vous ne contrôlez pas. Ajoutez des nouvelles tentatives seulement pour les erreurs temporaires : un délai dépassé, un code 429 ou un code 5xx. Limitez leur nombre. Chaque nouvelle tentative multiplie l’attente maximale et augmente la charge d’un fournisseur déjà en difficulté. Avec un modèle payant, une nouvelle tentative après un délai dépassé peut aussi doubler le coût. Le fournisseur peut avoir effectué le travail et l’avoir facturé, même si la réponse est arrivée trop tard.
Faites les vérifications peu coûteuses à l’entrée, et les vérifications coûteuses dans la tâche. Les empreintes coûtent un calcul de hachage par téléversement, quelques millisecondes même pour 5 Mo, et un index. Elles ne détectent pas deux fichiers qui diffèrent d’une seule espace. Il faudrait comparer le texte, ce que ce projet ne fait pas.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
La migration refuse votre base de données
Symptôme : vous avez copié la fin du module 4 dans un projet que vous avez utilisé au module 3. python -m doc_assistant.migrate s’arrête après la première nouvelle migration :
psycopg.errors.UniqueViolation: could not create unique index "documents_same_file_once"DETAIL: Key (tenant_id, sha256)=(bramble, 61d4344ea4a2db573f8ce15d43908fe004cd2564dfba0eeca72294e1ad8be9ea) is duplicated.applied 002_row_level_security--status affiche ensuite 002_row_level_security applied (appliquée) et 003_duplicate_safe_ingestion pending (en attente). python -m scripts.load_pack --reset échoue avec la même erreur, car cette commande applique d’abord les migrations.
Cause : au module 3, vous avez téléversé le même fichier deux fois sous deux noms, comme dans le problème ci-dessus. La migration 003 ne peut pas garantir « un document par fichier » quand il en existe deux.
Diagnostic : affichez les copies dans psql :
SELECT doc_key, version, left(sha256, 12) AS sha256 FROM documents WHERE tenant_id = 'bramble' AND sha256 IN (SELECT sha256 FROM documents WHERE tenant_id = 'bramble' GROUP BY sha256 HAVING count(*) > 1); doc_key | version | sha256----------+---------+-------------- faq | 4 | 61d4344ea4a2 faq-copy | 4 | 61d4344ea4a2Solution : supprimez la copie en trop. Son fichier et ses passages sont supprimés avec elle (ON DELETE CASCADE, suppression en cascade). Relancez ensuite la migration :
DELETE FROM documents WHERE tenant_id = 'bramble' AND doc_key = 'faq-copy';applied 003_duplicate_safe_ingestion1 migration(s) applied.Avec des données d’exercice seulement, vous pouvez aussi repartir d’une base de données vide : docker compose down --volumes, docker compose up -d --wait db, python -m doc_assistant.migrate, puis python -m scripts.load_pack.
Erreur courante
Toutes les questions échouent avec 503 provider_unavailable
Symptôme : après une exécution manuelle, chaque question renvoie 503 provider_unavailable (fournisseur indisponible), « Le fournisseur du modèle est indisponible. Réessayez plus tard. ».
Cause : l’API utilise encore ANSWER_PROVIDER=live et pointe vers le fournisseur d’exercice, que vous avez arrêté. Une connexion refusée signifie « indisponible ». L’API essaie donc 3 fois, puis abandonne.
Solution : démarrez l’API dans un terminal sans les paramètres de l’exécution manuelle. curl -s http://127.0.0.1:8000/ready affiche "answer_provider":"recorded" (fournisseur de réponses enregistrées) quand la configuration est correcte.
Votre projet
Section intitulée « Votre projet »Dans le parcours avec votre propre idée, vous créez votre adaptateur de fournisseur, votre analyseur et votre route de téléversement. Copiez les règles, pas le code. Fixez un délai maximal pour chaque appel externe. Réessayez seulement les erreurs temporaires, un nombre fixe de fois. Conservez une empreinte par boutique avec une contrainte d’unicité, et un seul format d’erreur. Créez ensuite votre propre version de failure_cases.py avec vos données.
Conservez ces preuves :
- La sortie de
python -m scripts.failure_cases(ou de votre version) : les quatre cas, avec le statut de chacun. - Votre attente maximale, calculée à partir du délai maximal et des nouvelles tentatives, dans la revue des menaces.
- Les tests des fichiers refusés, des doublons et du fournisseur lent :
python -m pytest tests/test_failures.py -v.
Liste de vérification
- Un fichier vide, trop volumineux ou non pris en charge est refusé avant tout stockage, avec son propre code.
- Un fichier impossible à analyser prend le statut
failed(échec), avec une raison qui permet à une personne d’agir. - Le même fichier téléversé deux fois par une boutique donne un seul document; le second téléversement indique
duplicate(doublon). - Chaque appel au modèle a un délai maximal; seuls les délais dépassés, 429 et 5xx sont réessayés, un nombre fixe de fois.
- Une question qui échoue ne stocke rien, et le message l’indique.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Avec PROVIDER_TIMEOUT_S=5 et PROVIDER_RETRIES=1, le fournisseur ne répond jamais. Prédisez combien de temps l'utilisateur attend et ce qu'il voit.
Afficher la réponse
Deux appels de 5 secondes chacun, avec une attente entre les deux. L’attente dure environ 1 seconde (2⁰ = 1, multiplié par 0,8 à 1,2). Le total est d’environ 5 + 1 + 5 = 11 secondes. L’API répond ensuite 504 provider_timeout (délai du fournisseur dépassé), avec « Le modèle n’a pas répondu à temps. Votre question n’a pas été enregistrée; réessayez. ». Rien n’est stocké.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Expliquez pourquoi un PDF tronqué reçoit 202, puis le statut failed, alors qu'un fichier Word reçoit immédiatement 415.
Afficher la réponse
Le fichier Word est refusé d’après son nom. L’analyseur ne lit pas les fichiers .docx, et la requête contient déjà le nom. L’API le refuse donc avant de stocker quoi que ce soit. Le PDF tronqué a un nom et une taille valides; la requête ne présente donc aucun problème. Seul l’analyseur détecte le problème, dans le processus, après l’acceptation du téléversement. Une nouvelle tentative échouerait de la même façon. Le processus attribue donc immédiatement le statut failed, avec la raison « Ce fichier n’est pas un PDF lisible (PdfStreamError). ».
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : téléversez data/bramble/documents/gift-cards.md deux fois avec le jeton d'Ines. Que montrent les deux réponses, et combien de documents sur les cartes-cadeaux la liste contient-elle?
Afficher la réponse
Une fois l’ensemble de données chargé, les deux téléversements renvoient 200 avec "duplicate": true (doublon détecté) et l’identifiant de la politique existante sur les cartes-cadeaux. Son empreinte SHA-256 est déjà stockée pour Bramble Books. Dans une boutique vide, le premier téléversement renvoie 202, et le second renvoie 200 avec le même identifiant. Dans les deux cas, la liste contient un seul document gift-cards.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Les entrées invalides sont refusées à l’entrée, en commençant par la vérification la moins coûteuse : 422 pour un fichier vide, 413 pour un fichier trop volumineux, 415 pour un type incorrect, 422 pour des métadonnées invalides. Un fichier dont l’analyse échoue prend le statut
failed, avec une raison. - Une empreinte SHA-256 par boutique et la contrainte d’unicité de la migration 003 empêchent les doublons lors des téléversements. Les mêmes octets renvoient le document existant.
- Chaque appel au modèle a un délai maximal. Seuls un délai dépassé, un code 429 ou un code 5xx déclenchent une nouvelle tentative. Il y en a au plus
PROVIDER_RETRIES, avec des attentes croissantes. Avec un délai maximal de 2 secondes et 2 nouvelles tentatives, l’utilisateur reçoit un code 504 après environ 9 secondes et 3 appels, et rien n’est stocké. python -m scripts.failure_casesexécute réellement les quatre cas de ce module : mauvaise boutique, source manquante, fichier invalide, délai du fournisseur dépassé.
Ensuite, ce que l’utilisateur voit quand l’assistant ne peut pas répondre, les preuves derrière chaque réponse et la suppression.
Leçon suivante : Révision par l'utilisateur et nettoyage