
Intégrer la récupération
- Leçon 10
- 120 min
- Module 3 : Créer un parcours utilisateur complet
Où nous en sommes
Dans les deux leçons précédentes, nous avons construit la tranche : un backend et une page, avec des substituts pour la recherche et le modèle. La tranche fonctionne, mais ses réponses ne veulent encore rien dire. Dans cette leçon, nous remplaçons les substituts par les vraies parties, une à la fois : recherche par le sens, vraies réponses enregistrées, citations vérifiées dans le code et trace de chaque question. Le vrai acteur arrive.
Leçon 10 sur 22 · Projet intégrateur : créer, évaluer et livrer un produit d'IAIntégrer la récupération
1. Choisir et délimiter le projet
2. Préparer les données et l'architecture
3. Créer un parcours utilisateur complet
4. Ajouter la fiabilité et le contrôle d'accès
5. Évaluer et améliorer
6. Déployer et exploiter
7. Préparer la présentation du portfolio
Ce que vous saurez faire
Remplacez les deux doublures par les vrais éléments : recherche par sens dans PostgreSQL, vraies réponses d’un modèle et citations vérifiées dans le code. Ajoutez une trace de chaque question qui montre où passe le temps.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les plongements (embeddings) et la recherche dense, dans Les plongements pour la recherche, et les vecteurs dans PostgreSQL, dans Stockage des vecteurs.
- Le contexte envoyé au modèle, dans Assembler le contexte.
- Les réponses composées d’affirmations, chacune avec ses passages, et les vérifications possibles dans le code, dans Répondre et citer.
- La tranche fonctionnelle et sa page, dans Fondations du backend et Fondations du frontend.
Ce qu’il vous faut sur votre ordinateur
- Votre projet de la dernière leçon, avec l’ensemble chargé par les doublures. Arrêtez l’API pour l’instant (Ctrl+C dans son terminal).
- Une connexion Internet pour la première exécution : le modèle de plongement, d’environ 470 Mo, se télécharge une fois dans
~/.cache/huggingface. - Aucun compte ni aucune clé. Les réponses de cette leçon sont des réponses enregistrées d’un vrai modèle.
Le vrai acteur arrive
Section intitulée « Le vrai acteur arrive »À la fin des répétitions, le vrai acteur remplace la doublure. Les marques au sol restent les mêmes, tout comme les caméras. Mais certaines choses changent : l’acteur est un peu plus grand, donc les lumières montent. L’équipe change une chose à la fois et vérifie la scène après chaque changement.
Le projet intégrateur fait de même. Les interfaces restent : embed_queries et complete. Les données derrière elles changent, et vous vérifiez la tranche fonctionnelle après chacun des deux changements.
Changement 1 : le vrai modèle de plongement
Section intitulée « Changement 1 : le vrai modèle de plongement »Dans .env, remplacez la doublure par hachage par le modèle du cours RAG, intfloat/multilingual-e5-small. Gardez la simulation pour les réponses, afin de ne changer qu’une chose.
EMBEDDER=e5ANSWER_PROVIDER=mockPosez la question sur l’Ontario dans le terminal. scripts.ask appelle le même pipeline que l’API, dans un seul processus :
python -m scripts.ask "How long does delivery to Ontario take?" --tenant brambleInes (staff) at Bramble Books asks: How long does delivery to Ontario take?Passages found: noneAnswer (not answerable): The documents do not answer this question.none none | 28605 ms | tokens 0 in, 0 out | US$0.000000 | trace f6a04f8c45466eda7b5b6524b0b32b90Les lignes de chargement du modèle sont omises ici et plus bas. Aucun passage, donc le modèle de réponse n’est pas appelé. La réponse est « Les documents ne répondent pas à cette question. » Rien n’est défectueux. Les documents ont été indexés avec hash-384, et on ne peut pas comparer les vecteurs de deux modèles. La recherche lit donc uniquement les segments du modèle actuel, et il n’y en a aucun. Indexez de nouveau avec le vrai modèle :
python -m scripts.load_pack --resetDeleted every shop's data.Identity: 2 shops, 7 people, 6 membershipslarkfield: 36 documents uploaded, 0 already therebramble: 15 documents uploaded, 0 already thereIndexing with intfloat/multilingual-e5-small@614241f ...
Indexed 51 documents in 6.2 s (failed 0). bramble: 15 documents, 60 passages, 0 failed larkfield: 36 documents, 185 passages, 0 failedLa première exécution télécharge le modèle; les suivantes utilisent la copie dans le cache. Le temps varie d’une exécution à l’autre : 7,1 s lors de l’exécution suivante du cours. Il était d’environ 30 secondes dans un environnement neuf lors de la vérification de l’instantané du cours. La même question trouve maintenant des passages. La recherche dans doc_assistant/retrieve.py est la recherche dense du cours RAG, écrite en une seule requête SQL. Elle applique quatre filtres avant de prendre les 5 meilleurs résultats : boutique, niveau d’accès du lecteur, date de la question et modèle de plongement. Un passage éliminé par un filtre ne peut jamais occuper l’une des cinq places. Posez de nouveau la question sur l’Ontario, avec la simulation encore activée :
Ines (staff) at Bramble Books asks: How long does delivery to Ontario take?Passages found: 20804b124392 delivery-policy v1, ffefe0c5ab86 delivery-policy v1, e5e28bf8b6a1 faq v4, 94a83a5b1bff delivery-policy v1, ba8746ede8c3 privacy-notice v2Answer (answerable): We ship within 2 business days. - We ship within 2 business days. [Delivery times, Shipping, v1]mock mock | 3822 ms | tokens 0 in, 0 out | US$0.000000 | trace b9b1f3c01c9332cf9e89a051938c3a27La simulation répond encore avec la première phrase du meilleur passage. Mais le meilleur passage est maintenant la section « Shipping » (livraison) de la politique de livraison. La recherche l’a trouvé par son sens, et non par des mots communs. Notez le temps : 3 822 ms. Chaque scripts.ask est un nouveau processus, donc chacun recharge le modèle de plongement. Gardez ce nombre en tête pour les traces ci-dessous.
Changement 2 : de vraies réponses, enregistrées
Section intitulée « Changement 2 : de vraies réponses, enregistrées »Remplacez maintenant la simulation par de vraies réponses :
ANSWER_PROVIDER=recordedL’équipe du cours a posé les questions du cours à un vrai modèle, chat-small. Elle a enregistré chaque requête et sa réponse dans recordings/answers.jsonl. Le fournisseur recorded (enregistré) les rejoue : aucune clé, aucun coût et la même réponse chaque fois. On retrouve un enregistrement par le modèle, la requête, la question et sa date, et non par les passages. L’idée vient de la relecture du cours RAG.
python -m scripts.ask "How long does delivery to Ontario take?" --tenant brambleInes (staff) at Bramble Books asks: How long does delivery to Ontario take?Passages found: 20804b124392 delivery-policy v1, ffefe0c5ab86 delivery-policy v1, e5e28bf8b6a1 faq v4, 94a83a5b1bff delivery-policy v1, ba8746ede8c3 privacy-notice v2Answer (answerable): Delivery to Ontario takes 4 to 8 days. Orders ship within 2 business days. - Delivery to Ontario takes 4 to 8 days. [Delivery times, Shipping, v1] - Orders ship within 2 business days. [Delivery times, Shipping, v1]recorded chat-small | 3932 ms | tokens 719 in, 137 out | US$0.000140 | trace 171024ffa6e415fc217bdea1792456dbUne réponse d’un vrai modèle, avec deux affirmations, chacune accompagnée d’une citation. La dernière ligne montre la relecture et le coût du vrai appel : 719 jetons en entrée et 137 en sortie. Le coût est de 0,000140 $ US selon les tarifs de chat-small (0,10 $ US et 0,50 $ US par million de jetons). La requête (prompt) est prompts/answer_v1.md. Elle demande des affirmations avec des identifiants de passages, dans un schéma JSON strict, pour que le code puisse les vérifier.
Les enregistrements existent pour les 62 questions de réglage du cours avec leurs dates, et pour rien d’autre. Posez une autre question, et la simulation répond, avec une note :
Ines (staff) at Bramble Books asks: Do we sell e-books?Passages found: 07e2059161e9 faq v4, 31d85d1940b3 faq v4, fafc42e3e194 special-orders v2, 5220ca4b5665 events-and-room-hire v1, 1e6a23c78c8f supplier-terms v1Answer (answerable): Can I pick up my online order? - Can I pick up my online order? [Frequently asked questions, Can I pick up my online order?, v4]Note: No recording for this question: the mock made this answer from your passages.mock mock | 3722 ms | tokens 0 in, 0 out | US$0.000000 | trace c40331669e8e4c26691b1e1cf0757815La date fait partie de la question. Les questions de Larkfield ont été enregistrées avec la date du 9 octobre 2026. La date « d’aujourd’hui » du cours est le 11 octobre 2026 (ASSISTANT_TODAY). Les mêmes mots avec une autre date constituent une autre question :
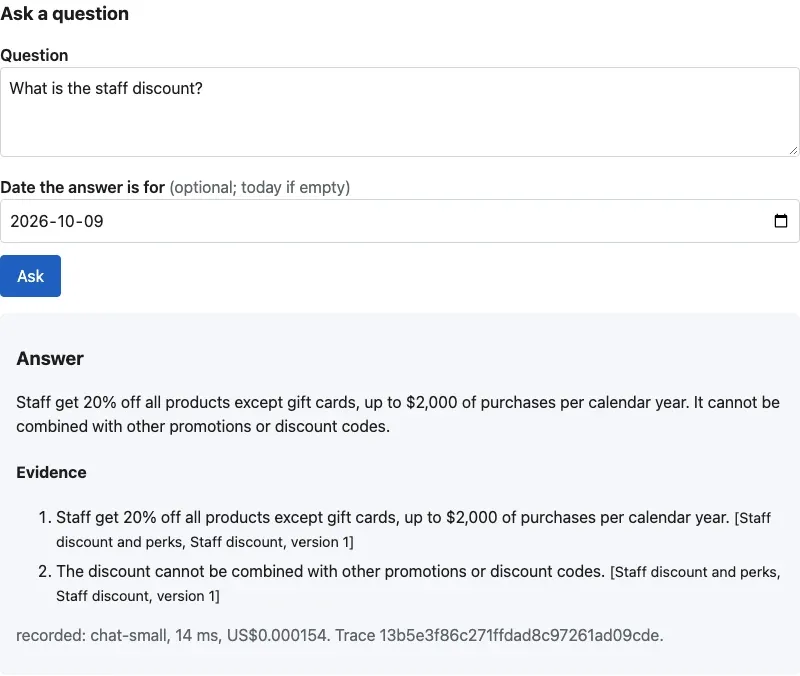
$ python -m scripts.ask "What is the staff discount?" --tenant larkfieldSam (staff) at Larkfield asks: What is the staff discount?Passages found: 81007010cd4d staff-discount-and-perks v1, 7919a06cc2aa staff-discount-and-perks v1, 93cb6359874a privacy-policy v3, 6fddb68adafa privacy-policy v3, 2638b732560d support-team-routing v4Answer (answerable): You get 20% off all products, except gift cards. - You get 20% off all products, except gift cards. [Staff discount and perks, Staff discount, v1]Note: No recording for this question: the mock made this answer from your passages.mock mock | 3791 ms | tokens 0 in, 0 out | US$0.000000 | trace 5c7e8e285f6de1af99ee1b84550d32a1$ python -m scripts.ask "What is the staff discount?" --tenant larkfield --as-of 2026-10-09Sam (staff) at Larkfield asks: What is the staff discount?Passages found: 81007010cd4d staff-discount-and-perks v1, 7919a06cc2aa staff-discount-and-perks v1, 93cb6359874a privacy-policy v3, 6fddb68adafa privacy-policy v3, 2638b732560d support-team-routing v4Answer (answerable): Staff get 20% off all products except gift cards, up to $2,000 of purchases per calendar year. It cannot be combined with other promotions or discount codes. - Staff get 20% off all products except gift cards, up to $2,000 of purchases per calendar year. [Staff discount and perks, Staff discount, v1] - The discount cannot be combined with other promotions or discount codes. [Staff discount and perks, Staff discount, v1]recorded chat-small | 3698 ms | tokens 958 in, 117 out | US$0.000154 | trace ddf0a76bf81ef75caf7388d2bd65deb1Une règle de sécurité pour la relecture
Section intitulée « Une règle de sécurité pour la relecture »Un enregistrement ne dépend pas des passages. Le fournisseur pourrait donc rejouer une réponse tirée de passages réservés au personnel pour quelqu’un qui ne peut pas les lire. Par exemple, Omar, un membre avec accès en lecture seule du module 4. Le fournisseur d’enregistrements a une règle pour l’empêcher : il rejoue un enregistrement uniquement si chaque passage cité figure parmi vos passages. Si un passage manque, la simulation répond à sa place, et la note explique pourquoi. Dans ce module, tout le monde agit comme Sam. Vous verrez donc la règle en action au module 4.
Votre propre modèle, si vous en voulez un
Section intitulée « Votre propre modèle, si vous en voulez un »ANSWER_PROVIDER=live appelle tout point de terminaison au format OpenAI Chat Completions, avec LLM_BASE_URL et LLM_API_KEY de .env. Les paramètres n’affichent jamais la clé. Chaque appel a un délai maximal (PROVIDER_TIMEOUT_S, 20 secondes). Une défaillance revient dans le format d’erreur unique, par exemple 504 provider_timeout. Cette leçon n’a pas exécuté live : les réponses enregistrées sont de vrais appels au même modèle. Les prix changent : vérifiez d’abord la page des tarifs actuels de votre fournisseur.
Les citations, vérifiées dans le code
Section intitulée « Les citations, vérifiées dans le code »Vous vérifiez les notes de bas de page d’un étudiant. La page citée existe-t-elle? Le livre figurait-il dans la liste de lecture? La page donne-t-elle le nombre de la phrase? Vous ne pouvez pas vérifier si l’étudiant a compris le livre, mais vous pouvez vérifier ces éléments en quelques secondes.
doc_assistant/cite.py fait de même pour chaque affirmation, comme dans Répondre et citer. Il vérifie cinq choses. Chaque identifiant cité correspond à un passage de cette boutique. Le modèle a reçu ce passage. L’affirmation cite quelque chose. Chaque nombre de l’affirmation figure dans un passage cité. Au moins la moitié de ses mots y figurent. Voici un petit exemple. Le passage est réel : la section « Shipping » de Bramble Books. Les quatre affirmations sont inventées pour tester les vérifications :
Passage 20804b124392:[20804b124392] Delivery times | policy, version 1, in force from 2026-09-15, no end date | section: ShippingDelivery timesShipping
We ship within 2 business days. Delivery in British Columbia takes 2 to 4 business days, and 4 to 8 days to the rest of Canada. We do not ship outside Canada.
Delivery to Ontario takes 4 to 8 days.  cites ['20804b124392']  ->  okDelivery to Ontario takes 3 to 5 days.  cites ['20804b124392']  ->  ['number_not_found:3,5']Delivery to Ontario takes 4 to 8 days.  cites nothing  ->  ['no_citation']Delivery to Ontario takes 4 to 8 days.  cites ['c0712b8decbc']  ->  ['missing_id:c0712b8decbc']
Lisez les quatre lignes. La première affirmation est appuyée. La deuxième contient des nombres absents du passage. La troisième ne cite rien. La quatrième cite un vrai passage, mais de la politique de livraison de Larkfield. Dans Bramble Books, cet identifiant n’existe pas. La vérification indique donc missing_id (identifiant manquant), et la page n’affiche rien à son sujet. Ces vérifications sont des indices, pas des preuves : une affirmation peut reprendre les mots du passage et dire le contraire. Une personne tranche ces cas, et le module 5 les mesure.
Où passe le temps : les traces
Section intitulée « Où passe le temps : les traces »Une course à relais compte quatre coureurs. Le temps de l’équipe est de 41 secondes, mais l’entraîneur veut en savoir plus. Quel coureur a été lent, et où le témoin a-t-il changé de main? L’entraîneur prend donc un temps intermédiaire pour chaque coureur.
Voici le problème sans temps intermédiaires : la première question de Sam par l’API a pris 3,6 secondes. Tomás est certain : « Le modèle est lent. Payons pour un modèle plus rapide. » Mais la réponse était une relecture, qui ne prend presque aucun temps. Sans mesure, vous changeriez le mauvais élément.
Une trace est l’enregistrement d’une requête, avec une étendue (span) pour chaque étape : nom, début, durée et quelques faits. Le pipeline crée une trace par question avec OpenTelemetry, l’outil standard pour les traces. Ses étendues sont ask, puis retrieve, generate, check et store à l’intérieur. Dans l’API, FastAPI ajoute ses propres étendues autour : la requête (POST /v1/tenants/{tenant}/answers), puis fastapi.dependencies, fastapi.endpoint et fastapi.serialization. doc_assistant/tracing.py les écrit dans traces/spans.jsonl, un objet JSON par ligne. Vous n’avez donc besoin d’aucun autre service pour les lire. Les étendues ne contiennent jamais la question ni la réponse, seulement des identifiants, des tailles et des temps. Une trace peut être conservée plus longtemps et lue par plus de personnes que les données.
Sam a démarré l’API avec les vrais éléments et posé deux questions chez Bramble Books. D’abord la question sur l’Ontario, puis « La livraison est-elle gratuite pour une commande de 75 dollars? » Après chacune, Sam a lu la trace. La longue liste d’attributs de la première ligne est raccourcie ici :
python -m scripts.trace lastLa première question :
trace 6c811aa755fae25bc492a985eed4c7ac: 3595 msPOST /v1/tenants/{tenant}/answers 0 ms + 3595 ms |########################################| http.route=/v1/tenants/{tenant}/answers, http.response.status_code=200 fastapi.dependencies 3 ms + 2 ms |# | code.function.name=doc_assistant.answers.post_answer fastapi.endpoint 5 ms + 3589 ms |####################################### | code.function.name=doc_assistant.answers.post_answer ask 5 ms + 3589 ms |####################################### | tenant=bramble, question.chars=39, prompt=answer_v1, answerable=True retrieve 5 ms + 3584 ms |####################################### | passages=5 generate 3590 ms + 0 ms | #| provider=recorded, model=chat-small, attempts=1, tokens.input=719, tokens.output=137 check 3590 ms + 2 ms | #| claims=2, claims.flagged=0 store 3592 ms + 2 ms | #| fastapi.serialization 3594 ms + 0 ms | #| code.function.name=doc_assistant.answers.post_answerLa deuxième question, quelques secondes plus tard :
trace 7c3ad66b436e9bce03c290390269e646: 16 msPOST /v1/tenants/{tenant}/answers 0 ms + 16 ms |########################################| http.route=/v1/tenants/{tenant}/answers, http.response.status_code=200 fastapi.dependencies 0 ms + 2 ms |##### | code.function.name=doc_assistant.answers.post_answer fastapi.endpoint 3 ms + 13 ms | ############################### | code.function.name=doc_assistant.answers.post_answer ask 3 ms + 13 ms | ############################### | tenant=bramble, question.chars=39, prompt=answer_v1, answerable=True retrieve 3 ms + 8 ms | ################## | passages=5 generate 12 ms + 0 ms | # | provider=recorded, model=chat-small, attempts=1, tokens.input=723, tokens.output=115 check 12 ms + 2 ms | #### | claims=2, claims.flagged=0 store 13 ms + 2 ms | ##### | fastapi.serialization 16 ms + 0 ms | #| code.function.name=doc_assistant.answers.post_answer
Description textuelle du diagramme
La première question a pris 3 595 ms dans l’API, dont 3 584 ms pour l’étape retrieve. L’API a chargé le modèle de plongement à sa première recherche. Generate a pris 0,1 ms, car la réponse a été rejouée; check a pris 1,5 ms et store 1,7 ms. La deuxième question a pris 16 ms au total. À la même échelle, ses barres sont des lignes minces. Dans la vue agrandie, retrieve prend 7,7 ms, generate 0,1 ms, check 1,6 ms et store 2,2 ms. Les deux appels enregistrés au modèle ont pris 1 463 ms et 1 420 ms quand l’équipe du cours les a faits. Un appel direct ajouterait environ 1,4 seconde à generate.
L’étape lente était donc retrieve : l’API charge le modèle de plongement à la première recherche, pas au démarrage. La réponse contient les deux temps. latency_ms est le temps réel de la question dans l’API : 3 587 et 11 ms. generation_ms est le temps de l’appel enregistré quand l’équipe du cours l’a fait.
Quand utiliser les traces. Pour chaque requête qui comporte plus d’une étape lente, dès le premier jour. Elles coûtent peu : une ligne par étendue dans un fichier. Quand ne pas les utiliser. Ne mettez pas de données personnelles dans une étendue. Ce qu’elles coûtent. Un fichier qui grossit avec chaque question. Supprimez-le, ou envoyez les étendues à un collecteur avec une limite de conservation. Le cours prévu MLOps et LLMOps : exploiter l’IA en production couvre les collecteurs.
Toute la tranche fonctionnelle, avec de vrais nombres
Section intitulée « Toute la tranche fonctionnelle, avec de vrais nombres »
Description textuelle du diagramme
Parcours de téléversement : l’API vérifie le fichier et répond 202 en 12 ms, et la ligne attend à l’état uploaded (téléversé). Le processus l’analyse, le découpe, produit ses plongements avec e5 et l’enregistre à l’état indexed (indexé). L’ensemble complet : 51 documents en 7,1 secondes. Parcours de question : l’API vérifie la question. Retrieve garde les 5 meilleurs résultats après quatre filtres, en 8 ms (3,6 secondes la première fois). Generate rejoue la réponse de chat-small (719 jetons en entrée, 137 en sortie, 0,000140 $ US). Les vérifications des citations prennent 2 ms, et le stockage prend 2 ms. Chaque requête à PostgreSQL nomme la boutique.
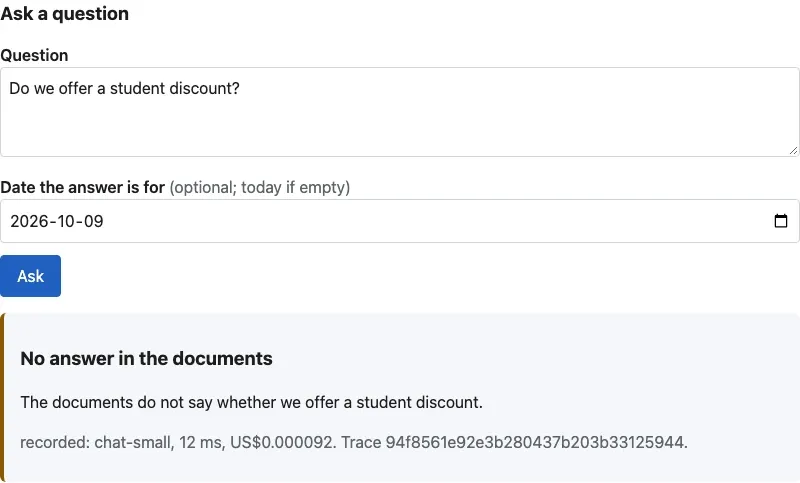
Le parcours de Grace sur la page utilise maintenant les vrais éléments. La question porte la date des enregistrements :
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Chaque réponse indique « No recording for this question » (aucun enregistrement pour cette question)
Symptôme : les réponses sur la page proviennent de la simulation, avec la note « No recording for this question : the mock made this answer from your passages. » (Aucun enregistrement pour cette question : la simulation a produit cette réponse à partir de vos passages.)
Cause : la question, sa date, la requête ou le modèle ne correspond pas exactement à l’enregistrement. Sur la page, un champ de date vide signifie aujourd’hui, le 11 octobre 2026. Les questions de Larkfield ont été enregistrées pour le 9 octobre 2026.
Solution : réglez la date au 9 octobre 2026 pour les questions de Larkfield. Posez les questions exactement comme dans evaluation/dev.jsonl. Pour toute autre question, la simulation est la réponse honnête sans modèle; utilisez live si vous avez votre propre point de terminaison.
Erreur courante
La première question prend plusieurs secondes, mais pas les suivantes
Symptôme : la première réponse après un démarrage prend de 3 à 4 secondes. La trace montre que le temps passe dans retrieve.
Cause : le modèle de plongement se charge à la première recherche. C’est prévu, et la trace le prouve.
Solution : aucune n’est nécessaire pour la tranche fonctionnelle. Si le premier utilisateur ne doit pas attendre, chargez le modèle au démarrage. Faites une requête au modèle de plongement dans le lifespan de l’API. Le coût est un démarrage plus lent. Notez ce choix.
Votre projet
Section intitulée « Votre projet »- Parcours standard. Faites les deux changements, un à la fois, et vérifiez après chacun. Posez trois questions enregistrées sur la page, puis une de votre choix, qui reçoit la simulation avec sa note. Lisez la trace de chacune.
- Parcours avec votre propre idée. Remplacez vos doublures une à la fois. Indexez vos documents avec un vrai modèle de plongement. Vérifiez que la recherche filtre par locataire, accès et date avant de prendre les k meilleurs résultats. Pour les réponses, enregistrez de vraies réponses d’un petit modèle uniquement pour vos questions de réglage, jamais pour vos questions réservées. Ou gardez la simulation jusqu’au module 5, et dites-le.
Preuves à conserver. Dans docs/evidence/m03-retrieval.txt : la sortie de load_pack avec le vrai modèle et une sortie de scripts.ask avec une réponse citée. Ajoutez la trace d’une première et d’une deuxième question, puis la sortie des vérifications des citations sur une mauvaise affirmation construite. Indiquez clairement chaque réponse simulée ou enregistrée.
Liste de vérification
- L’index a été créé avec le même modèle que celui qui y effectue la recherche.
- La recherche filtre par boutique, niveau d’accès et date avant de prendre les k meilleurs résultats.
- Chaque réponse indique quel fournisseur l’a produite : simulation, enregistrement ou appel direct.
- Les citations de chaque affirmation sont vérifiées dans le code, et une citation d’une autre boutique donne
missing_id. - Chaque question a une trace, sans texte de question ni réponse.
Exercices du module 3
Section intitulée « Exercices du module 3 »Exercice guidé : un petit flux, de bout en bout
Section intitulée « Exercice guidé : un petit flux, de bout en bout »Sam réalise un petit flux, du téléversement à la trace, avant d’ajouter quoi que ce soit. load_pack --reset a supprimé les données de toutes les boutiques, y compris les heures des fêtes. Sam téléverse donc holiday-hours.md à nouveau, cette fois avec les vrais composants, et pose la question de Grace.
- Redémarrez l’API dans son terminal (
fastapi dev doc_assistant/main.py), pour qu’elle lise le nouveau.env. Téléversezholiday-hours.mddans Larkfield, sur la page ou avec la commandecurlde Fondations du backend. - Surveillez son état : il passe de
uploaded(téléversé) àindexed(indexé), avec son nombre de passages. - Posez la question « Le service d’aide est-il ouvert le 26 décembre? ».
- Exécutez
python -m scripts.trace lastet vérifiez que l’identifiant de sa trace correspond à celui sous la réponse.
Afficher ce que Sam a vu
L’exécution du cours, avec curl pour le téléversement : sa ligne d’état, puis le document 3 secondes plus tard, abrégé.
HTTP/1.1 202 Accepted{"doc_key": "holiday-hours", "version": "1", "status": "indexed", "chunk_count": 2, "error": null}La réponse, abrégée pour montrer ses principaux champs :
{ "answer": "The help desk is closed on 25 December, 26 December and 1 January.", "provider": "mock", "model": "mock", "input_tokens": 0, "output_tokens": 0, "cost_usd": 0.0, "latency_ms": 12, "generation_ms": 0, "trace_id": "c2fe0f20d60f387a39946f27c9f3ae9c"}trace c2fe0f20d60f387a39946f27c9f3ae9c: 18 ms generate 13 ms + 0 ms | provider=mock, model=mock, attempts=1, tokens.input=0, tokens.output=0La réponse et scripts.trace last ont le même identifiant de trace. Cette trace appartient donc à cette réponse. Regardez le fournisseur : mock (simulé). Personne n’a enregistré de vraie réponse à cette question. Le fournisseur simulé a donc répondu, et la page affiche la note « No recording for this question » (aucun enregistrement pour cette question). Cette fois, la première phrase du fournisseur simulé est correcte : la recherche e5 a classé « Closed days » (jours de fermeture) en premier. C’est de la chance, pas de la qualité. Un petit flux fonctionne de bout en bout, et son point faible est documenté : les nouvelles questions nécessitent le fournisseur live (en direct).
Travail autonome
Section intitulée « Travail autonome »Dans votre projet, réalisez un petit flux de bout en bout avant d’ajouter une fonctionnalité facultative. Le flux comporte quatre parties : un document d’un nouveau type (par exemple, un PDF avec un tableau), et une question à laquelle lui seul répond. Ensuite, la réponse avec sa citation sur la page, et sa trace. Puis écrivez dans votre README, sous « Not yet » (pas encore), trois fonctionnalités que vous n’ajouterez pas dans ce module, et pourquoi.
Afficher une solution détaillée
Voici la solution détaillée de Sam dans le parcours standard. Le nouveau type de document est le PDF de location de salle de Bramble Books. Ses prix figurent uniquement dans un tableau. Il est déjà dans l’ensemble de données, et sa question a été enregistrée.
$ curl -s -H "Content-Type: application/json" -d '{"question": "Can a community group use the reading room for free?"}' http://127.0.0.1:8000/v1/tenants/bramble/answers{ "answer": "Yes. Community groups can use the reading room for free on Tuesdays from 6 pm to 9 pm.", "provider": "recorded", "model": "chat-small", "input_tokens": 760, "output_tokens": 75, "cost_usd": 0.0001135, "latency_ms": 11, "generation_ms": 1227, "trace_id": "e8836b56a46ac7edea822d97338e3b07"}La réponse ci-dessus est abrégée pour montrer ses principaux champs. La trace ne montre que les lignes à partir de ask :
trace e8836b56a46ac7edea822d97338e3b07: 18 ms ask 5 ms + 13 ms | ############################ | tenant=bramble, question.chars=52, prompt=answer_v1, answerable=True retrieve 5 ms + 9 ms | ################## | passages=5 generate 14 ms + 0 ms | # | provider=recorded, model=chat-small, attempts=1, tokens.input=760, tokens.output=75 check 14 ms + 2 ms | ### | claims=1, claims.flagged=0 store 16 ms + 2 ms | ### |Dans la réponse complète, l’unique affirmation cite events-and-room-hire, section « Prices » (prix) : le tableau dans le PDF. Sam ajoute ensuite une section « Not yet » à son README :
## Not yet
- Sign-in and roles: every request acts as Sam (Module 4 adds them; until then, run it only on your computer).- A reranker: not measured yet; Module 5 decides with evidence.- Answers to new questions with a real model: they need the live provider and a key; the mock answers them now, labelled.
Dans le parcours avec votre propre idée, votre flux et votre liste diffèrent. La structure reste la même : un flux avec ses preuves, et une courte liste de ce qui attend, avec chaque raison.
Vérification de fin : un nouvel utilisateur peut accomplir la tâche
Section intitulée « Vérification de fin : un nouvel utilisateur peut accomplir la tâche »Demandez à une personne qui n’a pas vu votre projet de suivre le parcours avec les données synthétiques. Elle utilise seulement votre README : démarrer le projet, téléverser un document, le voir indexé, poser une question et lire la réponse avec citations. Ne l’aidez pas et notez chaque endroit où elle s’arrête. Vous réussissez la vérification quand elle termine sans votre aide. Si elle s’est arrêtée, corrigez le README à chaque endroit, puis demandez à une deuxième personne.
Afficher un bon exemple de compte rendu
Ce compte rendu est un exemple inventé pour montrer le format.
Who: Amira (developer, had not seen the project). Computer: Windows 11, Python 3.12.Started: README "First run", step 1.Stop 1: step 2 - "pip install" took 6 minutes; she thought it had frozen. Fix: the README now says "about 900 MB; it can take several minutes".Stop 2: the page showed "No recording for this question" for her own question. Fix: the README now says which questions are recorded, and that others get the mock.Finished: upload (indexed, 4 passages), question, cited answer. 25 minutes.Second person after the fixes (Mei): finished with no stop.Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Après EMBEDDER=e5, la question sur l'Ontario ne trouvait aucun passage jusqu'à ce que Sam exécute load_pack --reset. Expliquez pourquoi, et pourquoi la recherche n'utilise pas simplement les anciens vecteurs.
Afficher la réponse
Les anciens segments avaient des vecteurs du substitut par hachage, et le vecteur de la question venait d’e5. Les vecteurs de deux modèles occupent des espaces différents, même avec la même longueur (384). Leur distance ne signifie donc rien. La recherche lit donc seulement les segments dont le document a été indexé par le modèle actuel (d.embedder = %(embedder)s). Il n’y en avait aucun. La réindexation a créé des vecteurs e5 pour chaque segment. Rechercher dans les anciens vecteurs renverrait les passages dans un ordre aléatoire, ce qui est pire qu’aucun passage.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : Sam demande « Quel est le rabais du personnel? » sur la page avec un champ de date vide. Quel fournisseur répond, et pourquoi?
Afficher la réponse
Le fournisseur simulé, avec la note « No recording for this question ». Une date vide correspond à la date du jour dans le cours, le 11 octobre 2026. Mais l’enregistrement de cette question de Larkfield a été fait pour le 9 octobre 2026. La date fait partie de la clé de relecture, car une politique peut changer entre deux dates. Avec la date du 9 octobre 2026, la réponse enregistrée du vrai modèle est rejouée.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
La première question a pris environ 4 secondes. Tomás veut un modèle plus rapide. Utilisez la trace pour lui répondre.
Afficher la réponse
La trace répartit les 4 secondes : presque tout le temps est dans retrieve, qui charge le modèle de plongement à la première recherche. generate a pris très peu de temps, car la réponse était rejouée. La deuxième question a pris quelques millisecondes de récupération. Un modèle de réponse plus rapide ne changerait rien ici. Si le premier utilisateur ne doit pas attendre, chargez plutôt le modèle de plongement au démarrage.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification de fin du module : un nouvel utilisateur suit le parcours avec les données synthétiques. Quelles trois preuves montrent qu'il l'a fait, et quelle sortie de la tranche doit être étiquetée?
Afficher la réponse
Par exemple : la ligne du document avec l’état indexed et son nombre de passages; la réponse sur la page avec ses affirmations et citations; et la trace de cette question, dont l’identifiant correspond à celui sous la réponse. Chaque réponse doit afficher son fournisseur. Ainsi, personne ne prend une réponse mock pour un indicateur de la qualité du produit. Le compte rendu des endroits où le nouvel utilisateur s’est arrêté, et des corrections du README, complète les preuves.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Remplacez les substituts un à la fois, et vérifiez la tranche après chaque changement.
- Il faut rechercher dans un index avec le même modèle qui l’a construit. Réindexez après un changement de modèle.
- La recherche filtre par boutique, niveau d’accès, date et modèle avant de prendre les 5 meilleurs résultats.
- Les réponses enregistrées sont de vraies réponses, rejouées selon le modèle, la requête, la question et la date. Les autres questions reçoivent une réponse simulée, avec une note. Un enregistrement est rejoué seulement si vos passages contiennent tous les passages qu’il cite.
cite.pyvérifie chaque affirmation dans le code : l’identifiant existe dans cette boutique, il a été fourni au modèle, les nombres et la plupart des mots figurent dans le passage.- Une trace avec un segment de trace (span) par étape montre où le temps passe. La première question charge le modèle de plongement; l’appel au modèle rejoué prend très peu de temps.
Le module 3 en un paragraphe. Vous avez construit une tranche verticale : un backend vérifié avec un format d’erreur unique, des téléversements sous forme de tâches avec états, et une page qui montre chaque état. Ensuite, les vrais composants ont remplacé les substituts, un à la fois : recherche dense, réponses enregistrées d’un vrai modèle, citations vérifiées dans le code et trace par question. Un nouvel utilisateur peut accomplir la tâche avec les données synthétiques. Mais chaque requête agit en tant que Sam, dans n’importe quelle boutique.
Ensuite, le module 4 sécurise la tranche : connexion, adhésions, rôles et sécurité au niveau des lignes.
Leçon suivante : Appliquer les autorisations