
Simplicité et évolution
- Leçon 7
- 50 min
- Module 2 : Concevoir l'architecture de bout en bout
Où nous en sommes
Dans les deux leçons précédentes, nous avons dessiné huit parties et suivi le locataire dans chaque flux. Mais nous n'avons pas encore décidé comment ces parties fonctionnent : une seule application, ou des services séparés? Dans cette leçon, nous décidons avec des chiffres plutôt que selon les tendances, et nous notons les signaux qui justifieraient le coût d'une séparation. Nous commençons par une boulangerie familiale qui grandit.
Leçon 7 sur 19 · Conception de systèmes d'IA et maîtrise des coûtsSimplicité et évolution
1. Commencer par les besoins
2. Concevoir l'architecture de bout en bout
3. Estimer les ressources et le coût
4. Optimiser avec des compromis mesurés
5. Concevoir pour les défaillances et la croissance
6. Présenter la proposition
Ce que vous saurez faire
Décidez si les parties de Larkfield forment une seule application ou des services séparés. Appuyez-vous sur des chiffres, pas sur les tendances. Notez ensuite les signaux mesurables qui justifieraient le coût d’une séparation. La conception pourra ainsi évoluer plus tard de façon réfléchie.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les huit parties et les deux processus, l’API et le processus en arrière-plan, présentés dans Limites des services.
- Le locataire et les versions dans chaque flux, présentés dans Flux de données et d’identité.
- Les répliques : plusieurs copies de la même application derrière une seule adresse. Voir Mise à l’échelle horizontale dans Mettre à l’échelle les API et les charges de travail d’IA.
Ce qu’il vous faut sur votre ordinateur
- Votre dossier de la dernière leçon :
python -m pytest -qaffiche1 failed, 15 passed(1 échec, 15 réussites). Vous écrirez un autre fichier dans l’exercice du module, à la fin.
Une boulangerie qui grandit
Section intitulée « Une boulangerie qui grandit »Une famille ouvre une boulangerie. Un seul bâtiment abrite le comptoir, la cuisine et la réserve. Chaque pièce a une porte et une fonction claire. Mais une seule clé ouvre le bâtiment, une seule alarme le protège, et une seule personne ferme le soir.
Des années plus tard, les gâteaux de mariage deviennent une activité importante. Ils exigent un grand four, une équipe distincte et leurs propres heures d’ouverture. La famille loue alors un deuxième bâtiment pour les gâteaux. La raison est concrète : le four ne rentre pas. De plus, l’équipe des gâteaux travaille le dimanche, quand la boutique est fermée.
Une famille qui loue deux bâtiments dès le premier jour paie deux loyers et deux alarmes. Chaque commande doit traverser la rue. Le deuxième bâtiment n’est pas un mauvais choix. Il arrive trop tôt, et personne ne peut dire quand il sera rentable.
Le problème : des services avant d’en avoir besoin
Section intitulée « Le problème : des services avant d’en avoir besoin »Tomás propose quatre services séparés : un service de réponses, un service de recherche, un service d’ingestion et un service de locataires. Chacun aurait son propre déploiement, et ils communiqueraient par le réseau. Il veut les faire tourner avec Kubernetes. « Comme ça, chaque partie peut grandir indépendamment », dit-il.
Regardez ce que les parties doivent faire aujourd’hui. Dans le scénario de base, la minute la plus chargée apporte 0,268 question par seconde. Chaque réponse passe environ 2,18 secondes dans le système. Ainsi, environ 0,268 × 2,18 = 0,58 requête est en cours au moment le plus chargé : commencée, mais pas encore terminée. Le module 3 explique cette multiplication. Moins d’une. Une petite copie de l’application attend pendant la majeure partie de la journée.
Passons au coût. Un service qui doit répondre à tout moment exige au moins une copie active tout le mois. Nous avons utilisé le calculateur du dossier, présenté au module 3, avec une, deux et trois copies toujours actives. Chaque copie a la taille de l’API : 0,5 vCPU et 1 Gio. Le tableau montre le scénario de base, au mois 0. Après le module 3, vous pourrez refaire le calcul : modifiez min_replicas dans design.toml.
| Conception | Copies toujours actives | Calcul, $ US par mois | Total, $ US par mois |
|---|---|---|---|
| Une application modulaire : API toujours active, processus en arrière-plan actif seulement quand il travaille | 1 | 27,43 | 52,67 |
| Réponses et recherche dans des services séparés, avec le processus en arrière-plan | 2 | 62,42 | 87,66 |
| Services de réponses, de recherche et de locataires, avec le processus en arrière-plan | 3 | 97,42 | 122,65 |
Ce modèle est approximatif et favorise la séparation. Il exclut la grappe de serveurs, le réseau entre les parties, les journaux supplémentaires et le temps de travail supplémentaire. Malgré cela, trois services toujours actifs utilisent 82 % du budget mensuel de 150 $ US d’Omar (Q8), avant toute croissance.
Et rien de tout cela n’accélère une réponse. Le modèle écrit pendant 1,52 seconde sur les 2,18 secondes. La base de données ajoute environ 0,1 ms pour la sécurité au niveau des lignes et 0,22 ms pour une recherche vectorielle. Une séparation remplace les appels de fonctions par des appels réseau. Elle ajoute donc du temps et de nouvelles possibilités de défaillance.
L’idée : une application modulaire, avec des déclencheurs de séparation
Section intitulée « L’idée : une application modulaire, avec des déclencheurs de séparation »Une application modulaire possède une seule base de code et un seul déploiement, avec des modules internes bien définis. Les modules de Larkfield sont answers, search, ingestion et tenants. Chaque module a une fonction précise et un petit ensemble de fonctions que les autres peuvent appeler. Les modules s’appellent comme des fonctions dans le même programme, sans passer par le réseau. Le même code peut quand même s’exécuter dans plusieurs processus : l’API, toujours active, et le processus en arrière-plan, seulement quand des tâches l’attendent.
Les services séparés (souvent appelés microservices) placent chaque module dans son propre déploiement. Ils communiquent par le réseau. Chacun peut être livré, mis à l’échelle et exécuté sur son propre matériel. Cette liberté est réelle, tout comme son coût : davantage de déploiements, d’appels réseau pouvant échouer et d’endroits où appliquer la règle du locataire.
Un déclencheur de séparation fait le lien entre les deux. Il définit un signal mesurable, un seuil et le changement justifié : « si l’ingestion exige un GPU, déplacer le processus en arrière-plan dans son propre service ». Vous écrivez les déclencheurs aujourd’hui, pendant que la conception est simple. La conception peut ensuite évoluer : elle change par petites étapes, chacune justifiée par un besoin mesuré. Vous ne devinez pas l’architecture finale dès le premier jour.

Description textuelle du diagramme
À gauche, une application modulaire : une seule base de code et un seul déploiement. À l’intérieur, le module answers appelle search et tenants, et le module ingestion appelle search. Le code s’exécute dans deux processus : l’API, toujours active, et le processus en arrière-plan, à la demande. À droite, les mêmes modules forment des services séparés, en orange. Le service de réponses appelle les services de recherche et de locataires par le réseau. Le service d’ingestion appelle le service de recherche. Cela donne quatre déploiements et quatre pipelines de mise en production, avec trois services toujours actifs. Sur un téléphone, le diagramme montre deux modules de chaque côté.
Un petit exemple : le coût d’une partie toujours active de plus
Section intitulée « Un petit exemple : le coût d’une partie toujours active de plus »Voici les trois totaux du tableau sous forme de graphique, à côté du budget d’Omar. Avant de poursuivre, regardez la colonne du calcul. La deuxième copie coûte-t-elle plus ou moins que la première? Pourquoi?
Description textuelle du graphique
Quatre colonnes, en dollars US par mois, étiquetées selon le nombre de parties toujours actives. Une partie toujours active : 52,67. Deux : 87,66. Trois : 122,65. Le budget d’Omar pour tous les locataires réunis : 150. Chaque partie toujours active supplémentaire ajoute environ 35 dollars par mois.
La deuxième copie coûte plus cher que la première. Le coût du calcul augmente de 62,42 − 27,43 = 34,99 $ US, alors que la première copie entière coûtait 27,43 $ US. La raison se trouve dans la liste de prix. Le modèle de coûts exécute l’application sur Azure Container Apps. Sa page de tarifs offre une quantité gratuite de calcul chaque mois. La première copie l’utilise déjà. Chaque copie suivante paie le plein tarif. La troisième copie ajoute encore 35,00 $ US.
Le coût d’une séparation n’est donc pas « un peu plus de la même chose ». La première partie coûte peu. Chaque partie toujours active supplémentaire paie le plein tarif, chaque mois, même quand personne ne pose de question.
Le choix de Larkfield
Section intitulée « Le choix de Larkfield »Avec Amira, Kwame compare les deux conceptions selon les critères importants pour cette charge de travail :
| Question | Une application modulaire | Services séparés |
|---|---|---|
| Déploiements et pipelines de mise en production | 1 | 4 |
| Appels réseau dans une réponse | 0 | au moins 2 (recherche, locataire) |
| Endroits où la règle du locataire doit s’appliquer | 1 base de données, 1 base de code | 1 base de données, 4 bases de code |
| Ingestion séparée des réponses | oui : le processus en arrière-plan est distinct | oui |
| Coût du processus en arrière-plan sans téléversements | 0 : il passe à zéro instance | 0 |
| Calcul, scénario de base (approximatif) | 27,43 $ US par mois | 97,42 $ US par mois |
| Responsable de la maintenance (Q6 : une seule développeuse) | Amira seule | exige plus de personnes |
Remarquez les quatrième et cinquième lignes. Le principal avantage d’une séparation, éloigner l’ingestion lente des réponses, existe déjà dans la conception modulaire. Le processus en arrière-plan est distinct, lit la file de tâches et passe à zéro instance. La séparation ajoute des mises en production indépendantes, du matériel distinct et une mise à l’échelle distincte pour la recherche et les locataires. Aujourd’hui, aucun besoin ne justifie ces ajouts.
La décision est donc une application modulaire avec deux processus. Au module 6, elle devient la première fiche de décision d’architecture. Et comme les modules ont déjà des limites claires, une séparation ultérieure déplacera du code sans le réécrire.
Les déclencheurs de séparation
Section intitulée « Les déclencheurs de séparation »Une décision sans condition de réexamen est une supposition que personne ne vérifie ensuite. Kwame écrit trois déclencheurs. Chacun a un signal mesurable et un changement qui en découle.

Description textuelle du diagramme
La conception actuelle est une application avec l’API et le processus en arrière-plan. Trois déclencheurs peuvent la modifier. Si l’ingestion exige un GPU ou son propre rythme de mise en production, le processus en arrière-plan devient un service distinct. Si l’API exige plus de 4 répliques à la minute la plus chargée, la partie qui la limite est séparée. Si une deuxième équipe est responsable d’une partie du code, la séparation suit les modules de cette équipe. Chaque déclencheur modifie une partie, pas toute la conception.
| Déclencheur | Comment le mesurer | Aujourd’hui |
|---|---|---|
| L’ingestion exige une machine différente (un GPU) ou un rythme de mise en production différent | le choix du modèle (le module 4 compare un modèle autohébergé); le journal des mises en production | le processus en arrière-plan appelle le fournisseur de modèles; aucun GPU |
| L’API exige plus de 4 répliques à la minute la plus chargée | les requêtes en cours à la minute la plus chargée, dans les journaux; le plan de croissance du module 5 | 0,58 requête en cours, 1 réplique |
| Une deuxième équipe est responsable d’une partie du code | la liste des équipes | une seule développeuse, Amira |
Chaque déclencheur est concret. « Quand nous deviendrons gros » n’est pas un déclencheur, car personne ne peut dire quand cette condition est remplie. « Plus de 4 répliques à la minute la plus chargée » est un nombre que les journaux montrent chaque jour. Le module 5 transforme ces signaux en plan de croissance, et le module 6 les inscrit dans la fiche de décision.
Tomás demande : « Et si on se trompe, et que les boutiques grandissent vite? » Kwame répond avec le scénario élevé du module 1 : 13 874 questions par jour au mois 12, avec quatre boutiques. Le module 3 calcule les ressources nécessaires, et le module 5 surveille cette évolution. Si un déclencheur s’active, l’équipe sépare une partie, avec les mesures à l’appui. C’est moins cher que quatre services aujourd’hui, payés chaque mois sur la base d’une supposition.
Quand choisir chaque option, et ce qu’elle coûte
Section intitulée « Quand choisir chaque option, et ce qu’elle coûte »Commencez par une application modulaire quand une seule équipe construit le produit, que la demande est faible ou incertaine et que les parties partagent une base de données. Cela décrit la plupart des nouveaux produits, ainsi que Larkfield. Gardez des limites strictes entre les modules. Chaque module appelle seulement les fonctions offertes par un autre module et ne lit jamais directement ses tables. Cette règle réduit le coût d’une séparation ultérieure.
Choisissez des services séparés quand un déclencheur s’est activé. Une partie exige du matériel différent, un autre rythme de mise en production ou une mise à l’échelle très différente. Ou plusieurs équipes doivent livrer sans s’attendre mutuellement. Les déploiements supplémentaires apportent alors un avantage réel.
Les deux choix ont un coût. L’application modulaire peut devenir un enchevêtrement si personne ne protège les limites des modules. Les services séparés exigent du calcul toujours actif, des appels réseau et une règle du locataire dans chaque service. Notez votre choix, ses raisons et les conditions de son réexamen.
Erreurs courantes
Section intitulée « Erreurs courantes »Erreur courante
Un déclencheur que personne ne peut mesurer
Symptôme : la conception dit « séparer en services quand nous atteindrons une grande échelle ». Un an plus tard, Tomás et Amira se disputent pour savoir si cette « grande échelle » est atteinte. Personne ne peut montrer un chiffre.
Cause : le déclencheur décrit une impression, pas un signal. Il n’y a ni seuil ni source où le vérifier.
Correction : reformulez-le avec un signal, un seuil et une source. Par exemple : « plus de 4 répliques de l’API à la minute la plus chargée, selon les journaux des requêtes ». Vérifiez que quelqu’un recueille déjà ce signal aujourd’hui. Sinon, le déclencheur exige d’abord une ligne de journal.
Erreur courante
Des services qui partagent une table
Symptôme : après une séparation, une modification de la table des segments dans le service d’ingestion brise le service de recherche. Deux équipes doivent maintenant livrer ensemble.
Cause : les services ont été séparés, mais pas les données. Les deux lisent et modifient la même table. Ils forment donc encore un seul système, avec un réseau au milieu.
Correction : avant toute séparation, donnez à chaque module ses propres tables. Les autres doivent y accéder seulement par les fonctions du module. Une séparation déplace alors le code et les tables ensemble. Dans l’application modulaire, cette règle ne coûte rien et garde cette option possible.
À vous de jouer : deux boutiques de plus
Section intitulée « À vous de jouer : deux boutiques de plus »Changez une condition. Omar signe avec les troisième et quatrième boutiques. Au mois 12, le scénario de base compte quatre locataires et 2 304 questions par jour. Cela active-t-il un déclencheur de séparation? Quel parcours et quelle règle répondent à la question?
Afficher la réponse
Aucun déclencheur ne s’active. Une nouvelle boutique est une donnée, pas du code : le parcours J5 dit « un nouveau locataire sans modification du code ». Les nouvelles boutiques ajoutent des lignes dans PostgreSQL, un dossier dans le stockage de fichiers et leurs utilisateurs chez le fournisseur d’identité. La règle du locataire s’applique déjà à elles.
La demande passe de 1 465 à 2 304 questions par jour dans le scénario de base. Elle reste bien en dessous du deuxième déclencheur : à la minute la plus chargée, il reste moins d’une requête en cours, avec une seule réplique. Le troisième déclencheur ne s’active pas non plus, car l’équipe reste la même. Le module 3 vérifie le coût et le module 5, la croissance, avec les mêmes déclencheurs.
Exercice du module : la séquence d’ingestion
Section intitulée « Exercice du module : la séquence d’ingestion »Vous avez maintenant le diagramme de conteneurs, le flux de données et d’identité et le flux de requête. Il manque une image : que se passe-t-il quand une boutique téléverse un document? C’est la tâche autonome du module.
Un petit exemple détaillé. Le flux de requête de la dernière leçon suivait une question. Voici plutôt un téléversement, sous forme de tableau d’états. Ines téléverse la version 5 de la politique de retour de Bramble Books; la version 4 est active. Observez les changements d’état, étape par étape. Les nombres sont construits pour l’exemple.
| Après l’étape | Fichier de la version 5 | Version 5 | Version 4 | Tâche 812 | Version des documents |
|---|---|---|---|---|---|
| L’API enregistre le fichier | enregistré | pas encore | active | pas encore | 7 |
L’API écrit une transaction, puis répond 202 Accepted (accepté) |
enregistré | en traitement | active | en file d’attente | 7 |
| Le processus prend la tâche | enregistré | en traitement | active | en cours | 7 |
| Le processus crée les plongements et le résumé | enregistré | en traitement | active | en cours | 7 |
| Le processus écrit une transaction | enregistré | active | remplacée | réussie | 8 |
Deux choses ressortent. Jusqu’à la dernière ligne, chaque question utilise encore la version 4, qui donne des réponses correctes aux clients. Et le changement se fait dans une seule transaction : les nouveaux segments, le résumé, les deux états des versions, la tâche et la version des documents. Si le processus s’arrête après avoir créé les plongements, rien n’est enregistré à moitié. Le bail de la tâche (sa limite de temps) se termine. Puis un processus reprend la tâche depuis le début, comme dans Cycle de vie d’une tâche du cours Mettre à l’échelle les API et les charges de travail d’IA.
Votre tâche. Créez architecture/ingestion-sequence.md avec un sequenceDiagram Mermaid de ce téléversement. Utilisez six participants : Ines (la rédactrice), l’API de l’assistant, le stockage de fichiers, PostgreSQL, le processus d’ingestion et le fournisseur de modèles. Montrez d’où vient le locataire, où la requête se termine pour Ines et quelle étape constitue la transaction unique. Ajoutez une note sur un processus qui s’arrête à mi-chemin. Puis exécutez les tests.
Afficher une solution détaillée
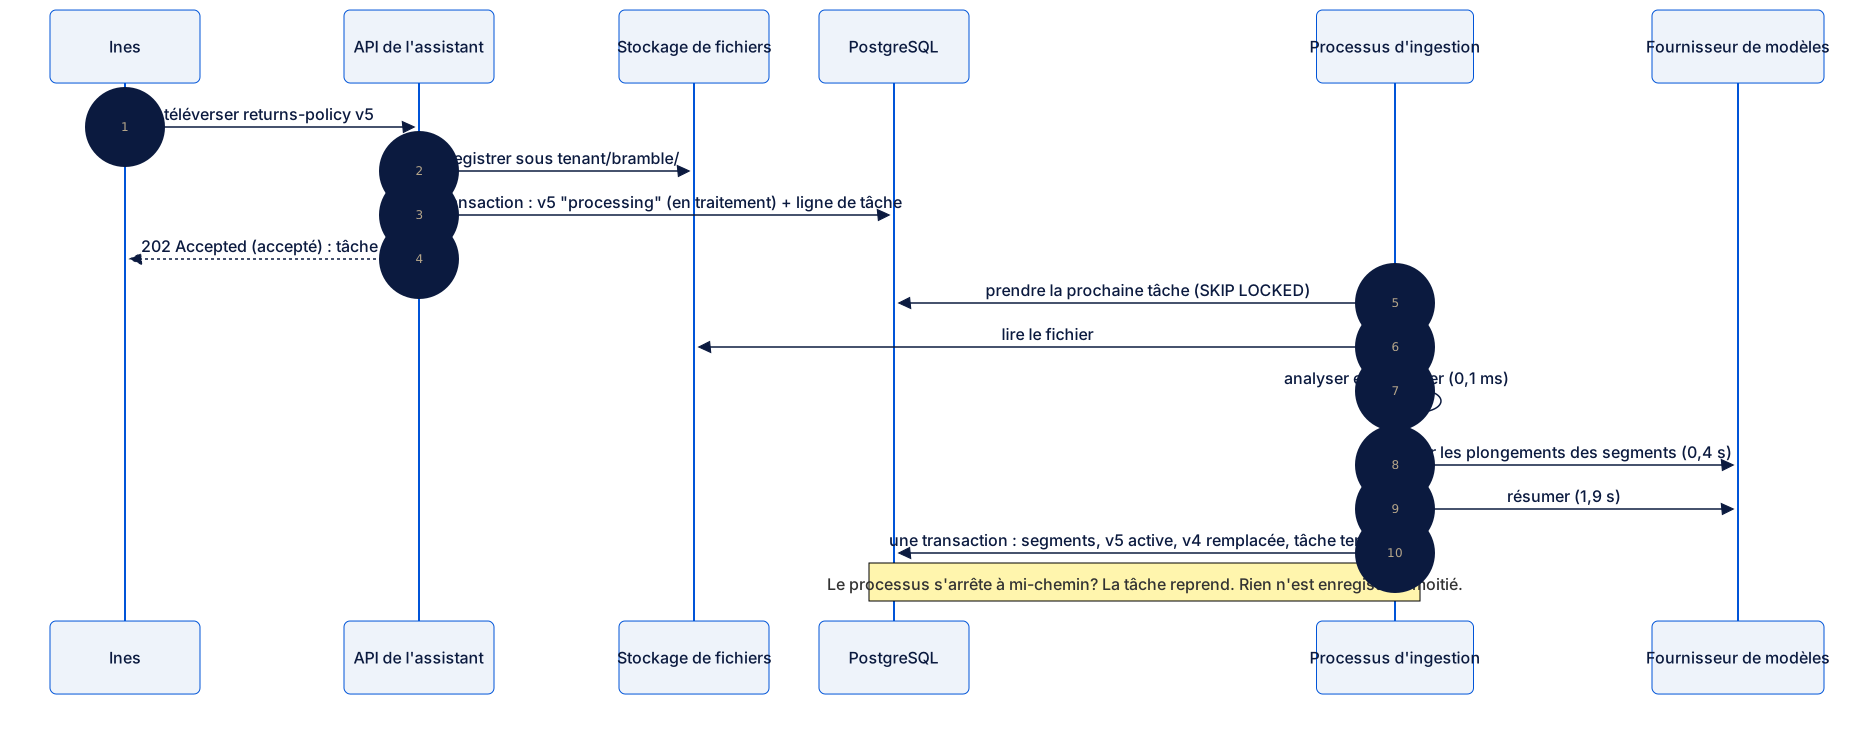
Description textuelle du diagramme
Ines téléverse la version 5 de la politique de retour. L’API enregistre le fichier dans le dossier de Bramble Books et écrit une transaction : la version 5 avec l’état « processing » (en traitement), et une ligne de tâche avec le locataire provenant de son jeton. Elle répond immédiatement 202 Accepted. Le processus prend la prochaine tâche avec SKIP LOCKED (ignorer les lignes verrouillées). Ainsi, deux processus ne prennent jamais la même tâche. Il lit le fichier, l’analyse et le découpe en environ 0,1 ms. Il crée les plongements de tous les segments en un appel, en environ 0,4 s, puis résume en environ 1,9 s. Ensuite, une seule transaction enregistre les segments, les vecteurs et le résumé. Elle marque aussi la version 5 comme active, la version 4 comme remplacée et la tâche comme terminée. Si le processus s’arrête à mi-chemin, la tâche s’exécute de nouveau, et rien n’est enregistré à moitié. Les durées sont des médianes mesurées lors des appels de l’équipe du cours.
Le fichier de l’instantané end-of-m02 propose un texte possible pour cette image. Comparez-le au vôtre, puis exécutez les tests :
python -m pytest -q................ [100%]16 passed in 0.02sLe dernier test vérifie que les deux séquences nomment les éléments du diagramme de conteneurs. La séquence d’ingestion doit aussi nommer le processus d’ingestion et le stockage de fichiers. Votre dossier correspond maintenant à l’instantané end-of-m02.
Vérifiez quatre points dans votre séquence. Le locataire vient du jeton du téléversement, passe par la ligne de tâche et ne vient jamais du nom de fichier. La requête d’Ines se termine avec 202, avant tout appel au modèle. La dernière écriture est une seule transaction. Et le processus peut s’arrêter à n’importe quelle étape sans laisser un document à moitié enregistré.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Tomás dit : « Les services séparés, c'est la façon moderne de faire. Et chaque élément peut grandir tout seul. » Donnez la réponse de Kwame avec les nombres de cette leçon, en trois ou quatre phrases.
Afficher la réponse
À la minute la plus chargée du scénario de base, environ 0,58 requête est en cours. Une seule copie de l’application suffit donc. L’élément qui doit grandir indépendamment, l’ingestion, s’exécute déjà dans son propre processus et peut passer à zéro instance. Trois services toujours actifs feraient passer le total mensuel approximatif de 52,67 $ US à 122,65 $ US. Cela exclut la grappe et le temps de travail des personnes. Et aucune réponse ne serait plus rapide : le modèle prend 1,52 s sur 2,18 s. Nous gardons une application modulaire et séparons un élément lorsqu’un déclencheur écrit s’active.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : pourquoi le deuxième élément toujours actif ajoute-t-il 34,99 $ US par mois, alors que le premier coûte seulement 27,43 $ US?
Afficher la réponse
Parce que la liste de prix comprend une quantité mensuelle gratuite de calcul, que le premier élément toujours actif utilise déjà. Chaque élément supplémentaire paie le plein prix pour chaque seconde du mois, même lorsqu’il ne fait rien. Le premier élément est donc le moins cher. Chaque élément suivant coûte environ 35 $ US par mois dans ce modèle approximatif.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification de fin de module : expliquez la responsabilité de chaque élément du diagramme de conteneurs et pourquoi il existe séparément.
Afficher la réponse
- Outil de soutien (Amira) : présente l’assistant aux agents et aux clients. Il existe parce que les personnes l’utilisent; c’est là que les parcours commencent.
- Fournisseur d’identité (Kwame) : connecte les personnes et émet un jeton contenant l’utilisateur, le locataire et le rôle. Il est externe : nous l’utilisons, nous ne le construisons pas, et chaque flux part de son jeton.
- API de l’assistant (Amira) : répond à une question d’un locataire : vérifie le jeton, cherche, appelle le modèle et enregistre la réponse. Elle existe parce qu’une personne attend sa réponse.
- Processus d’ingestion (Mei) : transforme une version de document téléversée en segments, en vecteurs et en résumé. Il existe parce que personne n’attend son résultat et qu’il ne doit jamais bloquer une réponse.
- PostgreSQL (Mei) : conserve chaque enregistrement, avec une sécurité au niveau des lignes. Il stocke les enregistrements, les vecteurs, la file d’attente et le cache au même endroit. Il y a donc une seule sauvegarde et une seule règle de locataire.
- Stockage de fichiers (Mei) : conserve le fichier original de chaque version. Les fichiers sont volumineux et rarement lus. Ils restent donc hors de la base de données, dans un dossier par locataire.
- Fournisseur de modèles (Kwame) : exécute les modèles de conversation et de plongement. Il est externe, avec un quota et des pannes que nous prévoyons.
- Journaux et alertes (Amira) : recueille les journaux et alerte une personne. Cet élément permet de mesurer les cibles du module 1 et de lire les déclencheurs de séparation.
La récupération et l’accès aux modèles sont des modules internes de l’application. Ils ont des limites, mais aucune boîte distincte, car aucune mesure actuelle n’exige leur exécution séparée.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une application modulaire a une seule base de code et un seul déploiement, avec des modules internes strictement délimités. Elle peut quand même s’exécuter dans deux processus : l’API et le processus d’ingestion de Larkfield.
- Les services séparés permettent des mises en production, du matériel et une mise à l’échelle indépendants. En contrepartie, ils exigent du calcul toujours actif, des appels réseau et davantage d’endroits où appliquer la règle de locataire.
- À la minute la plus chargée du scénario de base, 0,58 requête est en cours. Dans le modèle approximatif du dossier, le total passe de 52,67 $ US (un élément toujours actif) à 87,66 $ US (deux) et à 122,65 $ US (trois). La quantité gratuite de calcul couvre seulement le premier élément.
- Un déclencheur de séparation précise un signal, un seuil et un changement. Les trois de Larkfield : l’ingestion exige un GPU ou ses propres mises en production; plus de 4 répliques d’API à la minute la plus chargée; une deuxième équipe.
python -m pytest -qaffiche16 passed(16 tests réussis). Votre dossier correspond maintenant à l’instantanéend-of-m02.
Le module 2 en un paragraphe. Vous avez divisé l’assistant en huit éléments, chacun avec une tâche et une personne responsable. Vous avez demandé qui attend, quelles données chaque élément conserve et s’il nous appartient. Une réponse et une ingestion prennent toutes deux environ deux secondes, mais une personne attend seulement la réponse. L’ingestion s’exécute donc dans un processus en arrière-plan. Vous avez suivi le locataire, l’audience et les versions de documents dans chaque requête et chaque tâche. Le jeton, la transaction, la clé de cache, la ligne de tâche et le chemin du fichier portent chacun le locataire. Chaque réponse conserve aussi ses versions. Enfin, vous avez choisi une application modulaire plutôt que des services séparés, avec trois déclencheurs mesurés qui justifieraient une séparation.
Ensuite, le module 3 transforme cette architecture et la demande du module 1 en ressources et en coût mensuel.
Leçon suivante : Calculer la charge de travail