
Chemins texte et OCR
- Leçon 6
- 60 min
- Module 2 : Préparer et extraire le contenu
Où nous en sommes
Dans la dernière leçon, nous avons arrêté les mauvais fichiers à l'entrée, et 60 fichiers ont continué. Maintenant, nous devons en extraire les mots. La couche de texte est exacte, mais les numérisations et les photos n'en ont pas. L'OCR et un modèle de vision peuvent lire des images, mais chacun a son coût et ses propres échecs. Dans cette leçon, nous comparons les trois chemins sur les mêmes reçus, comme trois façons d'obtenir les mots d'une lettre.
Leçon 6 sur 19 · IA documentaire et multimodaleChemins texte et OCR
1. Comprendre les documents en entrée
2. Préparer et extraire le contenu
3. Retrouver la structure et les tableaux
4. Utiliser les modèles multimodaux de façon réfléchie
5. Valider et réviser les résultats
6. Évaluer et livrer le pipeline
7. Études de cas
Ce que vous saurez faire
Extrayez les mots d’une page de trois façons : la couche texte du PDF, l’OCR et un modèle de vision. Comparez-les sur les mêmes reçus. Vous saurez alors quel chemin utiliser pour chaque fichier, son coût par page, sa durée et ses limites.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- Les vérifications à la réception et les fichiers du module 2 dans votre projet, vus dans Traitement des entrées :
python -m pytest -qaffiche63 passed(63 tests réussis). - La couche texte d’un PDF numérique, ses lignes avec des rectangles en points et l’importance de l’ordre de lecture. Ces notions viennent de La politique de Larkfield, dans l’ordre de lecture, dans Mise en page et sens.
- Les neuf champs du reçu et
normalise, vus dans Le contrat de Larkfield, dans Définir le contrat d’extraction. - Un schéma JSON pour la réponse d’un modèle, vu dans Définir un schéma, dans Créer des applications fiables avec les API de LLM.
Ce qu’il vous faut sur votre ordinateur
- Le projet
~/projects/doc-extractavec l’environnement virtuel actif. Aucun compte, aucune clé et aucuns frais : les réponses du modèle de vision sont enregistrées, et le projet les rejoue.
Testé avec Python 3.12.13, pdfplumber 0.11.10, RapidOCR 3.10.0 et ONNX Runtime 1.31.0 sur macOS (Apple silicon). Les réponses de vision ont été enregistrées avec un modèle de vision hébergé, gpt-6.1-sol-2026-09-29. Les commandes Windows et Linux n’ont pas été testées.
Trois façons d’obtenir les mots d’une lettre
Section intitulée « Trois façons d’obtenir les mots d’une lettre »Vous avez besoin des mots d’une lettre sur votre ordinateur. Vous pouvez les obtenir de trois façons.
Si l’expéditeur vous a envoyé par courriel le fichier qu’il a tapé, vous copiez le texte. C’est exact et instantané, et vous savez où se trouvait chaque mot. Si vous avez seulement le papier, vous le retapez vous-même. C’est plus lent, avec quelques fautes de frappe, surtout quand l’impression est pâle. Ou vous donnez le papier à un collègue et lui demandez : « Remplissez ce formulaire à partir de cette lettre. » Votre collègue comprend même une lettre peu claire. Mais vous attendez, vous payez son temps, et il ne précise pas où il a vu chaque valeur sur la page. Parfois, il « corrige » un mot qu’il a lu trop vite.
Les documents offrent les trois mêmes choix à un programme. Cette leçon mesure les trois sur les reçus de Larkfield.
Le problème : un seul lecteur pour toutes les pages
Section intitulée « Le problème : un seul lecteur pour toutes les pages »Tomás a un plan simple : « De toute façon, chaque PDF est une image. Envoyons chaque page au modèle de vision. » Le modèle est bon. Mais regardez un reçu numérique net, D009, avec les trois chemins côte à côte :
python -m doc_extract.compare D009D009 receipt-lk-863042.pdf (digital_pdf, fr)field true value text ocr visionvendor Larkfield Larkfield ok Larkfield ok LARKEFIELD WRONGorder_number LK-863042 LK-863042 ok LK-863042 ok LK-863042 okdate 2026-06-06 2026-06-06 ok 2026-06-06 ok 2026-06-06 okcurrency CAD CAD ok CAD ok CAD oksubtotal 605.00 605.00 ok 605.00 ok 605.00 okshipping - - ok - ok - oktax 90.60 90.60 ok 90.60 ok 90.60 oktotal 695.60 695.60 ok 695.60 ok 695.60 okpayment_method Mastercard Mastercard ok Mastercard ok Mastercard ok
text 9/9 correct, 0.01 socr 9/9 correct, 0.99 svision 8/9 correct, 11.49 s, 1413 + 817 tokens = US$0.0110 (recorded)Le texte du PDF indique LARKFIELD. Le modèle a écrit LARKEFIELD, une lettre qui n’est pas sur la page. La couche texte a lu la page en 0,01 seconde, sans frais. Le modèle a pris 11,49 secondes et a coûté environ un cent américain.
Le plan inverse échoue aussi. Lisez D025, un PDF numérisé, avec la couche texte : tous les champs imprimés sont absents. Le PDF contient une image du reçu, pas son texte. Aucun lecteur ne convient donc à toutes les pages.
L’idée : trois chemins, un seul enregistrement
Section intitulée « L’idée : trois chemins, un seul enregistrement »Le projet lit une page de trois façons. Chacune est un chemin.
- La couche texte. Un PDF numérique stocke son texte sous forme de caractères avec des positions. pdfplumber les lit directement, comme dans Mise en page et sens.
- L’OCR, vu dans Types de documents : un programme qui trouve du texte dans une image et le lit. Le projet utilise RapidOCR sur le processeur de votre ordinateur. Pour chaque ligne, il fournit les caractères et un rectangle englobant (gauche, haut, droite, bas). Il fournit aussi un score de 0 à 1 : son degré de certitude.
- Un modèle de vision : un modèle qui accepte des images et du texte, comme l’explique Types de documents. Vous envoyez la page comme image avec une requête (prompt) (« remplissez ces champs »), et il répond avec des valeurs. Il traite les mises en page inhabituelles, mais ne fournit aucun rectangle et coûte de l’argent et du temps par page.
Le choix de conception important concerne ce que les chemins renvoient. La couche texte et l’OCR renvoient le même enregistrement : un Page avec son fichier, son numéro de page et son unité. Il contient des Line, chacune avec un texte, un rectangle et un score. C’est la représentation normalisée : une seule forme pour chaque chemin. Les règles qui remplissent le contrat (fields.py) utilisent ces lignes, peu importe le chemin qui les a produites. Comparer les chemins revient donc à comparer leur qualité de lecture. Chaque valeur conserve ses lignes, donc son fichier, sa page et son rectangle. Vous pouvez toujours retrouver son emplacement sur la page.

Description textuelle du diagramme
Le fichier original ne change jamais. Un PDF numérique passe par la couche texte vers un Page en points. Une numérisation ou photo passe par l’OCR vers un Page en pixels. Les deux Pages contiennent des Lines avec texte, rectangle et score (toujours 1.0 pour la couche texte). Les mêmes règles les transforment en valeurs qui conservent leur fichier, leur page et leur rectangle. Le troisième chemin envoie la page comme image au modèle de vision. Sa réponse contient seulement des valeurs, sans rectangle.
Un petit exemple : une photo, trois lignes
Section intitulée « Un petit exemple : une photo, trois lignes »Prenez D036, le reçu en français de Camille, de Montréal, photographié sur une table. Exécutez l’OCR sur ce reçu :
python -m doc_extract.ocr D036Les premières lignes de la sortie et les lignes autour du total :
IMG_4817.jpg, page 1: 34 lines by rapidocr 3.10.0 in 1.02 s (0 with a score under 0.80) 1.00 [ 492 162 791 238] LARKFIELD 1.00 [ 476 219 796 290] Maison et jardin 0.96 [ 442 261 828 338] 4100 rue Saint-Denis 0.99 [ 445 310 814 382] Montréal QC H2W 2M5 0.97 [ 255 381 605 451] Date : 09/08/2026 0.99 [ 252 428 660 502] Commande : LK-706142 ... 1.00 [ 216 1110 326 1155] TOTAL 1.00 [ 811 1122 919 1171] 87,78 0.98 [ 714 1155 915 1210] 1 011,78 $ 1.00 [ 212 1190 304 1234] CashChaque ligne contient le score, le rectangle en pixels de la photo de 1 200 × 1 600, puis le texte. Les coordonnées sont dans l’ordre gauche, haut, droite, bas. Les accents de Montréal sont corrects. Le traitement de la page a pris une seconde. La première exécution prend plus de temps, car RapidOCR charge ses modèles. Le résultat est conservé dans out/cache/ocr/, donc l’exécution suivante est instantanée.
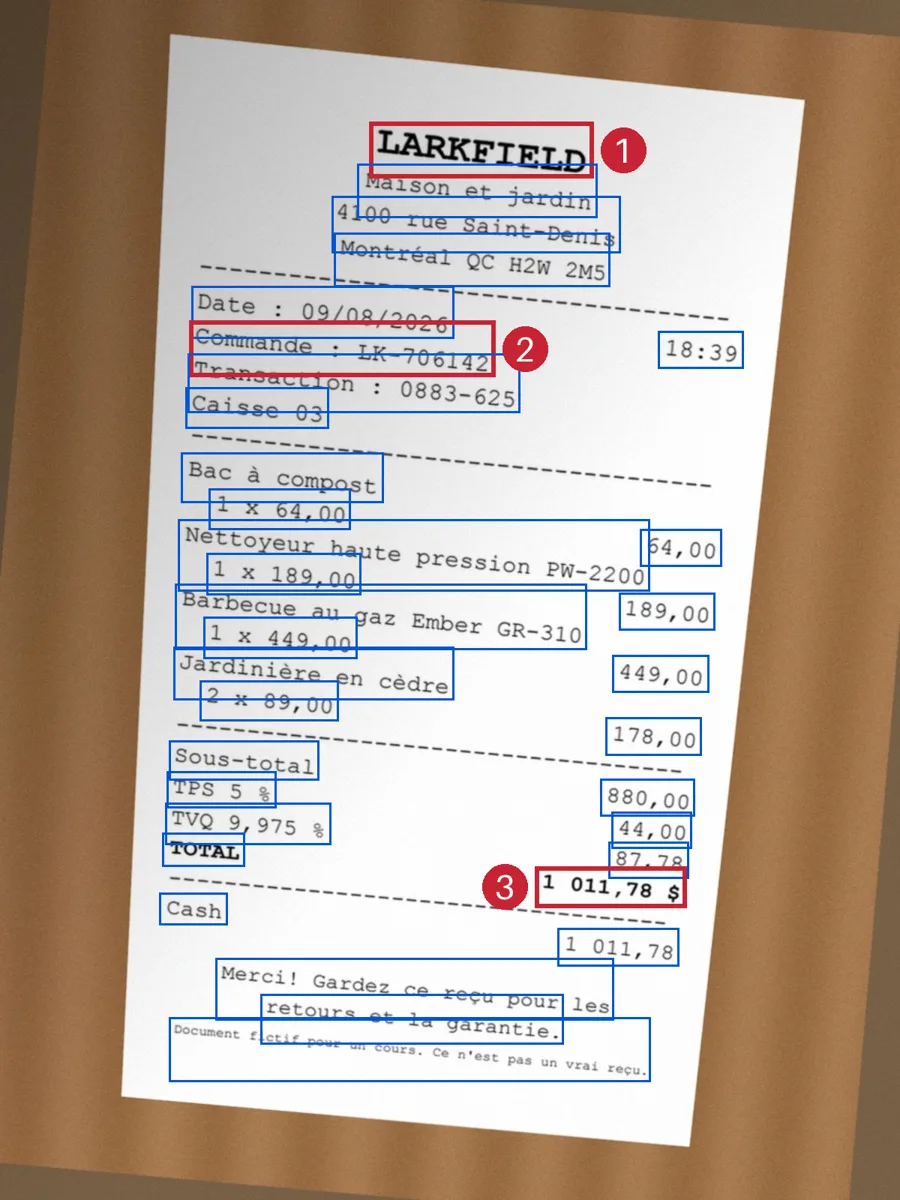
Description textuelle du diagramme
La photo originale de D036, légèrement inclinée, avec un mince rectangle bleu autour de chacune des 34 lignes trouvées par l’OCR. Trois rectangles rouges numérotés indiquent LARKFIELD (1), « Commande : LK-706142 » (2) et le total « 1 011,78 $ » (3). Comme la photo est inclinée, les montants à droite se trouvent un peu plus bas que leurs libellés.
Voici les trois lignes numérotées sous forme d’enregistrements, exactement comme le projet les stocke :
text (texte) |
box (rectangle, px) |
score |
|
|---|---|---|---|
| 1 | LARKFIELD |
492, 162, 791, 238 | 1.00 |
| 2 | Commande : LK-706142 |
252, 428, 660, 502 | 0.99 |
| 3 | 1 011,78 $ |
714, 1155, 915, 1210 | 0.98 |
Elles appartiennent au même Page : fichier IMG_4817.jpg, page 1, unité px, chemin ocr. Avec ces valeurs, n’importe qui peut ouvrir la photo et tracer le rectangle du total : c’est la preuve.
Les règles travaillent ensuite sur les lignes. Elles cherchent une rangée qui commence par TOTAL et prennent le montant sur la même rangée : 1 011,78 $. La fonction normalise du contrat le transforme en 1011.78. La date française 09/08/2026 devient 2026-08-09, car un reçu du Québec indique le jour en premier.
« Sur la même rangée » cache un piège. La photo est inclinée d’environ 5 degrés, donc chaque montant à droite se trouve plus bas que son libellé. Si vous triez les lignes de haut en bas selon leur valeur top (haut), vous obtenez cet ordre :
Sous-totalTPS 5 %880,00TVQ 9,975 %44,00TOTAL87,781 011,78 $Avec une lecture naïve, TPS 5 % est suivi de 880,00, et TOTAL de 87,78. Les deux paires sont incorrectes : une erreur d’ordre de lecture, avant qu’un modèle voie le texte. La fonction pages.rows du projet regroupe les lignes en rangées selon l’inclinaison de la page (5,33 degrés ici). Elle obtient Sous-total 880,00, TPS 5 % 44,00 et TOTAL 1 011,78 $.
Le chemin de vision : une réponse enregistrée
Section intitulée « Le chemin de vision : une réponse enregistrée »Le troisième chemin envoie l’image de la page à un modèle de vision avec la requête v2. Elle contient un schéma JSON strict avec les neuf champs et des règles pour les valeurs non imprimées. Conception des entrées et des requêtes la construit. Le cours a enregistré une réponse par page de reçu, avec ses jetons et sa durée. Le projet la rejoue, donc vous n’avez besoin d’aucune clé :
python -m doc_extract.vision D036recorded answer (replayed; nothing was sent)D036 IMG_4817.jpg page 1, prompt v2: gpt-6.1-sol-2026-09-29, 3135 tokens in, 787 out, 10.65 s, about US$0.0141 vendor LARKFIELD (confidence 1.0) order_number LK-706142 (confidence 1.0) date 2026-08-09 (confidence 1.0) currency CAD (confidence 0.99) subtotal 880.00 (confidence 1.0) shipping absent (not_printed) (confidence 1.0) tax 131.78 (confidence 1.0) total 1011.78 (confidence 1.0) payment_method Cash (confidence 1.0) item: 1 x Bac à compost @ 64.00 = 64.00 item: 1 x Nettoyeur haute pression PW-2200 @ 189.00 = 189.00 item: 1 x Barbecue au gaz Ember GR-310 @ 449.00 = 449.00 item: 2 x Jardinière en cèdre @ 89.00 = 178.00Chaque valeur est correcte, et le modèle a aussi listé les quatre articles. Lisez la ligne du coût. L’image et la requête représentaient 3 135 jetons (tokens) en entrée. Les jetons sont les morceaux de texte et d’image qu’un modèle lit et facture. La réponse comptait 787 jetons en sortie. Le prix affiché est de 2 $ US par million de jetons en entrée et de 10 $ US par million en sortie. L’appel a donc coûté 3 135 × 2 / 1 000 000 + 787 × 10 / 1 000 000 = 0,0063 $ US + 0,0079 $ US, soit environ 0,0141 $ US. Les prix changent : consultez la page des tarifs actuels de votre fournisseur. La réponse a pris 10,65 secondes.
Il manque deux choses. Le modèle ne précise l’emplacement d’aucune valeur. Et sa « confiance » est un nombre qu’il écrit, pas une mesure. Confiance et acheminement vers la révision montre ce qu’elle vaut.
Comparer les trois chemins sur une page
Section intitulée « Comparer les trois chemins sur une page »-
Comparez les chemins sur la photo en français :
Fenêtre de terminal python -m doc_extract.compare D036D036 IMG_4817.jpg (photo, fr)field true value text ocr visionvendor Larkfield (cannot read) Larkfield ok LARKFIELD okorder_number LK-706142 (cannot read) LK-706142 ok LK-706142 okdate 2026-08-09 (cannot read) 2026-08-09 ok 2026-08-09 okcurrency CAD (cannot read) CAD ok CAD oksubtotal 880.00 (cannot read) 880.00 ok 880.00 okshipping - (cannot read) - ok - oktax 131.78 (cannot read) 131.78 ok 131.78 oktotal 1011.78 (cannot read) 1011.78 ok 1011.78 okpayment_method Cash (cannot read) Cash ok Cash okocr 9/9 correct, 1.02 svision 9/9 correct, 10.65 s, 3135 + 787 tokens = US$0.0141 (recorded)Une photo n’a pas de couche texte. Un champ est
ok(correct) quand sa valeur normalisée égale la valeur réelle. Ainsi,LARKFIELDcompte pourLarkfield. Un champ non imprimé (-) est correct quand le chemin le laisse vide. -
Comparez-les sur un PDF numérique :
Fenêtre de terminal python -m doc_extract.compare D011Les dernières lignes :
text 9/9 correct, 0.01 socr 9/9 correct, 0.85 svision 9/9 correct, 7.15 s, 1359 + 561 tokens = US$0.0083 (recorded)Les trois sont corrects. La couche texte est environ 85 fois plus rapide que l’OCR et 700 fois plus rapide que le modèle. Elle ne coûte rien.
-
Comparez-les sur D025, une numérisation tournée sur le côté :
Fenêtre de terminal python -m doc_extract.compare D025text 1/9 correct, 0.00 socr 1/9 correct, 0.93 svision 9/9 correct, 8.27 s, 3194 + 598 tokens = US$0.0124 (recorded)La couche texte et l’OCR obtiennent seulement la livraison « correcte », car elle n’est pas imprimée. Un PDF numérisé contient une image, pas du texte. L’OCR lit l’image tournée sur le côté comme du texte incompréhensible. La prochaine leçon, Préparation des images, corrige l’OCR sur cette page.
Explorer les trois chemins
Section intitulée « Explorer les trois chemins »L’explorateur montre six reçus du cours avec les trois chemins. Chaque panneau trace sur la page les rectangles que son chemin peut fournir : vert pour une valeur correcte, rouge pour une incorrecte. Le tableau en dessous compare chaque champ à la valeur réelle. Ici, l’OCR lit l’image préparée dans la prochaine leçon.
Explorer
Une page, trois chemins
Prédisez d’abord : Quel chemin obtient le plus de champs corrects sur une photo? Lequel peut montrer où se trouve chaque valeur sur la page?
D036 (IMG_4817.jpg): Une photo de téléphone en français : l’OCR et le modèle trouvent 9 sur 9. L’OCR donne un cadre à chaque valeur ; le modèle ne donne que les valeurs.
Couche texte du PDF
Ce fichier est illisible pour ce chemin : une image n’a pas de couche texte.
OCR (image préparée)
- 9 sur 9 justes
- 1,25 s
- cadres : 8 sur 8 valeurs
Modèle de vision (enregistré)
- 9 sur 9 justes
- 10,65 s
- 3135 + 787 jetons, environ 0,0141 $ US
- cadres : 6 sur 8 valeurs (retrouvées sur les lignes de l’OCR ; le modèle n’en donne aucun)
| Champ | Vraie valeur | Couche texte | OCR | Modèle de vision |
|---|---|---|---|---|
vendor | Larkfield | – | Larkfieldjuste | LARKFIELDjuste |
order_number | LK-706142 | – | LK-706142juste | LK-706142juste |
date | 2026-08-09 | – | 2026-08-09juste | 2026-08-09juste |
currency | CAD | – | CADjuste | CADjuste |
subtotal | 880.00 | – | 880.00juste | 880.00juste |
shipping | non imprimé | – | (rien)juste : non imprimé | (rien)juste : non imprimé |
tax | 131.78 | – | 131.78juste | 131.78juste |
total | 1011.78 | – | 1011.78juste | 1011.78juste |
payment_method | Cash | – | Cashjuste | Cashjuste |
Description textuelle de l’explorateur
Une commande permet de choisir le document. Pour chacun, trois panneaux montrent la page avec les rectangles et les comptes de chaque chemin. Un tableau liste chaque champ. D011, un PDF numérique : les trois chemins obtiennent 9 sur 9, en 0,006 s, 0,96 s et 7,15 s (environ 0,0083 $ US). D036, une photo en français : l’OCR et le modèle obtiennent 9 sur 9. L’OCR a un rectangle pour chacune de ses 8 valeurs, le modèle pour 6. D025, une numérisation tournée sur le côté : aucune couche texte. L’OCR sur l’image préparée et le modèle obtiennent 9 sur 9. D049, le magasin partenaire : l’OCR avec les règles obtient 6 sur 9, le modèle 9 sur 9. D045, bas coupé : 8 sur 9 chacun (l’OCR manque la devise, le modèle la taxe). D046, illisible : 1 sur 9 chacun. La réponse : sur les photos, le modèle obtient autant de champs corrects ou plus. Mais seul l’OCR montre où se trouve chaque valeur.
Les 54 pages de reçus : ce que chaque chemin lit bien
Section intitulée « Les 54 pages de reçus : ce que chaque chemin lit bien »Six documents sont des exemples. Le cours a mesuré les trois chemins sur chaque page de reçu : 53 reçus et la page de reçu de la réclamation de garantie. Ils présentent 435 valeurs imprimées. Une valeur non imprimée n’est pas comptée ici.
- Couche texte
- OCR (image brute)
- Modèle de vision
Description textuelle du graphique
Valeurs imprimées correctes, dans l’ordre couche texte, OCR et modèle de vision. PDF numériques : 96,5 %, 96,5 %, 99,4 %. PDF numérisés : 0 %, 86,0 %, 100 %. Images numérisées : 0 % (lecture impossible), 81,2 %, 100 %. Photos : 0 % (lecture impossible), 88,0 %, 92,3 %.
Sur les PDF numériques, la couche texte est aussi bonne que l’OCR. Leurs 6 valeurs manquantes se trouvent sur les deux reçus du magasin partenaire, dont les règles ne connaissent pas les mots. Sur les numérisations, l’OCR perd des valeurs que le modèle conserve, surtout sur les deux pages tournées, D025 et D026. Sur les photos, même le modèle baisse : personne ne peut lire D046, et sur D045, il a manqué la taxe. Sur les 435 valeurs : couche texte, 169 (38,9 %, car elle lit seulement les PDF numériques); OCR, 392 (90,1 %); modèle, 425 (97,7 %). Avec la préparation des images, l’OCR atteint 408 (93,8 %), comme le montre la prochaine leçon.
compare --all compte autrement, donc vérifiez votre lecture des résultats. Il compte les 9 champs de chaque reçu. Un champ non imprimé compte comme correct s’il reste vide :
python -m doc_extract.compare --allsource text ocr visiondigital_pdf 183/189 (97%) 183/189 (97%) 188/189 (99%)scan_pdf 8/63 (13%) 55/63 (87%) 63/63 (100%)scan_image cannot read 76/90 (84%) 90/90 (100%)photo cannot read 121/135 (90%) 126/135 (93%)mixed_pdf 3/9 (33%) 9/9 (100%) 9/9 (100%)Correct fields of 9 per receipt; a field is correct when its normalised value is the true one.La première exécution prend environ 30 secondes d’OCR; les suivantes utilisent le cache. Le 8/63 de la couche texte sur les PDF numérisés correspond seulement aux champs de livraison vides. C’est pourquoi les leçons comptent les valeurs imprimées.
Temps et coût par page
Section intitulée « Temps et coût par page »| Chemin | Temps par page (médiane) | Coût par page | Fournit des rectangles |
|---|---|---|---|
| Couche texte | 5,4 ms | aucun | oui, en points |
| OCR, image brute | 0,49 s | aucun (votre processeur) | oui, en pixels |
| OCR, image préparée | 0,97 s | aucun (votre processeur) | oui, sur l’image originale |
| Modèle de vision, requête v2 | 7,35 s (p95 10,65 s) | environ 0,0113 $ US (3 135 jetons en entrée, 556 en sortie) | non |
Ces durées viennent de l’ordinateur du cours, avec d’autres tâches en cours. Comparez donc les rapports, pas les nombres. Le modèle est environ 15 fois plus lent que l’OCR et plus de 1 000 fois plus lent que la couche texte. Pour 1 000 pages, il coûte environ 1 000 × 0,0113 $ US = 11,30 $ US au prix affiché.
Quel moteur OCR choisir, et pourquoi
Section intitulée « Quel moteur OCR choisir, et pourquoi »L’OCR n’est pas un seul programme. Le cours a comparé deux moteurs OCR qui s’installent avec seulement pip, sur les mêmes 54 pages de reçus préparées. Le taux d’erreur sur les caractères (CER) compte les caractères mal lus, en proportion des caractères imprimés. Plus il est bas, mieux c’est.
| RapidOCR 3.10.0 | OnnxTR 0.9.0 | |
|---|---|---|
| Taux d’erreur sur les caractères | 5,69 % | 6,55 % |
| Mots imprimés trouvés | 93,2 % | 92,0 % |
| Mots français accentués lus correctement | 42 sur 42 | 42 sur 42 |
| Valeurs imprimées correctes (avec les mêmes règles) | 408 sur 435 | 400 sur 435 |
| Temps par page (médiane) | 0,51 s | 0,50 s |
| Mémoire maximale | 1 336 Mo | 1 253 Mo |
| Modèles à la première utilisation | inclus dans le paquet | 102 Mo téléchargés |
RapidOCR gagne de peu, et ses modèles sont inclus dans le paquet. Derrière le pare-feu d’une entreprise, un téléchargement de 102 Mo depuis GitHub peut échouer. Le cours n’a pas essayé Tesseract, le moteur gratuit le plus connu. Il nécessite un paquet système (Homebrew, apt ou un programme d’installation), et le cours limite l’installation à pip. Un petit écart peut changer avec d’autres documents. Mesurez donc les résultats sur vos propres fichiers avant de choisir.
Où chaque chemin échoue
Section intitulée « Où chaque chemin échoue »- La couche texte lit seulement ce que le PDF stocke comme texte : une numérisation dans un PDF ne donne rien. L’ordre de stockage n’est pas toujours l’ordre de lecture, comme l’ont montré deux colonnes dans Mise en page et sens.
- L’OCR échoue sur les pages tournées (D025 et D026 brutes : 1 sur 9 chacune). Il supprime des espaces sur les images de mauvaise qualité (
Nettoyeur haute pressionPW-2200sur D036). Il mélange aussi les rangées sur une photo inclinée. Les règles qui suivent connaissent seulement les mots de Larkfield, donc elles manquentAMOUNT DUE(montant dû) sur D049. - Le modèle de vision coûte de l’argent et du temps, ne fournit aucun rectangle et peut écrire une valeur absente de la page :
LARKEFIELDsur D009. Avec une requête simple, il a inventé 11 numéros de commande. Conception des entrées et des requêtes montre ce cas et sa correction.
Quand utiliser chaque chemin et combien il coûte
Section intitulée « Quand utiliser chaque chemin et combien il coûte »Utilisez la couche texte dès qu’une page en possède une : elle est exacte, instantanée, gratuite et fournit des cadres. Utilisez l’OCR pour les images : numérisations, photos et pages numérisées d’un PDF mixte. L’OCR utilise votre processeur, fournit des cadres et des scores, et prend environ une seconde par page. Types de documents dirige déjà chaque page vers l’un de ces deux chemins.
Utilisez le modèle de vision seulement quand ces deux chemins et les règles ne suffisent pas. Par exemple, la mise en page est inconnue ou les règles ne trouvent pas certaines valeurs obligatoires. Il coûte environ un cent et prend sept secondes par page. Ses valeurs n’ont aucune preuve, sauf si vous les retrouvez dans les lignes OCR. Combiner les méthodes construit cette règle. Le modèle traite 9 des 54 reçus : 0,0018 $ US par document en moyenne, plutôt que 0,0113 $ US par page.
Le modèle a un autre coût : la confidentialité. Chaque page envoyée quitte votre ordinateur. Un reçu peut contenir un nom, une adresse et les derniers chiffres d’une carte. Envoyez seulement les pages qui en ont besoin, dans le cadre d’une entente acceptée par votre entreprise.
Un appel en direct, si vous le souhaitez (facultatif)
Section intitulée « Un appel en direct, si vous le souhaitez (facultatif) »Utilisez votre propre clé pour un point de terminaison compatible avec OpenAI dont le modèle lit les images. Définissez VISION_BASE_URL, VISION_API_KEY et VISION_MODEL dans un fichier .env (voir .env.example), puis lancez python -m doc_extract.vision D036 --live. Cela coûte environ un cent américain par page, et votre réponse peut différer de celle enregistrée. La suite ne dépend pas de cet appel. Le cours n’a pas testé --live avec d’autres fournisseurs.
Erreur courante
Traiter chaque PDF comme une image
Symptôme : Tomás envoie chaque page au modèle de vision. Les valeurs semblent correctes après une vérification rapide. Puis la facture arrive : environ un cent par page, même pour les 21 reçus numériques. Et sur D009, un PDF numérique bien lisible, le fournisseur est LARKEFIELD, un mot absent de la page.
Cause : Un PDF numérique n’est pas une image. Il contient déjà son texte sous forme de caractères, exactement comme la caisse du magasin les a imprimés. Le convertir en image pour demander au modèle de le lire supprime ce texte. Ensuite, on paie pour le deviner.
Diagnostic : Lancez python -m doc_extract.route et regardez le chemin de chaque page. Une page avec le chemin text (texte) possède une couche texte. Comparez les valeurs du modèle avec textlayer (couche texte) sur cette page. compare D009 montre immédiatement la différence.
Solution : Lisez la couche texte quand une page en possède une. Envoyez les images à l’OCR. Appelez le modèle seulement pour les champs que les règles n’ont pas remplis, comme dans Combiner les méthodes.
Conséquence pour le travail en IA : le pipeline est plus lent, plus coûteux et moins exact sur les documents les plus faciles. Il perd aussi les preuves que la couche texte fournit gratuitement.
À vous de jouer : la photo du magasin partenaire
Section intitulée « À vous de jouer : la photo du magasin partenaire »Changez une condition : le magasin. D049 est une photo prise au téléphone d’un reçu de Maple & Pine Hardware. La caisse de ce magasin partenaire imprime des mots différents de ceux de Larkfield. Avant de lancer quoi que ce soit, faites une prédiction. Quels champs l’OCR avec les règles manquera-t-il, et lesquels le modèle trouvera-t-il? Lancez ensuite python -m doc_extract.compare D049 et python -m doc_extract.ocr D049, puis expliquez le résultat à partir des lignes OCR.
Afficher la réponse
D049  IMG_5101.jpg  (photo, en)field           true value    text            ocr             visionvendor          Maple & Pine Hardware(cannot read)   MAPLE & PI ok   MAPLE & PI okorder_number    -             (cannot read)   - ok            - okdate            2026-09-23    (cannot read)   2026-09-23 ok   2026-09-23 okcurrency        CAD           (cannot read)   CAD ok          CAD oksubtotal        27.45         (cannot read)   - WRONG         27.45 okshipping        -             (cannot read)   - ok            - oktax             3.57          (cannot read)   3.57 ok         3.57 oktotal           31.02         (cannot read)   - WRONG         31.02 okpayment_method  Visa          (cannot read)   - WRONG         Visa ok
ocr     6/9 correct, 0.68 svision  9/9 correct, 6.46 s, 3135 + 489 tokens = US$0.0112 (recorded)
L’OCR a bien lu les mots : MERCH 27.45 (marchandises), AMOUNT DUE 31.02 (montant dû) et TENDER VISA****4821 (paiement), avec des scores de 1,00. Les règles manquent trois champs parce qu’elles cherchent les mots de Larkfield (Subtotal (sous-total), TOTAL (total)). Il s’agit donc d’une erreur des règles, pas d’une erreur d’OCR. Le cours a volontairement choisi une mise en page inconnue des règles. Le modèle trouve les 9 champs. C’est ici que le modèle justifie son coût, et Combiner les méthodes l’utilise précisément à cet endroit.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Nommez les trois chemins et, pour chacun, ce qu'il renvoie pour une ligne de texte sur la page.
Afficher la réponse
La couche texte fournit les caractères de la ligne exactement comme le PDF les stocke. Elle fournit aussi un cadre en points et un score de 1,0. L’OCR fournit les caractères lus dans l’image, un cadre en pixels et un score de 0 à 1. Ce score indique son degré de certitude. Les deux fournissent le même enregistrement, une Line (ligne) dans une Page (page). Les mêmes règles peuvent donc les utiliser, et chaque valeur conserve son fichier, sa page et son cadre. Le modèle de vision fournit les valeurs des champs, avec une « confiance » qu’il écrit lui-même, sans cadre.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez et expliquez : Omar demande pourquoi la couche texte trouve seulement 38,9 % des valeurs imprimées au total, contre 96,5 % sur les PDF numériques. Que répondez-vous, et quel nombre devrait guider le choix du chemin?
Afficher la réponse
Les numérisations et les photos n’ont pas de couche texte. Ce chemin ne trouve donc aucune de leurs valeurs. Ses 169 valeurs sur 435 proviennent presque uniquement des PDF numériques. Aucun des deux nombres ne guide seul le choix : il faut choisir pour chaque page. Utilisez la couche texte pour les pages qui en possèdent une : 96,5 % sur celles-ci, en quelques millisecondes, gratuitement. Utilisez l’OCR pour les images, et le modèle quand les règles manquent encore des valeurs obligatoires. C’est pourquoi route décide page par page.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Vérification pratique : lancez compare sur D021, une numérisation inclinée en français. Quels chemins la lisent, combien de champs chacun trouve-t-il correctement, et qu'indiquent les lignes de durée et de coût?
Afficher la réponse
python -m doc_extract.compare D021 affiche 1/9 correct (1 champ correct sur 9) pour la couche texte. Seul le champ de livraison vide est correct, car un PDF numérisé n’a pas de texte. L’OCR obtient 9/9 correct (9 champs corrects sur 9) en environ 0,9 seconde. Le modèle obtient 9/9 correct en 8,92 secondes, pour 3 194 + 602 jetons (tokens), soit environ 0,0124 $ US. Sur cette numérisation, l’OCR est aussi exact que le modèle, environ dix fois plus rapide et gratuit. Une numérisation inclinée de 2 degrés ne pose pas de problème à l’OCR; une page tournée sur le côté, oui.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Trois chemins lisent une page. La couche texte est exacte, prend 5,4 ms, ne coûte rien et fournit des cadres en points. Mais elle fonctionne seulement pour les PDF numériques. L’OCR lit toute image en environ 0,5 à 1 s sur le processeur, avec des cadres en pixels et un score. Un modèle de vision lit comme une personne, en environ 7 s, pour environ 0,0113 $ US par page, sans cadre.
- La couche texte et l’OCR fournissent une représentation normalisée commune : des lignes avec texte, cadre et score. Ces lignes appartiennent à une page avec son fichier et son unité. Les mêmes règles utilisent cette représentation, et chaque valeur conserve sa source.
- Sur les 435 valeurs imprimées des 54 pages de reçus : couche texte 169 (38,9 %), OCR 392 (90,1 %), modèle de vision 425 (97,7 %). Par type de document, la couche texte et l’OCR sont à égalité sur les PDF numériques. L’OCR perd en exactitude sur les numérisations tournées, et même le modèle baisse sur les photos.
- Chaque chemin échoue à sa façon. Les numérisations n’ont pas de couche texte; l’OCR échoue sur les pages tournées et supprime des espaces. Les règles ne connaissent pas toutes les mises en page; le modèle écrit
LARKEFIELDsur un PDF bien lisible. RapidOCR a légèrement dépassé OnnxTR sur les mêmes pages.
Ensuite, vous préparez les images avant l’OCR : rotation, recadrage, redressement et agrandissement, tout en gardant chaque cadre sur l’original.
Leçon suivante : Préparation des images