
L'aide de l'IA pour l'automatisation de l'interface
- Leçon 23
- 35 min
- Module 7 : Assurance qualité assistée par l'IA et protection contre les régressions
Où nous en sommes
Dans les deux leçons précédentes, l'IA nous a aidés à trouver des idées de test et à trier des réponses. Toutes nos vérifications testent ce que dit l'assistant, avec l'exécuteur. Mais les clients utilisent une page Web, et la page aussi peut briser. Dans cette leçon, nous automatisons une vérification dans le navigateur, nous demandons à un assistant de la rendre robuste et nous révisons son travail comme du code de test.
Leçon 23 sur 24 · Tester les applications d'IA : assurance qualité manuelle et assistée par l'IAL'aide de l'IA pour l'automatisation de l'interface
1. Comment les fonctions d'IA échouent
2. Planifier et juger sans une seule bonne réponse
3. Explorer et reproduire
4. Rédiger des rapports de bogue utiles aux personnes
5. Rédiger des rapports qu'un agent de programmation peut corriger
6. Tester la recherche, les agents et la sécurité
7. Assurance qualité assistée par l'IA et protection contre les régressions
Ce que vous saurez faire
Automatisez une vérification dans le navigateur, comme un client utilise l’application Web. Gardez-la fonctionnelle à chaque exécution et chaque version. Vous enregistrez la vérification, demandez à un assistant de la rendre robuste, puis révisez son travail comme tout code de test. Durant ce processus, vous gardez les données clients hors des outils externes.
Avant de commencerCe qu’il faut savoir et avoir sous la main
L’exécution des étapes de cette leçon est facultative. Lisez-la au complet, car les compétences de révision s’appliquent à tous les tests qu’un assistant écrit. Exécutez les étapes si vous faites de l’automatisation de navigateur, ou souhaitez en faire.
Ce que vous devez savoir
- L’application Web, ses identifiants de trace et la graine, présentés dans Découvrir l’application de chasse aux bogues.
- BUG-004 (un message vide provoque une erreur du serveur), présenté dans Un modèle de rapport de bogue pour le comportement de l’IA.
- Comment lire un court fichier Python. Vous n’en écrivez pas : vous modifiez les lignes fournies dans la leçon.
Ce qu’il vous faut sur votre ordinateur
- Votre dossier de cours
ai-qa, avec l’environnement virtuel de l’application d’exercice actif danspractice-app. - Environ 1 Go d’espace disque libre et une connexion Internet. Sur macOS, Playwright et son navigateur occupaient environ 700 Mo.
- Deux terminaux : un pour l’application, un pour les vérifications.
Testé sur macOS (Apple silicon) avec Python 3.12.13, Playwright pour Python 1.64.0 et pytest 9.1.1. Le navigateur fonctionnait en mode sans fenêtre. L’étape d’enregistrement (codegen) ouvre une fenêtre de navigateur; elle n’a pas été exécutée pour cette leçon. Les commandes Windows et Linux n’ont pas été exécutées.
Une macro enregistrée qui modifie la mauvaise cellule
Section intitulée « Une macro enregistrée qui modifie la mauvaise cellule »Beaucoup d’employés de bureau ont déjà enregistré une macro dans un tableur. Vous sélectionnez la cellule B7, saisissez un total et le mettez en gras. L’enregistreur sauvegarde exactement cela : « aller à B7 ». Le mois suivant, le tableau compte une ligne de plus, et la macro écrase le chiffre du mois précédent avec le total. La macro a fait ce que vous avez fait. Elle n’a pas fait ce que vous vouliez : « la cellule sous la dernière ligne ».
Une vérification enregistrée dans le navigateur a la même faiblesse. L’enregistreur note ce qui était à l’écran à ce moment : ce numéro de trace, cette phrase exacte, cette version. L’exécution suivante se déroule à un autre moment.
Le problème : la vérification enregistrée échoue à la deuxième exécution
Section intitulée « Le problème : la vérification enregistrée échoue à la deuxième exécution »Esme enregistre une vérification de l’application Web avec Playwright, un outil gratuit qui contrôle un navigateur à partir d’un script. Son enregistreur, codegen, ouvre un navigateur et transforme chaque clic en une ligne de Python. Elle sélectionne le client de test, demande « Les cartes-cadeaux expirent-elles? », vérifie la réponse et ouvre sa trace.
Voici un exemple de ce que codegen écrit pour ces clics. Les détails de votre enregistrement seront différents.
page.goto("http://localhost:8730/")page.get_by_label("Test customer").select_option("C-1001")page.get_by_role("textbox", name="Message").click()page.get_by_role("textbox", name="Message").fill("Do gift cards expire?")page.get_by_role("button", name="Send").click()expect(page.get_by_role("log")).to_contain_text("Thanks for asking. Gift cards never expire and have no fees. [1] I hope this helps.")page.get_by_role("button", name="tr-0001-1").click()expect(page.locator("#trace")).to_contain_text("\"app_version\": \"2.3.0\"")Le fichier contient aussi quelques lignes avant et après celles-ci, pour démarrer et fermer le navigateur. Esme démarre l’application avec une graine fixe pour obtenir la même réponse chaque fois, puis exécute le script deux fois :
== run 1(no output: the check passed)== run 2playwright._impl._errors.TimeoutError: Locator.click: Timeout 30000ms exceeded.Call log: - waiting for get_by_role("button", name="tr-0001-1")L’application n’a rien fait de mal. La deuxième exécution a créé une deuxième conversation; sa réponse portait donc l’identifiant de trace tr-0002-1. Le script a attendu 30 secondes un bouton tr-0001-1, puis a échoué. Un test qui échoue alors que le logiciel fonctionne bien est une fausse alerte. Un test qui réussit parfois et échoue parfois, sans raison dans l’application, est dit instable. Après quelques fausses alertes, les gens cessent de lire les résultats, et le test ne protège plus rien.
L’idée : vérifiez ce que vous voulez, pas ce que vous avez vu
Section intitulée « L’idée : vérifiez ce que vous voulez, pas ce que vous avez vu »Une vérification robuste réussit quand la fonction marche et échoue seulement quand elle ne marche pas. Quatre habitudes rendent une vérification robuste :
- Trouvez les éléments comme une personne le fait. Un localisateur indique au script comment trouver un élément. Utilisez le rôle et le nom visible : « le bouton Send (envoyer) », « la zone nommée Message ». Évitez les noms qui changent, comme un numéro de trace.
- Vérifiez le fait, pas toute la phrase. La grille de ce cours demande le bon fait et une source, pas la salutation. Vérifiez donc « never expire » (n’expirent jamais) et un lien vers la politique sur les cartes-cadeaux.
- Partez d’un état connu. Sélectionnez le client de test, saisissez une graine et démarrez une nouvelle conversation. Ainsi, les anciens messages ne peuvent pas satisfaire la vérification.
- Ne fixez pas ce qui peut changer. « app_version 2.3.0 » échoue avec 2.3.1 sans qu’il y ait de bogue. Vérifiez que la trace ouverte appartient à cette réponse.
Chaque ligne fragile de l’enregistrement enfreint une de ces habitudes. L’image montre chaque ligne, la cause de son échec et une ligne robuste pour la remplacer.

Description textuelle du diagramme
Quatre rangées. Premièrement, le localisateur enregistré pour le bouton nommé tr-0001-1 : le numéro de trace augmente à chaque conversation. L’exécution 2 a donc attendu 30 secondes et a échoué. La ligne robuste trouve un bouton dont le nom correspond à tr-, chiffres, -1. Deuxièmement, la vérification de toute la réponse, « Thanks for asking. Gift cards never expire and have no fees. [1] I hope this helps. » : la salutation et la conclusion sont aléatoires. Avec une autre graine, la même bonne réponse échoue. Les lignes robustes saisissent 1 dans la zone Seed et vérifient seulement « never expire ». Troisièmement, la vérification de app_version 2.3.0 : elle est fixée à une seule version et échoue avec 2.3.1 sans bogue. La ligne robuste vérifie l’identifiant de trace de cette réponse. Quatrièmement, l’enregistrement n’a aucune étape pour démarrer une nouvelle conversation; les anciens messages peuvent donc satisfaire la vérification. Les lignes robustes sélectionnent New conversation et attendent exactement une réponse.
Demandez à un assistant de rendre la vérification robuste
Section intitulée « Demandez à un assistant de rendre la vérification robuste »Esme pourrait réécrire le script elle-même. Mais un assistant écrit ce genre de code en quelques secondes, et elle peut consacrer son temps à la révision. Avant de coller quoi que ce soit, elle cherche dans le script les données qui ne doivent pas quitter Larkfield. Puis elle fait sa demande.
D’abord : ce qui peut aller dans un outil externe
Section intitulée « D’abord : ce qui peut aller dans un outil externe »Un assistant sur Internet est un outil externe. Ce que vous collez quitte votre entreprise. L’outil peut le conserver ou l’utiliser selon ses propres conditions. Un enregistrement contient tout ce qui était à l’écran. Dans l’application d’exercice, ce sont uniquement des données de test : « C-1001 », un client fictif. Dans une vraie application, le même enregistrement pourrait contenir le nom, le numéro de commande et le courriel d’un vrai client.
| Vous pouvez coller (avec l’application d’exercice) | Ne collez jamais |
|---|---|
| Le script avec les clients de test (C-1001 à C-1004) et les commandes de test | Des enregistrements faits dans la boutique en production, avec les données de vrais clients |
| Le HTML de la page de l’application d’exercice | Des témoins, des jetons de session, des mots de passe et des clés d’API |
| Votre propre description du problème | Des fichiers de trace Playwright et des captures d’écran de vrais comptes : ils contiennent toutes les requêtes et tous les écrans |
| Les messages d’erreur de vos exécutions | Des adresses internes, sauf si votre entreprise les autorise |
Utilisez seulement les outils autorisés par votre entreprise, et enregistrez seulement avec des comptes de test. Si un script contient de vraies données, remplacez-les par des données de test avant de le coller. « Je les supprimerai ensuite » ne fonctionne pas : vous ne pouvez pas les supprimer de l’outil.
La requête et la réponse
Section intitulée « La requête et la réponse »Esme a collé le script enregistré et le HTML de la page, avec cette requête :
I am a tester. I recorded this browser test with Playwright codegen for the web page of our supportassistant (a practice app with test data only, on http://localhost:8730). It passed once, then failed when Iran it again. Please make it robust:- It must pass on every run, also when the app already has other conversations, and on the next versions of the app (2.3.1, 2.4.0).- It must still fail when the feature is broken: the reply must answer the gift card question, show its sources, and have a trace ID that opens the trace.- Make it a pytest test that I can run with `python -m pytest`. We do not use the pytest-playwright plugin.- Explain each change in one line.La réponse, enregistrée (modèle réel), provenait d’un modèle de clavardage hébergé; votre assistant répondra autrement. C’était un test d’environ 120 lignes, avec 14 explications d’une ligne. En voici quelques-unes, dans les mots du modèle :
- Explicit new conversation: Avoids dependence on existing server conversations without destructively resetting shared data.- Fixed seed: Removes the simulator's random default; it does not bypass checks on the generated reply.- Dynamic trace ID: Uses the ID returned for this reply rather than a counter-dependent recorded value.- Dynamic version check: Compares against the running app's version instead of requiring `2.3.0`.Ce sont de bonnes idées. Elles respectent les quatre habitudes. Mais une bonne explication n’est pas un test fonctionnel.
Révisez le résultat comme tout code de test
Section intitulée « Révisez le résultat comme tout code de test »Révisez un test écrit par l’IA comme celui d’un nouveau collègue : exécutez-le, lisez-le et faites-le échouer. L’image montre tout le parcours, de l’enregistrement à une vérification que vous conservez.
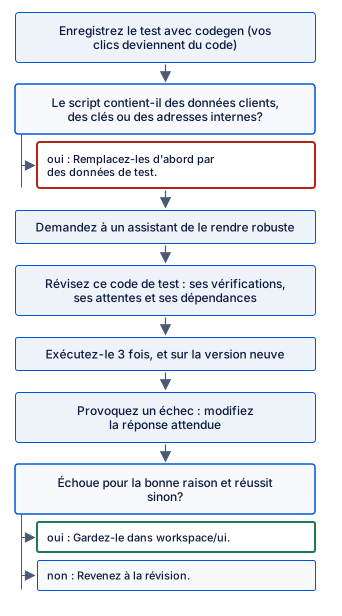
Description textuelle du diagramme
Enregistrez la vérification avec codegen pour transformer vos clics en code. Puis demandez-vous : le script contient-il des données clients, des clés ou des adresses internes? Si oui, remplacez-les d’abord par des données de test. Demandez ensuite à un assistant de rendre la vérification robuste. Révisez le résultat comme du code de test : ce qu’il vérifie, comment il attend et ce dont il dépend. Exécutez-le trois fois, puis sur la nouvelle version. Faites-le échouer une fois volontairement en changeant la réponse attendue. S’il échoue pour la bonne raison et réussit autrement, conservez-le dans workspace/ui. Sinon, revenez à la révision.
Exécutez-le trois fois
Section intitulée « Exécutez-le trois fois »Esme a sauvegardé le test de l’assistant et l’a exécuté trois fois sur 2.3.0, puis une fois sur 2.3.1. Il n’a jamais réussi. La première exécution a échoué ici :
> assert "error" not in trace_dataE AssertionError: assert 'error' not in {'trace_id': 'tr-0003-1', 'conversation_id': 'c-0003', 'turn': 1, 'app_version': '2.3.0', ...}L’assistant a supposé qu’une bonne trace n’a pas de champ error (erreur). Mais toutes les traces de l’application ont ce champ : il vaut "error": null quand rien n’a mal tourné. L’assistant n’avait jamais vu de trace. Il a écrit une vérification à partir d’une supposition erronée. Cette vérification échouerait pour toutes les bonnes réponses.
Les trois autres exécutions ont échoué plus tôt, à la première ligne qui utilise la page :
E playwright._impl._errors.TimeoutError: Locator.select_option: Timeout 15000ms exceeded.E Call log:E - waiting for get_by_label("Test customer", exact=True)L’assistant a ajouté exact=True pour « rendre les localisateurs exacts ». Mais la liste des clients de test se trouve à l’intérieur de son étiquette. Une fois la liste chargée, le texte de l’étiquette contient aussi le nom de chaque client. Le texte exact « Test customer » (client de test) ne correspond donc à rien. À la première exécution, la vérification a devancé la liste et a réussi cette ligne par chance. La version « robuste » était donc instable d’une nouvelle façon.
Lisez-le
Section intitulée « Lisez-le »La lecture des 120 lignes a révélé trois autres points :
- Il teste le fonctionnement interne de l’application, pas la page. Il attend les requêtes
/api/chatet/api/traces/..., lit leur JSON et vérifie le corps de la requête. Si Tomás renomme un champ de l’API, le test échoue, même si le client ne voit aucun changement. Une vérification dans le navigateur doit vérifier ce que le client voit. - Il installe sans préciser les versions :
python -m pip install pytest playwright. Le mois prochain, cette commande installera d’autres versions. Fixez-les, comme le fait le cours. - Il est long. Chaque ligne est du code que quelqu’un devra lire et corriger plus tard. Un test cinq fois plus long que l’enregistrement représente un coût, pas une qualité.
Aucun de ces points ne demande de compétences en programmation. Ils demandent les questions qu’une personne qui teste pose à tout test. Que vérifie-t-il? De quoi dépend-il? Peut-il échouer pour la mauvaise raison?
Gardez les bonnes idées, écrivez la version courte
Section intitulée « Gardez les bonnes idées, écrivez la version courte »Esme a gardé les deux meilleures idées de l’assistant : la zone Seed et le bouton New conversation. Elle a laissé tomber le reste et écrit la vérification selon les quatre habitudes :
def open_new_conversation(page, seed):    page.goto(URL)    page.get_by_label("Test customer").select_option("C-1001")    page.get_by_label("Seed").fill(seed)    page.get_by_role("button", name="New conversation").click()

def send(page, text):    page.get_by_role("textbox", name="Message").fill(text)    page.get_by_role("button", name="Send").click()

def test_reply_shows_answer_source_and_trace():    with sync_playwright() as p:        browser = p.chromium.launch()        page = browser.new_page()        open_new_conversation(page, "1")        send(page, "Do gift cards expire?")
        reply = page.locator(".msg.bot")        expect(reply).to_have_count(1)        expect(reply).to_contain_text("never expire")        expect(reply.get_by_role("link")).to_have_attribute("href", re.compile(r"^/policies/gift-cards/"))
        trace_button = reply.get_by_role("button", name=re.compile(r"^tr-\d+-1$"))        trace_id = trace_button.inner_text()        trace_button.click()        expect(page.locator("#trace")).to_contain_text(f'"trace_id": "{trace_id}"')        browser.close()
expect(...) attend automatiquement la page jusqu’à 5 secondes; la vérification n’a donc besoin d’aucune pause fixe. launch() sans options démarre le navigateur sans fenêtre. Le début du fichier définit URL (par défaut http://localhost:8730) et importe re, expect et sync_playwright.
Exécutez la vérification robuste
Section intitulée « Exécutez la vérification robuste »-
Installez Playwright et pytest dans l’environnement de l’application d’exercice :
Fenêtre de terminal python -m pip install pytest==9.1.1 playwright==1.64.0python -m playwright install chromiumLa deuxième commande télécharge un navigateur pour Playwright. Cela peut prendre quelques minutes.
-
Copiez le dossier
uidu cours, depuis l’étapeend-of-m07, dans votre espace de travail. Danspractice-app:Fenêtre de terminal cp -R ../workspace/snapshots/end-of-m07/ui ../workspace/Fenêtre de terminal Copy-Item -Recurse ..\workspace\snapshots\end-of-m07\ui ..\workspace\Fenêtre de terminal cp -R ../workspace/snapshots/end-of-m07/ui ../workspace/Si vous avez fait votre propre enregistrement, gardez-le à côté de ces fichiers.
-
Dans un deuxième terminal, dans
practice-appavec l’environnement actif, démarrez l’application :Fenêtre de terminal python -m helpdesk serve -
Dans le premier terminal, dans
practice-app, exécutez les vérifications trois fois :Fenêtre de terminal for i in 1 2 3; do python -m pytest ../workspace/ui/test_chat_ui.py; doneFenêtre de terminal foreach ($i in 1,2,3) { python -m pytest ..\workspace\ui\test_chat_ui.py }Fenêtre de terminal for i in 1 2 3; do python -m pytest ../workspace/ui/test_chat_ui.py; doneLa fin de chaque exécution, simulée (application d’exercice) :
FAILED ../workspace/ui/test_chat_ui.py::test_empty_message_gets_a_reply_not_an_error========================= 1 failed, 1 passed in 5.91s ==========================
La première vérification a réussi lors des trois exécutions. Le fichier contient aussi une deuxième vérification, pour BUG-004, que vous écrivez dans « À vous de jouer ». Elle échoue sur 2.3.0 parce que le bogue est présent : c’est correct. Vos durées seront différentes.
Faites-la échouer volontairement
Section intitulée « Faites-la échouer volontairement »Une vérification qui ne peut pas échouer est pire qu’aucune vérification : elle donne une fausse confiance. Rendez donc la réponse attendue incorrecte une fois, et observez l’échec.
-
Dans
test_chat_ui.py, remplacez"never expire"par"expire after 2 years"(expirent après 2 ans). Sauvegardez le fichier. -
Exécutez seulement la première vérification.
-k answersélectionne les vérifications dont le nom contient « answer » (réponse) :Fenêtre de terminal python -m pytest ../workspace/ui/test_chat_ui.py -k answerLa fin de la sortie :
E Actual value: Good question. Gift cards never expire and have no fees. [1]EE Sources:E [1] Gift cards, version 1: Using a gift card (/policies/gift-cards/v1#using-a-gift-card)trace tr-0007-1 | conversation c-0007 | seed 1...FAILED ../workspace/ui/test_chat_ui.py::test_reply_shows_answer_source_and_trace======================= 1 failed, 1 deselected in 5.44s ======================== -
Remettez le texte à
"never expire"et sauvegardez.
La vérification a échoué pour la bonne raison, et le message montre toute la réponse. La personne qui le lit voit immédiatement ce que l’application a dit. Vos numéros de trace et de conversation seront différents.
Exécutez-la sur la nouvelle version
Section intitulée « Exécutez-la sur la nouvelle version »Dans le deuxième terminal, arrêtez l’application avec Ctrl+C. Démarrez la version 2.3.1 depuis son propre dossier : cd ../releases/2.3.1, puis python -m helpdesk serve. Exécutez de nouveau les vérifications dans le premier terminal :
../workspace/ui/test_chat_ui.py ..                                       [100%]
============================== 2 passed in 0.90s ===============================
Les deux vérifications réussissent sur 2.3.1, deux fois de suite. La vérification robuste ne dépend pas de la version. Celle de BUG-004 réussit maintenant, car 2.3.1 a corrigé le bogue. Arrêtez l’application quand vous avez terminé, puis revenez avec cd ../../practice-app.
Quand automatiser dans le navigateur, et à quel coût
Section intitulée « Quand automatiser dans le navigateur, et à quel coût »Une vérification dans le navigateur est lente et demande de l’attention. Chacune démarre un navigateur et cesse de fonctionner quand la page change, même si les réponses de l’assistant restent identiques. Les cas YAML de l’exécuteur vérifient les mêmes réponses en une fraction du temps. Donc :
- Utilisez l’exécuteur pour ce que l’assistant dit : faits, sources, outils, refus. Cela représente la plupart de vos vérifications.
- Utilisez le navigateur pour ce que seule la page montre : le message d’erreur que voit le client, le lien de trace, les liens vers les sources. Limitez le nombre de ces vérifications et gardez-les courtes.
Un assistant réduit la saisie, pas la révision. Dans cette leçon, l’assistant a écrit environ 120 lignes en quelques secondes. Deux de ses suppositions ont fait échouer le test. La révision a pris plus de temps que l’écriture. C’est normal, et cette partie ne peut pas être omise. Pour savoir comment les développeurs révisent le code écrit par l’IA, consultez Examiner les différences dans Développement logiciel assisté par l’IA.
Erreur courante
La vérification ne peut pas accéder à l'application
Symptôme : toutes les vérifications échouent à la première ligne, avec une erreur qui indique l’adresse :
E playwright._impl._errors.Error: Page.goto: net::ERR_CONNECTION_REFUSED at http://localhost:8730/Cause : l’application ne fonctionne pas, ou elle utilise un autre port.
Diagnostic : regardez le deuxième terminal. Il doit afficher Larkfield help desk ... on http://localhost:8730 (service de soutien Larkfield… à l’adresse http://localhost:8730).
Solution : démarrez l’application avec python -m helpdesk serve. Si elle utilise un autre port, indiquez-le à la vérification : HELPDESK_URL=http://localhost:8731 python -m pytest ... sur macOS et Linux, ou d’abord $env:HELPDESK_URL = "http://localhost:8731" sur Windows.
Erreur courante
Une vérification réussit seule et échoue en boucle
Symptôme : une vérification réussit au premier essai et échoue aux suivants, ou l’inverse. L’application n’a pas changé.
Cause : la vérification dépend d’un élément qui change entre les essais : un compteur (tr-0001-1), une salutation aléatoire, les données laissées par le dernier essai ou la vitesse de chargement de la page (le libellé avec exact=True ci-dessus).
Diagnostic : exécutez-la trois fois de suite et lisez la première ligne en échec. Demandez-vous : « Qu’est-ce qui était différent lors de cet essai? »
Solution : appliquez les quatre habitudes : un localisateur stable, le fait plutôt que la phrase, un état initial connu, aucune valeur variable fixée. Ne la « corrigez » jamais avec une pause fixe comme wait_for_timeout(5000). Cela ralentit chaque essai et échoue quand même si le chargement est lent.
À vous de jouer : une vérification dans le navigateur pour BUG-004
Section intitulée « À vous de jouer : une vérification dans le navigateur pour BUG-004 »Sur la version 2.3.0, un message contenant seulement une espace affiche « Error 500: Internal Server Error » (erreur 500 : erreur interne du serveur) dans la conversation (BUG-004). Seule la page montre ce problème. Écrivez une deuxième vérification pour ce cas. Cela prend environ 10 minutes.
- Dans
test_chat_ui.py, ajoutez une fonctiontest_empty_message_gets_a_reply_not_an_error. Utilisezopen_new_conversation(page, "1")etsend(page, " "). - Vérifiez qu’une seule réponse apparaît et qu’elle ne contient pas « Error » (erreur).
not_to_contain_textest l’inverse deto_contain_text. - Faites une prédiction : sur la version 2.3.0, la vérification réussit-elle ou échoue-t-elle? Et sur la version 2.3.1?
- Exécutez-la sur les deux versions, trois fois chacune.
Vérifiez votre travail
def test_empty_message_gets_a_reply_not_an_error():    with sync_playwright() as p:        browser = p.chromium.launch()        page = browser.new_page()        open_new_conversation(page, "1")        send(page, " ")
        reply = page.locator(".msg.bot")        expect(reply).to_have_count(1)        expect(reply).not_to_contain_text("Error")        browser.close()
Sur la version 2.3.0, elle échoue à chaque essai, avec le message du bogue lui-même :
E AssertionError: Locator expected not to contain text 'Error'E Actual value: Error 500: Internal Server ErrorSur la version 2.3.1, elle réussit à chaque essai : la réponse est « Please type your question. » (Veuillez saisir votre question.).
Pourquoi commencer par to_have_count(1)? Sans cette étape, la vérification pourrait s’exécuter avant qu’une réponse existe. « Aucune réponse ne contient Error » est alors vrai, et la vérification réussit sur une application défectueuse. Attendre exactement une réponse fait échouer la vérification pour la bonne raison. Pourquoi ne pas vérifier la présence de « Please type your question. »? Cela fixerait une formulation précise; la règle est « une réponse, pas une erreur ».
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
La vérification enregistrée a réussi au premier essai et échoué au deuxième, sans changement à l'application. Nommez la cause et deux autres lignes de l'enregistrement qui cesseraient aussi de fonctionner plus tard.
Afficher la réponse
L’enregistrement cherchait le bouton tr-0001-1. Le deuxième essai a créé une deuxième conversation, avec tr-0002-1. Le localisateur n’a donc rien trouvé et a atteint le délai maximal après 30 secondes. Deux autres lignes cesseraient de fonctionner. La vérification de la phrase entière échoue avec une autre graine aléatoire, car la salutation et la conclusion sont aléatoires. La vérification de "app_version": "2.3.0" échoue sur la version 2.3.1, sans aucun bogue. Une quatrième faiblesse : elle ne démarre jamais une nouvelle conversation, donc d’anciens messages peuvent correspondre.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Le test de l'assistant expliquait bien chaque changement. Pourquoi a-t-il quand même échoué, et qu'avez-vous fait pour trouver les problèmes?
Afficher la réponse
Il a écrit deux vérifications à partir de suppositions sur une application qu’il n’avait jamais exécutée. Il supposait qu’une trace correcte n’a pas de champ error (erreur), mais chaque trace contient "error": null. Il a ajouté exact=True au libellé du client. Mais une fois la liste chargée, le texte du libellé contient aussi les noms des clients. Le localisateur trouvait donc une correspondance seulement quand la page était lente. Exécuter le test trois fois a révélé les deux problèmes. La lecture a révélé un troisième problème : il vérifie les requêtes API de l’application, pas ce que le client voit.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Un collègue veut coller une vérification enregistrée dans la boutique en production dans un assistant en ligne, « seulement pour corriger les localisateurs ». Que vérifiez-vous d'abord, et que lui dites-vous?
Afficher la réponse
Vérifiez le contenu de l’enregistrement : noms, courriels et numéros de commande de vrais clients, ainsi que témoins, jetons, clés ou adresses internes. Un enregistrement de la boutique en production contient ce qui était à l’écran. Dites-lui d’enregistrer avec des comptes de test, ou de remplacer chaque valeur réelle par des données de test avant de coller quoi que ce soit. Et d’utiliser seulement les outils que l’entreprise autorise. Supprimer le contenu après coup ne règle pas le problème. Les fichiers de trace et les captures d’écran de vrais comptes ne doivent jamais être envoyés à un outil externe.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une vérification enregistrée consigne un moment précis : un numéro de trace, une phrase, une version. Elle échoue quand ces éléments changent.
- Une vérification robuste trouve les éléments par rôle et libellé, vérifie le fait plutôt que la phrase, part d’un état connu et ne fixe aucune valeur qui peut changer.
- Un assistant peut réécrire une vérification en quelques secondes. Révisez le résultat comme du code de test. Exécutez-le trois fois, lisez de quoi il dépend, faites-le échouer une fois et exécutez-le sur la nouvelle version. Ici, la version de l’assistant n’a jamais réussi.
- Collez seulement des données de test dans un outil externe. Ne collez jamais de données de clients, de témoins, de clés ou de fichiers de trace.
- Utilisez les vérifications dans le navigateur seulement pour ce que la page montre. Utilisez l’exécuteur pour ce que l’assistant dit.
Votre espace de travail contient maintenant les fichiers précédents, plus ui/recorded_check.py (l’enregistrement), ui/test_chat_ui.py (deux vérifications robustes) et ui/README.md. Ensuite, vous transformerez tous vos constats en jeu de non-régression et déciderez si la version 2.3.1 peut être publiée.
Leçon suivante : Des constats au jeu de non-régression et à la validation de version