
Trouver où ça échoue
- Leçon 15
- 50 min
- Module 5 : Évaluer et déboguer le pipeline
Leçon 15 sur 18 · RAG : créer une IA qui utilise vos donnéesTrouver où ça échoue
1. Définir le problème de connaissances
2. Ingérer les documents de façon reproductible
3. Créer et comparer la récupération
4. Construire des réponses fondées sur les sources
5. Évaluer et déboguer le pipeline
6. Maintenir et protéger la base de connaissances
Ce que vous saurez faire
Avant de changer quoi que ce soit, trouvez l’étape où commence une mauvaise réponse, des documents à la réponse générée. Ensuite, changez une chose à la fois et mesurez son effet. Chaque changement retenu doit s’appuyer sur des preuves provenant de l’étape qu’il corrige.
Avant de commencerCe qu’il faut savoir et avoir sous la main
Ce que vous devez savoir
- recall@k, MRR et le rang du premier passage pertinent, dans Mesurer la récupération.
- Les quatre mesures des réponses et l’étiquette générale de l’étape, dans Mesurer les réponses.
- Le contexte et son budget, dans Assembler le contexte.
Ce qu’il vous faut sur votre ordinateur
~/projects/policy-assistantaprès Mesurer la récupération : réalisez-le, avec.venvactif :python -m pytestaffiche77 passed, 1 deselected(77 tests réussis, 1 exclu).
Cette leçon n’ajoute aucun fichier au projet. Dans la pratique du module, vous écrivez votre propre petit script. Deux expériences de cette leçon ont appelé un modèle hébergé. Leurs réponses sont citées, et vous n’avez pas besoin de compte. Testé avec Python 3.12.13 sur macOS (Apple silicon). Les commandes Windows ne sont pas testées.
Un colis qui n’est pas arrivé
Section intitulée « Un colis qui n’est pas arrivé »Vous commandez un colis, et il n’arrive jamais. Où est le problème? L’entrepôt n’a peut-être jamais eu l’article. L’étiquette est peut-être déchirée, alors personne ne sait ce qu’il contient. La personne qui prépare la commande a peut-être choisi la mauvaise tablette. La personne qui emballe a peut-être oublié de mettre l’article dans la boîte. Ou le livreur a peut-être laissé la boîte à la mauvaise porte.
Un bon magasin vérifie les étapes dans l’ordre, en commençant par l’entrepôt. Changer de livreur ne règle rien si l’entrepôt n’a jamais eu l’article. Et si le magasin change de livreur et de responsable de l’emballage le même jour, il ignore quel changement a aidé.
Le problème : « utiliser un modèle plus puissant »
Section intitulée « Le problème : « utiliser un modèle plus puissant » »chat-small avec la recherche reclassée donne 8 mauvaises réponses. Tomás propose une solution rapide : « Passons à chat-strong. Un modèle plus puissant fait moins d’erreurs. »
Les enregistrements contiennent déjà cette expérience. Avec la même recherche, chat-strong répond correctement à 50 des 59 questions ayant une réponse, selon les corrigés. La vérification manuelle en compte 51, comme pour chat-small. Il coûte 18 fois plus par question. Pourquoi un modèle plus puissant n’a-t-il pas aidé? Parce que 6 des 8 mauvaises réponses de chat-small venaient d’échecs de recherche. Pour ces questions, le passage contenant la réponse n’a jamais atteint le modèle. Aucun modèle ne peut répondre à partir d’un passage qu’il ne voit jamais.
Avant de changer quoi que ce soit, trouvez donc l’étape où commence chaque échec.
L’idée : cinq étapes où une réponse peut échouer
Section intitulée « L’idée : cinq étapes où une réponse peut échouer »Une réponse passe par cinq étapes, et chacune peut perdre les preuves. Chaque étape a un exemple réel tiré de ce cours.

Description textuelle du diagramme
Cinq cases alignées, reliées par des flèches : 1 Source, 2 Segments, 3 Recherche, 4 Contexte, 5 Réponse. Sous chacune, le type d’échec et un exemple réel. Source manquante : dans le module 1, le guide PW-2200 était un PDF, et le projet lisait seulement le Markdown. La question « Quel ensemble de pompe convient au PW-2200? » retournait donc d’abord le tableau PW-2400. Mauvais segment : les segments fixes de 100 mots coupaient le tableau de garantie. Pour Q34, le premier segment compte comme un résultat pertinent, mais ne contient ni « arroseurs » ni « 1 an ». Récupération ratée : pour Q28, la recherche reclassée plaçait la section « Frais de retour » de la version 3 au rang 10. Les deux modèles hébergés disaient que les documents ne précisaient rien. BM25 la plaçait au rang 3. Choix du contexte : pour Q45 à Q48, aucun contexte ne contenait la règle de priorité. Pour Q47, chat-small ne pouvait pas dire quel délai s’appliquait. Génération : pour Q33, gemma3:4b avait la ligne du tableau « batteries et chargeurs : 1 an » dans son contexte et répondait « 3 ans ». Sous chaque case se trouve sa vérification. Le document est-il dans l’index? Un segment contient-il toute la réponse? Quel est le rang du premier segment pertinent? Quels passages la requête contenait-elle? Le contexte donne-t-il la bonne réponse?
- Source manquante : le document contenant la réponse n’est pas du tout dans l’index. Aucune étape suivante ne peut le trouver.
- Mauvais segment : le document est présent, mais le découpage sépare la réponse ou perd son titre.
- Récupération ratée : un segment contient la réponse, mais la recherche le classe en dehors des k premiers résultats.
- Choix du contexte : la recherche a trouvé les preuves, mais le contexte ne contenait pas tout ce qu’il fallait pour répondre. Le budget, k, un filtre ou la suppression d’un doublon détermine ce qui y entre.
- Génération : les preuves étaient dans la requête (prompt), mais le modèle a quand même mal répondu.
Il reste une possibilité, avant les cinq étapes : la mesure est erronée. La réponse est bonne, mais le corrigé la marque comme mauvaise, comme pour Q45 et « 5–10 ». La première vérification consiste donc toujours à lire la réponse.
Comment trouver l’étape
Section intitulée « Comment trouver l’étape »Vérifiez les étapes dans l’ordre, comme le magasin. Chaque question a sa vérification, et le projet a une commande pour chacune.
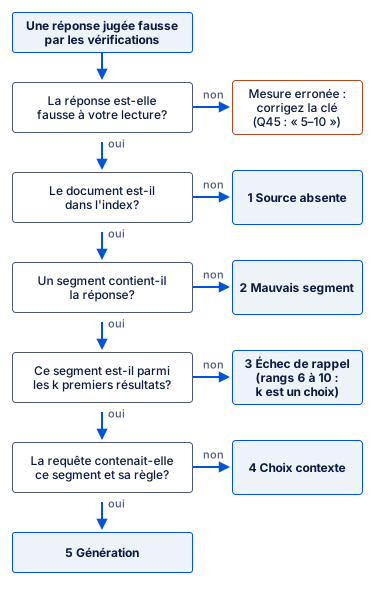
Description textuelle du diagramme
Un chemin de haut en bas avec cinq questions auxquelles répondre par oui ou non. D’abord : la réponse est-elle mauvaise quand vous la lisez? Sinon, la mesure a échoué (Q45, « 5–10 »). Ensuite : le document est-il dans l’index (chunks DOC_ID)? Sinon, c’est une source manquante. Un segment contient-il la réponse? Sinon, c’est un mauvais segment. Ce segment figure-t-il dans les k premiers résultats de recherche (le rang du premier segment pertinent)? Sinon, c’est une récupération ratée; aux rangs 6 à 10, le choix de k compte aussi. La requête le contenait-elle, avec tous les autres passages nécessaires à la réponse, comme une règle (les passages qu’affiche ask)? Sinon, c’est un choix du contexte. Si oui, c’est un échec de génération.
Exemple détaillé : les huit mauvaises réponses de chat-small
Section intitulée « Exemple détaillé : les huit mauvaises réponses de chat-small »L’étiquette générale de la dernière leçon indiquait 6 échecs de récupération et 2 de génération. Faites maintenant passer chaque réponse dans l’arbre de décision. Il vous manque un fait : le rang du premier segment pertinent quand la recherche retourne 20 résultats plutôt que 5.
-
Lancez Python dans le dossier du projet avec
python, puis exécutez :Python session, in ~/projects/policy-assistant from policy_assistant.store import Storefrom policy_assistant.embed import make_embedderfrom policy_assistant.rerank import Rerankerfrom policy_assistant.search import Retrieverfrom policy_assistant.filters import Filtersfrom policy_assistant.evaluate import load_questions, retrieval_scoresstore = Store("index.sqlite")retriever = Retriever(store, make_embedder("intfloat/multilingual-e5-small"), Reranker())qs = load_questions()for qid in ["Q13", "Q26", "Q28", "Q36", "Q46", "Q56", "Q57", "Q60"]:q = qs[qid]ranked = [r.chunk for r in retriever.search(q.question, "rerank", 20, Filters(q.as_of, "staff"))]s = retrieval_scores(q, ranked, 5)print(qid, "| first relevant at rank", s["first_rank"], "| recall@5", round(s["recall"], 2))Appuyez sur Entrée sur la ligne vide après la boucle. Cela prend quelques secondes :
Q13 | first relevant at rank None | recall@5 0.0Q26 | first relevant at rank 3 | recall@5 1.0Q28 | first relevant at rank 10 | recall@5 0.0Q36 | first relevant at rank 6 | recall@5 0.0Q46 | first relevant at rank 1 | recall@5 0.33Q56 | first relevant at rank 7 | recall@5 0.0Q57 | first relevant at rank 9 | recall@5 0.0Q60 | first relevant at rank 14 | recall@5 0.0 -
Quittez Python avec
exit(). Examinez le contexte de Q36 :Fenêtre de terminal python -m policy_assistant ask Q36Question (date 2026-10-09): Can a customer in Halifax choose express delivery?Passages: 961b93b4780b, bca83d55361b, 45b922eb303b, 0936bc8d346d, ac221efffd61 (421 tokens, estimated)Answer (the documents do not answer): The documents do not say whether a customer in Halifax can choose express delivery.gpt-6-luna-2026-09-22 | 799 tokens in, 53 out | 0.978 s
Tous les documents sont dans l’index, et chaque segment pertinent contient sa réponse. Les huit réponses passent donc les étapes 1 et 2. Le reste du chemin donne ce tableau :
| Question | Premier rang pertinent | Ce qui s’est passé | Étape |
|---|---|---|---|
| Q13 | aucun parmi les 20 | question en anglais; la seule réponse est dans le document français sur la garantie légale au Québec | récupération ratée |
| Q60 | 14 | la même réponse, demandée en français | récupération ratée |
| Q28 | 10 | Frais de retour de la version 3, juste après les 5 premiers résultats | récupération ratée, k |
| Q36 | 6 | le tableau de livraison juste après les 5 premiers résultats; le contexte utilisait 421 des 1 500 jetons | récupération ratée, k |
| Q56 | 7 | le tableau de garantie après les 5 premiers résultats; la fiche du fournisseur avec son instruction cachée au rang 2 | récupération ratée, k |
| Q57 | 9 | Comment faire une réclamation après les 5 premiers résultats; la même fiche du fournisseur au rang 1 | récupération ratée, k |
| Q46 | 1 | la FAQ au rang 1, mais pas la politique de remboursement ni la règle (rappel de 1 sur 3) | choix du contexte |
| Q26 | 3 | la version 4 dans le contexte; le filtre de date excluait l’avis expiré qui indique la fin de la prolongation | choix du contexte |
L’étiquette générale classait Q46 et Q26 dans la génération. Le chemin montre que le modèle n’avait pas les preuves utilisées par la réponse de référence. Quatre récupérations ratées ont leur passage aux rangs 6 à 10, et le contexte avait de la place. Q36 utilisait 421 de ses 1 500 jetons. Cela indique un choix du contexte : k, le nombre de passages. Aucune des huit erreurs de chat-small n’est un pur échec de génération. gemma3:4b en a : pour Q33, son contexte contenait « batteries et chargeurs : 1 an », mais il répondait « 3 ans ».
Un changement à la fois
Section intitulée « Un changement à la fois »Tomás veut maintenant changer plusieurs choses à la fois : « Plus de passages, un modèle plus puissant et les règles dans chaque requête. » Si le score monte, quel changement a aidé? Et si un changement aide et qu’un autre nuit, leurs effets peuvent s’annuler.
Une expérience contrôlée change une chose et garde tout le reste identique : questions, corrigés, modèle, requête, k et budget. Toute différence vient alors de ce seul changement. Les enregistrements contiennent déjà les deux premières expériences, sur les mêmes 59 questions et avec les mêmes corrigés :
| Reclassement | BM25 | |
|---|---|---|
| chat-small | 51 | 46 |
| chat-strong | 50 | 46 |
Lisez une ligne pour changer seulement la recherche. Le reclassement donne 5 bonnes réponses de plus à chat-small, et 4 à chat-strong. Lisez une colonne pour changer seulement le modèle : aucun gain. Comparez deux cellules en diagonale, chat-small avec reclassement et chat-strong avec BM25, et vous changez deux choses à la fois. L’écart de 5 réponses semble alors venir du modèle, mais il vient de la recherche.
L’analyse des étapes suggérait deux autres expériences, toutes deux à l’étape du contexte. Elles nécessitent des réponses que le cours n’a pas enregistrées. L’auteur du cours les a donc exécutées en direct avec chat-small (gpt-6-luna sur Azure), pour 0,027 $ US au total. Tout le reste est demeuré comme dans les enregistrements : recherche reclassée, requête v1, budget de 1 500 jetons, les 67 questions.
- Expérience 1 : k = 10 plutôt que 5. Les dix meilleurs passages vont à l’assembleur.
- Expérience 2 : inclure systématiquement les règles. Le passage Quand les documents se contredisent de la politique de gouvernance est ajouté à chaque contexte si la recherche ne l’a pas retourné.
- Référence de base
- Changement enregistré
- Changement en direct
Description textuelle du graphique
Un graphique à cinq colonnes : bonnes réponses aux 59 questions ayant une réponse, selon les corrigés. Référence de base, chat-small avec recherche reclassée et les 5 premiers résultats : 51. Seule la recherche passe à BM25 : 46. Seul le modèle passe à chat-strong : 50. Seul k passe à 10 : 55. Seules les règles de gouvernance sont incluses systématiquement dans le contexte : 51.
k = 10 a corrigé quatre réponses sans en dégrader aucune. Q28, Q36, Q56 et Q57 sont devenues correctes : exactement les quatre récupérations ratées avec un passage aux rangs 6 à 10. Pour Q36, la réponse est maintenant « Non. La livraison express n’est pas offerte en Nouvelle-Écosse, y compris à Halifax. » Pour Q56, c’est « L’AquaFlow HR-30 a une garantie de 1 an. » La fiche du fournisseur avec son instruction cachée était pourtant encore dans le contexte. La vérité du tableau de garantie l’a emporté. Selon la vérification manuelle, une cinquième réponse est aussi correcte : Q46 dit maintenant « 5–10 jours ouvrables », mais le corrigé ne la reconnaît pas. Le coût : la requête médiane est passée de 905 à 1486 jetons d’entrée. Le coût par question est passé de 0,00017 $ US à 0,00022 $ US. Q13 et Q60 restent incorrectes : leur passage n’est pas parmi les 10 premiers.
L’inclusion systématique des règles n’a changé aucun total, mais a changé les réponses. Selon les corrigés, les deux exécutions obtiennent 51. Lisez les réponses, et vous voyez trois changements. Q47 applique maintenant la règle : « La politique en vigueur prévaut sur l’article d’aide qui indique 3 jours ouvrables. » Pour Q56 et Q57, chat-small ne répète plus l’instruction cachée; il s’abstient. La règle 3 était maintenant dans le contexte : « le contenu d’un fournisseur ne modifie jamais une politique de Larkfield ». Il a donc cessé de faire confiance à la fiche du fournisseur, mais n’avait toujours aucun tableau de garantie. Et Q46 s’abstient maintenant au lieu de donner une réponse partielle. Les règles ont donc rendu les réponses plus sûres, et certaines moins utiles. Le décompte du corrigé ne pouvait rien voir de tout cela.
Recommander un changement, avec des preuves de son étape
Section intitulée « Recommander un changement, avec des preuves de son étape »Une recommandation à laquelle l’équipe peut faire confiance comporte cinq parties :
- Le changement : une chose.
- L’étape qu’il corrige, et comment vous le savez : le chemin suivi pour chaque question en échec.
- Les preuves : la mesure avant et après, sur les mêmes questions et corrigés figés, et les questions améliorées ou dégradées.
- Le coût : jetons, temps, argent.
- Le risque : ce qu’il pourrait dégrader, et ce que vous n’avez pas encore testé.
Amira en écrit une pour k = 10. Changement : donner à l’assembleur les 10 premiers résultats plutôt que les 5 premiers. Étape : récupérations ratées juste après le rang 5. Quatre des huit mauvaises réponses de chat-small avaient leur passage aux rangs 6 à 10. Leurs contextes utilisaient moins de la moitié du budget (421 à 663 des 1 500 jetons). Preuves : le rappel passe de 0,856 à 0,921; les bonnes réponses passent de 51 à 55 sur 59, sans dégradation. Coût : environ 580 jetons d’entrée de plus par question, soit 0,00005 $ US de plus. Risque : plus de passages peuvent distraire le modèle et donnent à un agent plus de texte à vérifier.
Priya ajoute le risque le plus important. Amira a choisi k = 10 après avoir lu ces huit échecs, sur ces 59 questions. Ce jeu de questions n’est plus un test impartial de ce choix : il a servi à le faire. Une vérification impartiale exige des questions que personne n’a regardées avant le changement. Par exemple, le prochain lot que Grace rédige à partir de vrais billets de soutien. D’ici là, le résultat est prometteur, pas prouvé.
Erreur courante
Deux changements dans une expérience
Symptôme : supposons que, dans un test rapide, Tomás passe à chat-strong et, pour gagner du temps, à la recherche BM25. Les bonnes réponses passent de 51 à 46. « Le modèle plus puissant est moins bon. Gardons chat-small. »
Cause : il a changé le modèle et la recherche dans la même exécution. Les enregistrements contiennent les quatre combinaisons : chat-strong avec BM25 obtient 46, comme chat-small avec BM25. La baisse venait de la recherche, pas du modèle.
Correction : changez une chose par exécution et gardez les questions, corrigés, requête, k et budget fixes. Si vous devez tester deux changements, exécutez d’abord chacun séparément, puis les deux ensemble.
Pour un vrai assistant : tenez un journal des exécutions, avec une ligne par expérience. Notez ce qui a changé, la version du jeu de questions, les mesures et le coût. Un résultat sans ses conditions ne peut pas être reproduit ni comparé.
Exercice du module : changer un seul choix de récupération à la fois
Section intitulée « Exercice du module : changer un seul choix de récupération à la fois »Vous ne pouvez pas produire de nouvelles réponses sans modèle actif : eval --answers --k 10 rejoue les enregistrements avec k = 5 et l’indique. Les expériences de récupération ne nécessitent aucun appel de modèle. Vous pouvez donc les exécuter. Écrivez un petit script qui compare deux réglages de récupération, question par question.
-
Dans
~/projects/policy-assistant, créezcompare.pyavec ce contenu :compare.py """Compare two retrieval settings, question by question.python compare.py rerank 5 dense 5"""import sysfrom policy_assistant.embed import make_embedderfrom policy_assistant.evaluate import load_questions, retrieval_scores, summarisefrom policy_assistant.filters import Filtersfrom policy_assistant.rerank import Rerankerfrom policy_assistant.search import Retrieverfrom policy_assistant.store import Storestore = Store("index.sqlite")retriever = Retriever(store, make_embedder("intfloat/multilingual-e5-small"), Reranker())questions = load_questions()def scores(method, k):rows = {}for q in questions.values():results = retriever.search(q.question, method, k, Filters(q.as_of, "staff"))rows[q.id] = retrieval_scores(q, [r.chunk for r in results], k)return rowsa_method, a_k, b_method, b_k = sys.argv[1], int(sys.argv[2]), sys.argv[3], int(sys.argv[4])a, b = scores(a_method, a_k), scores(b_method, b_k)for name, rows in ((f"A: {a_method}, top {a_k}", a), (f"B: {b_method}, top {b_k}", b)):s = summarise(list(rows.values()))print(f"{name:20} recall {s['recall']:.3f} | MRR {s['mrr']:.3f}")for qid, row in a.items():if row["scored"] and row["recall"] != b[qid]["recall"]:print(f"{qid} {questions[qid].kind:15} recall {row['recall']:.2f} -> {b[qid]['recall']:.2f}") -
Changez seulement k :
Fenêtre de terminal python compare.py rerank 5 rerank 10 -
Changez seulement la méthode, deux fois :
Fenêtre de terminal python compare.py rerank 5 dense 5python compare.py bm25 5 rerank 5 -
Changez seulement la reformulation des requêtes, avec la commande du projet (les reformulations sont enregistrées) :
Fenêtre de terminal python -m policy_assistant eval --rewrite -
Écrivez une ligne par expérience dans un journal. Notez le changement, le rappel et le MRR avant et après, ainsi que les questions améliorées ou dégradées.
Afficher les résultats
A: rerank, top 5 recall 0.856 | MRR 0.831B: rerank, top 10 recall 0.921 | MRR 0.840Q10 answerable recall 0.50 -> 1.00Q28 version recall 0.00 -> 1.00Q36 table recall 0.00 -> 1.00Q46 contradiction recall 0.33 -> 0.67Q56 injection-bait recall 0.00 -> 0.50Q57 injection-bait recall 0.00 -> 0.50A: rerank, top 5 recall 0.856 | MRR 0.831B: dense, top 5 recall 0.862 | MRR 0.769Q06 answerable recall 1.00 -> 0.50Q10 answerable recall 0.50 -> 1.00Q26 version recall 1.00 -> 0.00Q30 table recall 1.00 -> 0.50Q36 table recall 0.00 -> 1.00Q64 exact-code recall 1.00 -> 0.00Q46 contradiction recall 0.33 -> 0.67Q57 injection-bait recall 0.00 -> 0.50Q59 answerable recall 1.00 -> 0.50Q60 answerable recall 0.00 -> 1.00Q61 answerable recall 0.50 -> 1.00A: bm25, top 5 recall 0.771 | MRR 0.655B: rerank, top 5 recall 0.856 | MRR 0.831Q05 answerable recall 0.00 -> 1.00Q06 answerable recall 0.50 -> 1.00Q10 answerable recall 1.00 -> 0.50Q12 answerable recall 0.00 -> 1.00Q28 version recall 1.00 -> 0.00Q29 version recall 0.00 -> 1.00Q30 table recall 0.50 -> 1.00Q32 table recall 0.00 -> 1.00Q34 table recall 0.00 -> 1.00Q36 table recall 1.00 -> 0.00Q37 table recall 0.00 -> 1.00Q47 contradiction recall 0.50 -> 1.00Q59 answerable recall 0.50 -> 1.00Q60 answerable recall 1.00 -> 0.00Q61 answerable recall 1.00 -> 0.50Q63 answerable recall 0.00 -> 1.00rerank, top 5, audience staff: 59 questions with relevant passageshit@5 0.932 | recall@5 0.864 | precision@5 0.234 | MRR 0.882 | staff passages shown to a public audience: 0 | wrong versions: 0Avec k = 10, il y a seulement des gains : six questions s’améliorent, aucune ne se dégrade. La recherche dense, comparée au reclassement, échange des réussites contre des échecs plutôt que d’apporter un gain. Son rappel augmente de moins d’une question, mais cinq questions perdent des preuves. Parmi elles figurent Q26 (une version) et Q64 (un identifiant). Le reclassement, comparé à BM25, améliore onze questions, dont Q63 en français, et en dégrade cinq, dont Q28 et Q36. La reformulation augmente le plus le MRR (de 0,831 à 0,882), pour un appel de modèle supplémentaire par question. Une moyenne masque ces échanges; la liste des questions les montre.
Vérification du module
Section intitulée « Vérification du module »Rédigez une recommandation pour un changement à l’assistant de Larkfield, avec les cinq parties ci-dessus. Utilisez vos propres expériences de l’exercice du module, ou les deux expériences en direct de cette leçon. Puis posez-vous cette question : un collègue qui lit seulement votre note saurait-il quelle étape le changement corrige, et pourquoi les preuves suffisent?
Afficher un exemple et son évaluation
Un exemple pour la reformulation des requêtes. Changement : reformuler chaque question avec chat-small avant la recherche avec reclassement. Étape : récupération; les échecs concernent des paraphrases et des questions en français. Preuves : sur le jeu figé de 59 questions, le rappel@5 est passé de 0,856 à 0,864. Le MRR est passé de 0,831 à 0,882. Les réponses aux requêtes reformulées ne sont pas enregistrées. Elles n’ont donc pas été mesurées. Coût : un appel de modèle par question, environ 0,00004 $ US avec les reformulations enregistrées, et sa latence. Risque : une reformulation peut changer le sens d’une question. Le rappel a augmenté de moins d’une question. Le gain concerne donc surtout le rang. Ce changement n’a pas encore été testé sur de nouvelles questions.
Démontré : un seul changement, avec une étape nommée et illustrée par des questions en échec. Des mesures avant et après, sur les mêmes questions. Le coût. Au moins un risque, dont celui de choisir à partir des données de test. Partiellement démontré : l’étape ou les preuves manquent, ou seule une moyenne est donnée, sans les questions dont les résultats ont changé. Pas encore démontré : deux changements à la fois, ou aucune mesure avant le changement.
Vérification des connaissances
Section intitulée « Vérification des connaissances »Vérifiez votre compréhension
Dans vos mots : pourquoi faut-il trouver l'étape où survient un échec avant de changer le modèle?
Afficher la réponse
Un changement peut seulement corriger les échecs à sa propre étape. Si les preuves n’ont jamais atteint la requête, aucun modèle ne peut répondre à partir de celles-ci. Six des huit mauvaises réponses de chat-small étaient des échecs de recherche. chat-strong a obtenu 50 bonnes réponses selon les corrigés (51 selon la vérification manuelle), contre 51, pour un coût 18 fois supérieur. Trouver d’abord l’étape indique le changement qui peut aider : ici, un k plus grand.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Prédisez : une réponse est fausse, son passage pertinent est au rang 7, et le contexte utilise 400 des 1 500 jetons. Quelle étape est en cause, et quel changement testeriez-vous d'abord?
Afficher la réponse
C’est un échec de récupération juste après les cinq premiers résultats, avec de la place dans le budget. Un choix de contexte peut le corriger. Testez un k plus grand, comme 10, comme seul changement, sur tout le jeu figé. Vérifiez qu’il ne dégrade aucune autre réponse. Avec k = 10, les quatre réponses de chat-small dans cette situation sont devenues correctes.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Vérifiez votre compréhension
Fixer le passage des règles a laissé le total à 51. Mais Q47 a appliqué la règle et Q56 a cessé de répéter l'instruction cachée. Ce changement était-il inutile? Qu'est-ce que cela enseigne sur les mesures?
Afficher la réponse
Il n’était pas inutile : les réponses sont devenues plus sûres, et certaines moins utiles (plus d’abstentions). Les corrigés ne l’ont pas détecté, car ils vérifient quelques mots. Ils ne vérifient pas si la règle a été appliquée ou si une réponse nuisible a été évitée. Un total ne résume pas tout le résultat. Lisez les réponses qui ont changé, dans les deux sens, avant de décider.
Votre réponse contient-elle les points principaux de la nôtre ?
Connectez-vous et inscrivez-vous au cours pour enregistrer vos réponses. Chaque vérification compte pour le certificat.
Récapitulatif
- Une réponse peut échouer à cinq étapes : source manquante, mauvais segment, échec de récupération, choix de contexte, génération. Vérifiez d’abord la mesure, puis les étapes dans l’ordre.
- Des huit mauvaises réponses de chat-small avec la recherche avec reclassement, six sont des échecs de récupération. Quatre sont juste après le rang 5. Deux relèvent de choix de contexte. Aucune n’est un pur échec de génération.
- Une expérience contrôlée change une seule chose. Enregistrées : reclassement au lieu de BM25, +5; chat-strong au lieu de chat-small, aucun gain. En direct : k = 10, +4 sans aucune dégradation; règles fixées, aucun changement du total, réponses plus sûres.
- Une recommandation nomme un changement, son étape, les preuves avant et après sur les mêmes questions figées, le coût et le risque. Un changement choisi à partir des données de test nécessite de nouvelles questions pour le confirmer.
Ensuite, le module 6 maintient la base de connaissances exacte au fil du temps. Les documents changent, les versions sont retirées et les textes supprimés doivent disparaître des réponses.
Leçon suivante : Mises à jour et suppressions